
Мой блог
PyTorch MPS против Apple MLX: дообучение LLM на Mac с 16 ГБ

Локальное дообучение языковых моделей на компьютерах с чипами Apple Silicon ставит инженеров перед выбором между двумя основными стеками: фреймворком Apple MLX и бэкендом PyTorch MPS в связке с библиотеками Hugging Face. При работе на конфигурациях с 16 ГБ объединенной памяти выбор инструмента определяет не только скорость вычислений, но и принципиальную возможность запустить обучение на длинном контексте.
Практическое дообучение LLM на Mac с 16 ГБ сопряжено с жесткими системными ограничениями: операционная система macOS резервирует ощутимую часть RAM под собственные нужды и композитинг интерфейса. В таких условиях выбор между FP16 на MPS и 4-битной QLoRA на MLX приводит к разным компромиссам по скорости, потреблению ресурсов и стабильности работы.
Особенности нагрузки: SFT на трейсах автономных агентов
В типовых руководствах по Supervised Fine-Tuning (SFT) часто применяются короткие одноходовые датасеты с контекстом 256–512 токенов. При подготовке специализированных моделей для кодинга ситуация меняется: данные представляют собой продолжительные сессии с множеством диалоговых ходов, вызовами консольных утилит и большими логами сборки.
В рамках сравнительного исследования использовался датасет badlogicgames/pi-mono, включающий полные рабочие сессии автономных сред разработки. Подготовленный конвейер обработал 627 файлов, из которых было сформировано 6 727 примеров с предельным окном контекста max_length=4096 токенов (6 471 пример вошел в обучающую выборку, а 256 — в валидационную).
Специфика маскирования и расчет потерь
Для корректного обучения модели поведению агента критически важно не заучивать вывод системных команд и логи терминала. Стандартный каузальный расчет функции потерь по всей длине последовательности в данном сценарии не подходит. Требуется обучать нейросеть только на генерацию структурированных ответов ассистента и вызовов внешних инструментов.
В процессе подготовки токенов запросы пользователей и системный вывод маскируются значением -100. Функция потерь вычисляется исключительно по позициям токенов, сгенерированных моделью. В библиотеке TRL (Hugging Face) этот режим включается аргументом completion_only_loss=True, тогда как в MLX маскирование входных данных пришлось подготавливать заранее на этапе формирования датасета.
Архитектура бэкендов в условиях объединенной памяти
В архитектуре Apple Silicon центральный процессор, графический ускоритель Metal и сама операционная система делят единое физическое пространство оперативной памяти. Из доступных 16 ГБ системные процессы macOS обычно забирают от 4 до 5 ГБ, оставляя под задачи машинного обучения порядка 11 ГБ.
PyTorch MPS со стеком Hugging Face
Бэкенд MPS использует точность FP16 для весов и активаций, поскольку стандартное квантование через bitsandbytes опирается на архитектуру CUDA и на Metal не поддерживается. При r=16 и alpha=32 для адаптеров LoRA веса занимают 2 байта на каждый параметр. Преимуществом остается совместимость с инструментарием TRL и PEFT, что позволяет легко переносить код на внешние серверы с видеокартами NVIDIA.
Apple MLX (mlx-lm)
Нативный фреймворк Apple предоставляет прямую поддержку 4-битной QLoRA на базе готовых репозиториев сообщества. Это сокращает объем требуемой памяти под параметры модели приблизительно на 75%. Например, для модели масштаба 3 млрд параметров чекпойнт требует около 1,8 ГБ вместо 6 ГБ в FP16. Недостатком решения выступает узкая привязка к экосистеме Apple без возможности прямого запуска того же кода на CUDA.
В обоих сценариях для тестов на моделях семейства Qwen 2.5 (0.5B, 1.5B и 3B) удерживался одинаковый эффективный размер батча (4), но алгоритмы оптимизации различались: PyTorch MPS задействовал AdamW с косинусным расписанием, а MLX по умолчанию использовал базовый Adam с фиксированной скоростью обучения.
Сравнение производительности и скорости обучения
Показатели 10 контролируемых запусков выявили существенное преимущество PyTorch MPS по чистой скорости обработки батчей на поддерживаемых размерах моделей:
- Qwen 0.5B (контекст 2k): MPS показал 5,35 итераций в секунду против 0,94 it/s у MLX (отрыв в 5,7 раза);
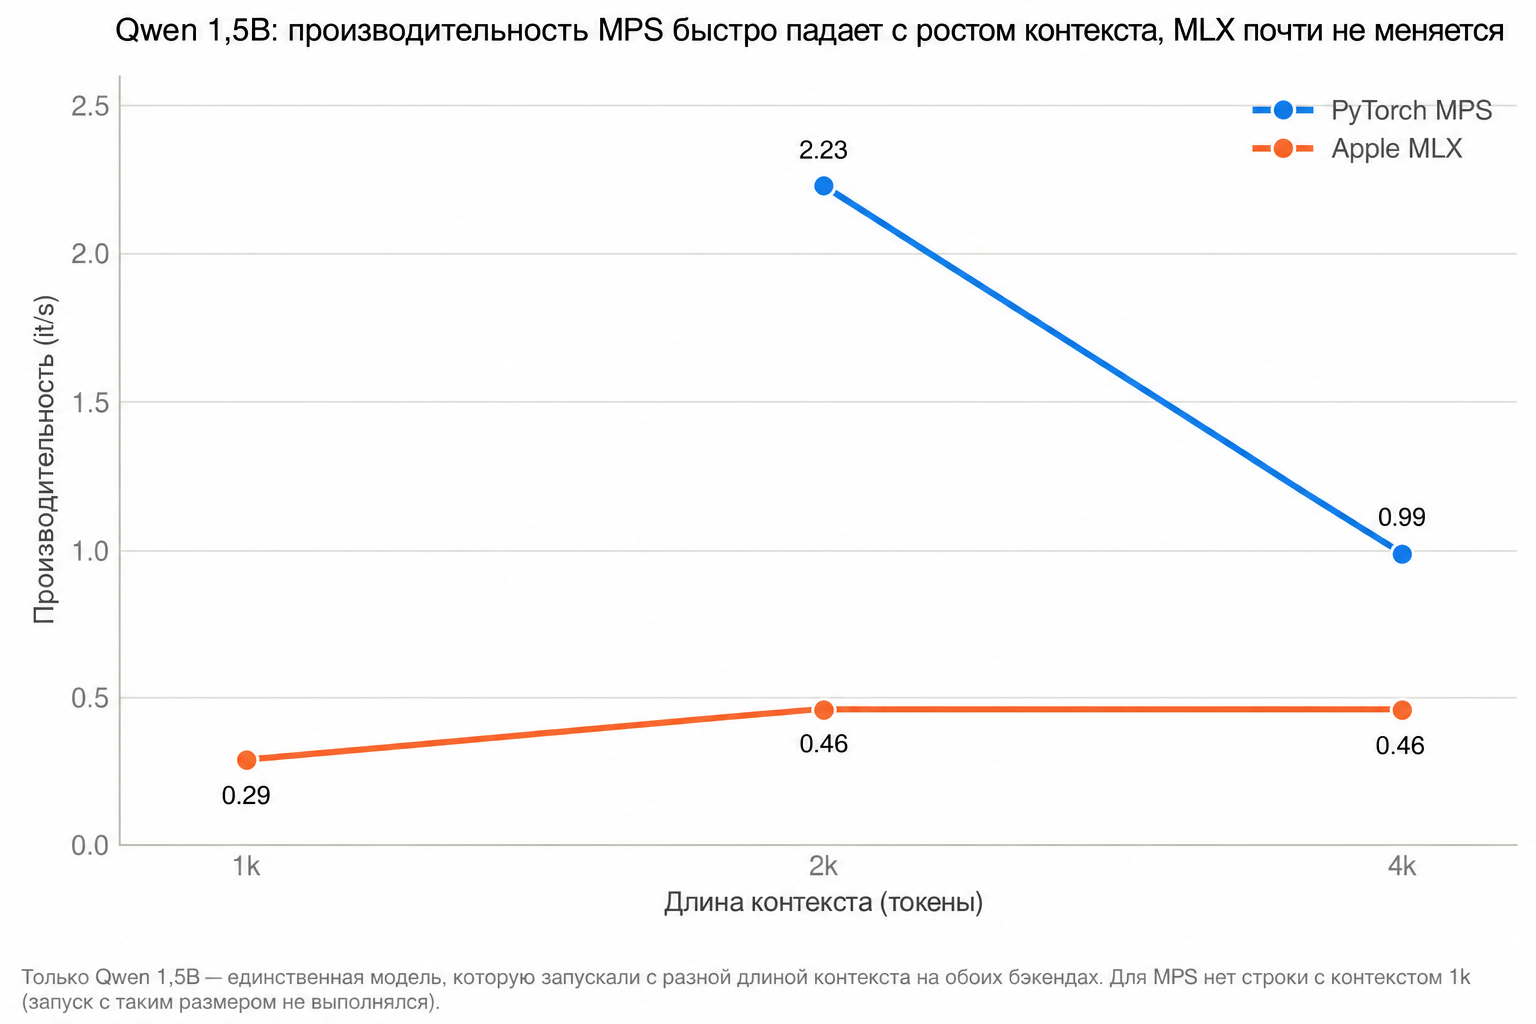
- Qwen 1.5B (контекст 2k): MPS продемонстрировал 2,23 it/s против 0,46 it/s у MLX (отрыв в 4,8 раза);
- Qwen 1.5B (контекст 4k): скорость MPS снизилась до 0,99 it/s, тогда как MLX сохранил темп 0,46 it/s (разрыв сократился до 2,2 раза).
Отставание MLX обусловлено спецификой вычислений в режиме обучения. На этапе инференса 4-битные веса дают ускорение за счет снижения требований к пропускной способности памяти при последовательной генерации токенов. Однако при обучении полные батчи требуют регулярного деквантования 4-битных целых чисел обратно в FP16 перед каждым матричным умножением на прямом и обратном проходах. Это создает вычислительные накладные расходы.
Дополнительные тесты MLX в 16-битном режиме без квантования показали, что деквантование отвечает лишь за небольшую долю замедления (в 1,07–1,4 раза). Основной разрыв в 4,1–4,6 раза сохраняется на уровне реализации вычислительного графа и ядра LoRA внутри самой библиотеки mlx_lm.
Эффективность расхода памяти и масштабирование
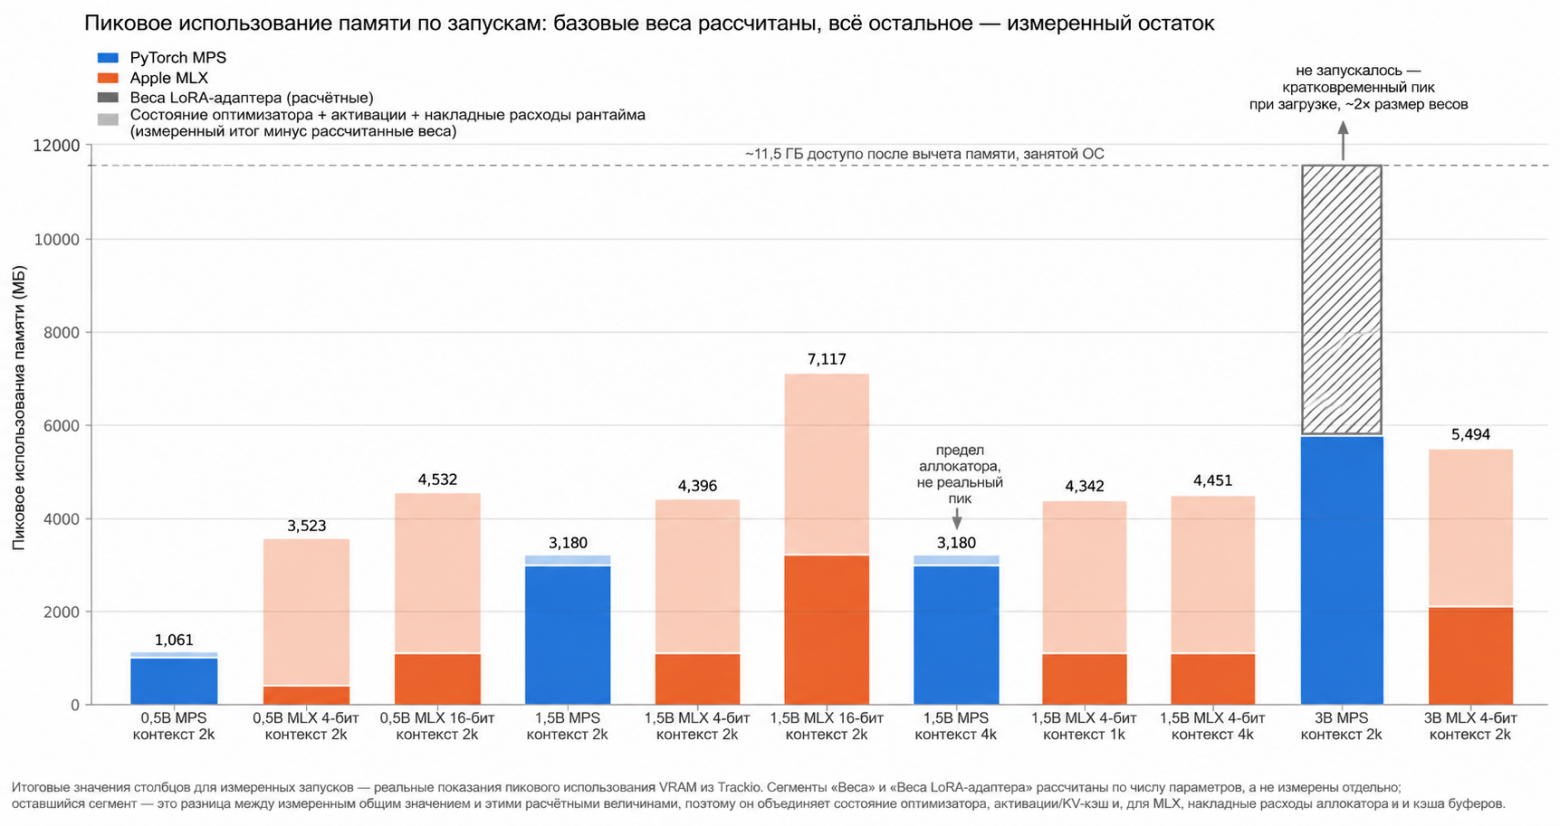
Несмотря на высокую скорость, PyTorch MPS оказывается ограничен по объему обрабатываемых моделей. При попытке инициализировать модель на 3 млрд параметров в FP16 стандартный загрузчик Hugging Face сначала помещает веса в системную память CPU, после чего перемещает их на устройство MPS. В объединенной памяти этот дублирующий шаг требует до 12 ГБ, что вместе с нагрузкой от macOS вызывает немедленное исчерпание физического лимита в 16 ГБ.
Apple MLX за счет нативного 4-битного представления уверенно запускает модель 3B при окне контекста 2048 токенов с пиковым расходом памяти всего 5 494 МБ. Более того, масштабирование контекста на MLX с 1k до 4k токенов на модели 1.5B увеличило пиковый объем VRAM всего на 109 МБ (с 4342 до 4451 МБ).
При этом при прямом сопоставлении в FP16 фреймворк PyTorch расходует память аккуратнее: для модели 1.5B MPS потребовал пиковые 3 180 МБ, тогда как неквантованный MLX 16-bit занял 7 117 МБ. Способность MLX удерживать более крупные архитектуры в рамках 16 ГБ достигается именно 4-битной упаковкой, а не лучшей организацией буферов.
Влияние квантования на сходимость модели
Эксперименты показали, что применение 4-битной QLoRA не разрушает способность модели воспринимать структурированный вывод инструментов и синтаксис JSON. На модели Qwen 1.5B при контексте 2k финальная валидационная функция потерь у MPS составила 0,4623, а у MLX — 0,4780. Вариант Qwen 3B на MLX достиг значения 0,4520.
Точность предсказания токенов ответа на бэкенде MPS удерживалась на уровне 85,9–88,6%. В MLX аналогичная прямая метрика token accuracy по умолчанию не вычисляется из-за отсутствия отдельной операции argmax над логитами при валидации, что сделано разработчиками для экономии буферов Metal.
Практические рекомендации по настройке окружения на macOS
При организации дообучения на компьютерах Mac важно учитывать ряд системных факторов, способных привести к аварийной остановке или деградации скорости.
Управление аллокатором MPS
Стандартный аллокатор PyTorch регулирует доступ к ресурсам через коэффициенты PYTORCH_MPS_HIGH_WATERMARK_RATIO (по умолчанию 1.7) и PYTORCH_MPS_LOW_WATERMARK_RATIO (1.4). При обучении моделей на пределе памяти эти лимиты вызывают агрессивный сброс кэша. Для их отключения переменные задают в ноль строго до импорта библиотеки:
import os
os.environ["PYTORCH_MPS_HIGH_WATERMARK_RATIO"] = "0.0"
os.environ["PYTORCH_MPS_LOW_WATERMARK_RATIO"] = "0.0"
import torch
После отключения лимитов контроль за предотвращением переполнения памяти полностью ложится на разработчика.
Оптимизация параметров DataLoader
Традиционные для Linux-систем флаги pin_memory=True и увеличенное количество потоков num_workers на Apple Silicon приводят к противоположному результату. Закрепление памяти в физическом пространстве не имеет смысла в unified memory и тратит ресурсы. Многопоточность через запуск процессов spawn на macOS дублирует таблицы памяти, поэтому рекомендуется выставлять dataloader_pin_memory=False и dataloader_num_workers=0.
Предотвращение сна и контроль файла подкачки
Фоновые механизмы macOS могут снижать производительность вычислений: функция App Nap снижает частоты GPU при сворачивании окна терминала. Для предотвращения троттлинга процессы запускают через системную команду caffeinate -dimsu.
Кроме того, необходимо отслеживать состояние свопа через терминальную утилиту sysctl vm.swapusage. Если активный объем страниц подкачки начинает непрерывно расти, Metal-буферы сбрасываются на SSD, что критически снижает общую скорость обучения. В таком случае запуск следует остановить и уменьшить длину последовательности или размер батча.
