
Мой блог
Google выпустила Gemini 3.8 Flash TTS и Flash-Lite TTS с генерацией голоса по текстовым промптам

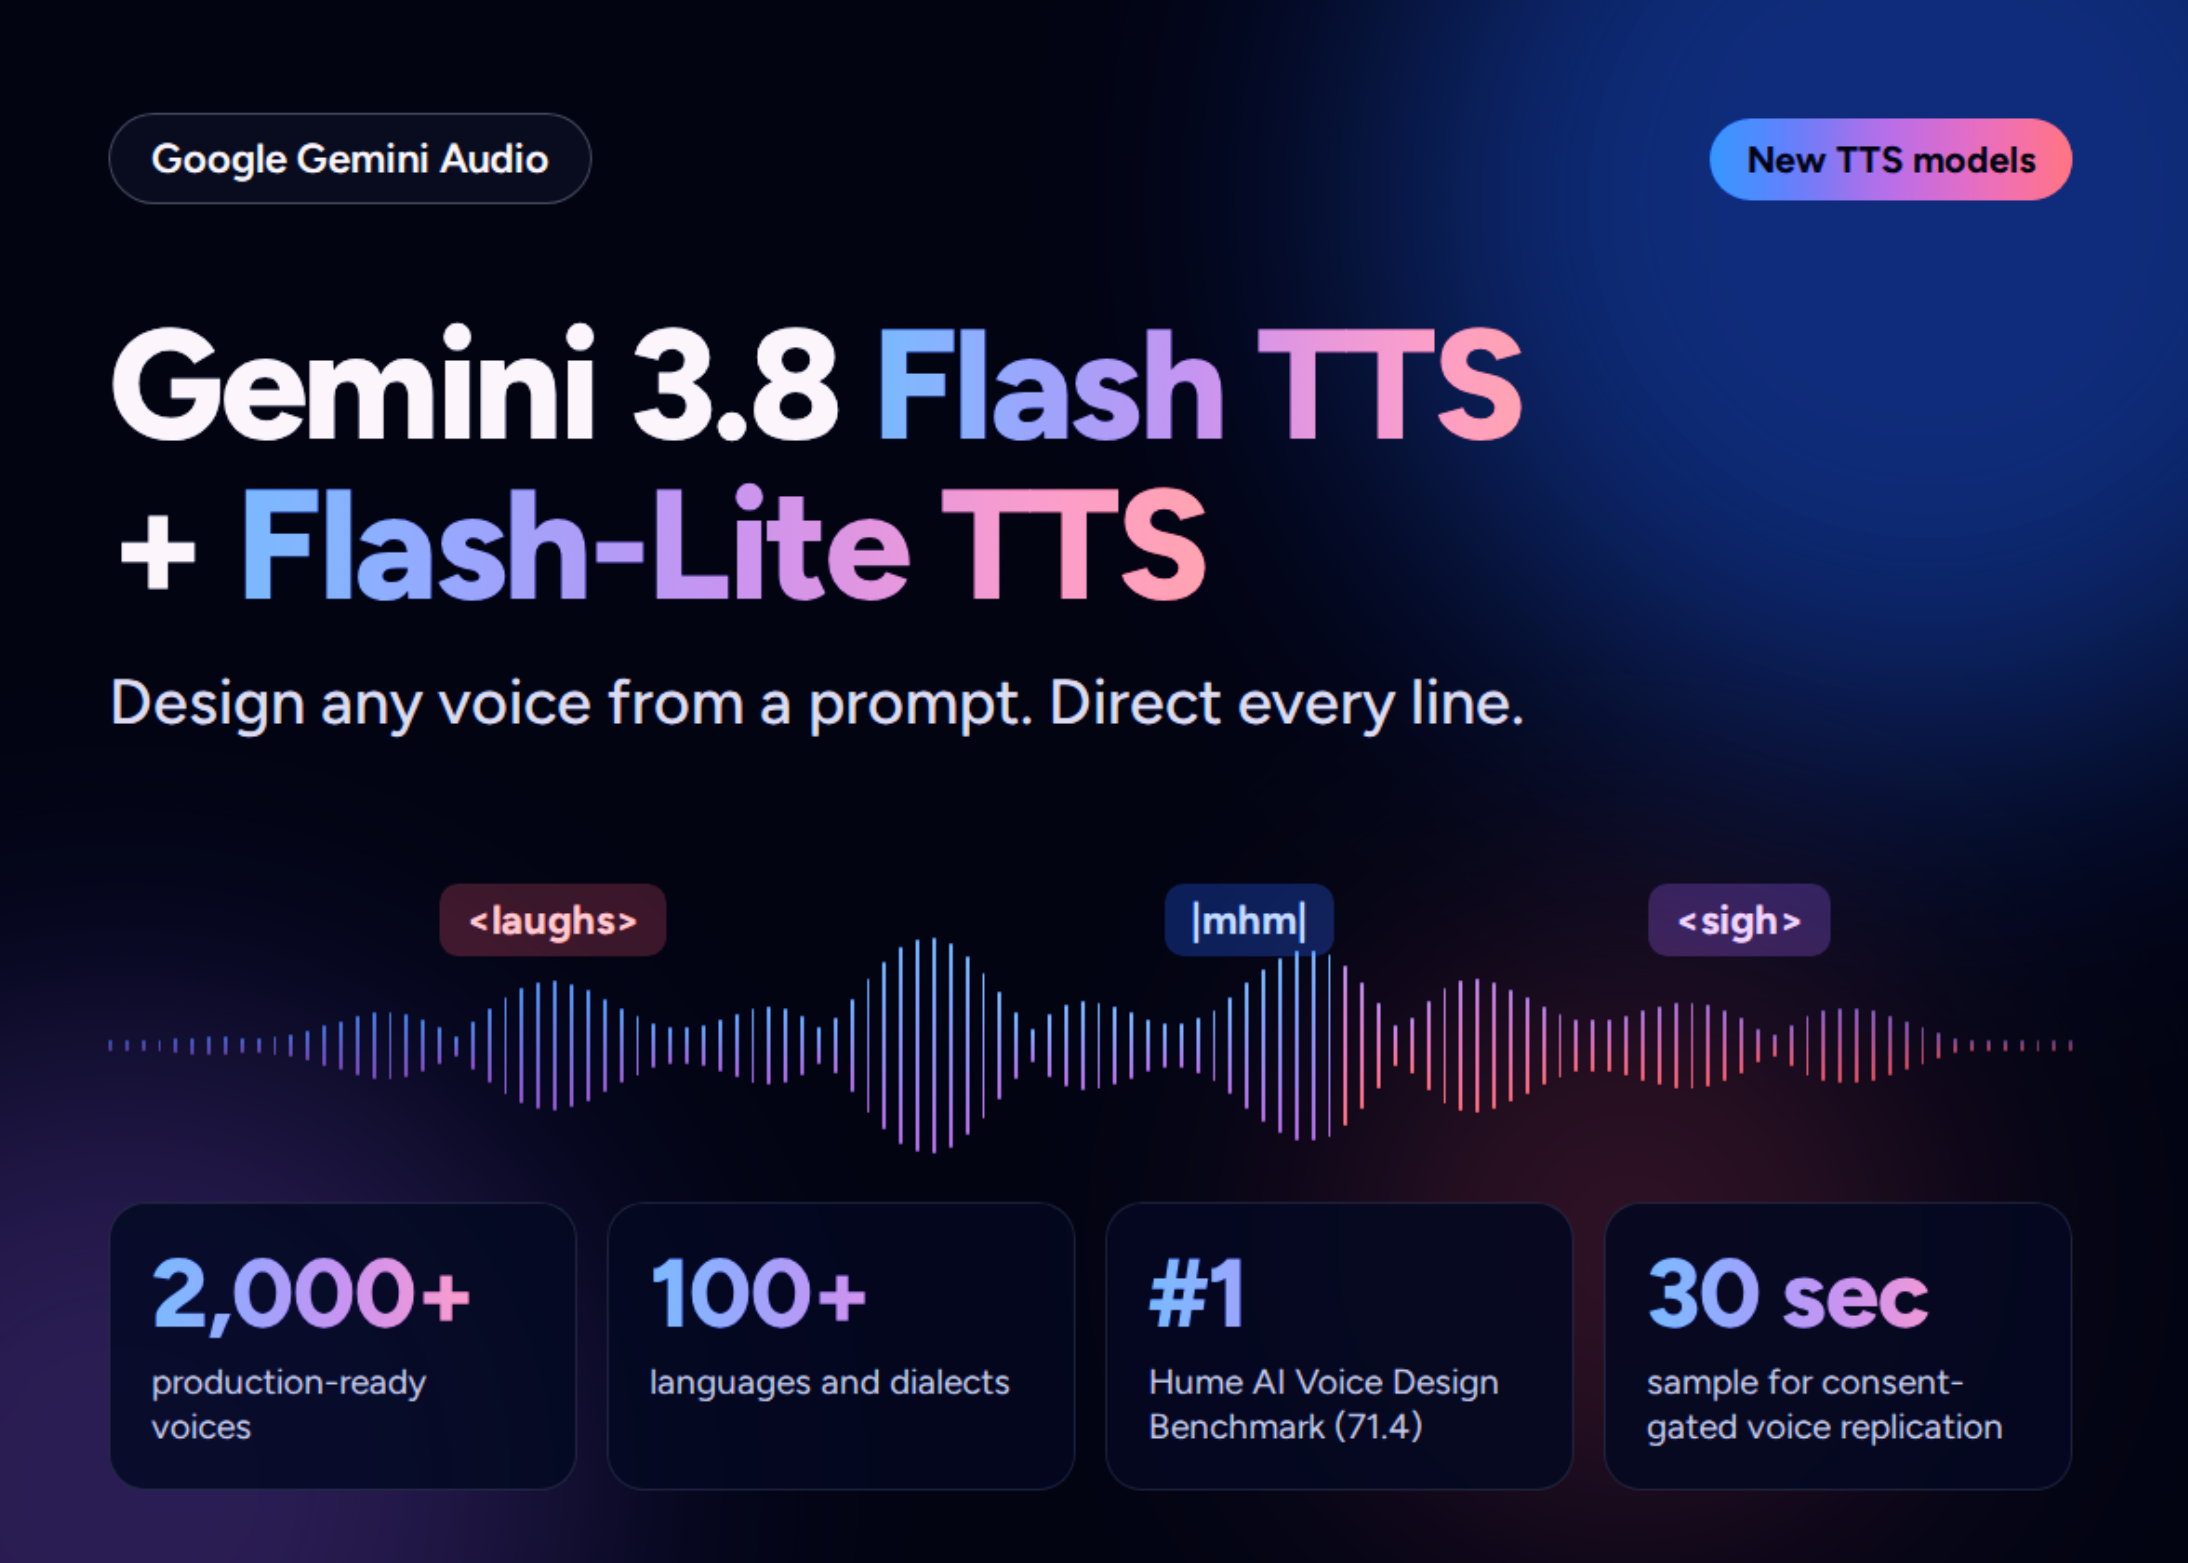
Компания Google представила две новые модели синтеза речи в своем семействе Gemini Audio — Gemini 3.8 Flash TTS и Flash-Lite TTS. По заявлениям разработчиков, это самые выразительные инструменты генерации аудио на сегодняшний день, ориентированные на детальную творческую режиссуру и массовое экономичное производство.
Я подготовил подробный разбор возможностей новых моделей, их архитектурных отличий, систем управления звучанием, а также требований безопасности и результатов бенчмарков.
Что именно выпустила Google
Новое семейство текстового синтеза речи разделено на два ключевых направления с общими инструментами управления подачей. Обе модели доступны исключительно через программный интерфейс API и среду разработки Google AI Studio без возможности самостоятельного хостинга весов, а корпоративный доступ через Gemini Enterprise ожидается в ближайшее время.
Два уровня генерации речи
Модель Gemini 3.8 Flash TTS разработана для глубокой творческой работы и проектирования персонажей. Она отлично подходит для видеоигр, интерактивных медиа, подкастов и масштабных аудиокниг, предлагая точный контроль над актерскими ремарками, темпом, изменениями диалектов и фоновыми звуковыми реакциями. В свою очередь, Gemini 3.8 Flash-Lite TTS ориентирована на экономичное масштабирование и высокую производительность в задачах дубляжа, массового создания контента и создания разговорных ИИ-агентов, обеспечивая детализированное управление тоном и нюансами экспрессии.
Идентификаторы в Google AI Studio
Для тестирования в рабочей среде Google AI Studio используются четкие системные идентификаторы: gemini-3.8-flash-tts для базовой творческой версии и gemini-3.8-flash-lite-tts для облегченной модификации. Это позволяет разработчикам быстро интегрировать нужный уровень модели в свои программные продукты.
Дизайн голоса из текстового промпта
Если раньше стандартные решения Gemini предлагали ограниченный набор из 30 оригинальных голосов, то версия 3.8 переносит систему на совершенно иной масштаб генерации.
Параметры кастомизации и библиотека
Генеративный инструмент Flash TTS умеет создавать абсолютно новые уникальные голоса на основе текстовых описаний роли, специфических акцентов и характеристик. Функция поддерживает более ста языков и диалектов. В качестве демонстрации возможностей разработчики создали такие образы, как диджей из Мельбурна, монотонный робот и японский дракон. Кроме того, создателям доступна готовая библиотека из более чем 2000 профессиональных голосов, включая региональные вариации вроде мексиканского испанского, квебекского французского и шотландского английского. Пользователи могут сохранять кастомные голоса для стабильного использования в проектах, а в скором времени появится функция ремиксирования тембра, высоты и темпа через промпты.
Управление производительностью
Обе новинки поддерживают сценические ремарки прямо внутри сценария, а также умеют выстраивать подачу по естественным подсказкам в тексте.
Продолжительность и многоголосие
Качество голоса, выверенный темп и стабильный тембр сохраняются на протяжении многих часов непрерывной генерации аудио. Функция нативной двухголосой постановки позволяет запускать многоступенчатый диалог с разделенными голосами в рамках одного скрипта. Дополнительную реалистичность привносят невербальные звуковые вкрапления вроде смеха, вздохов и одышки, а также реплики активного слушания наподобие утвердительных междометий, которые помогают контролировать комедийный тайминг и реакцию аудитории.
Клонирование голоса и меры безопасности
Процедура репликации голоса строит согласованный вокальный профиль на основе всего лишь 30-секундного аудиофрагмента. При этом образец должен принадлежать самому пользователю или применяться на законных основаниях.
Защита и верификация контента
Для клонирования обязательно требуется запись голосового согласия владельца, которая сопоставляется с эталонным спикером. Каждый сгенерированный аудиофабрикой Gemini фрагмент маркируется невидимым водяным знаком SynthID, интегрированным в выходной поток. Клонированные голоса также получают учетные данные содержимого стандарта C2PA для прозрачного отслеживания происхождения.
Результаты независимых бенчмарков
Компания приводит официальные показатели успешности новых языковых моделей на основе тестирования сторонними организациями.
Рейтинги производительности
По данным Hume AI, модель Flash TTS заняла первое место в общем зачете бенчмарка Voice Design с результатом 71.4 балла, а также уверенно лидирует в моделировании акцентов со счетом 60.8. В общем индексе качества Hume AI модель Flash TTS расположилась на первой строчке, тогда как облегченная Flash-Lite TTS заняла второе место. В слепом тестировании Voice Arena обе новинки заслужили высшие оценки на японском, бразильском португальском, вьетнамском, современном стандартном арабском, мексиканском испанском и хинди языках.
Основные выводы
Выход Gemini 3.8 Flash TTS и Flash-Lite TTS знаменует важный шаг Google в развитии выразительного голосового синтеза для творчества и бизнеса. Модели предлагают беспрецедентный уровень контроля, огромную базу готовых голосов и передовые инструменты безопасности, делая генерацию аудио гибкой и технологичной.
Часто задаваемые вопросы
Ниже приведены ответы на самые популярные вопросы о новых моделях синтеза речи от Google.
Что представляет собой Gemini 3.8 Flash TTS?
Это фирменная модель синтеза речи от Google, предназначенная для создания уникальных голосов и детального управления актерской игрой по строкам. Она доступна через Gemini API и рабочее пространство Google AI Studio.
Чем отличается версия Flash-Lite TTS?
Эта модификация оптимизирована под высоконагруженные и экономичные рабочие процессы, такие как автоматический дубляж и голосовые ИИ-агенты, занимая при этом вторую строчку в глобальном индексе качества Hume AI.
Можно ли скопировать собственный голос?
Да, для этого потребуется 30-секундный звуковой семпл и записанное на микрофон подтверждение согласия владельца, хотя в некоторых регионах вроде Великобритании, ЕЭП и Индии эта функция в AI Studio пока недоступна.
