
Мой блог
Запуск гигантских MoE-моделей на потребительском ПК: иерархическая память и квантование

Архитектуры типа Mixture of Experts (MoE) позволили существенно сократить объем вычислений при обработке каждого токена, однако необходимость держать в памяти полный набор весов долгое время оставалась ключевым барьером для их запуска на пользовательских системах. Новая иерархическая организация памяти для MoE-моделей, реализованная в специализированных движках инференса, предлагает распределять данные между видеопамятью, системным ОЗУ и SSD-накопителем, благодаря чему становится возможной работа с нейросетями объемом в сотни миллиардов параметров.
Подобное перераспределение ресурсов смещает фокус с использования вычислительной мощности графических процессоров на баланс всех компонентов компьютера. Ниже подробно рассмотрены механизмы распределенного кеширования, требования к оборудованию, показатели точности агрессивных квантов, а также результаты замеров скорости в проектах Strata и Project Maya.
Архитектура MoE и принцип иерархического кеширования памяти
Основное преимущество архитектур с множеством экспертов перед монолитными (Dense) сетями заключается в разреженности вычислений. В монолитной модели на каждом шаге генерации считываются абсолютно все параметры. В MoE-системах, таких как Qwen3.8-Flash-Next со 125 миллиардами параметров и 24 576 экспертами, для обработки конкретного токена активируется лишь порядка десяти экспертов. Это снижает число арифметических операций на шаг генерации, но не меняет общий объем занимаемой памяти: все веса экспертов должны находиться в доступности системы.
Для решения проблемы нехватки VRAM был предложен подход, аналогичный многоуровневой кеш-памяти центральных процессоров (L1, L2, L3). Вместо попытки разместить всю нейросеть целиком в память графического ускорителя, компоненты модели распределяются по разным типам физической памяти в зависимости от частоты доступа и критичности к задержкам.
Устройство движка Strata и трехуровневое распределение ресурсов
Проект Strata реализует распределение нейросети по трем уровням хранения:
- Кеш L1 (Видеопамять GPU): здесь находятся слои внимания (Attention), DeltaNet, роутеры, MTP-слои, KV-кеш и наиболее часто задействуемые эксперты.
- Кеш L2 (Системная оперативная память RAM): хранит полный массив экспертов (например, все 24 576 блоков), с которыми центральный процессор работает параллельно с видеокартой.
- Кеш L3 (NVMe SSD): содержит таблицу n-gram размером в несколько десятков гигабайт. Поскольку за один шаг с диска запрашиваются единичные строки, пропускной способности современных SSD оказывается достаточно.
Предыдущие попытки создания гибридных систем инференса сталкивались с узким местом в виде пропускной способности шины PCIe. В Strata при отсутствии нужного эксперта в VRAM его данные не прокачиваются через шину PCIe на видеокарту. Вместо этого вычисления с данным экспертом выполняются непосредственно силами процессора в оперативной памяти.
При такой схеме объем видеопамяти сохраняет первостепенное значение: каждый дополнительный гигабайт VRAM позволяет удерживать в быстрой зоне порядка 700 дополнительных экспертов. Параллельно поддерживаются стандартные технологии оптимизации, включая Multi-Token Prediction (MTP) и упреждающую загрузку экспертов следующего слоя во время расчета внимания текущего слоя.
Квантование и требования к оборудованию
Движок Strata из коробки поддерживает модели Qwen3.8-Flash-Next, Qwen3.6-35B-A3B и DeepSeekV4.1-Flash-1017. Для работы с ними применяются сжатые форматы от лаборатории распределенных алгоритмов и систем Австрийского института науки и технологий (ISTA), развивающей методы квантования GSQ и RCO.
В этой схеме выбор подходящего уровня сжатия привязан к суммарному объему видеокарты и оперативной памяти.
Минимальный комбинированный объем памяти (RAM + VRAM) для Qwen3.8-Flash-Next (180B):
- Q2_0: от 38 ГБ;
- IQ2_XS: от 40 ГБ;
- IQ3_XXS: от 47 ГБ;
- IQ3_S: от 55 ГБ.
Минимальный комбинированный объем памяти для DeepSeekV4.1-Flash-1017 (763B):
- IQ1_M (1.75 bpw): от 46 ГБ;
- IQ2_XXS (2.00 bpw): от 54 ГБ;
- IQ2_XS (2.25 bpw): от 64 ГБ.
Производительность Qwen3.8-Flash-Next (180B)
Скорость работы модели Qwen3.8-Flash-Next на различных конфигурациях оборудования распределяется следующим образом:
- RTX 5070 (12 ГБ VRAM) + Ryzen 5 7600 + 64 ГБ RAM: 94 ток/с (квант Q2_0), 79 ток/с (IQ2_XS), 53 ток/с (IQ3_S);
- RTX 4070 (12 ГБ VRAM) + i5-12600KF + 32 ГБ RAM: 48 ток/с (IQ2_XS);
- RX 9070 (16 ГБ VRAM) + Ryzen 7 5800X3D + 64 ГБ RAM: 58 ток/с (IQ3_XXS);
- RTX 5070 Ti (16 ГБ VRAM) + 64 ГБ RAM: 30 ток/с (IQ3_S);
- RTX 5060 Ti (16 ГБ VRAM) + 128 ГБ RAM: 48 ток/с (IQ3_S);
- 2x TITAN RTX (2x 24 ГБ VRAM) + Xeon E5-2696 v4 + 125 ГБ RAM: 77 ток/с (IQ3_S);
- Ноутбук на AMD Strix Halo + 128 ГБ RAM: 40 ток/с (UD-IQ4_XS);
- Встроенная графика Radeon 780M + 60 ГБ RAM: 14 ток/с (Q2_0 с MTP).
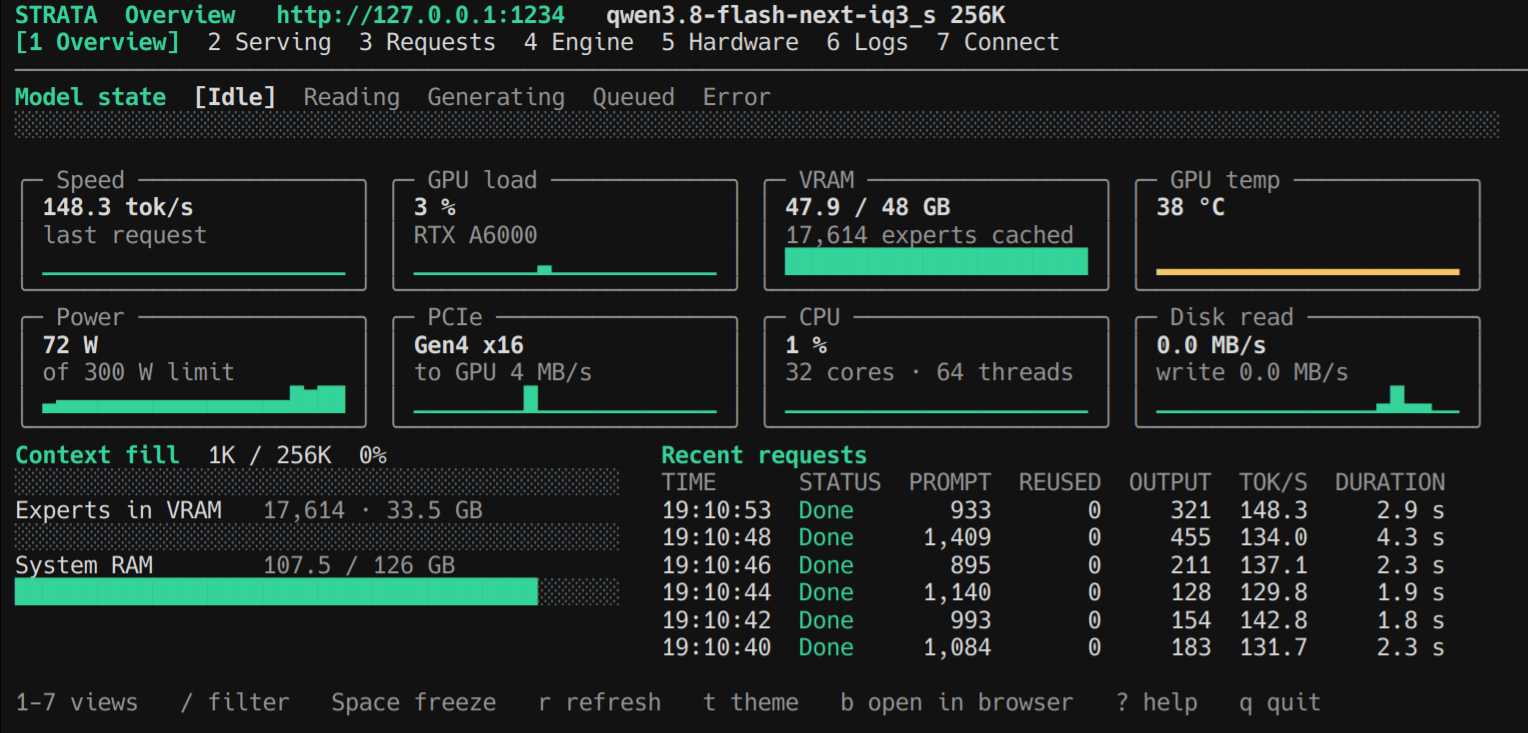
В рамках практических испытаний на тестовом стенде с видеокартой NVIDIA RTX A6000 (48 ГБ VRAM), процессором AMD Threadripper 3970X, 128 ГБ ОЗУ и контекстным окном 256K токенов квант IQ3_S продемонстрировал скорость генерации 150 токенов в секунду.
Производительность DeepSeekV4.1-Flash-1017 (763B)
Для гигантской модели DeepSeekV4.1-Flash-1017 показатели скорости декодирования составляют:
- RTX 3060 (12 ГБ VRAM) + 46 ГБ RAM: 10 ток/с (квант IQ2_XXS, 2.00 bpw);
- RTX 4000 SFF Ada + 64 ГБ RAM: 6 ток/с (IQ2_XXS);
- RTX 5070 (12 ГБ VRAM) + 64 ГБ RAM: 5 ток/с (IQ2_XXS);
- RTX 5070 Ti (16 ГБ VRAM) + 64 ГБ RAM: 12 ток/с (IQ2_XXS);
- RTX 4090 (24 ГБ VRAM) + 96 ГБ RAM: 15 ток/с (IQ2_XXS);
- RTX 4090 (24 ГБ VRAM) + 90 ГБ RAM: 25 ток/с (IQ2_XS, 2.25 bpw);
- RTX 3090 + Ryzen 5 5600 + 96 ГБ DDR4 (2400 МТ/с): 13 ток/с (IQ2_XS);
- Radeon AI PRO R9700 + 251 ГБ RAM: 23 ток/с (IQ2_XXS).
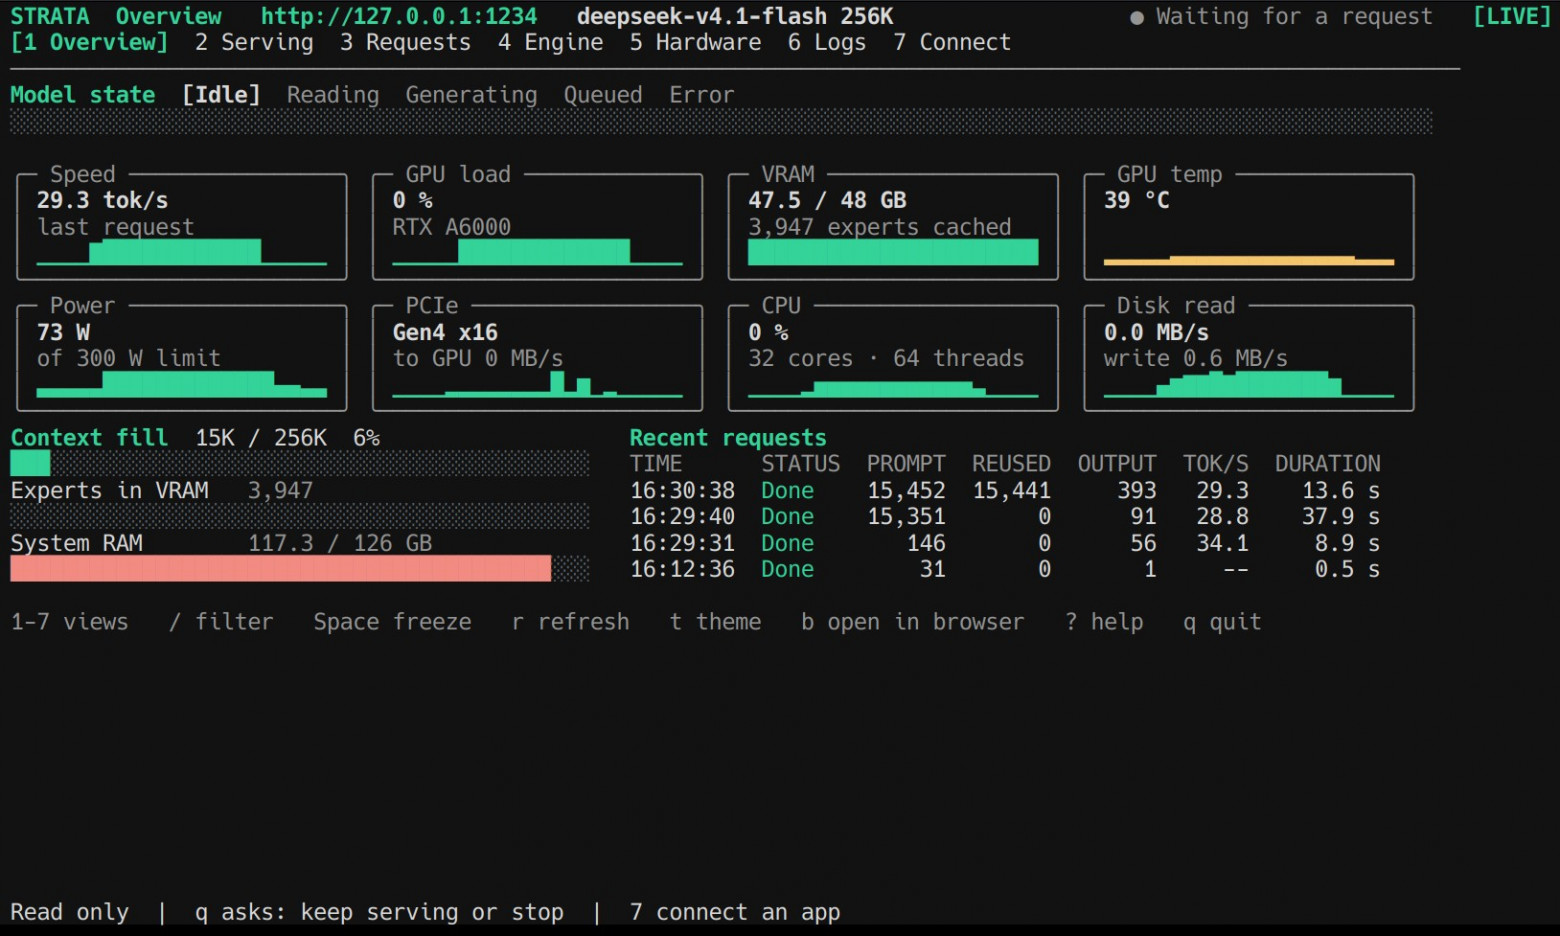
На стенде с RTX A6000 (48 ГБ), Threadripper 3970X и 128 ГБ RAM вариант IQ2_XS при длине контекста 256K обеспечивает стабильные 30 токенов в секунду.
Потери точности низкобитных квантов относительно базового формата BF16 зависят от степени сжатия: формат UD-Q4_K_XL сохраняет 94,1% точности оригинала, IQ3_S — 90,0%, IQ3_XXS — 87,3%, IQ2_XS — 85,0%, а Q2_0 — 84,1%.
Проект Project Maya и расширение поддержки моделей
Узкая узкоспециализированная оптимизация Strata под конкретные типы квантов ограничила перечень поддерживаемых сетей. Для расширения совместимости был создан форк Project Maya, поддерживающий архитектуры GLM-5.3-Flash (321B), DeepSeek-V4.1-Flash-1017 (748B) и MiniMax-M3.1-Flash (428B).
Модель GLM-5.3-Flash (321B) представляет интерес благодаря отсутствию цензурных ограничений и поддержке длинных диалоговых сессий с окном контекста до 1 миллиона токенов без применения механизмов сжатия.
Версии квантов и показатели скорости GLM-5.3-Flash (321B)
Разработчики Project Maya подготовили линейку собственных квантов с разным балансом точности (относительно эталонного FP8) и требований к оборудованию:
- Maya-S (размер ~96.5 ГБ): ориентирован на видеокарты с объемом памяти до 16 ГБ; сохраняет 97,9% точности FP8;
- Maya-S24 (размер ~94.7 ГБ): оптимизирован под карты с 16–24 ГБ VRAM; точность 97,7%;
- Maya-M (размер ~116 ГБ): рассчитан на графические ускорители от 24 до 48 ГБ VRAM; точность 97,9%;
- Maya-L (размер ~156.3 ГБ): предназначен для конфигураций с 48 ГБ VRAM и выше; точность 99,2%.
Минимальный объем системной оперативной памяти для запуска движка Project Maya составляет 32 ГБ.
Тесты производительности GLM-5.3-Flash (321B) показывают следующие результаты по скорости декодирования (Decode) и обработки первичного контекста (Prefill):
- 2x NVIDIA H100 (80 ГБ) [Maya-L, контекст 1M]: Decode 122–124 ток/с, Prefill ~2000 ток/с;
- 4x RTX 4090 [Maya-S24]: Decode 118 ток/с, Prefill 4129 ток/с;
- NVIDIA RTX PRO 6000 Blackwell [Maya-M, контекст 256K]: Decode 81 ток/с, Prefill 3102 ток/с;
- 2x RTX 3090 (225 Вт) [Maya-S24]: Decode 53 ток/с, Prefill 885 ток/с;
- RTX 3090 + RTX 3060 + 8-канальный AMD EPYC [Maya-M]: Decode 33,7 ток/с, Prefill 682 ток/с;
- RTX 5090 + Ryzen 9 7950X + 96 ГБ DDR5 [Maya-M]: Decode 30+ ток/с, Prefill ~2000 ток/с;
- RTX 3090 (24 ГБ) + 128 ГБ RAM [Maya-S24]: Decode 26,0 ток/с, Prefill 913 ток/с;
- RTX 5090 + 64 ГБ RAM (Win 11) [Maya-S]: Decode 23,0 ток/с, Prefill 2173 ток/с;
- RTX 4090 (24 ГБ) + Ryzen 7 9700X + 64 ГБ RAM [Maya-S24, контекст 32K]: Decode 16,6 ток/с, Prefill 1320 ток/с;
- RTX 5090 Laptop (24 ГБ) + 64 ГБ RAM [Maya-S24]: Decode 14,5 ток/с, Prefill 994 ток/с;
- AMD Radeon 8060S (Strix Halo) + 128 ГБ RAM [Maya-S]: Decode 18,3 ток/с, Prefill 320 ток/с;
- NVIDIA DGX Spark [Maya-S, контекст 128K]: Decode 16,5 ток/с, Prefill ~730 ток/с.
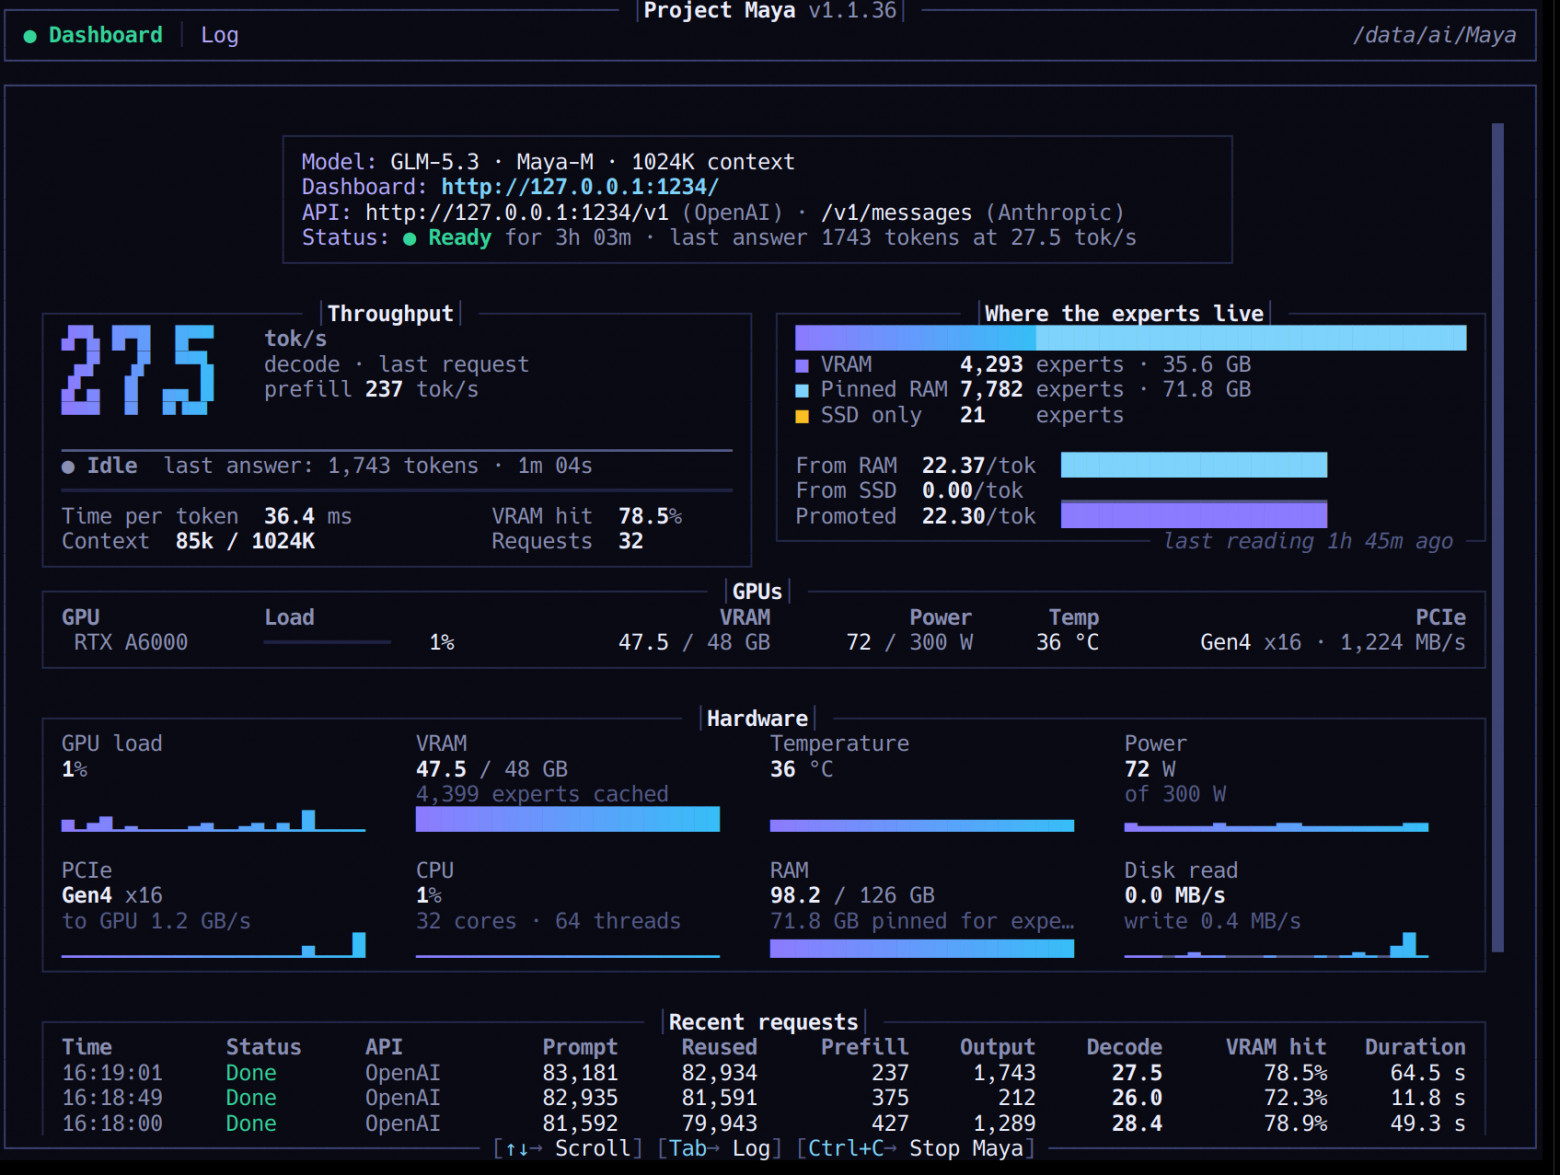
Замер на тестовом компьютере с видеокартой RTX A6000, 128 ГБ RAM и процессором Threadripper 3970X с квантом Maya-M на полном окне контекста в 1M токенов показал результат в 28 токенов в секунду.
Перспективы локального инференса гигантских нейросетей
Использование гибридных архитектур памяти в сочетании с узкоспециализированными движками и MTP-ускорением доказало свою эффективность. Модели уровня Qwen-125B при запуске на карте класса RTX 5070 с 12 ГБ видеопамяти способны выдавать несколько десятков токенов в секунду, а сеть GLM-321B запускается на одиночной ускорительной карте RTX 3090 с производительностью 20–35 токенов в секунду.
Плата за возможность запуска неперевариваемых объемов параметров на стандартных компьютерах выражается в применении квантования до уровня 2–3 бит, требованиях к наличию от 64 до 128 ГБ быстрой оперативной памяти и скоростных NVMe-накопителей. Рынок постепенно переходит от вопроса о физической возможности размещения модели к выбору допустимой степени сжатия весов ради требуемой скорости работы.
