Тэг
MoE

Mistral AI представила Mistral Large 4 (Le Chonk): гигантскую мультимодальную MoE-модель на 1,05 трлн параметров
Mistral AI представила Mistral Large 4 (Le Chonk) — мультимодальную MoE-модель на 1,05 трлн параметров с окном контекста 1М и нативной поддержкой изображений.
Читать далее
Reflection AI представила Beam: мощную open-weight MoE-модель с 501 млрд параметров
Reflection AI представила Beam — мощную open-weight MoE-модель с 501 млрд параметров, созданную для кодинга и сложных агентских задач.
Читать далее
Релиз Olmo-core 3: масштабируемая инфраструктура для обучения MoE-моделей
Обзор Olmo-core 3 от Ai2: масштабируемая открытая инфраструктура для обучения trillion-parameter MoE-моделей с высокой эффективностью.
Читать далее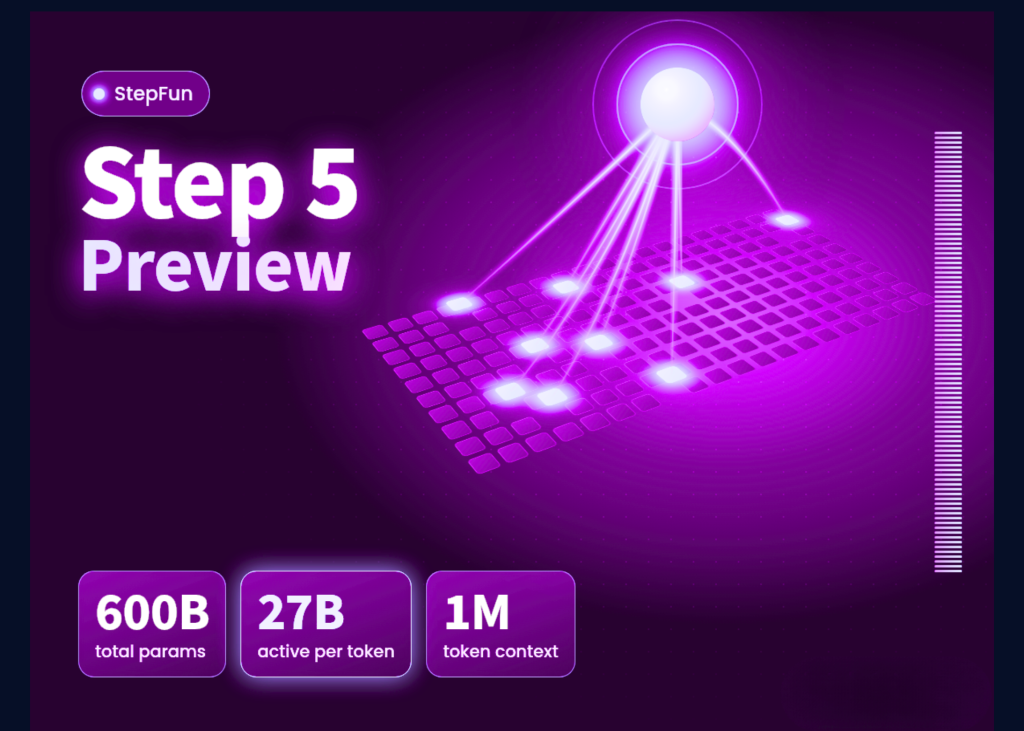
Обзор Step 5 Preview: нейросеть MoE на 600B параметров и 1M контекста для сложных задач
Компания StepFun анонсировала Step 5 Preview — флагманскую MoE-нейросеть на 600B параметров с окном в 1M токенов. Подробный разбор архитектуры, бенчмарков, цен API и даты выхода открытых весов.
Читать далее
DeepSeek-V4.1-Flash в API Baseten: архитектура Causal Encoder-Decoder и контекстное окно на 1 млн токенов
Платформа Baseten добавила мультимодальную модель DeepSeek-V4.1-Flash с 552 млрд параметров и контекстным окном в 1 миллион токенов. Разбираем архитектурные изменения, результаты бенчмарков и новые тарифы.
Читать далее
Cohere представила North Small Translate: модель перевода на 218B параметров с архитектурой MoE
Cohere выпустила North Small Translate — открытую MoE-модель на 218 миллиардов параметров, разработанную специально для перевода на 50 языков.
Читать далее
Тестирование DeepSeek, Qwen и GLM на ПК с RTX 5090: подборы инференса, VRAM и драфтеры
Провел масштабный бенчмарк свежих локальных нейросетей DeepSeek, Qwen, GLM и Ornith на топовом пользовательском ПК с RTX 5090 и 192 ГБ ОЗУ. Разбираем реальную скорость, работу MoE и спекулятивное декодирование.
Читать далееАктивация экспертов и роутинг стратегий в ИИ: почему одной траектории недостаточно и как работает Qwen3.8-Flash-Next
Разбираемся, почему экономной активации параметров в MoE-моделях вроде Qwen3.8-Flash-Next недостаточно для сложных задач и как настроить маршрутизацию стратегий рассуждения.
Читать далее
Разреженная смесь экспертов в обработке звука: разбор архитектуры SESAME для Speech Enhancement
Подробный разбор архитектуры SESAME: как разреженная смесь экспертов (MoE) позволяет улучшить качество очистки речи (Speech Enhancement) и снизить вычислительные затраты при инференсе.
Читать далее