
Мой блог
Релиз Olmo-core 3: масштабируемая инфраструктура для обучения MoE-моделей


Я подготовил подробный разбор важного релиза от команды Ai2 — Olmo-core 3. Этот крупный апдейт фреймворка для разработки больших языковых моделей предлагает полностью переработанную открытую систему обучения архитектур «микросхем экспертов» (Mixture-of-Experts, MoE).
Новая инфраструктура спроектирована так, чтобы масштабировать тренировку MoE-моделей до триллионных параметров без потери вычислительной эффективности. Это один из ключевых элементов, лежащих в основе следующего поколения моделей серии Olmo, продолжающий традицию открытости инструментов и обучающих пайплайнов.
Экономия ресурсов и преодоление барьеров масштабирования
Обучение продвинутых систем искусственного интеллекта требует колоссальных вычислительных мощностей, что ведет к росту финансовых затрат и энергопотребления. Подобные требования часто делают разработку недоступной для независимых исследователей и академических лабораторий. Модели MoE предлагают более рациональный подход, позволяя задействовать гораздо большее число обученных параметров без необходимости активировать их все для каждого отдельного токена.
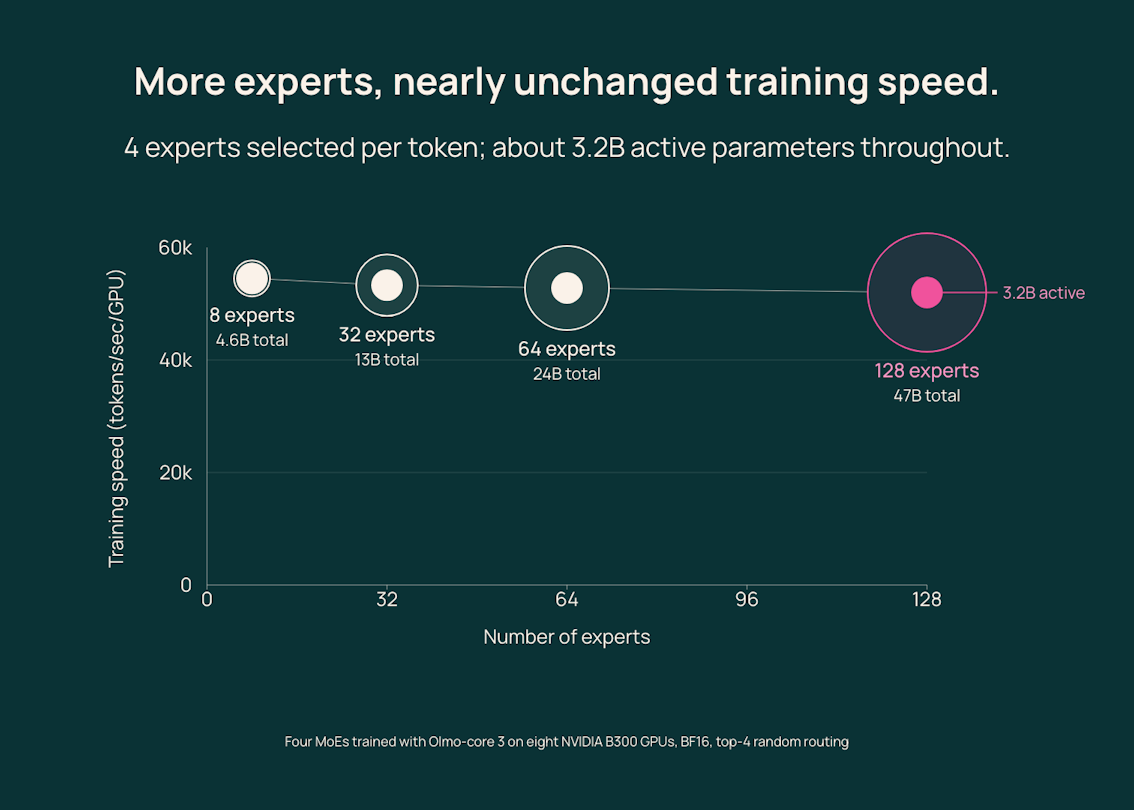
Тем не менее, полная модель должна храниться в памяти графических процессоров (GPU) и обновляться во время тренировки, а маршрутизация входящих запросов к нужным экспертам по всему кластеру порождает серьезные накладные расходы на коммуникацию. Платформа Olmo-core 3 призвана закрыть этот разрыв. В ходе одного из бенчмарков я обратил внимание, что разработчики увеличили пул экспертов с 8 до 128, продолжая выбирать только по четыре эксперта на токен. Это позволило зафиксировать число активных параметров на отметке около 3.2 млрд, в то время как общая емкость модели выросла с 4.6 млрд до 47 млрд, а падение производительности обучения составило менее 5%.
Создание тренировочного стека под реальную логику MoE
Архитектура Olmo-core эволюционировала вместе с каждой новой версией семейства Olmo. Предыдущие эксперименты со разреженными моделями включали систему OlmoE с 64 маршрутизируемыми экспертами, тогда как модель Olmo 3 опиралась на плотную архитектуру, где для каждого токена задействовались практически все компоненты.

Переход от FSDP к распределенной параллельности данных
Старая реализация MoE внутри Olmo-core использовала полностью шарированную параллельность данных (FSDP), которая собирала и перераспределяла веса модели для каждого небольшого батча. В версии Olmo-core 3 я отмечаю переход на систему на базе распределенной параллельности данных (DDP). Она удерживает экспертов непосредственно в памяти GPU и направляет к ним релевантные данные, исключая необходимость постоянного пересобирания весов.
Сравнение производительности с Megatron-Core
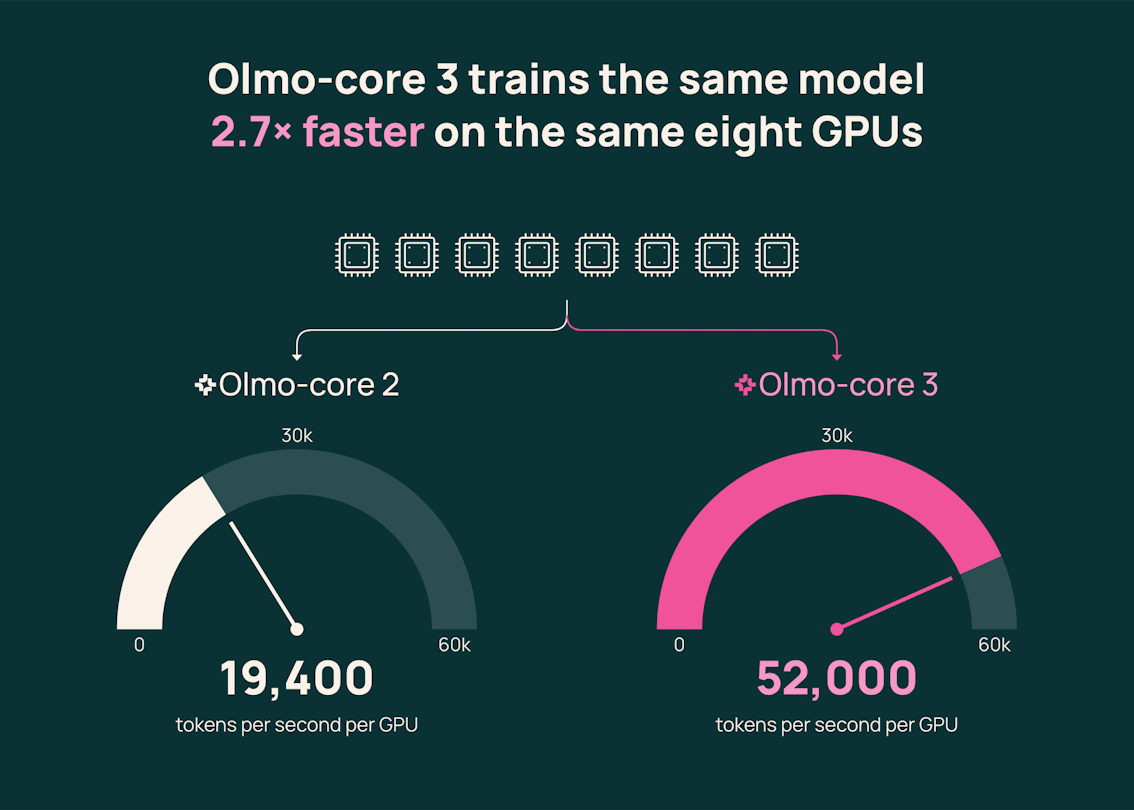
Известным аналогом для подобных задач выступает стек Megatron-Core от NVIDIA. Тем не менее, свежий релиз приносит интегрированный инструмент, который обеспечивает существенный прирост пропускной способности. Предварительные тесты на восьми ускорителях NVIDIA B300 показали, что модель на 47 миллиардов параметров обрабатывает 52 000 токенов в секунду на каждый GPU, тогда как старая реализация выдавала лишь 19 400 токенов — это примерно в 2.7 раза быстрее.

Оптимизация и распределение процессов обучения
Для эффективного разделения огромных MoE-моделей между кластерами графических чипов Olmo-core 3 объединяет сразу несколько аппаратных и программных техник.

Три кита параллелизма в Olmo-core 3
Я выделил три основные стратегии разделения модели и её тренировочного состояния по оборудованию:
- Параллелизм экспертов распределяет их пулы по разным GPU, избавляя каждый отдельный чип от хранения всей структуры целиком.
- Параллелизм пайплайна делит последовательные слои модели между группами устройств, снижая требования к объему памяти.
- Распределенный оптимизатор разделяет вспомогательные данные для вычисления градиентов между устройствами вместо дублирования полной копии.
Снижение издержек на маршрутизацию и формат MXFP8
Кроме того, разработчики минимизировали затраты на пересылку данных. Метод rowwise expert parallelism отправляет входящие блоки прямо в буферы экспертов, а GPU-resident routing удерживает служебную информацию о маршрутах локально на видеокартах. Поддержка формата пониженной точности MXFP8 позволяет задействовать меньше бит для ряда вычислений, увеличивая общую скорость обработки примерно на 21% по сравнению с базовым BF16 и снижая пиковое потребление памяти со 103 до 95 ГиБ.

Масштабирование до триллионных конфигураций
Тестирование инфраструктуры на ускорителях NVIDIA B300 продемонстрировало впечатляющие результаты. Команда запустила конфигурацию с 1.2 триллионами параметров (из которых 58.36 млрд были активны на токен) на 512 графических чипах, достигнув пиковой производительности в 858 TFLOP/s/GPU. Дополнительные эксперименты с альтернативным модулем коммуникации DeepEP v2 позволили протестировать гигантскую модель на 2.38 триллиона параметров.
Помимо чистой производительности, инженеры исследовали множество скрытых проблем обучения. Например, они столкнулись с феноменом «token gerrymandering», когда метрики балансировки улучшались вопреки ухудшению реальной равномерности нагрузки. Подобные практические выводы делают технический отчёт крайне полезным документом для глубокого изучения специфики масштабирования.
Открытая база для будущих поколений ИИ
Созданный программный стек выступает фундаментом для грядущего поколения моделей Olmo, которые получат MoE-архитектуру, увеличенный контекст и самую большую обучающую выборку в истории проекта. Важнейшим принципом остается полная открытость: исследователи могут использовать код на GitHub, адаптировать его под собственное железо и экспериментировать с алгоритмами маршрутизации, развивая индустрию открытого искусственного интеллекта.
