
Мой блог
Intel анонсировала характеристики ИИ-ускорителя GPU D-Series

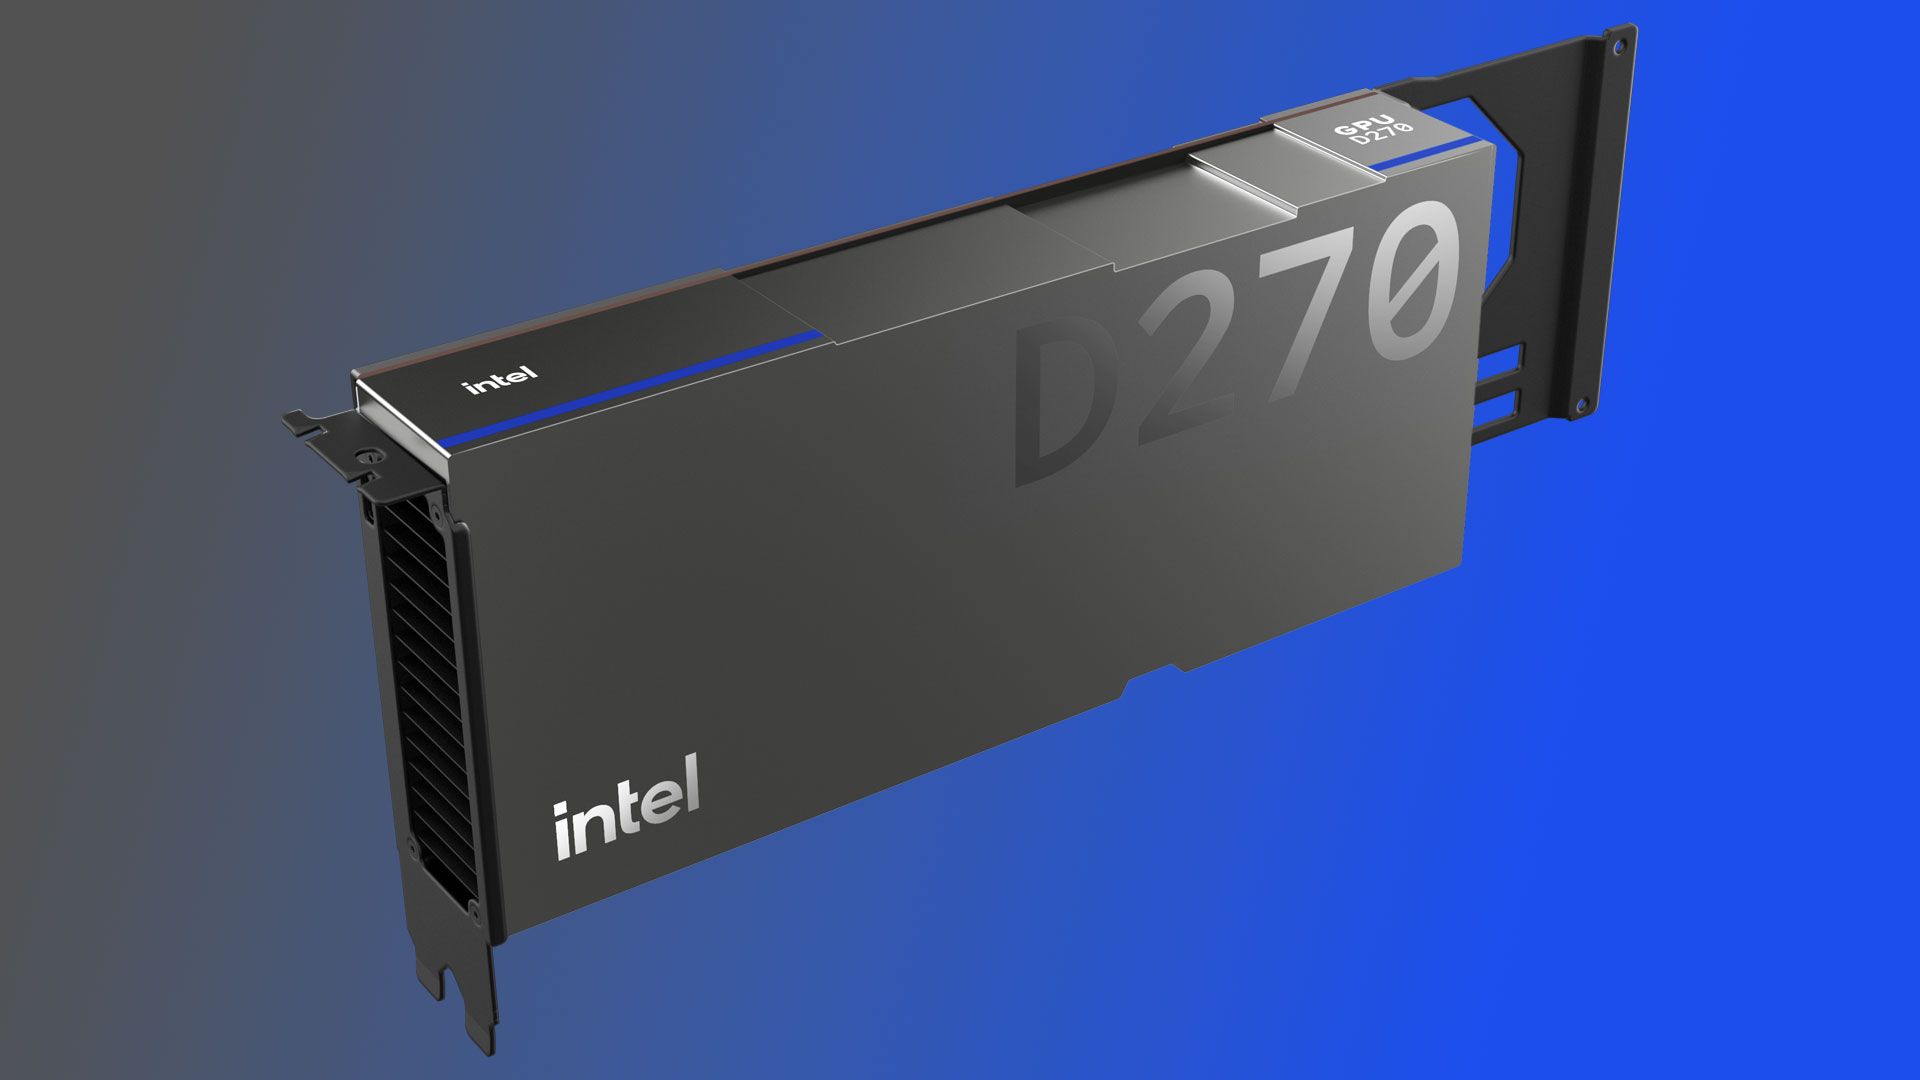
Компания Intel официально представила подробные технические параметры своего нового чипа для инференса искусственного интеллекта, ранее известного под кодовым названием Crescent Island. Новое семейство продукции получило официальное наименование Intel GPU D-Series и ориентировано на развертывание в традиционных стоечных серверах с воздушным охлаждением.
В ходе отраслевого мероприятия OCP 2026 разработчики раскрыли ключевые показатели производительности и пропускной способности памяти устройств. Ожидается, что аппаратная платформа займет собственную нишу в инфраструктуре корпоративных дата-центров, предложив альтернативные требования к тепловыделению и энергопотреблению по сравнению с передовыми решениями конкурентов.
Архитектура и производительность чипа
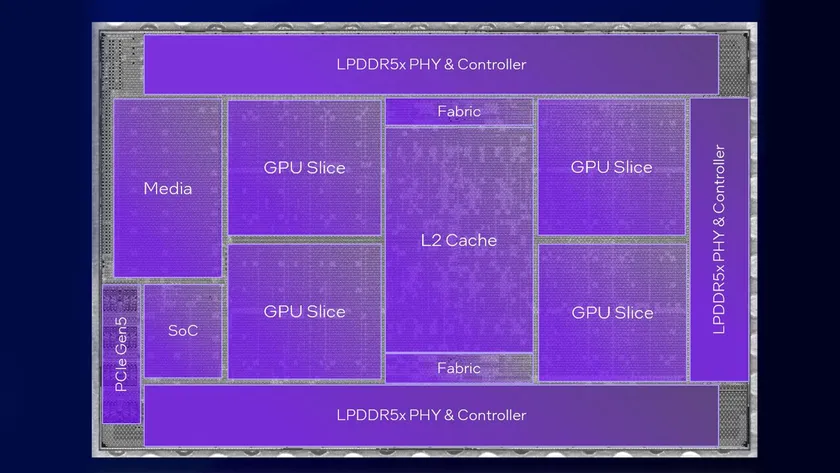
Новый ускоритель базируется на фирменной архитектуре Xe3P, которая представляет собой массивную параллельную вычислительную систему без традиционных графических функциональных блоков, поскольку чип практически полностью лишен графических модулей. По заявлению разработчиков, теоретическая пиковая производительность чипа в вычислениях FP8 достигает 1.3 петафлопса (PFLOPS), а финальная пропускная способность памяти составляет 1.5 ТБ/с.
Устройства серии будут поставляться в форм-факторе PCIe с воздушным охлаждением, при этом уровень энергопотребления (TDP) составит 350 Вт, а объем памяти может достигать 480 ГБ LPDDR5X (включая конфигурации вроде 160 ГБ). Для сравнения, каждый из 72 графических процессоров Rubin в стоечной системе Nvidia Vera Rubin NVL72 может обеспечивать теоретические 17.5 PFLOPS производительности FP8, однако такие чипы требуют жидкостного охлаждения и имеют энергопотребление в киловаттах. Intel GPU D-Series нацелена на принципиально иной класс инфраструктуры и тепловых пакетов.
Инфраструктура и сценарии применения
Платформа рассчитана на интеграцию в стандартные воздушные серверные стойки с масштабированием до восьми графических процессоров (подобно системам Nvidia HGX). Подобная конфигурация позволяет обрабатывать запросы инференса для моделей, насчитывающих свыше одного триллиона параметров.
Область применения чипов охватывает масштабные языковые модели (LLM), задачи с длинным контекстом и одновременное обслуживание нескольких параллельных запросов. Подобная архитектура востребована в многопользовательских сервисах искусственного интеллекта, робототехнике и других сценариях, критичных к задержкам.
Программная экосистема
Для слаженной работы распределенного инференса, где несколько ускорителей функционируют как единое целое, требуется надежный программный стек. Представители компании подчеркивают роль единой программной основы Xe, которая объединяет искусственный интеллект на базе ядер Xe в интегрированных и дискретных графических продуктах.
В настоящее время Intel сотрудничает с широким кругом производителей оригинального оборудования (OEM), разработчиков аппаратного обеспечения (ODM), неооблаков, независимых поставщиков программного обеспечения, провайдеров аппаратных решений и AI-компаний для вывода ускорителей в дата-центры. На текущем этапе уже ведется рассылка ознакомительных образцов заказчикам, однако точные сроки полноценного рыночного запуска пока не уточняются.
