Мой блог
Как сделать мультфильм нейросетью: от сценария до озвучки и монтажа

Современные технологии генерации видео открывают возможности для создания анимации без использования классических инструментов рисования. В данном материале подробно разбирается процесс создания мультфильма при помощи нейросетей, начиная от формирования идеи и заканчивая финальным сведением звука. Тестирование различных моделей позволяет оценить, насколько эффективно ИИ справляется с динамичными сценами, сохранением внешности персонажей и воспроизведением русской речи.
Для реализации проекта такого типа требуется комплексный подход: текстовая модель для сценария, видеогенератор для визуального ряда, инструменты синтеза речи и видеоредактор для сборки. В ходе экспериментов авторы первоисточника проверили работу актуальных нейросетей в режимах генерации по тексту и на основе готовых изображений, выявив характерные ошибки и сильные стороны каждой технологии.
Прямая генерация мультфильма по текстовому описанию
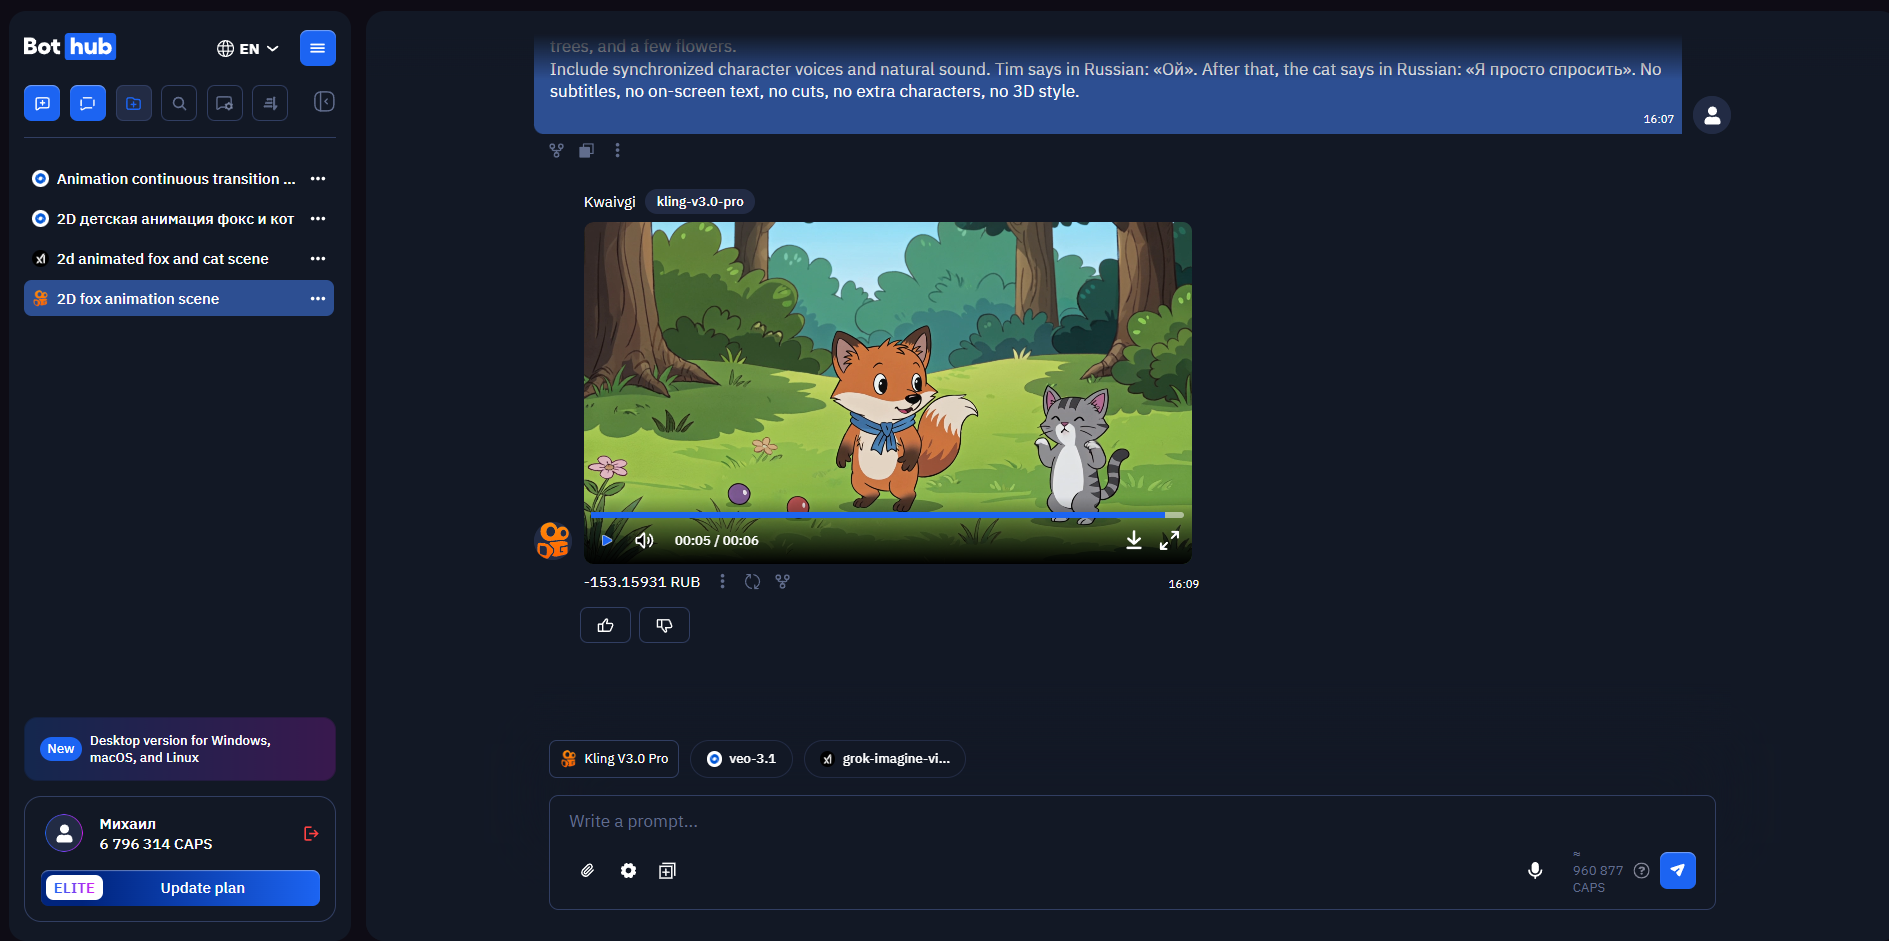
Метод генерации «текст в видео» (text-to-video) считается наиболее быстрым, так как требует от пользователя только грамотно составленного промпта. Однако этот способ сопряжен с рисками: нейросеть может произвольно менять детали окружения или внешность героев от кадра к кадру. Для проверки возможностей моделей был составлен сложный сценарий, включающий двух персонажей — лисенка Тима и кота — на лесной поляне.
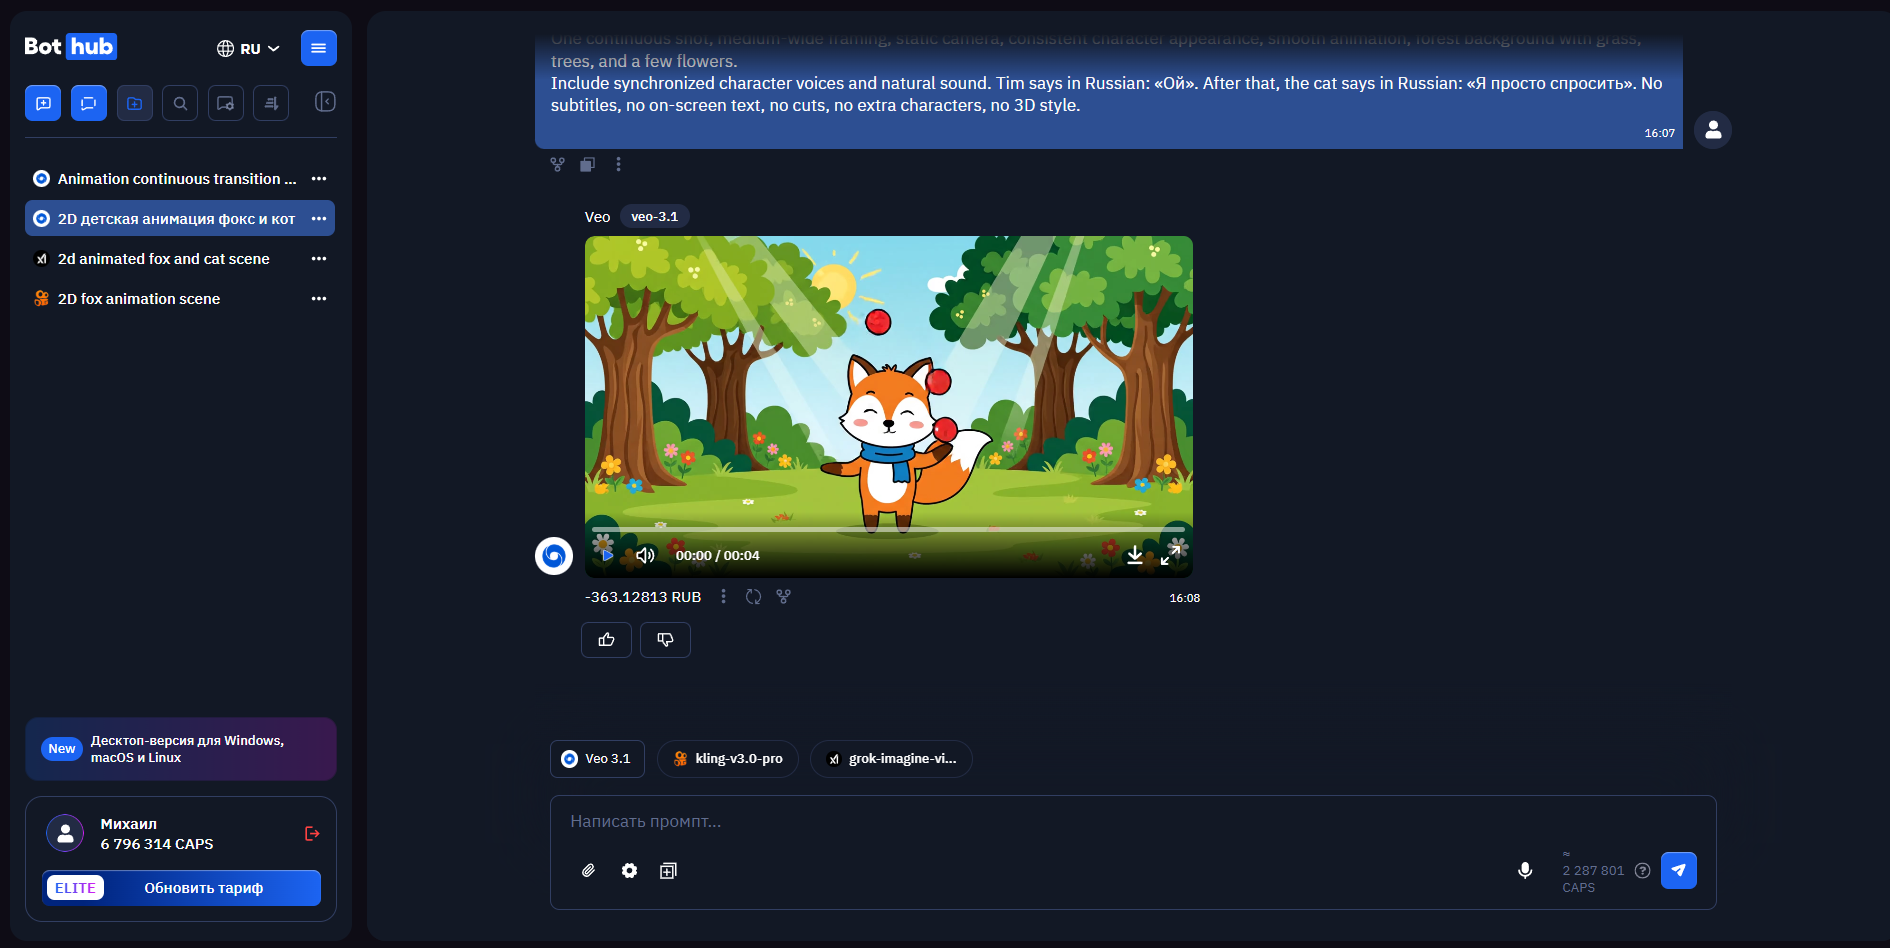
В тестовое задание специально заложили несколько «ловушек» для проверки физики и логики: лисенок должен жонглировать мячами, которые при появлении кота падают на землю. Это позволяет увидеть, сохранит ли алгоритм количество объектов, их цвет и траекторию движения. Также проверялась способность моделей озвучивать героев на русском языке с соблюдением синхронизации губ.
Тестирование модели Kling V3.0 Pro
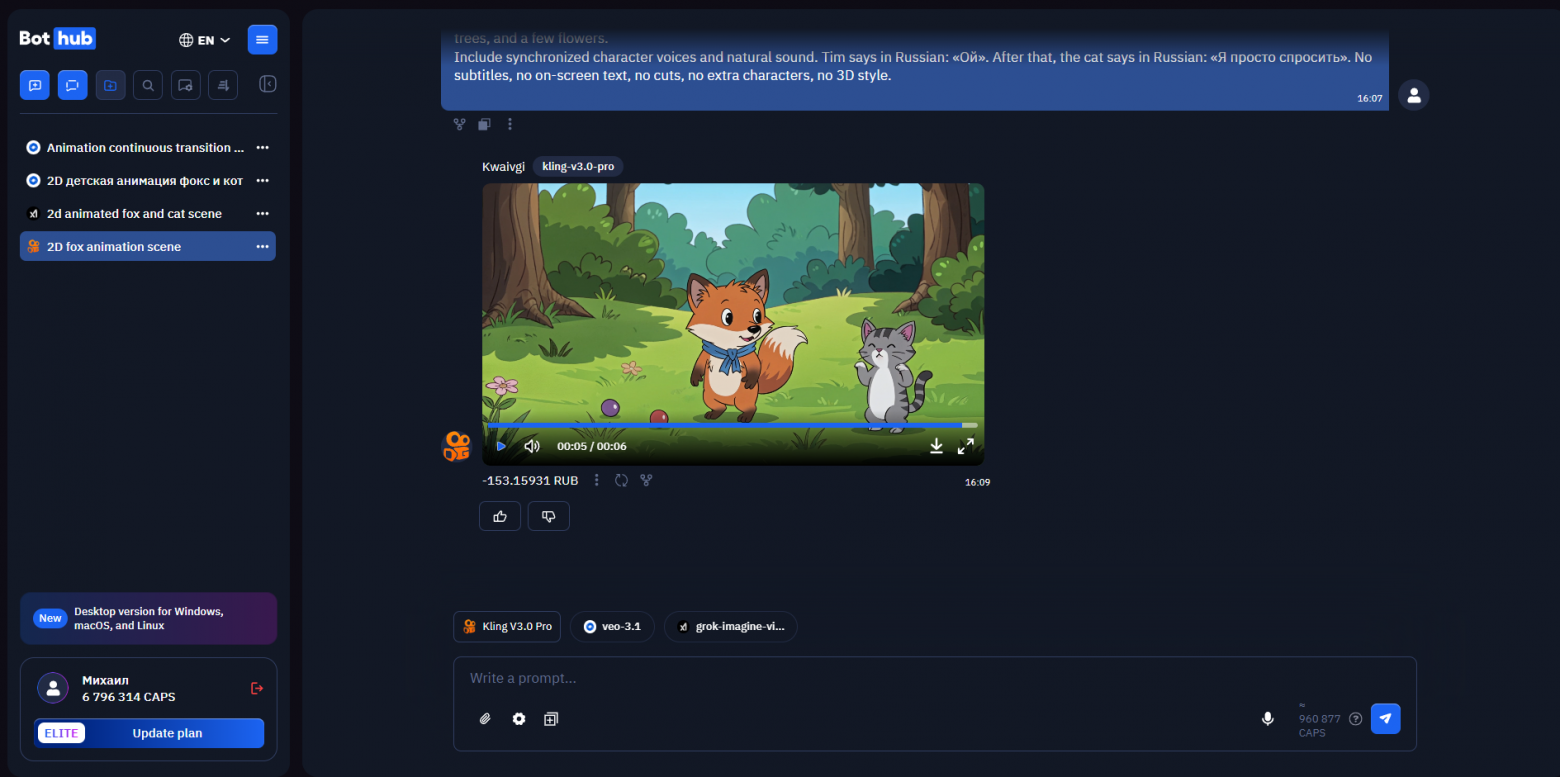
При использовании Kling V3.0 Pro от разработчиков Kuaishou Technology анимация получилась плавной, а движения антропоморфных животных — естественными. В материале отмечается, что графика выглядит аккуратно, хотя в динамичных моментах заметно характерное для нейросетей размытие. Главным недостатком модели стала работа с мелкими объектами: мячи для жонглирования меняли цвет в полете или бесследно исчезали, пролетая сквозь конечности персонажа.
С озвучкой модель также не справилась в полной мере. Несмотря на четкое указание в промпте использовать русский язык, персонажи заговорили на английском. Стоимость создания одной шестисекундной сцены в этой модели составила 153 рубля.
Результаты работы Veo 3.1
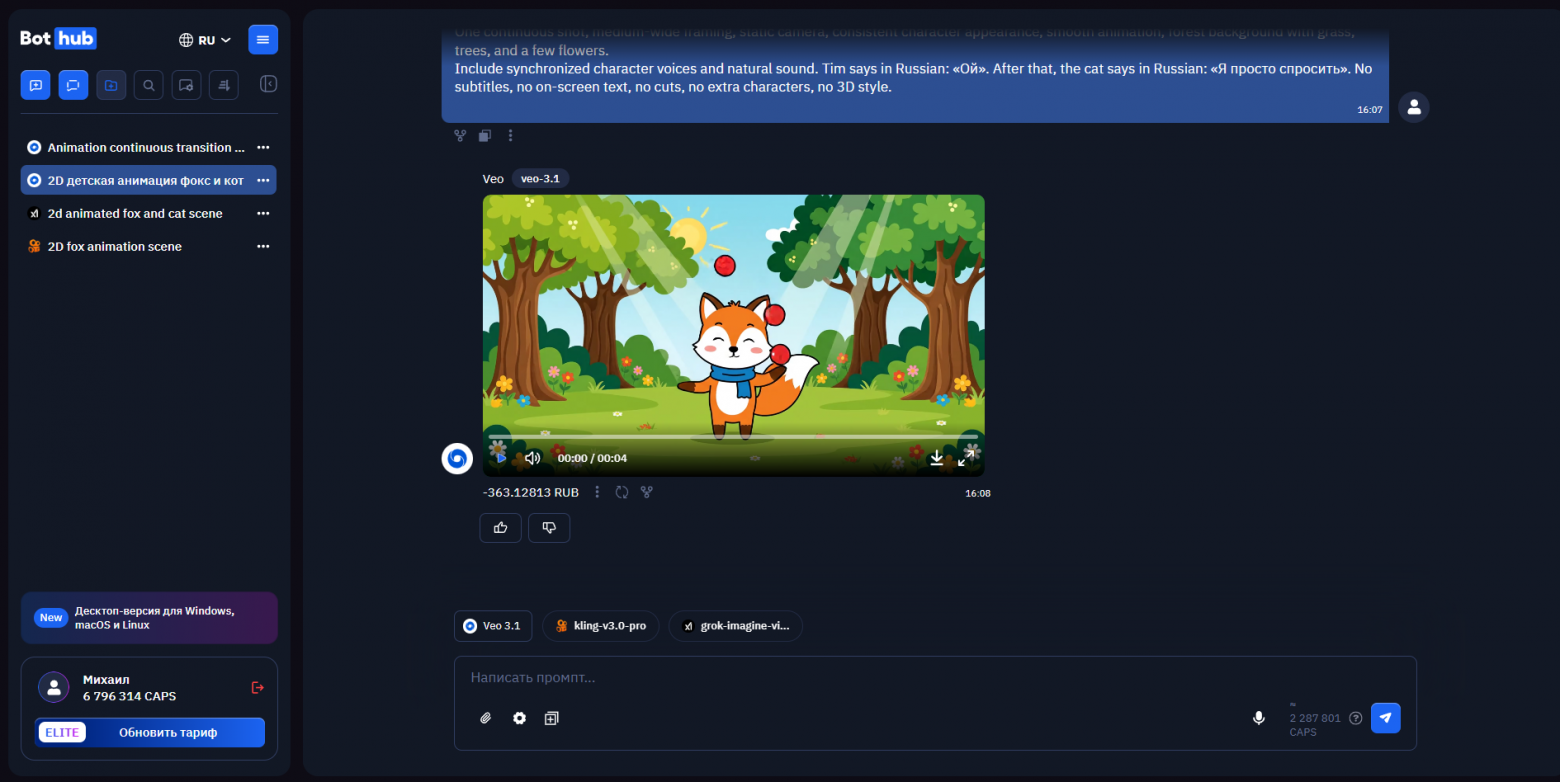
Нейросеть Veo 3.1 от Google DeepMind показала более скромные результаты в режиме прямой генерации. Графика была охарактеризована как примитивная, а взаимодействие персонажей оказалось нескоординированным. Одной из критических ошибок стало слияние нескольких мячей в один объект к концу сцены. Кроме того, модель проигнорировала распределение реплик: все фразы произнес один персонаж, а лицо второго героя заметно исказилось. Генерация четырехсекундного ролика в Veo 3.1 обошлась дороже остальных участников теста — 363 рубля.
Возможности Grok Imagine Video 1.5
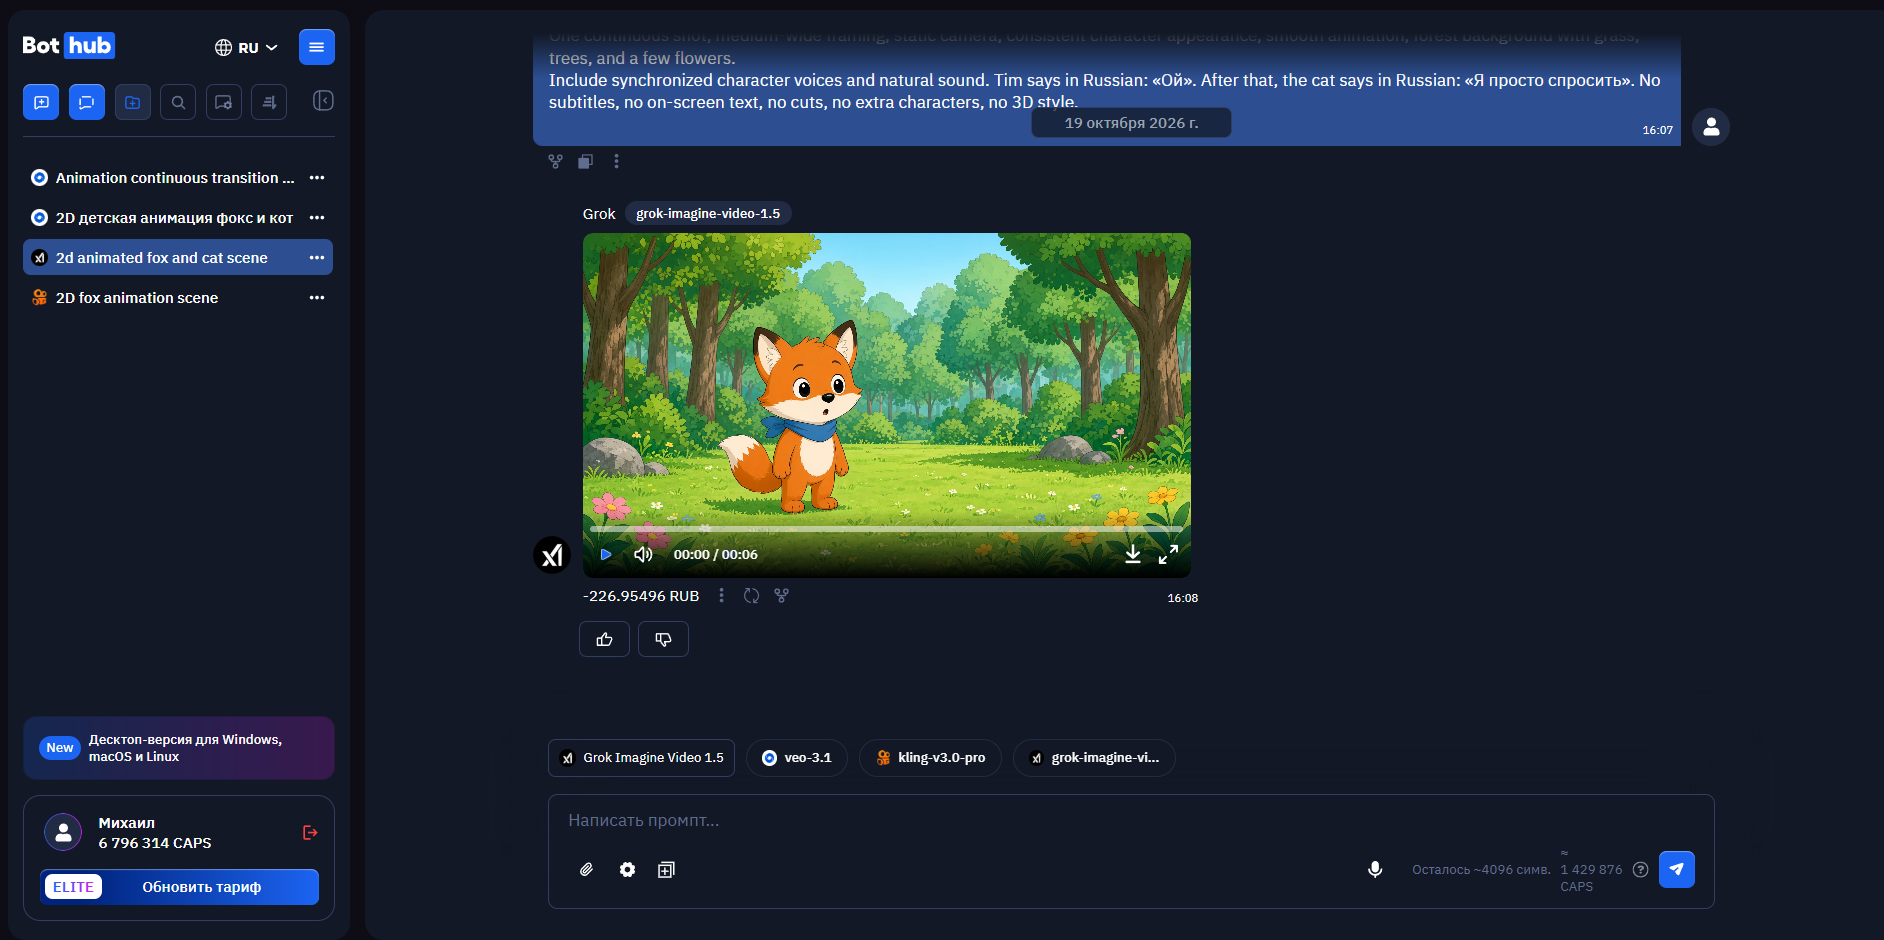
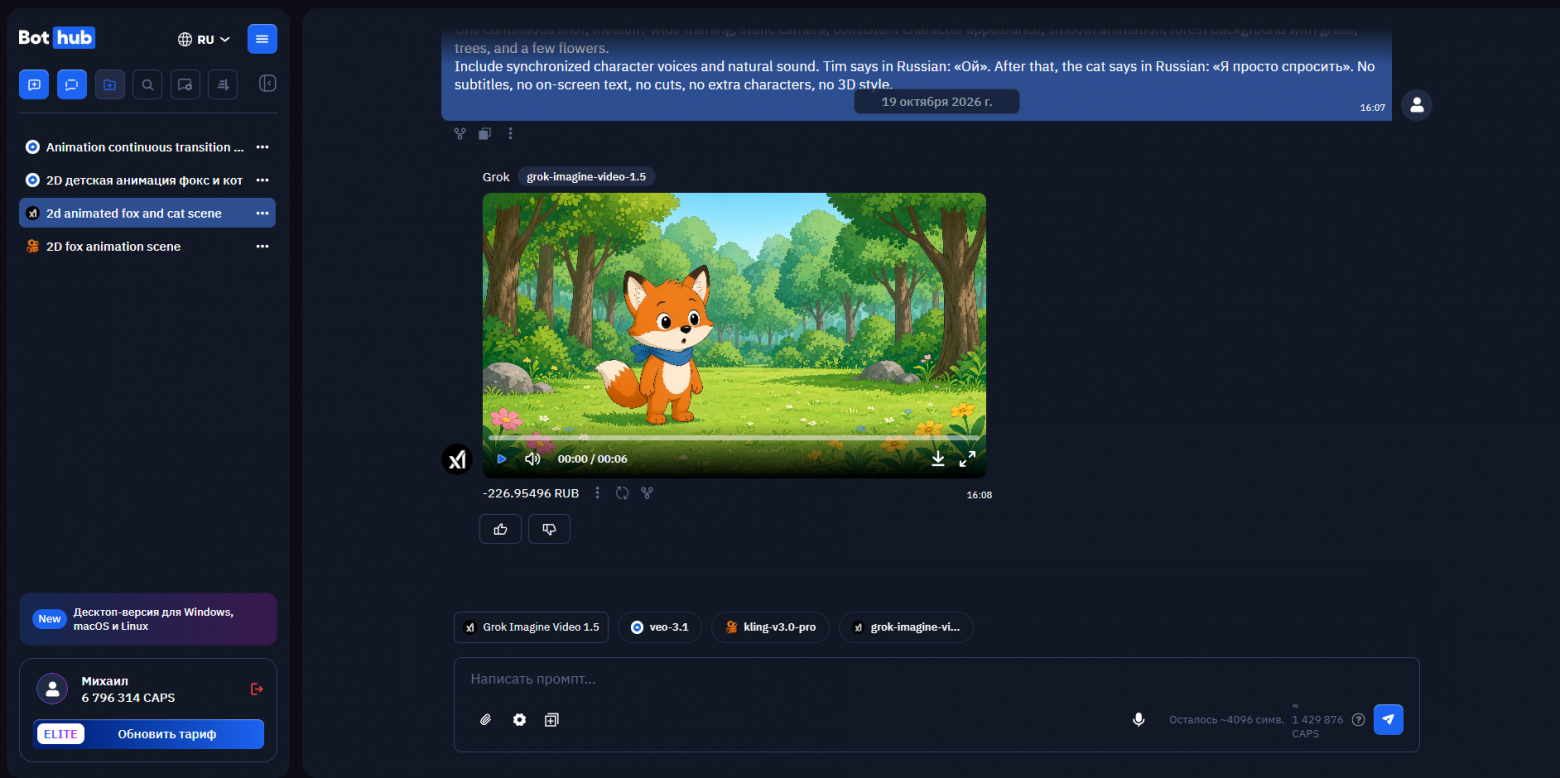
Модель от компании Илона Маска продемонстрировала наиболее эстетичный результат в рамках данного теста. Визуальный ряд получился насыщенным, а движения персонажей — выразительными. Grok Imagine Video 1.5 лучше других справилась с озвучкой: герои произносили фразы вовремя и с нужной интонацией, хотя и говорили одним и тем же голосом. Ошибки в физике объектов сохранились — при падении количество мячей увеличилось с трех до пяти, однако по совокупности факторов (цена, качество и плавность) эта модель стала лидером сравнения.
Создание анимации через раскадровку и референсы
Более предсказуемый и качественный результат дает метод «изображение в видео» (image-to-video). Он позволяет зафиксировать внешность героя и композицию кадра до начала анимации. В материале показан поэтапный процесс работы с моделью Veo 3.1, используя ее способность анимировать переход между первым и последним ключевыми кадрами.
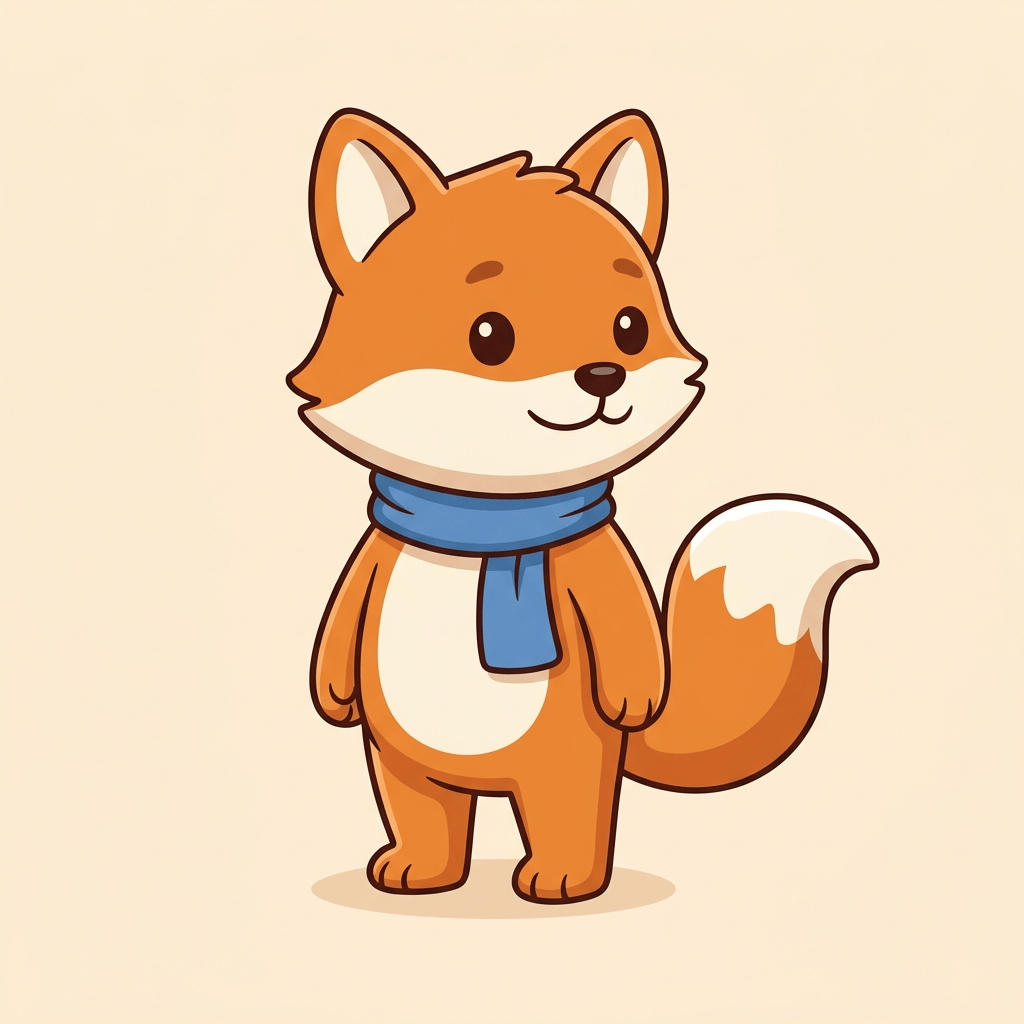
Фиксация внешности персонажа
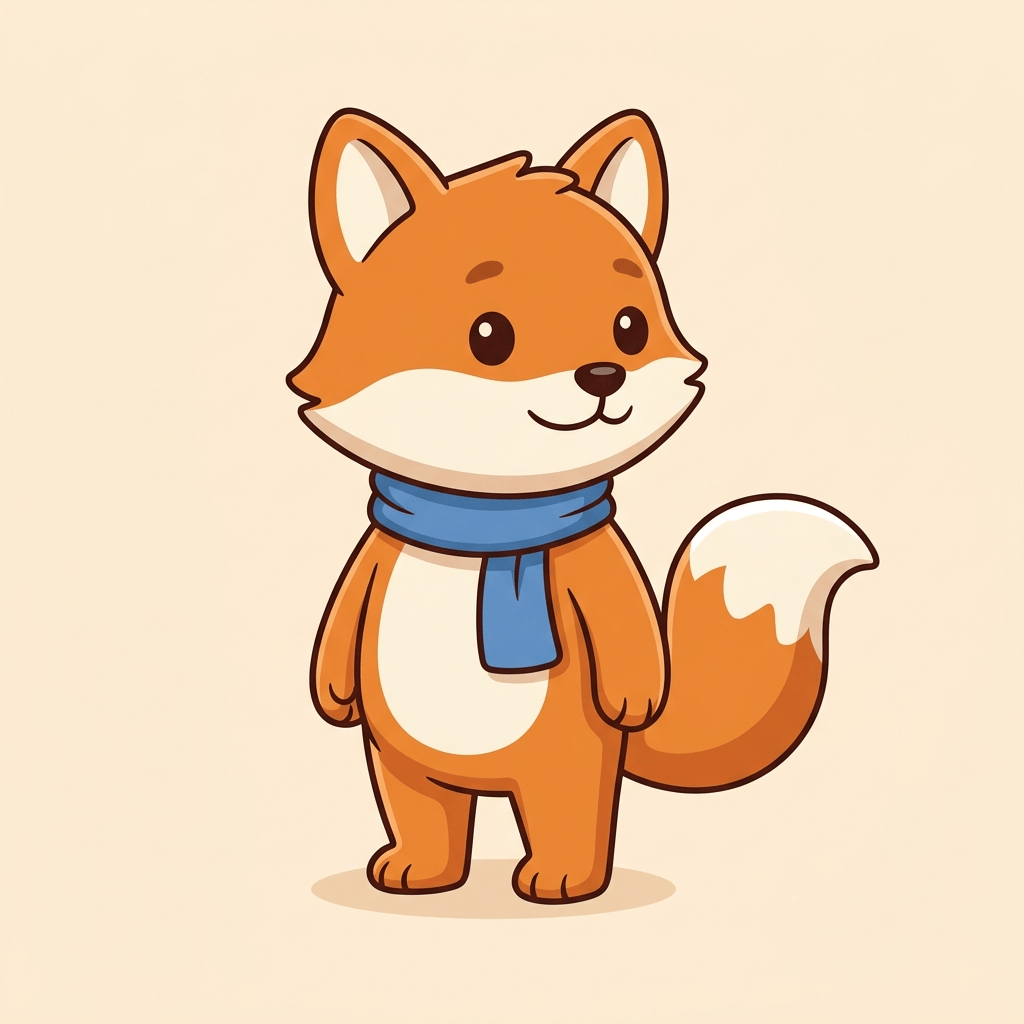
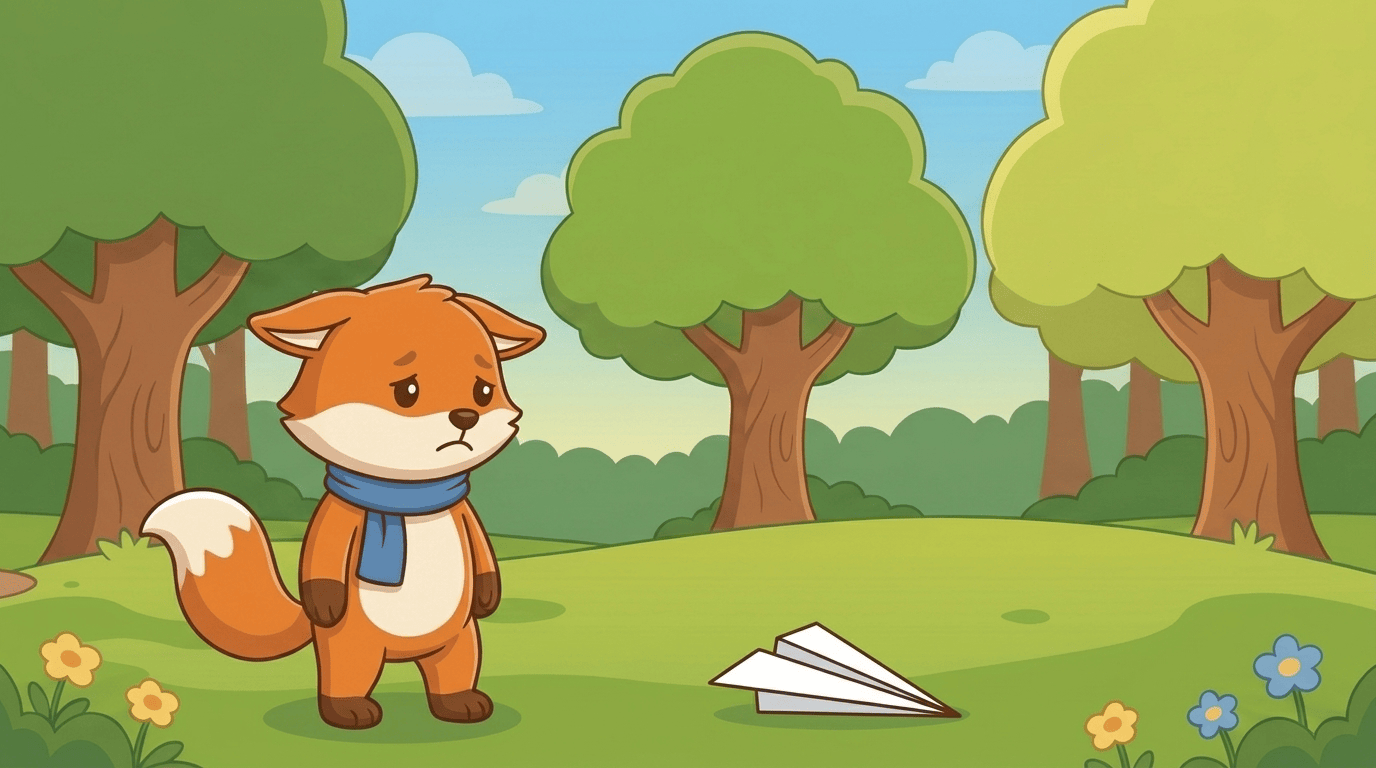
Первым шагом создается эталонное изображение героя (референс). Важно подробно описать детали: цвет шерсти, особенности одежды (например, синий шарф без узоров) и пропорции тела. Использование одного и того же изображения в качестве основы для всех последующих генераций гарантирует, что лисенок в начале мультфильма будет выглядеть так же, как и в конце. На этом этапе важно отсеять неудачные варианты с неправильным количеством лап или дефектами стиля.
Подготовка ключевых кадров для планов
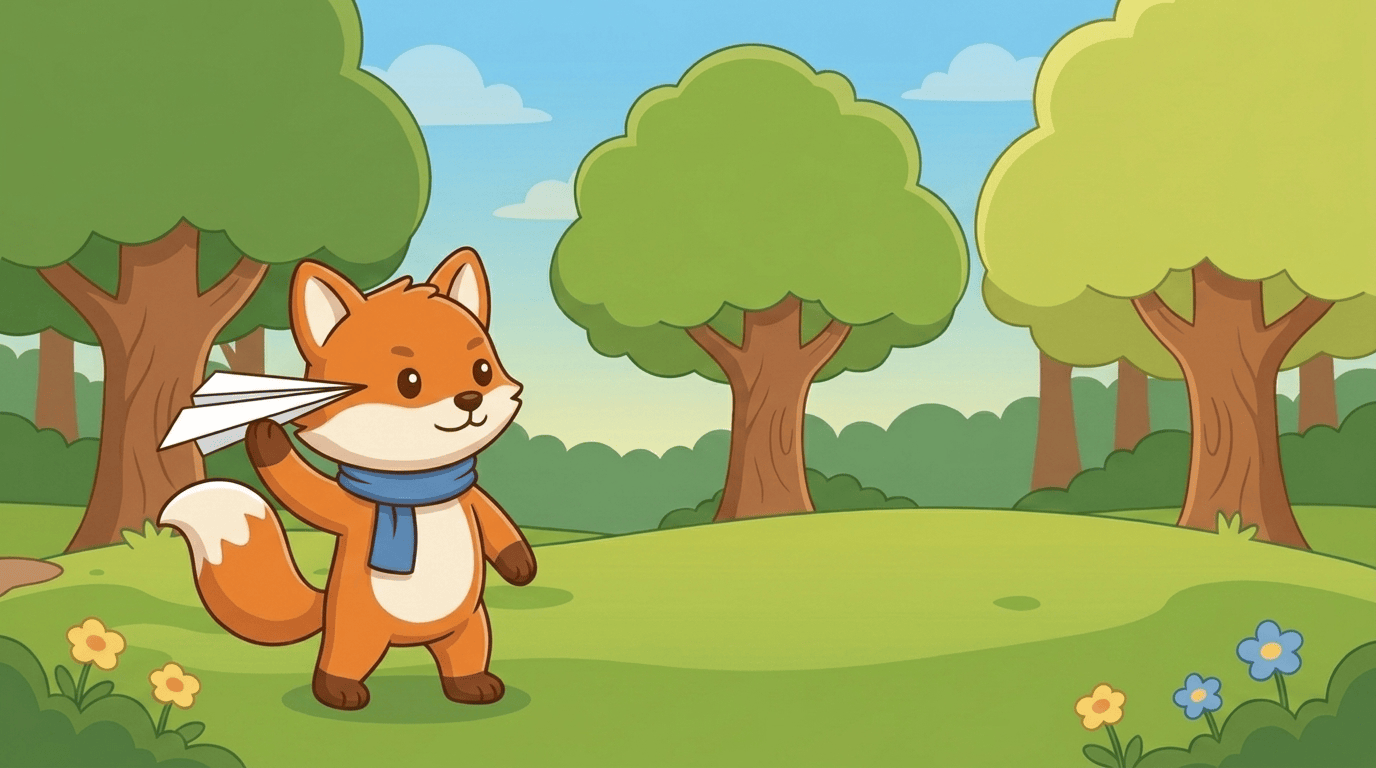
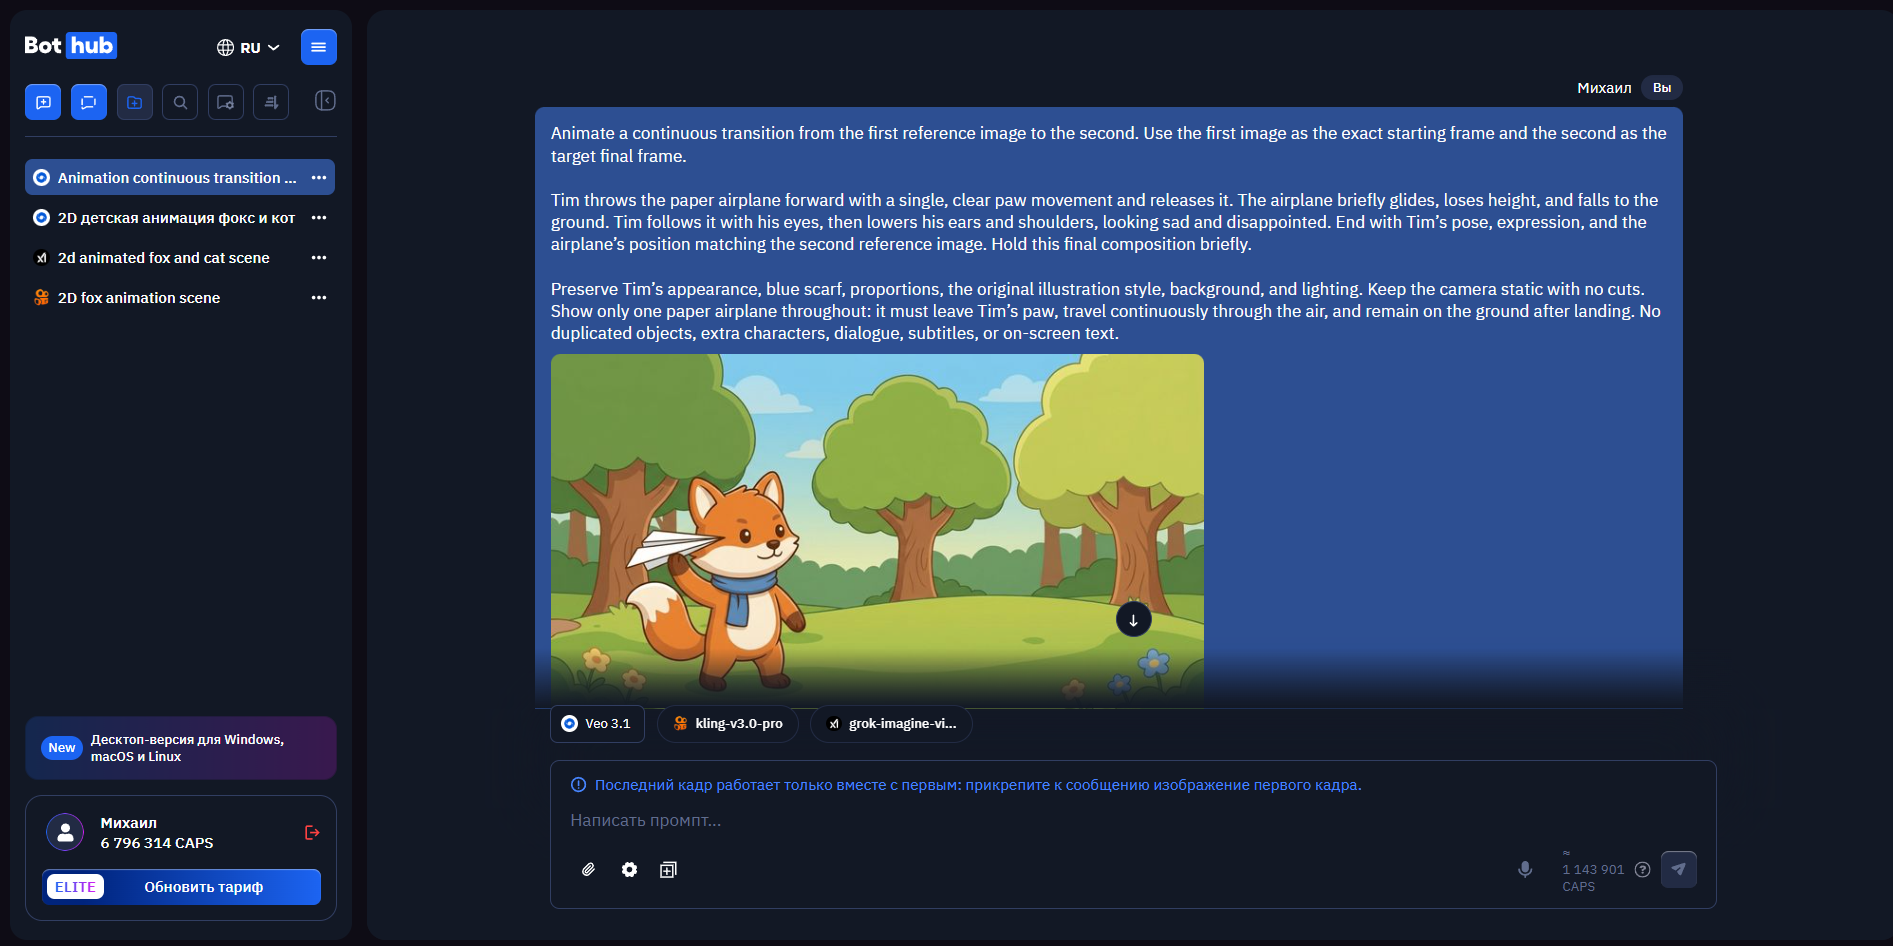
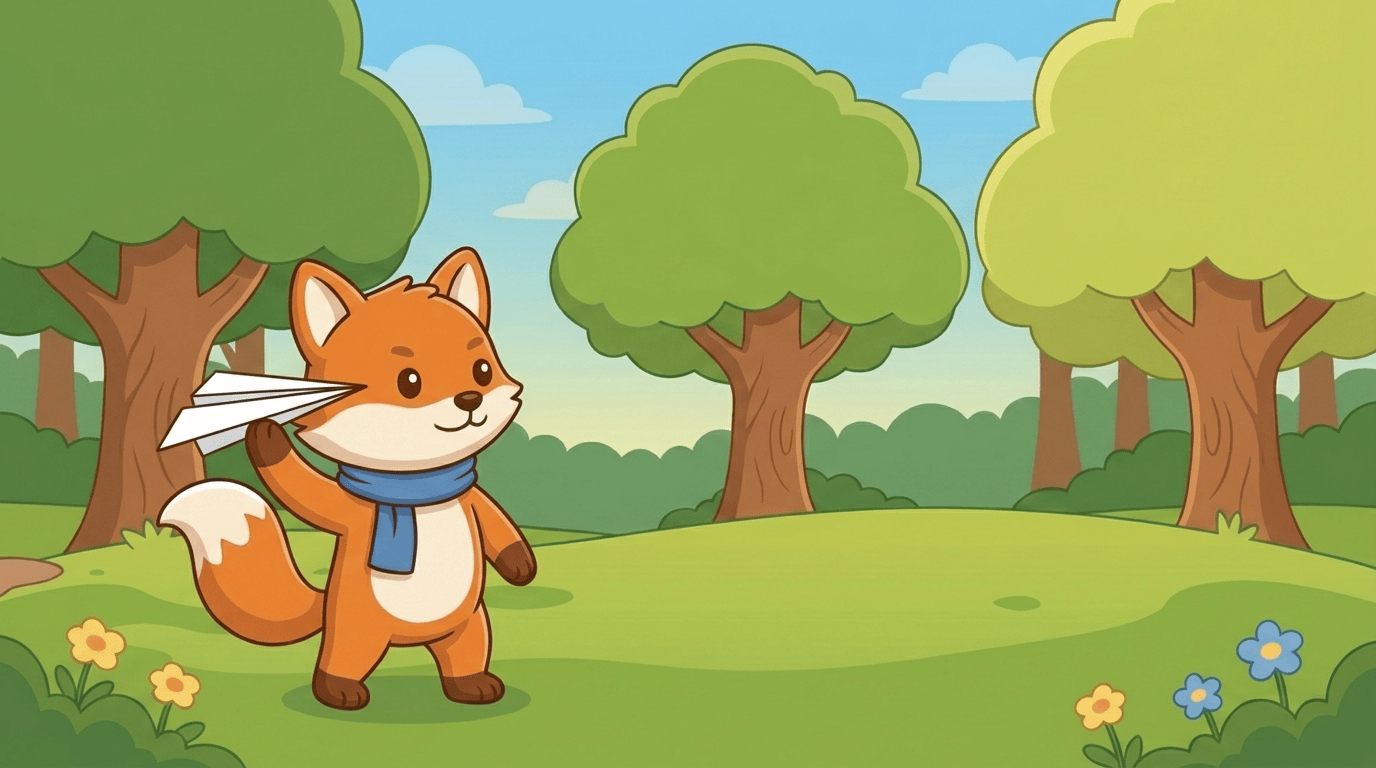
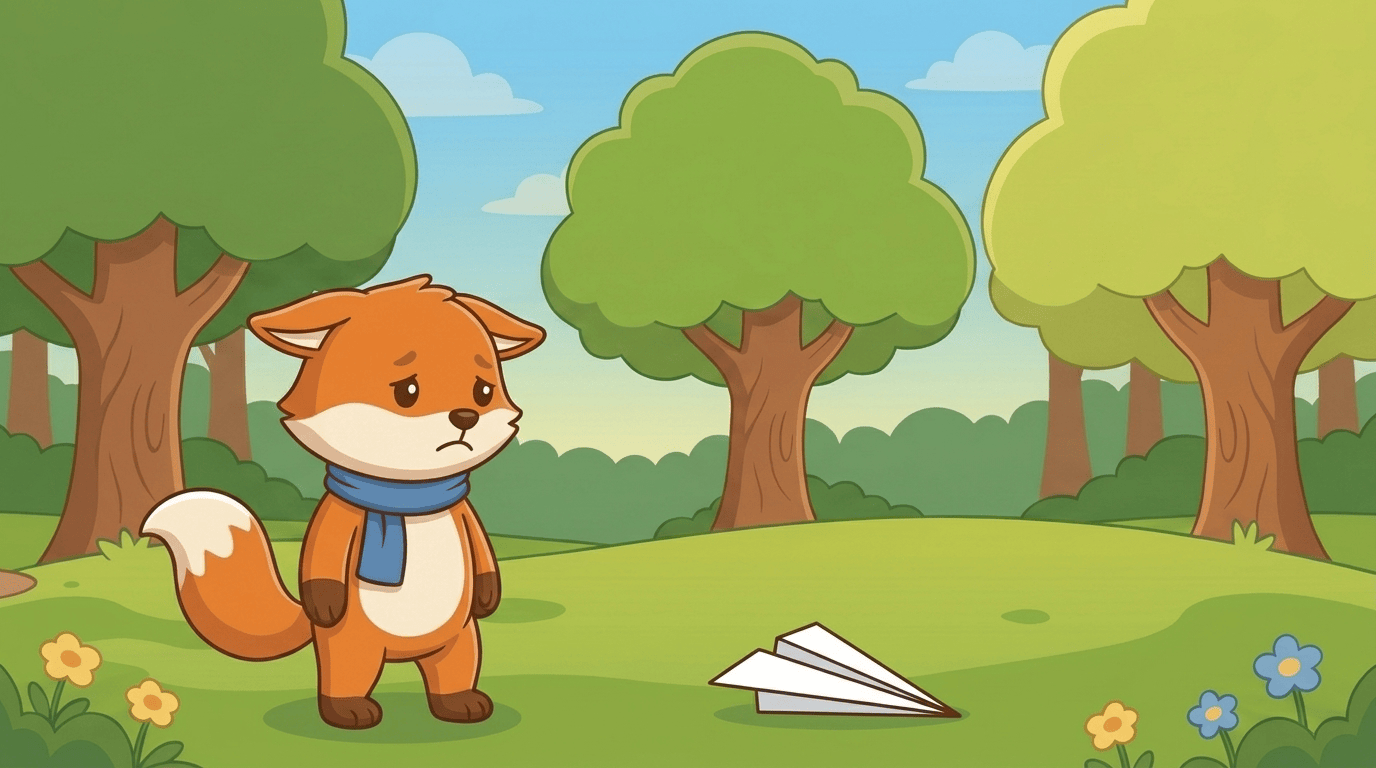
Для создания сцены броска бумажного самолетика потребовалось два изображения в формате 16:9. На первом кадре лисенок держит самолет в лапе, стоя в левой части кадра, а правая часть оставлена свободной для будущего движения. Второй кадр фиксирует финал сцены: самолет лежит на земле, а герой выглядит расстроенным. Важно сохранять единство стиля, освещения и фона на обоих изображениях, чтобы при анимации не возникло визуальных скачков.
Оживление моментов через промпт
При запуске генерации видео загружаются оба кадра, а в текстовом описании указывается задача: осуществить плавный переход от первого изображения ко второму. Модель должна имитировать физику полета самолета и мимику персонажа. В ходе теста Veo 3.1 успешно справилась с траекторией полета и даже добавила эффект пыли при приземлении предмета. Однако возникли анатомические ошибки: лапа героя на мгновение прошла сквозь шею, а в глазах, которые изначально были просто черными точками, появились белки. Несмотря на это, метод раскадровки позволил добиться гораздо более точного следования сценарию, чем прямая генерация по тексту.
Выбор метода: текст против раскадровки
Выбор технологии зависит от сложности проекта. Генерация по тексту (text-to-video) оптимальна для коротких зарисовок, визуальных шуток или быстрого поиска идей, когда точное сохранение внешности героя не критично. Для связной истории с повторяющимся персонажем необходимо использовать раскадровку (image-to-video). Это требует больше времени и ресурсов на создание статичных кадров, но дает контроль над композицией и дизайном персонажа.
Работа со звуком и озвучкой на русском языке
Существует два подхода к работе со звуком. Некоторые видеомодели позволяют генерировать речь одновременно с видео, но это ограничивает возможности редактирования. Более гибким вариантом является создание отдельной аудиодорожки с помощью специализированных сервисов, таких как ElevenLabs. Это позволяет корректировать темп, ударения и интонации без повторной перегенерации всего видеоряда.
При подготовке текста для синтеза речи рекомендуется соблюдать правила:
- Всегда проставлять букву «ё», чтобы избежать ошибок в произношении;
- Расшифровывать сокращения и числительные;
- Использовать знаки препинания для управления паузами;
- Удалять из текста фразы, которые уже очевидны из видеоряда (например, «он посмотрел на небо»).
Если предполагается, что персонаж должен говорить непосредственно в кадре, потребуется дополнительная обработка для синхронизации движений губ (lip-sync), иначе простая замена аудиодорожки будет выглядеть неестественно.
Финальный монтаж и сведение
На этапе сборки в монтажном редакторе планы выстраиваются в нужной последовательности, обрезаются неудачные моменты и подгоняется длительность кадров под ритм закадрового рассказа. Не стоит стремиться заполнять каждую секунду речью — зрителю нужно время, чтобы рассмотреть действие. Кроме голоса, важно добавить фоновые шумы: шелест листвы, звуки шагов или природы. Это делает мультфильм более живым. При экспорте готового ролика следует сохранять единую частоту кадров и соотношение сторон, чтобы избежать искажений.
Экономика и рекомендации для начинающих
Создание анимации нейросетями не всегда является бесплатным процессом. Бюджет проекта складывается не из финального хронометража, а из количества попыток генерации каждого плана. По оценкам, приведенным в материале, на создание качественного десятиминутного мультфильма может потребоваться около 20 000 рублей, учитывая необходимость переделывать неудачные дубли.
Для первого проекта рекомендуется выбирать простую историю с одним героем и одной локацией на 20–30 секунд. Начинать лучше с одного полностью законченного фрагмента, где отработаны и движение, и звук, и только после этого переходить к созданию остальных сцен по той же схеме.