
Мой блог
Как работает фильтр Калмана в цикле правок ИИ-агентов

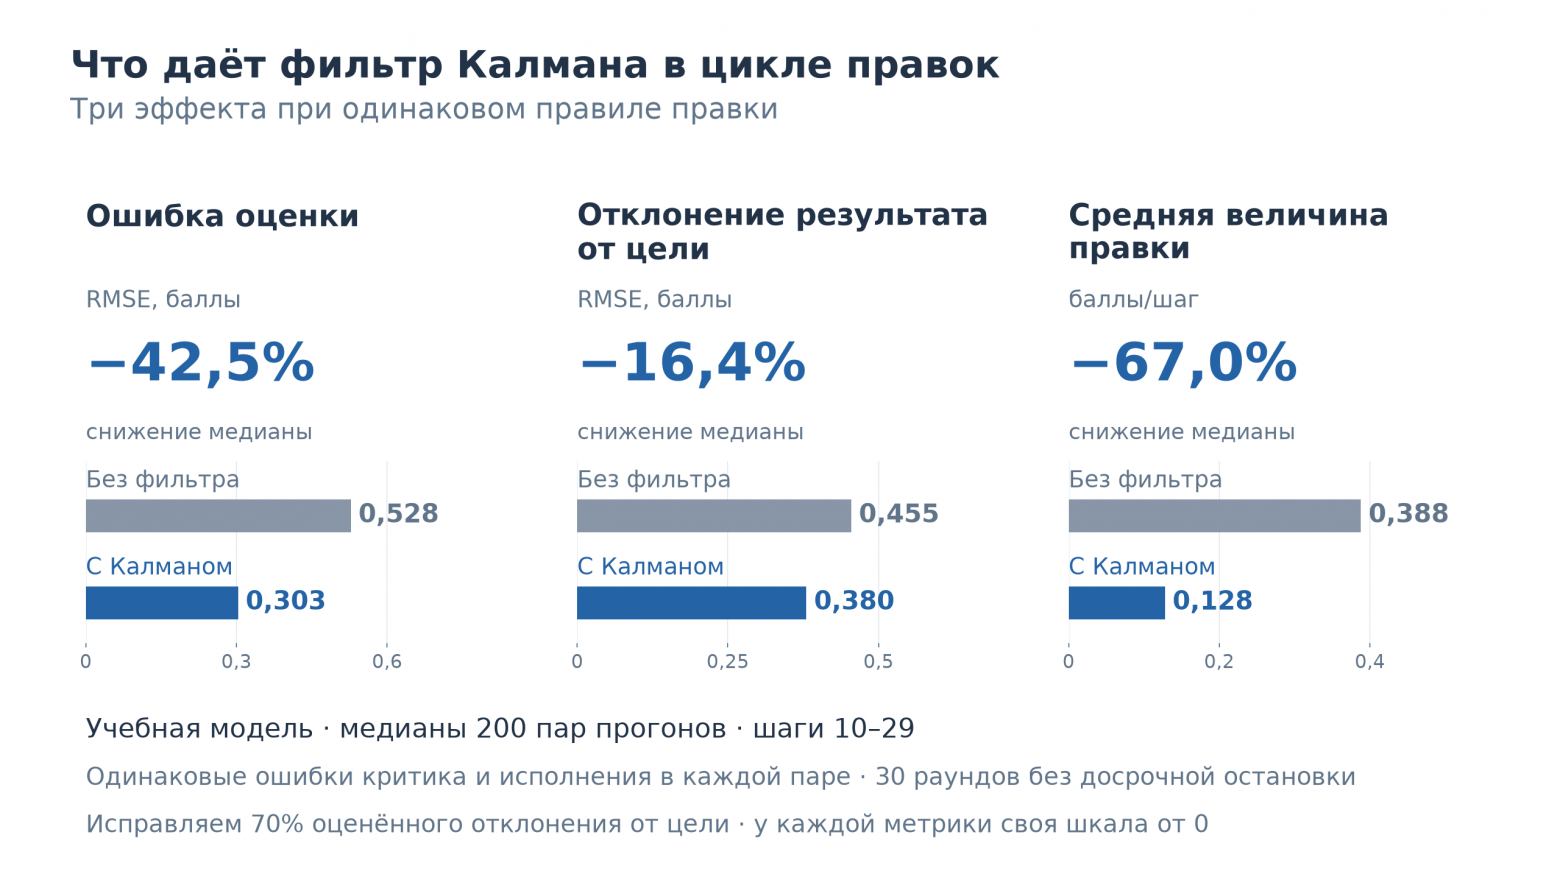
Исследование процессов взаимодействия ИИ-агентов и критиков показывает, что автоматические исправления без учета теории управления часто приводят к избыточным итерациям. На основе численных симуляций можно оценить, как работает фильтр Калмана в цикле правок, снизить уровень шума и уменьшить количество лишних переписываний кода.
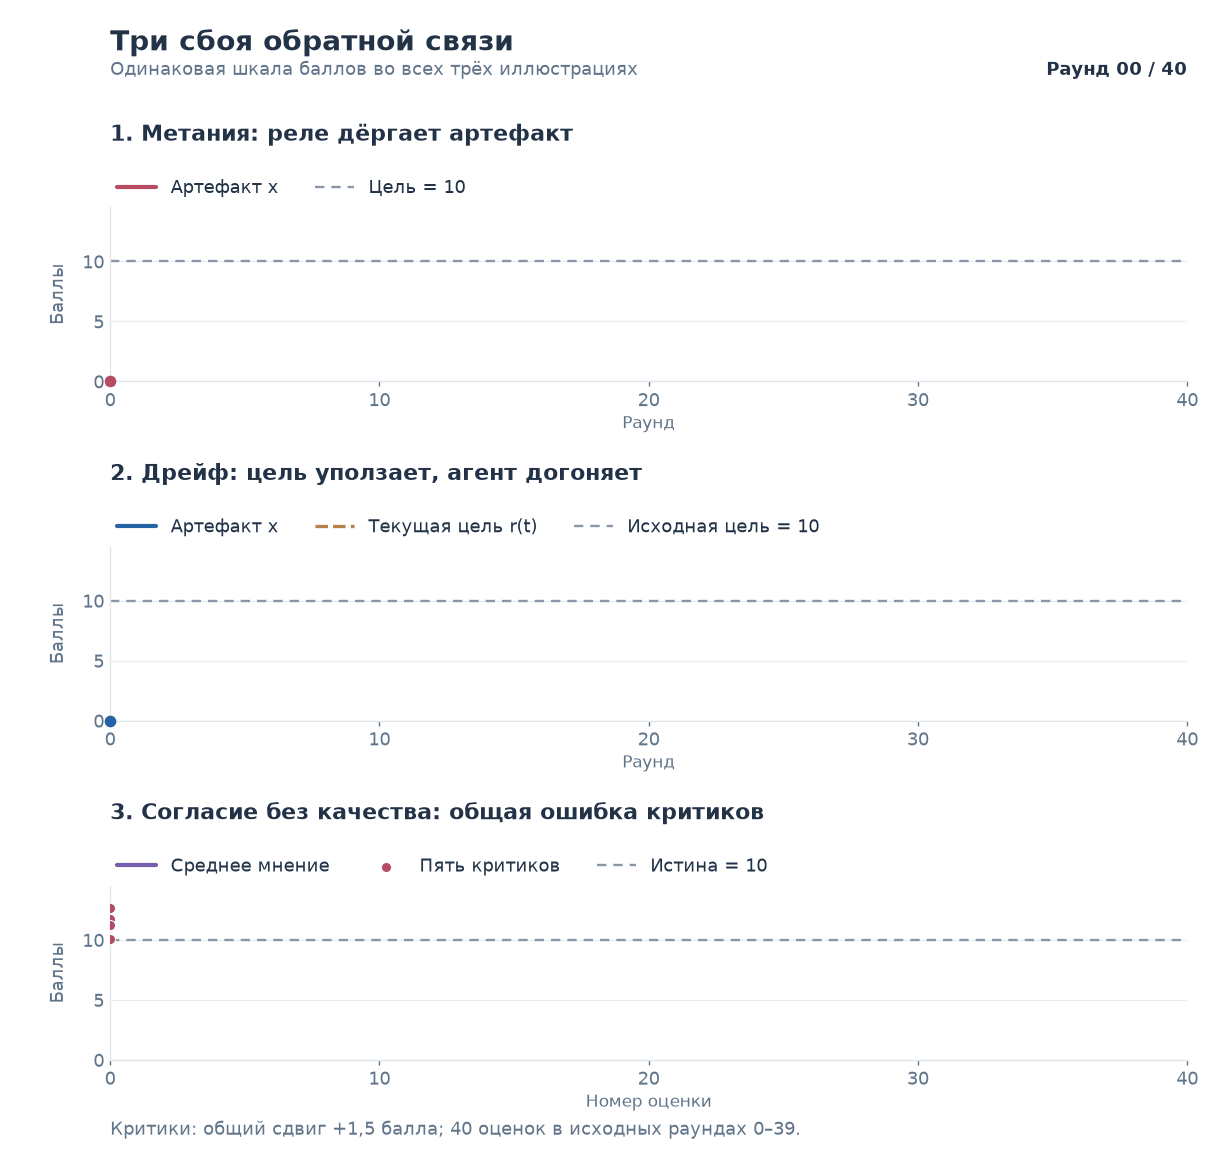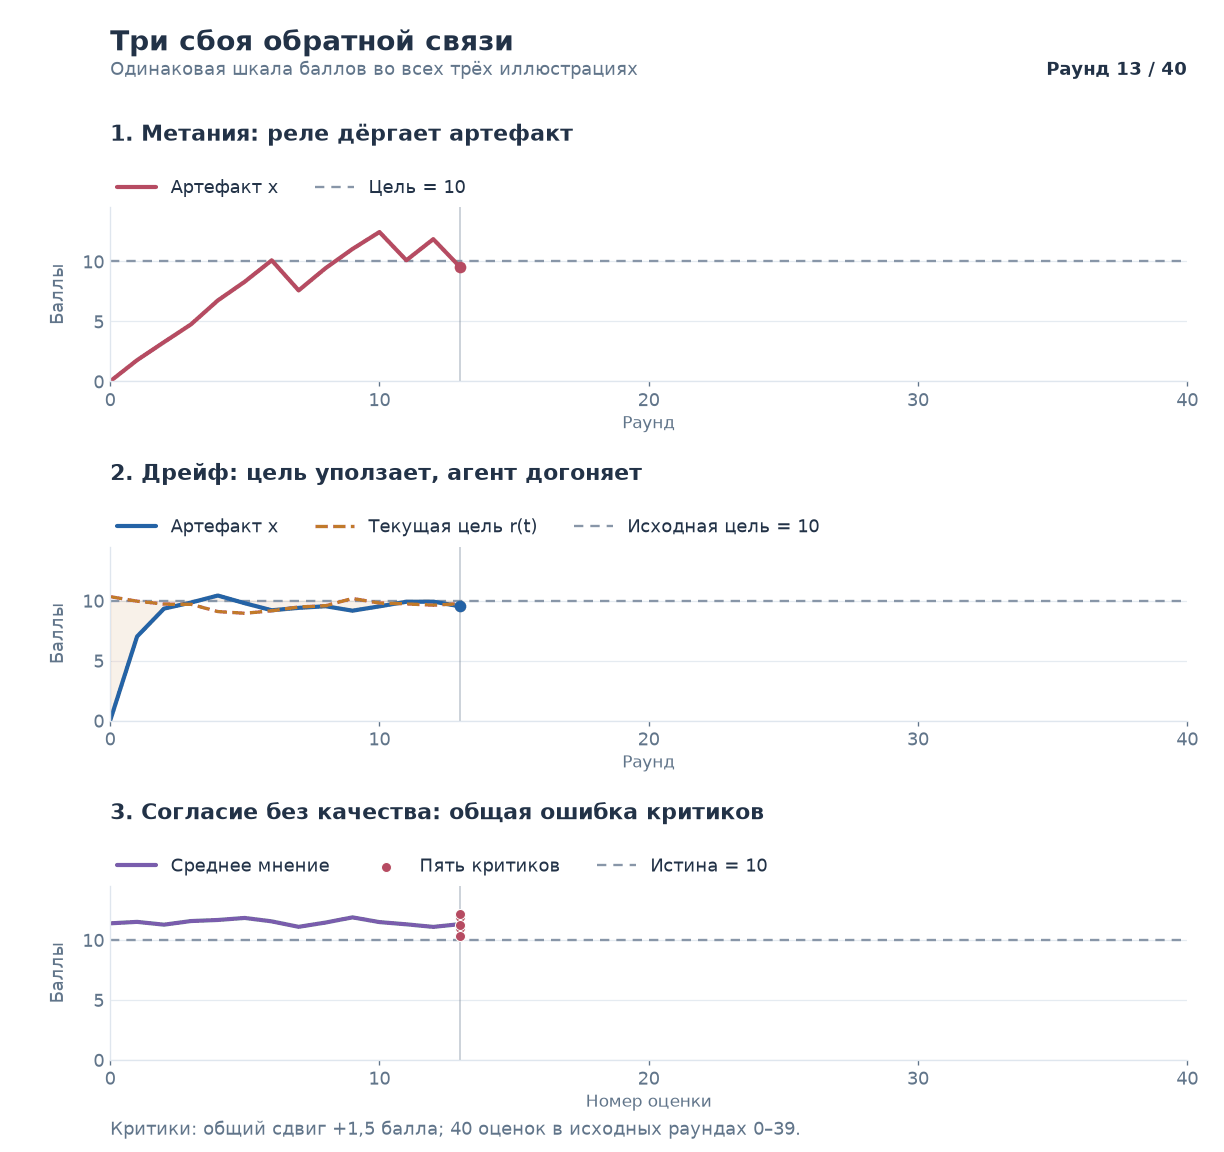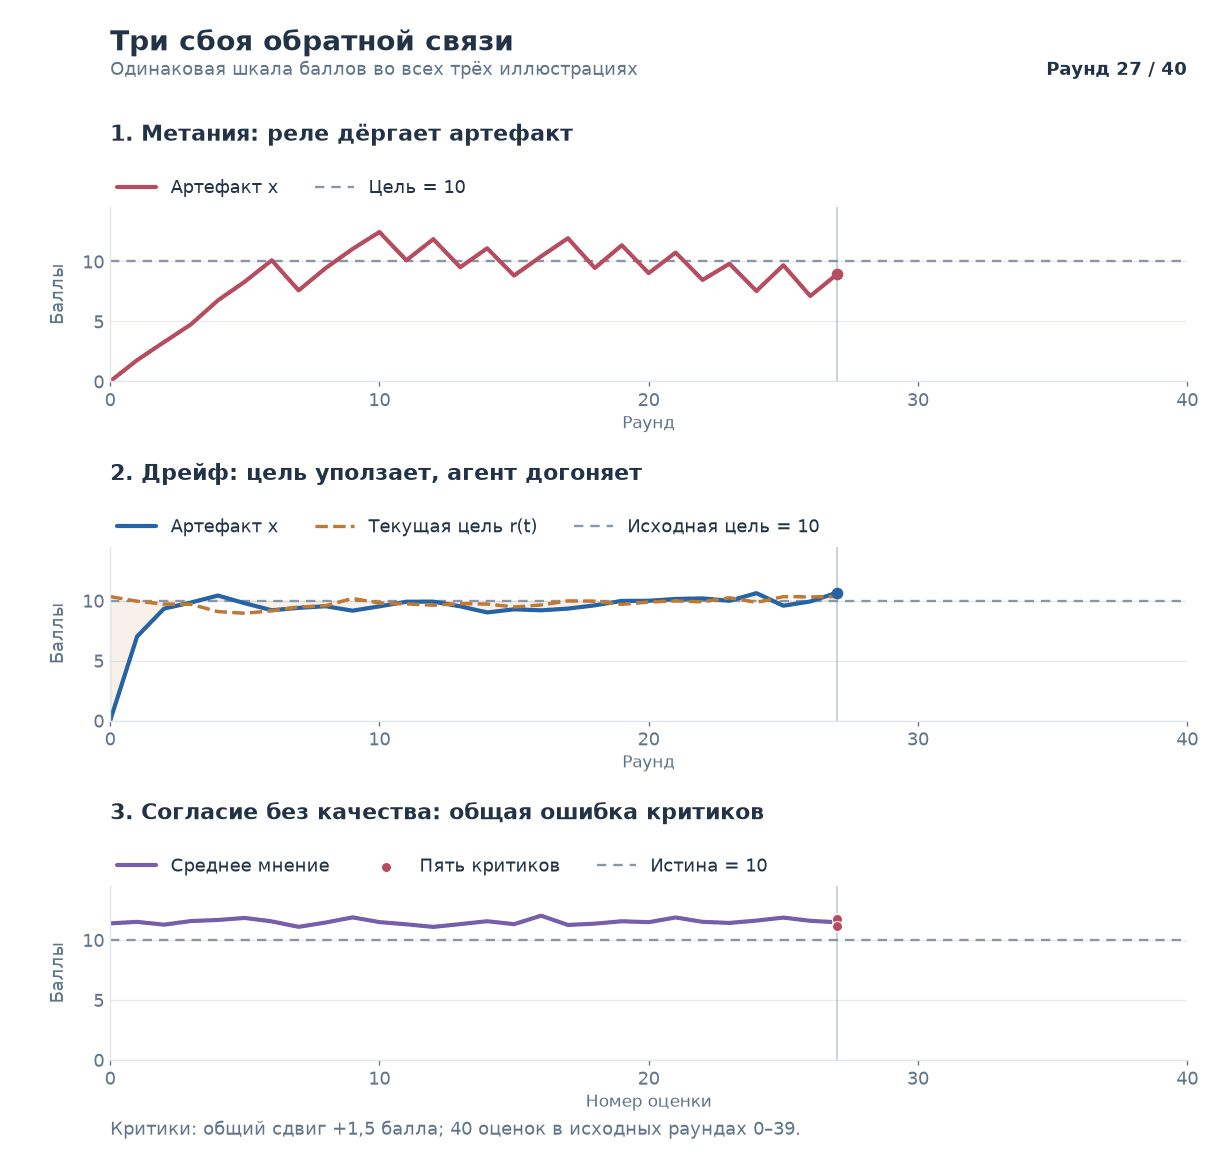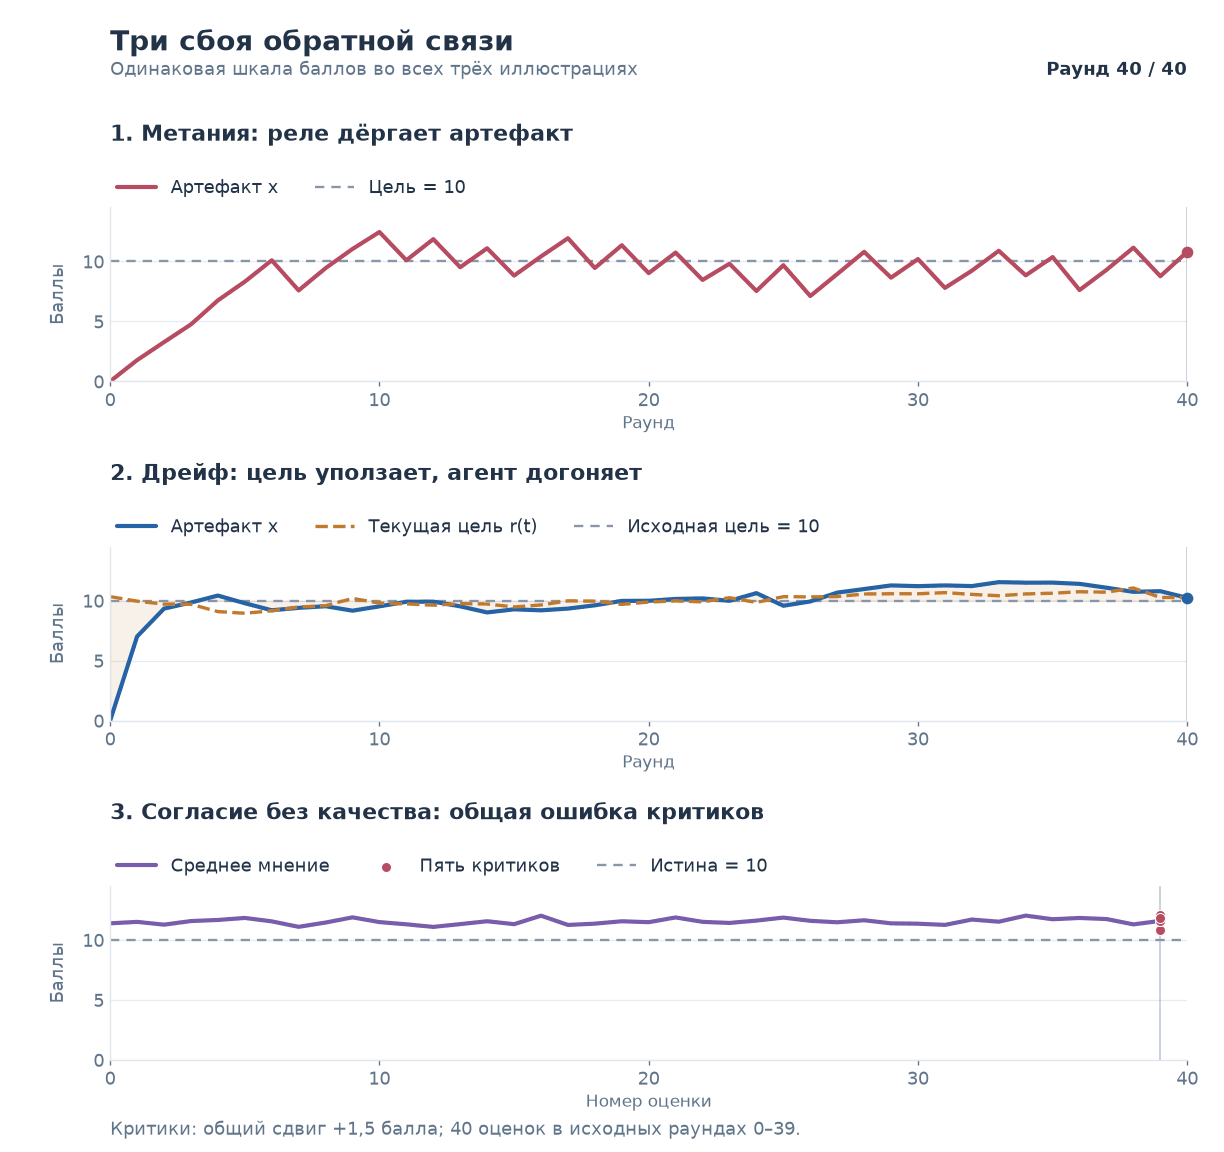
Когда оценка критика сразу определяет следующую правку, ИИ-агент очень легко попадает в цикл избыточных правок. Поправил вступление — критик доволен. Переписал середину, слегка сломав вступление, — критик просит вернуть прежнее. ИИ-агент возвращает вступление и заново ломает середину. Версии сменяют друг друга, бюджет токенов убывает. Теория управления помогает разобраться, почему такой цикл может колебаться вместо достижения цели.
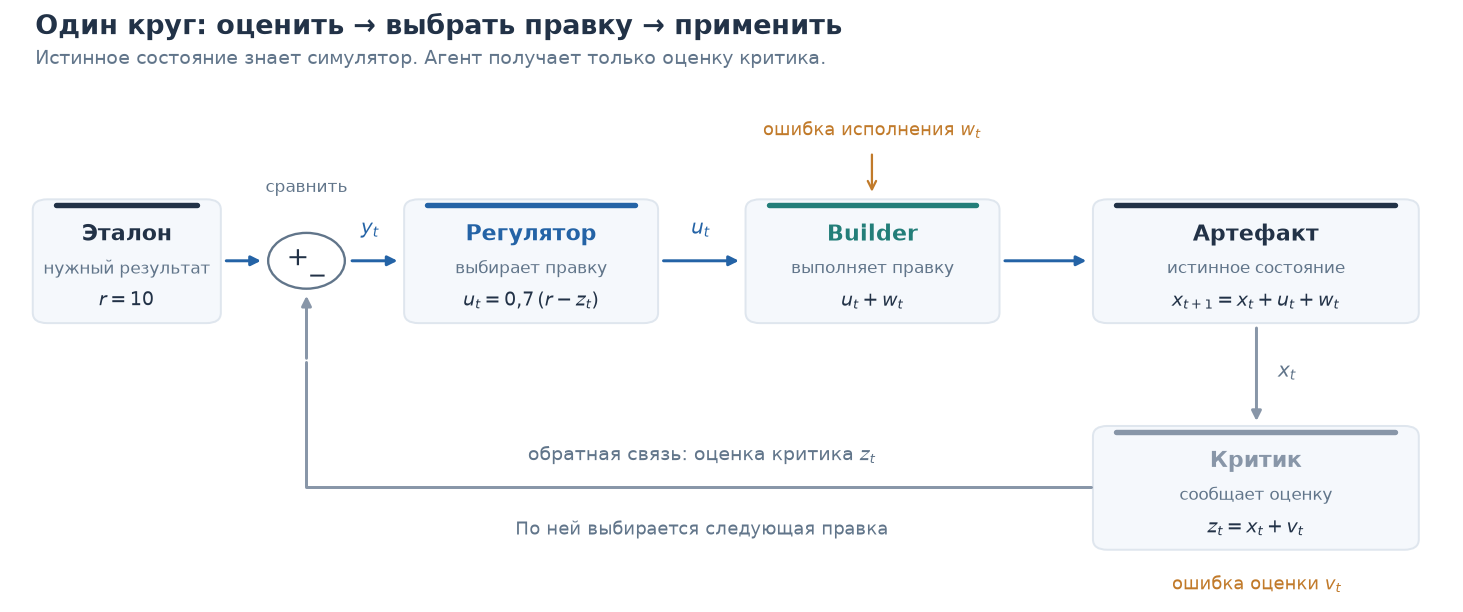
Что здесь происходит с научной точки зрения? ИИ-агент правит работу, критик оценивает результат, отзыв критика определяет следующую правку. В теории управления это называется обратной связью. Шумные правки могут возникнуть как из-за слишком сильных правок исполнителей, так и из-за неточных отзывов критиков. Как отличить действие этих причин друг от друга? Используем парное контролируемое сравнение: сохраняем остальные условия и меняем только способ обработки измерений. Сначала закрепим простое правило правки, затем проверим вклад обработки отзывов критика.
Минимальная модель: эталон, артефакт, критик
Состояние результата работы ИИ-агента можно представить одной точкой на числовой оси. Одна точка показывает текущее состояние результата, другая — нужное. Правка сдвигает первую точку, а критик сообщает её положение с ошибкой. Эта точка движется после каждой итерации. Она может приближаться к цели, метаться вокруг неё или уходить в сторону. Цель заключается в том, чтобы понять, как этим управлять.
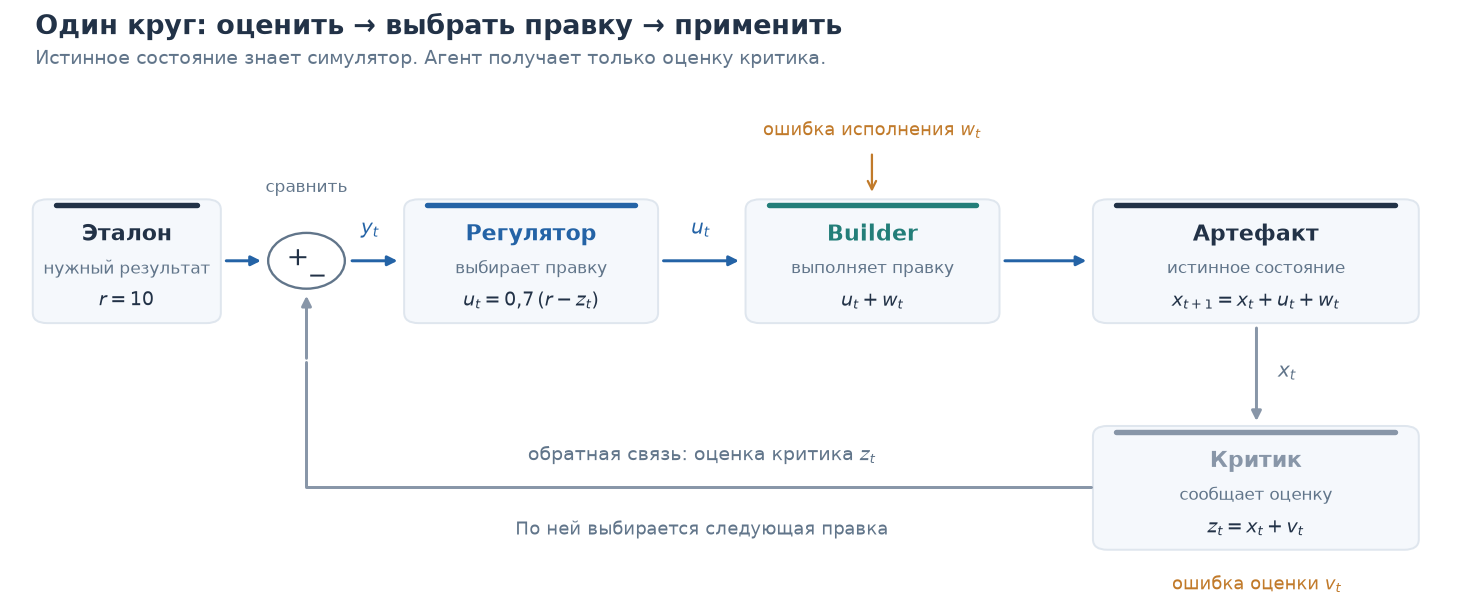
Такая модель удобна тем, что можно по отдельности включать ошибку критика, неточность исполнения или задержку. А затем дать двум вариантам цикла одинаковые последовательности ошибок и проверить, что изменяют разные подходы. Смысл такого опыта гораздо шире задачи редактирования текста или решения простейшего дифференциального уравнения. В первую очередь он важен для задачи генерации кода.
Одна правка глазами агента и критика
Прежде всего разберёмся, откуда и как именно возникает ошибка. Пусть нужный результат находится на отметке 10, текущий — на 8,1. Агент решил прибавить 1,2 балла. Правка сработала чуть сильнее: добавилось ещё 0,05. Получилось 9,35. Но критик сегодня строг: занизил оценку на 0,25 и сообщил 9,1. Что получилось после правки: 8,1 + 1,2 + 0,05 = 9,35. Что сообщил критик: 9,35 − 0,25 = 9,1. Сколько осталось до цели на самом деле: 10 − 9,35 = 0,65. Сколько осталось, по мнению агента: 10 − 9,1 = 0,9.
Агент выбирает следующую правку по последней строке. Например, если исправлять 70% замеченной ошибки, он добавит ещё 0,63 балла. Мы уже видим источник проблем: действие рассчитывается по оценке критика, а меняет реальный артефакт. Эти две величины могут расходиться.
Что фиксируем в модели
Зафиксируем правила этой числовой шкалы. Мы хотим попасть близко к десяти; перелёт выше цели тоже будем считать ошибкой. У нас два источника случайности. Исполнитель может выполнить правку чуть сильнее или слабее, чем задумал. Критик может завысить или занизить результат. В базовом опыте оба источника дают случайные ошибки без систематического смещения. Зададим типичный разброс ошибок критика — 0,55 балла, а исполнения — около 0,22.
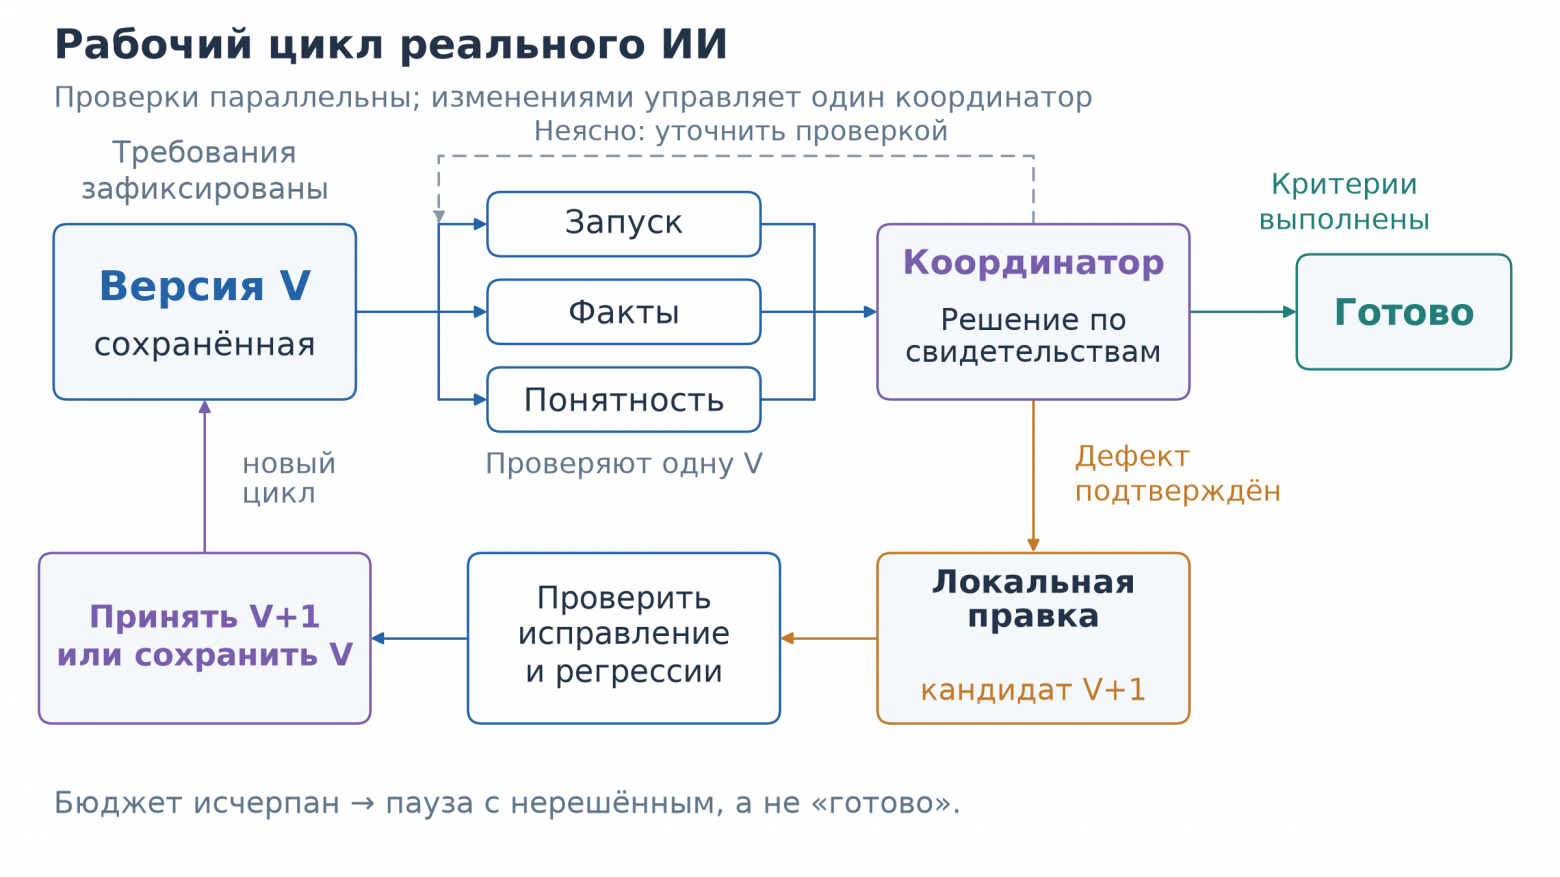
Разность «цель минус оценка критика» будем называть невязкой. Если она положительная — нужно прибавить, отрицательная — убавить. Правило, которое по этой невязке выбирает правку, называется регулятором. Теперь весь цикл можно прочитать без формул: измерить → сравнить с целью → выбрать правку → применить её → повторить.
Фильтр Калмана: как не начинать с нуля после каждого отзыва ИИ-критика
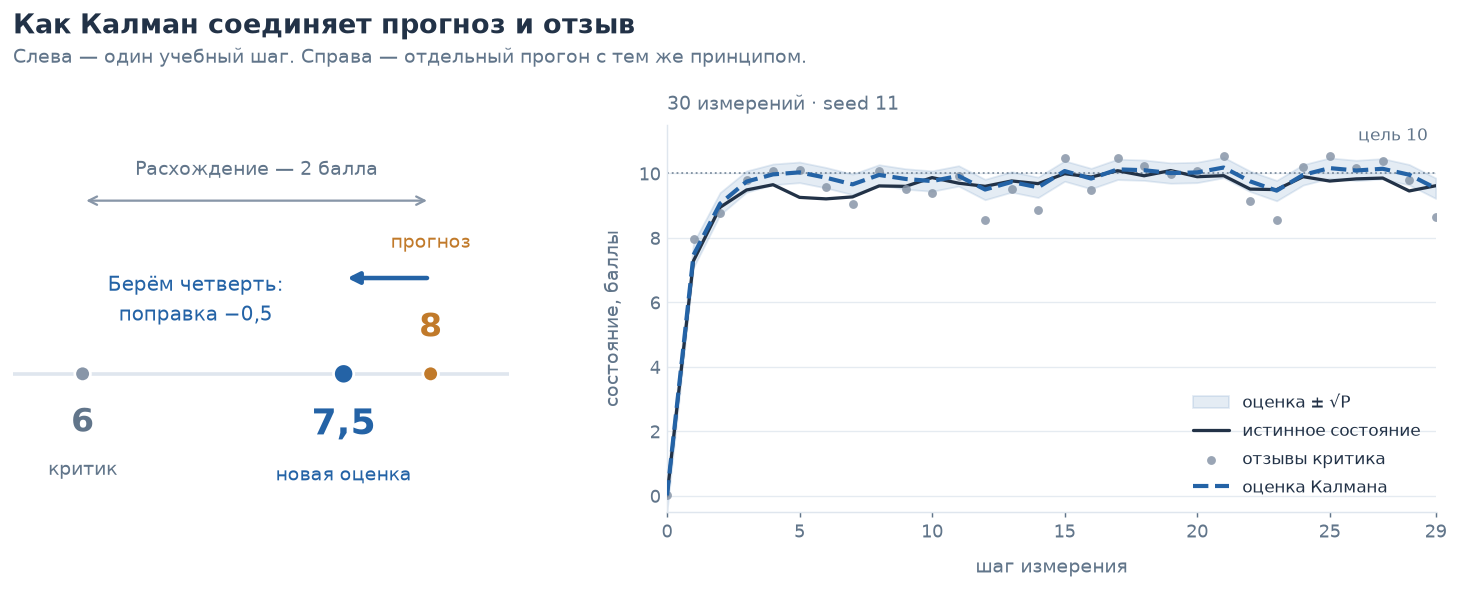
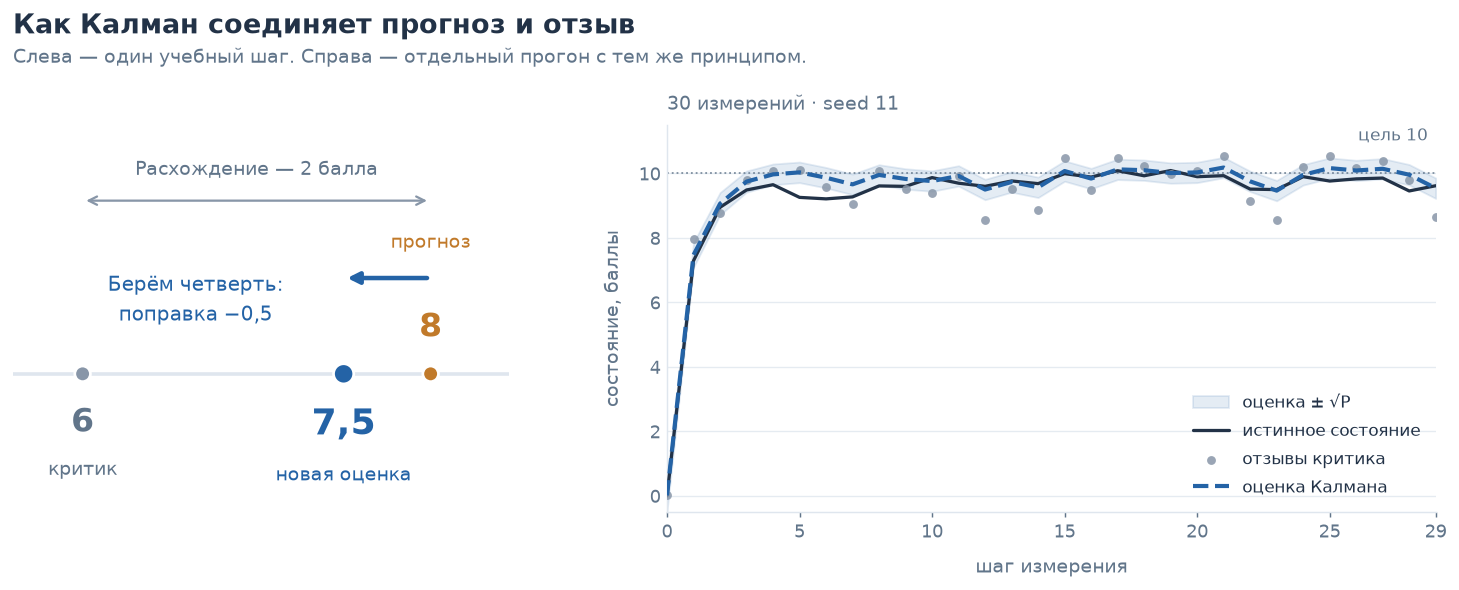
Прежняя оценка была шесть, ожидаемая прибавка от правки — два, новый отзыв — опять шесть. Прогноз и критик расходятся на два балла. Если критик занизил состояние, регулятор, принявший его оценку как есть, подготовит слишком большую правку. Но у нас осталась полезная информация: прежняя оценка и сведения о том, что уже изменилось. Критик мог ошибиться, а правка могла сработать слабее ожидаемого.
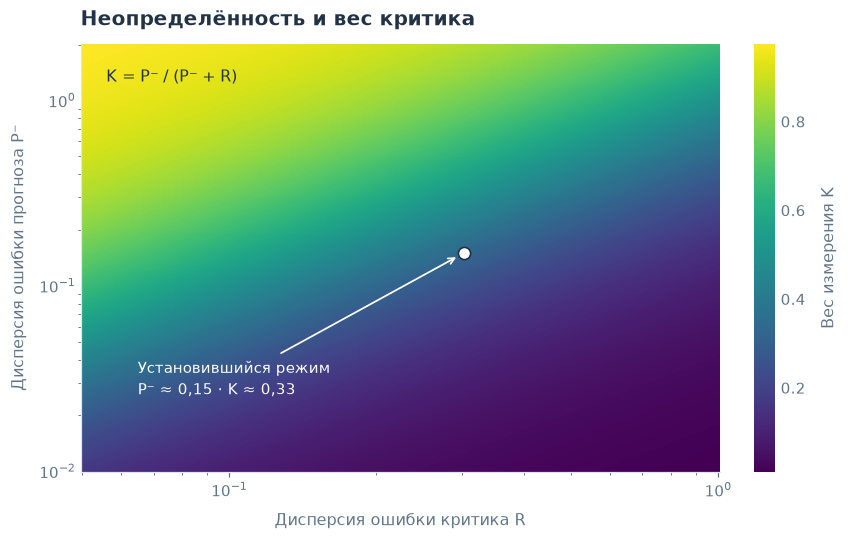
Фильтр Калмана хранит оценку состояния, предсказывает её изменение после правки и уточняет прогноз по новому измерению. В теории управления такой помощник называется наблюдателем. Его роль в том, что он отвечает регулятору на вопрос «где мы сейчас, насколько можем судить по данным?». Ожидаем прибавку 2, получаем прогноз 8, критик сообщил 6, на два балла ниже прогноза. Учитывая надёжность источников, берём четверть расхождения и отступаем от 8 на половину балла: получаем 7,5.
Следующий раунд и проверка прогноза
Теперь в памяти остаются 7,5 и величина неопределённости этой оценки. После очередной правки мы переносим оценку вперёд на ожидаемую прибавку. Заодно увеличиваем неопределённость: правка могла сработать не совсем так, как задумано. Приходит новый отзыв — снова уточняем прогноз. Это объясняет, зачем здесь модель изменения состояния, а не простое среднее последних оценок. Старые отзывы относятся к старым версиям работы.
Для проверки прогноза и систематического перекоса нужен внешний ориентир, например оценка человека по той же шкале или объективная метрика качества. По одной разнице двух отзывов отделить эффект правки от ошибки критика нельзя. В журнале фиксируется версия, прогноз эффекта, выполненная правка и повторная оценка.
Что даёт сам фильтр Калмана? Сравним в одинаковых условиях
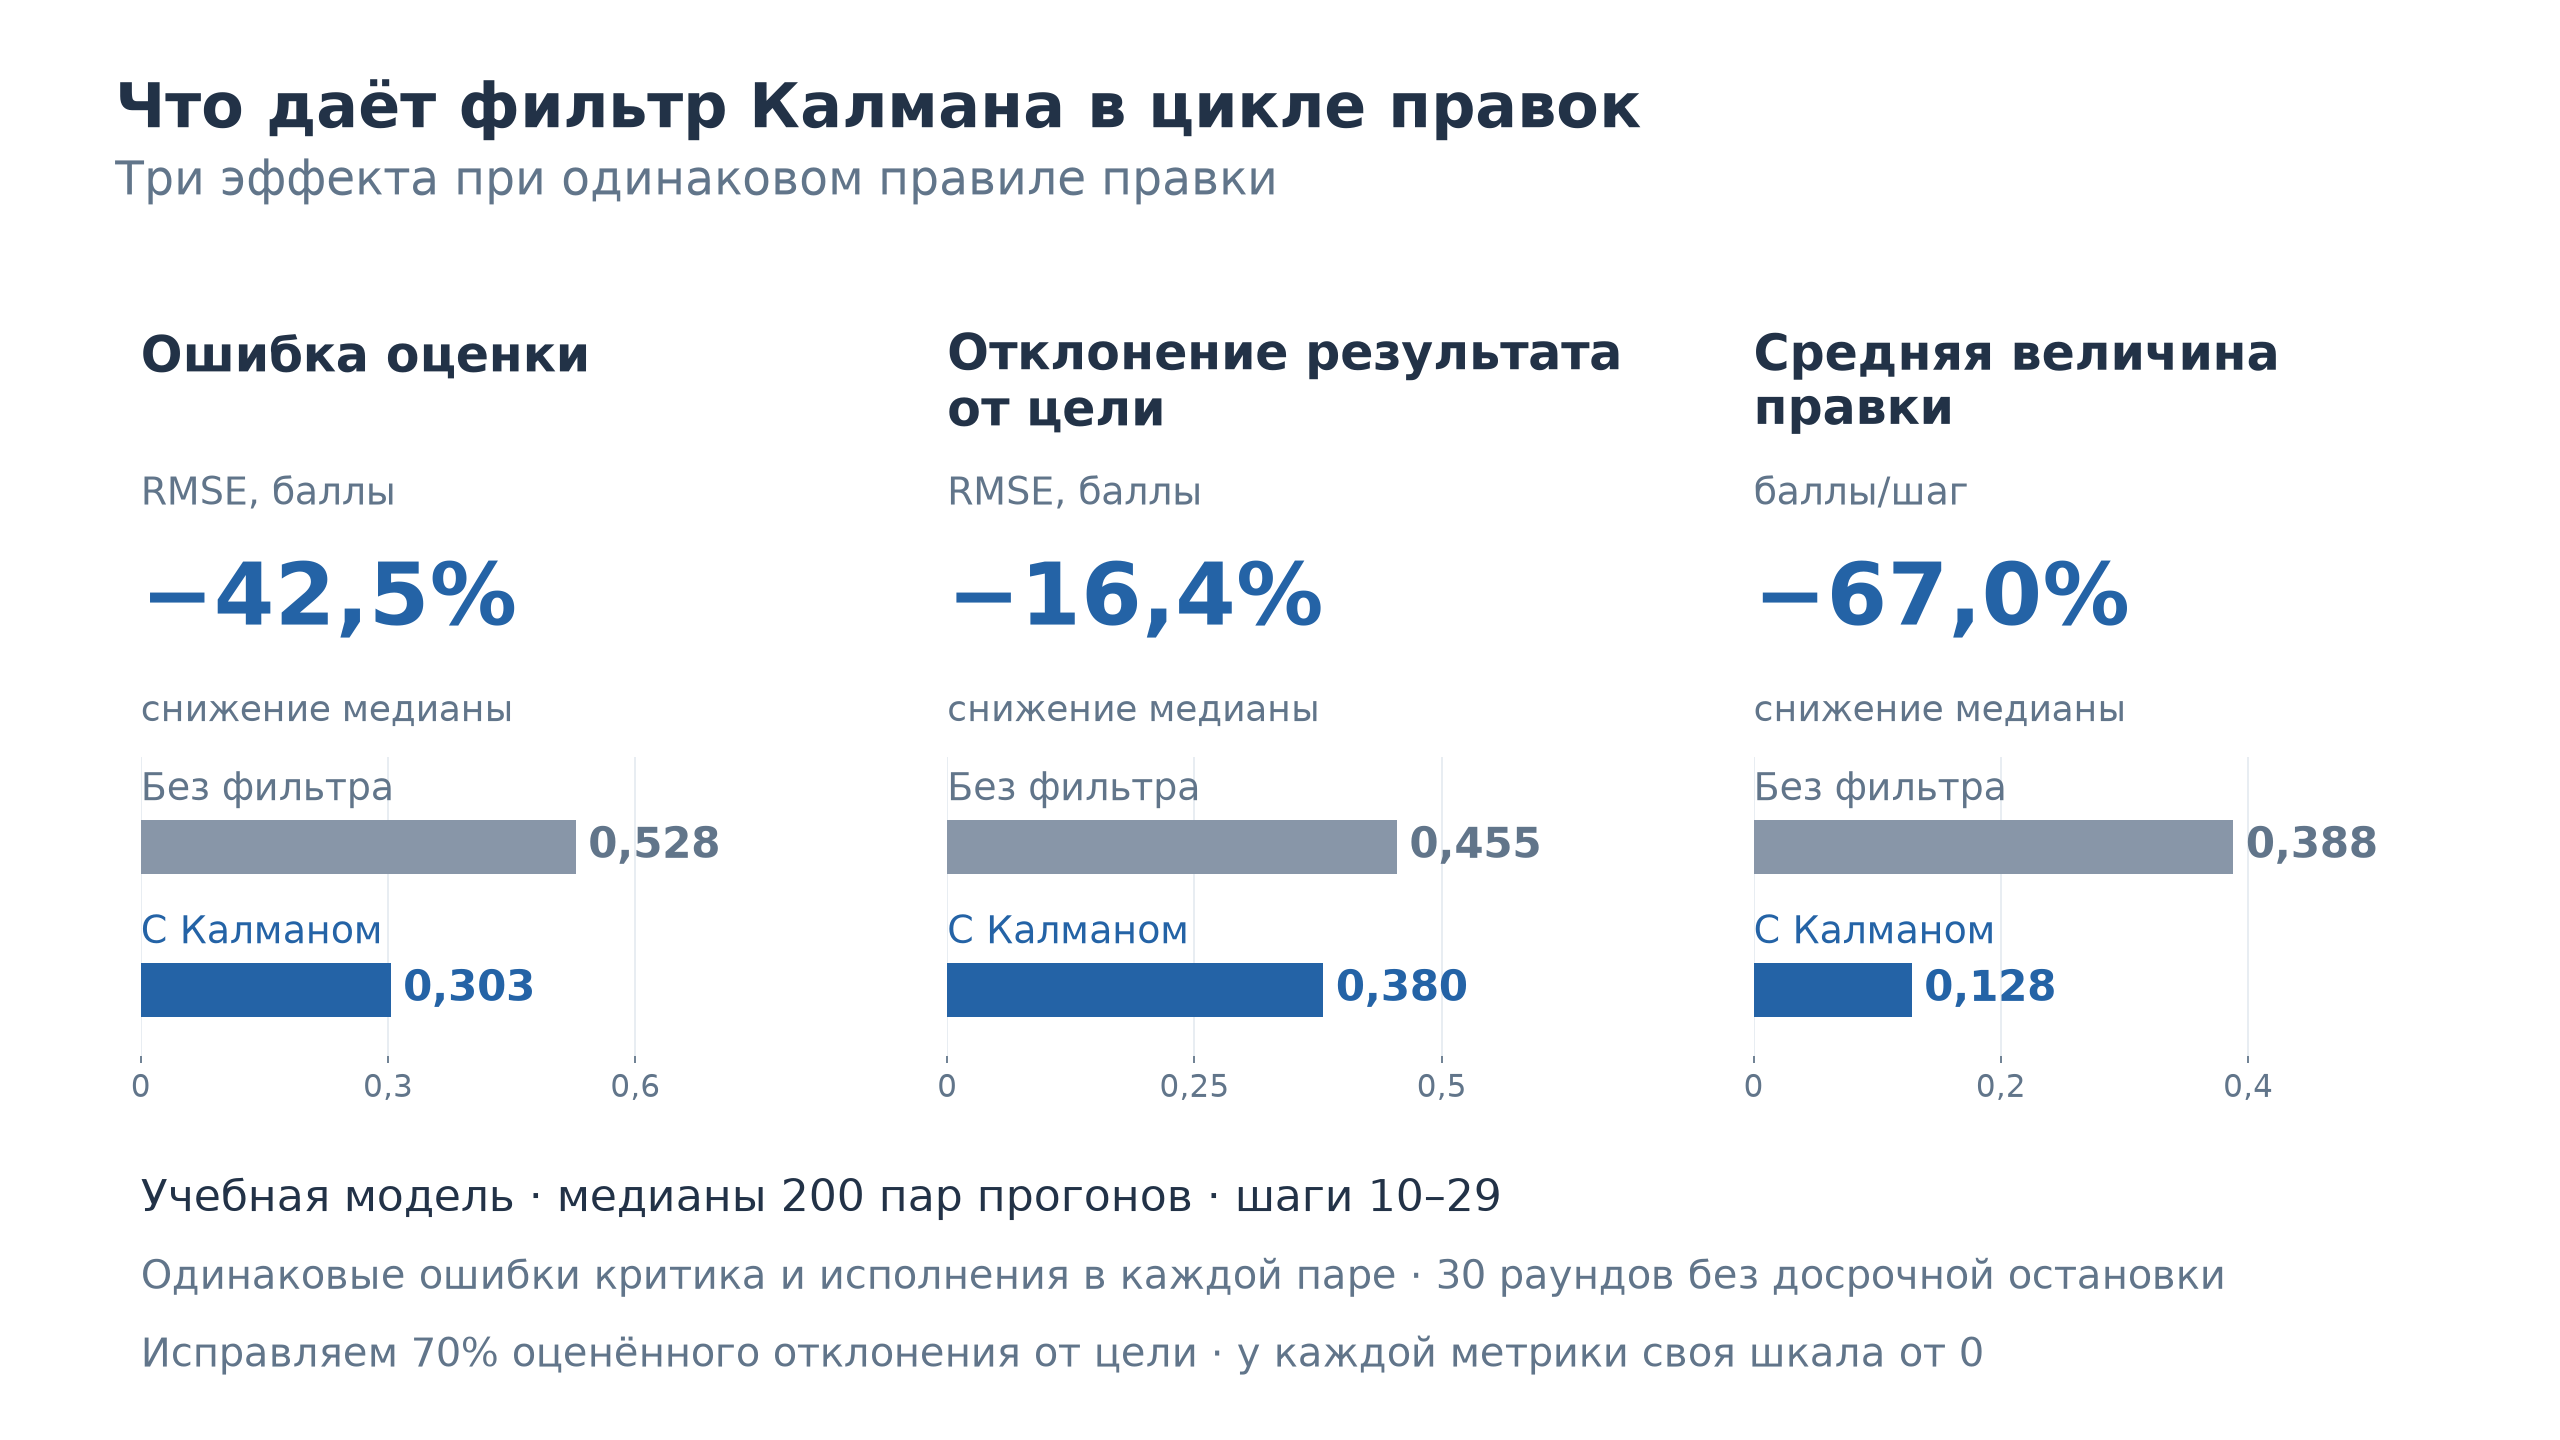
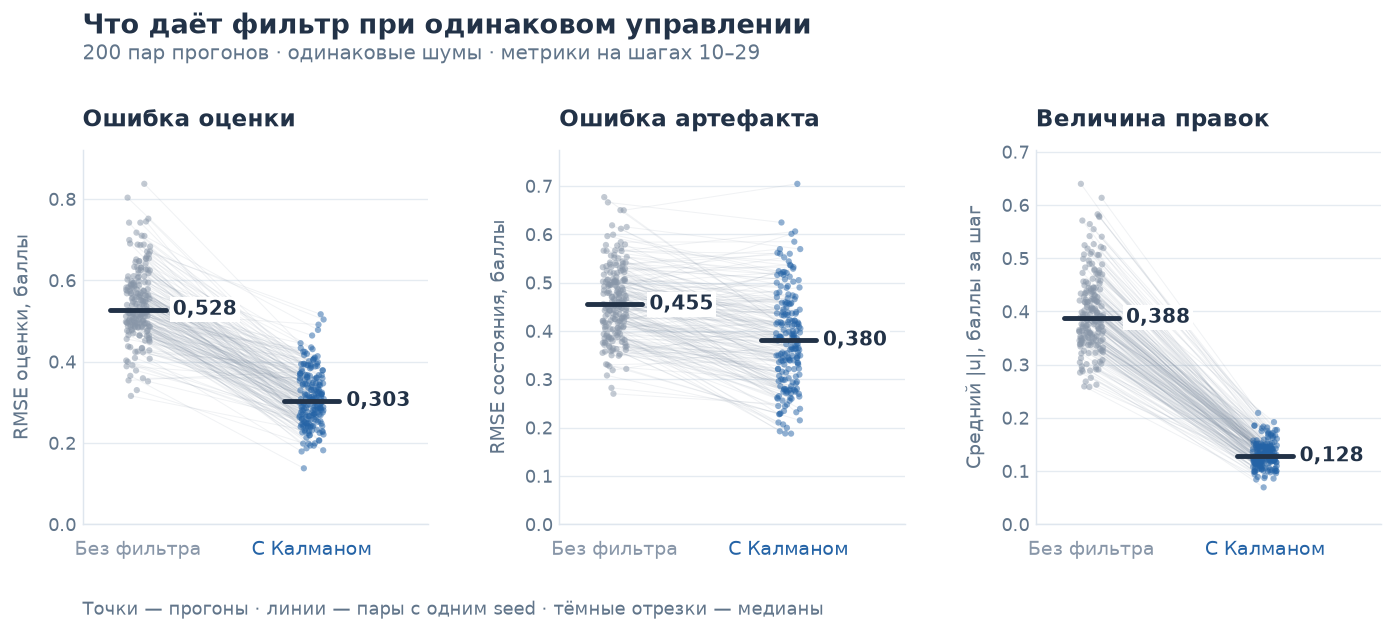
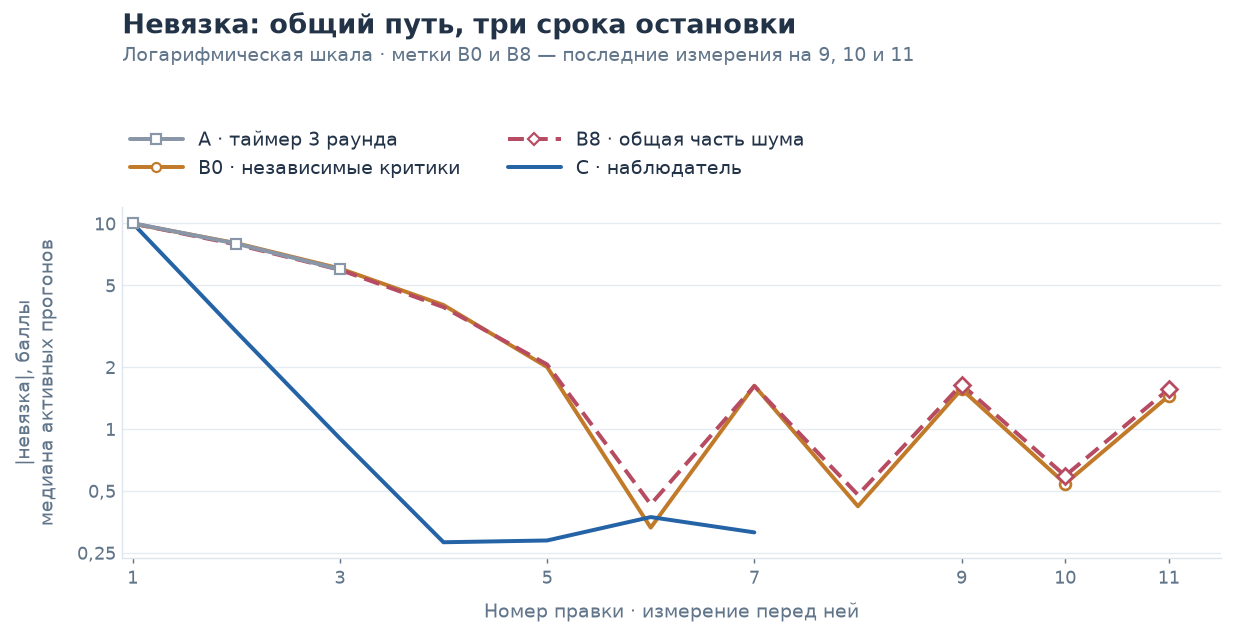
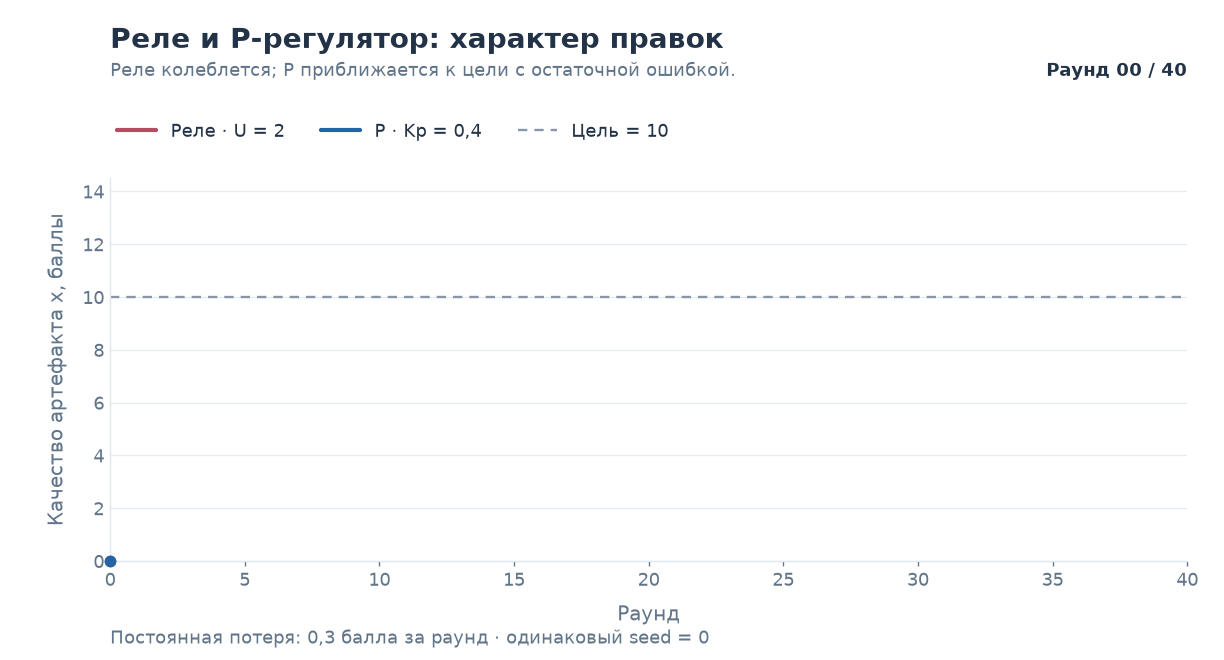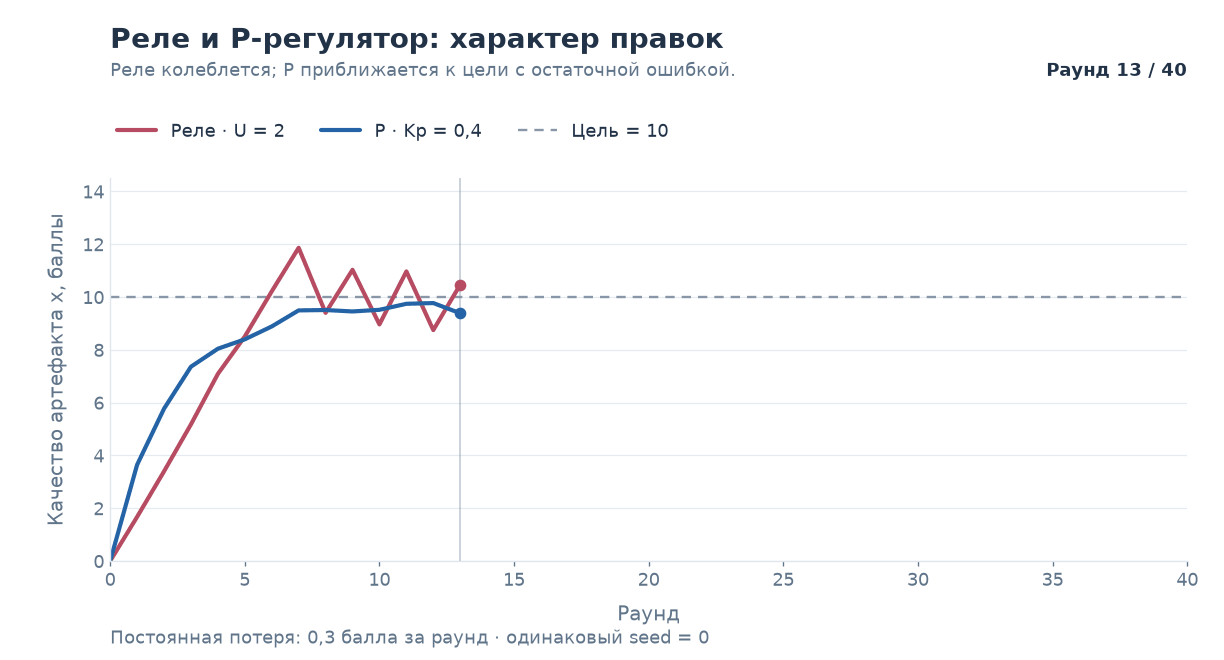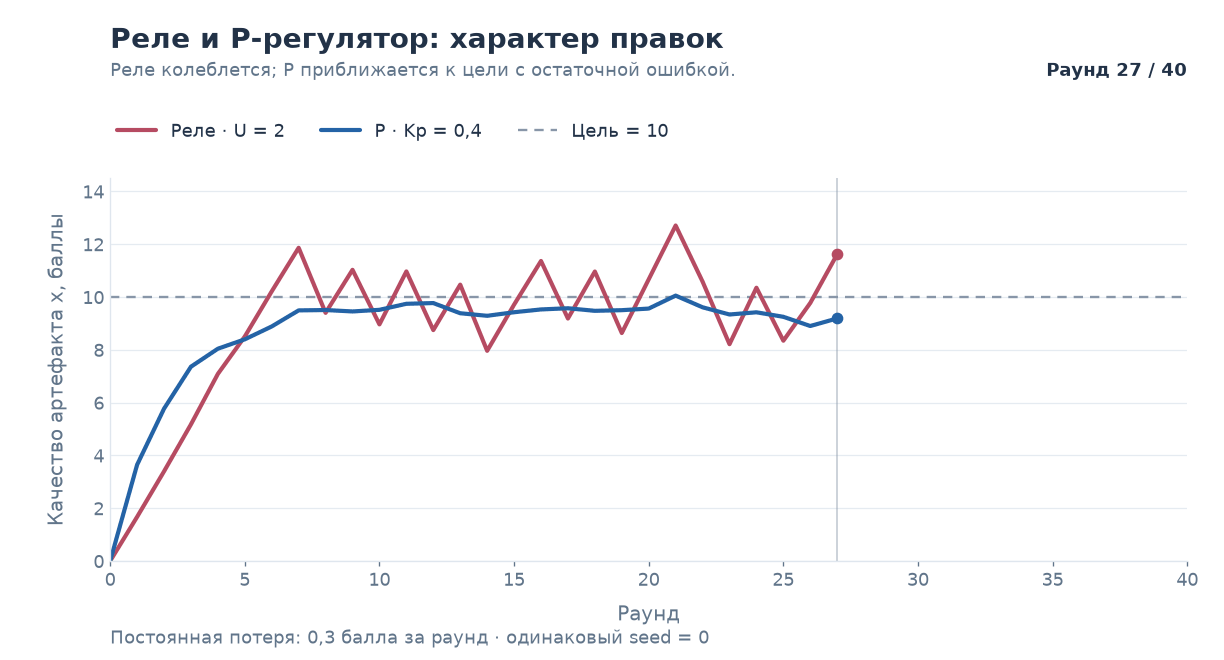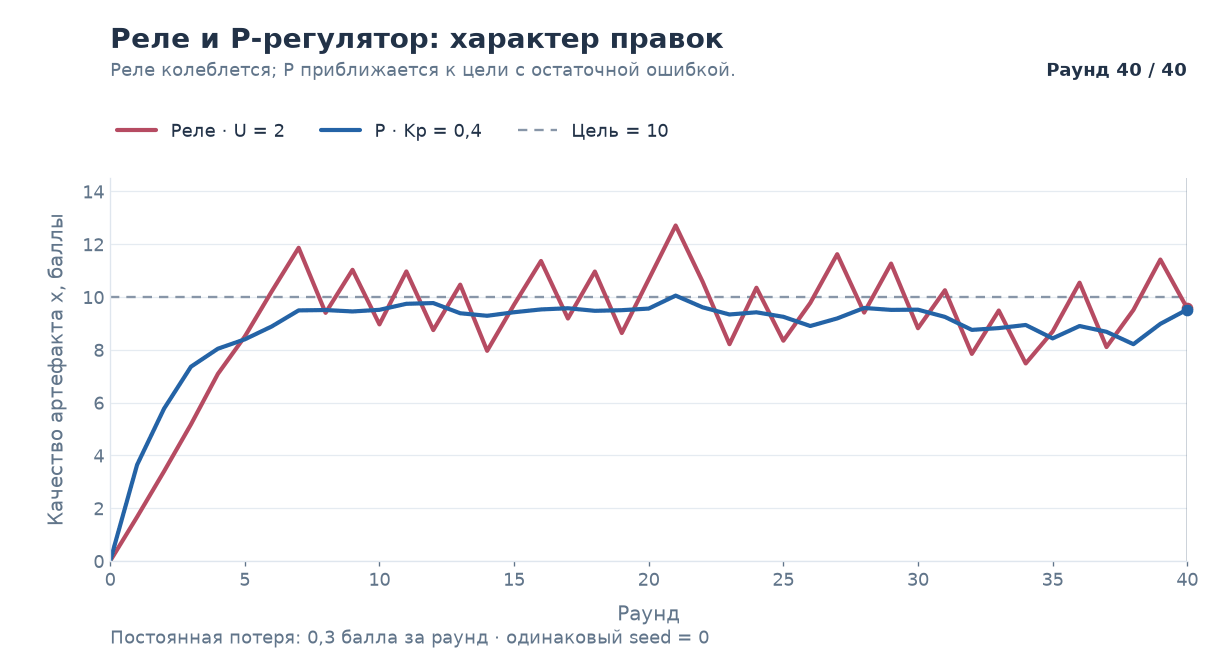
Самое интересное начинается тогда, когда работа уже приблизилась к своей цели. Один отзыв требует немного дописать, следующий — убрать примерно столько же. Агент исправно слушается, но часть этой суеты вызвана шумом критика и является лишней. Фильтр Калмана позволяет смешать новый отзыв критика с прогнозом и бороться с этим шумом. Поставим рядом два одинаковых P-регулятора: каждый исправляет 70% оценённого недобора до цели. Первый верит свежей оценке критика, второй — оценке фильтра Калмана.
Стартовые условия, цель, последовательности ошибок и правило правки одинаковы. Меняем только способ оценки текущего состояния, чтобы отдельно проверить вклад фильтра. Проведём 200 пар прогонов по 30 раундов. Фильтр заметно улучшил оценку, но в самом артефакте выигрыш скромнее. Средний модуль правки сократился примерно втрое: цикл слабее реагировал на шум свежего отзыва.
Почему одного фильтра недостаточно
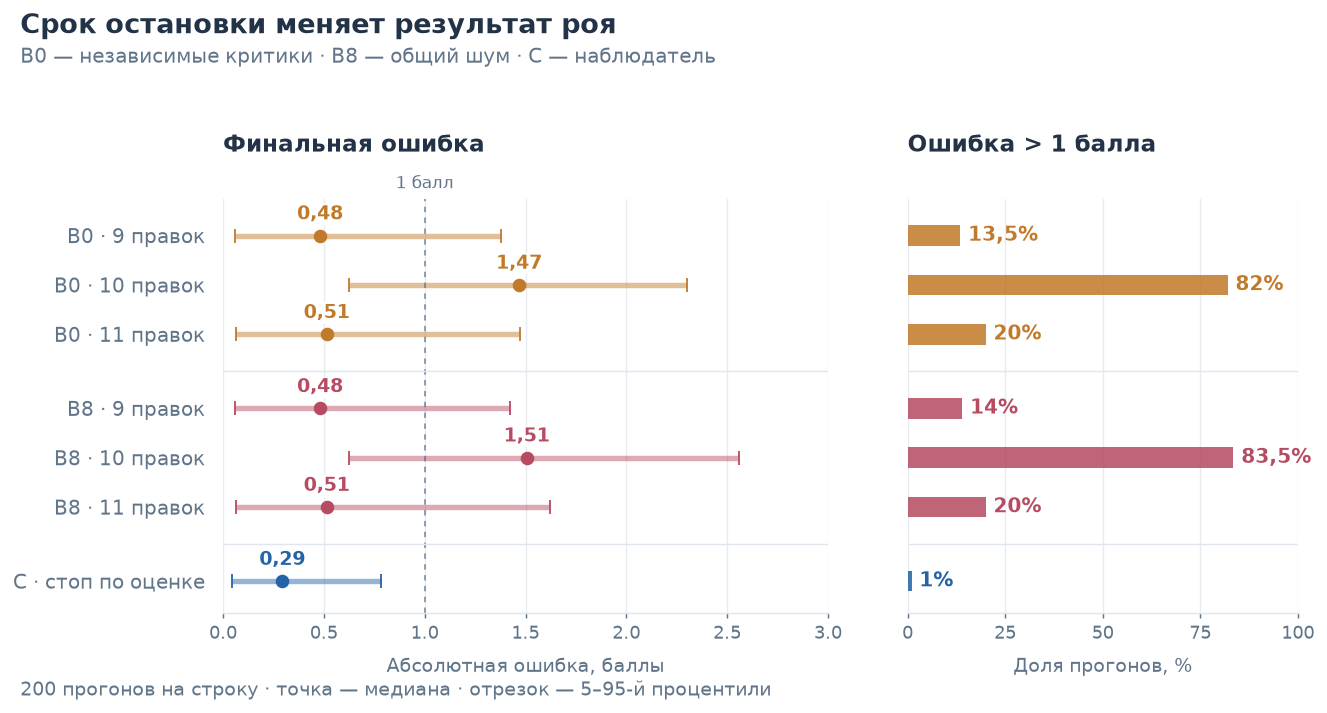
В парном опыте заранее зафиксирована цель, выбрано правило правки и обоим контурам дано одинаковое время. Теперь надо посмотреть на все эти решения по отдельности. Дело в том, что даже точная оценка состояния не может определить, куда идти, как сильно править и когда закончить. Три распространённых упрощения включают фиксированное число попыток, цель из последних замечаний и усреднение нескольких критиков.
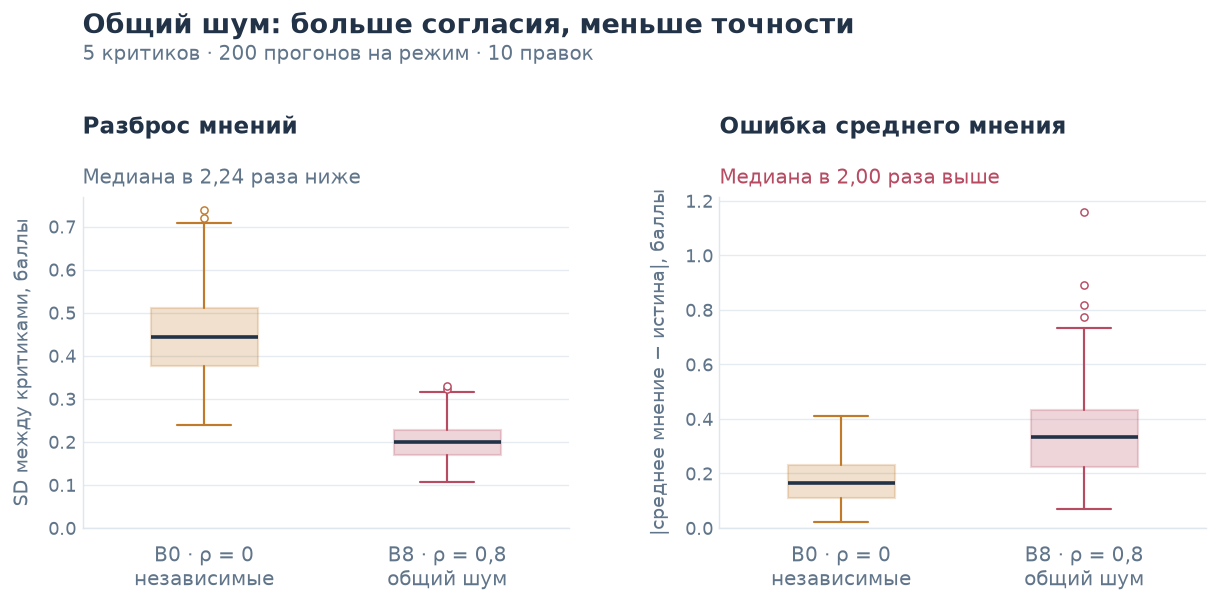
Специальные эксперименты с роем агентов показывают, что согласие пяти критиков еще не означает точность оценки. Если артефакт находится на восьми баллах, а все пятеро дружно ставят девять, среднее значение тоже будет девять. Единодушие арифметику не исправляет, если присутствует общая часть ошибки или коррелированный случайный шум.
Четыре конфигурации на полигоне: фильтр, правка и остановка
На стенде проверялись четыре режима: простой таймер по два балла за три раунда (A), независимый рой критиков (B0), рой со скоррелированными ошибками (B8) и контур с наблюдателем и фильтром Калмана (C). На испытательном полигоне контур C продемонстрировал лучшие показатели по точности и объему правок.
Контур C дошёл до цели и остановился с меньшим объёмом переписывания. В 165 из 200 прогонов стоп наступил после четвёртой правки. Ошибка больше балла осталась в двух прогонах, а в строгий коридор ±0,5 попал 161 результат, что составляет 80,5%. Преимущество данной конфигурации сохранилось при всех проверенных сроках завершения работы.
Что будет, если сломать допущения: выбросы, задержки и смена шкалы
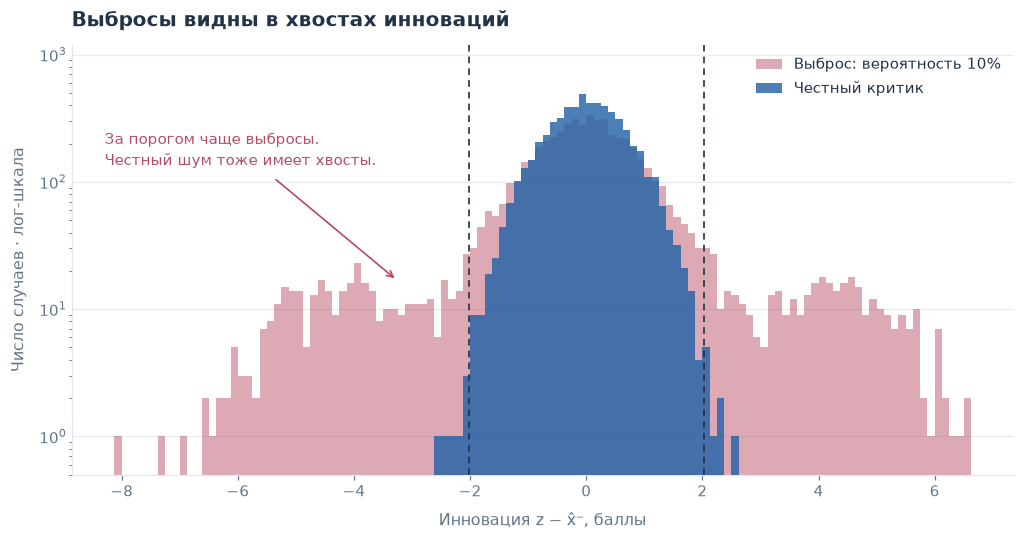
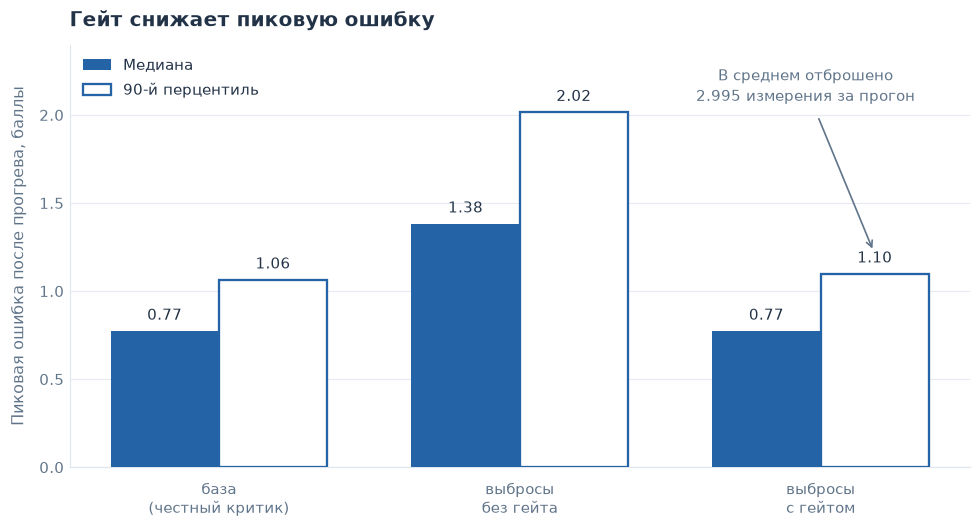
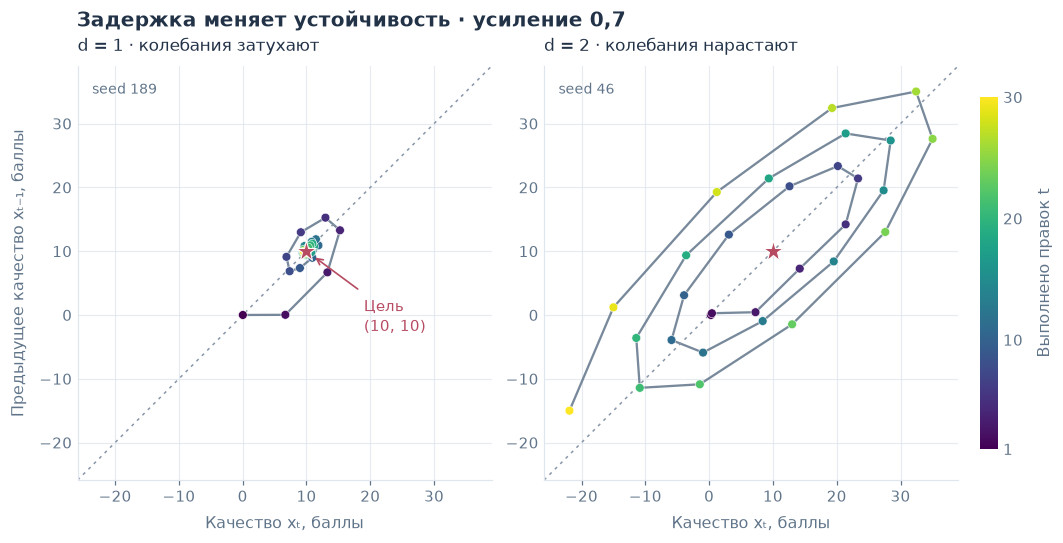
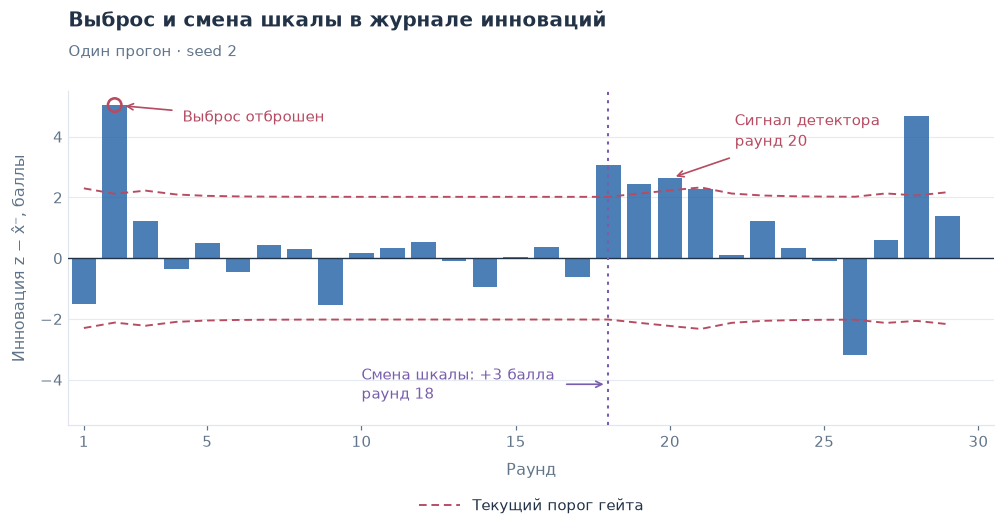
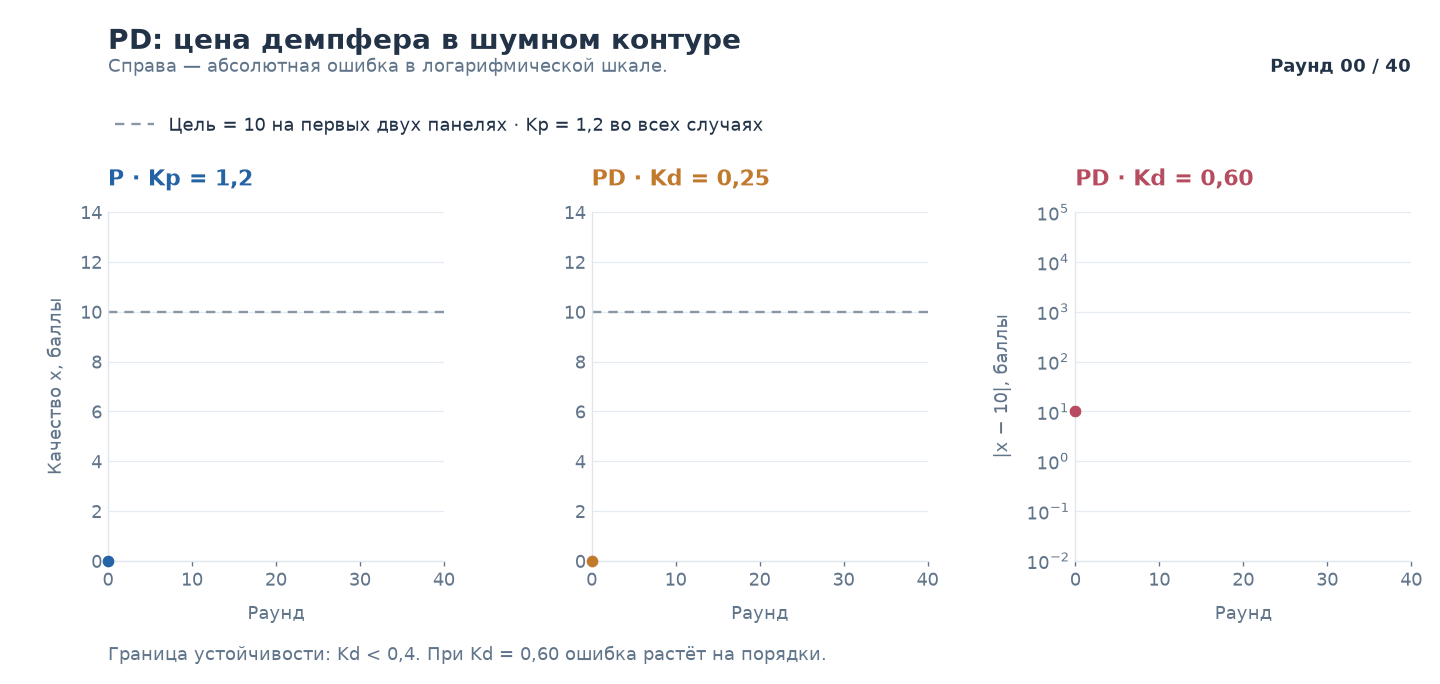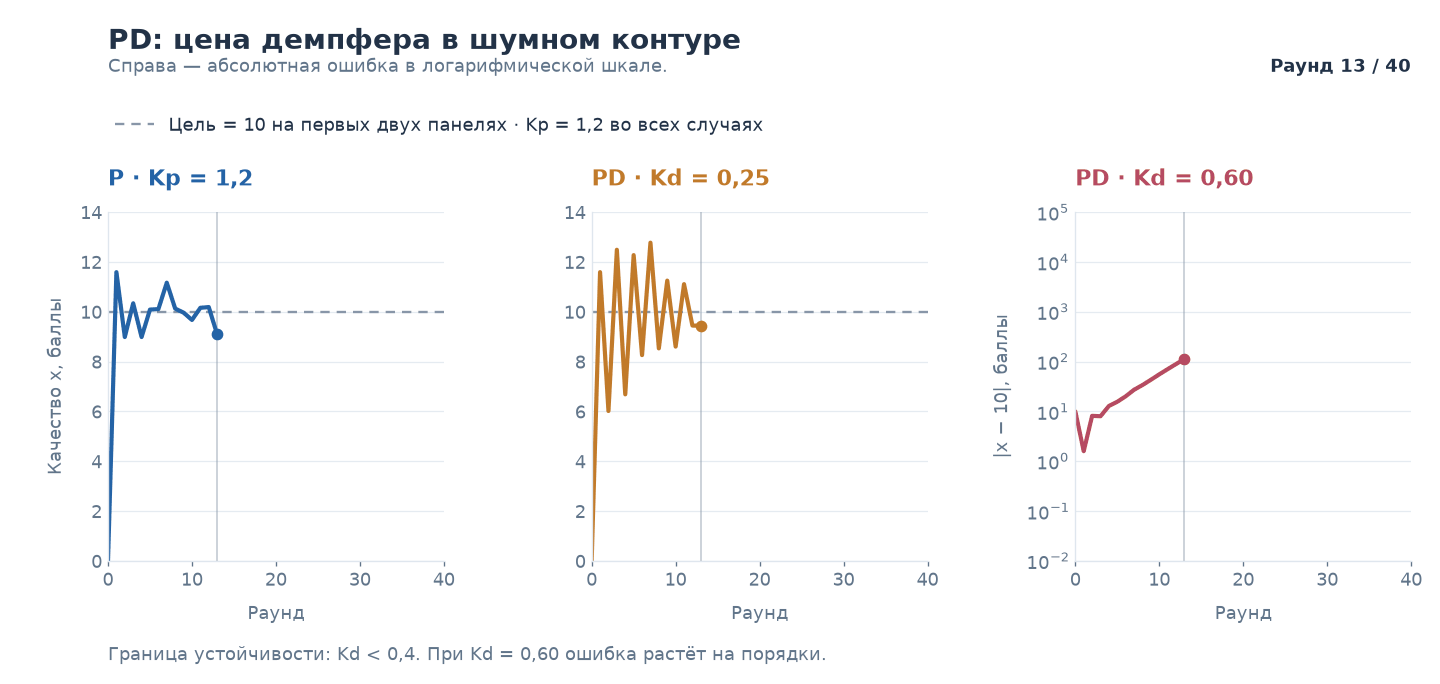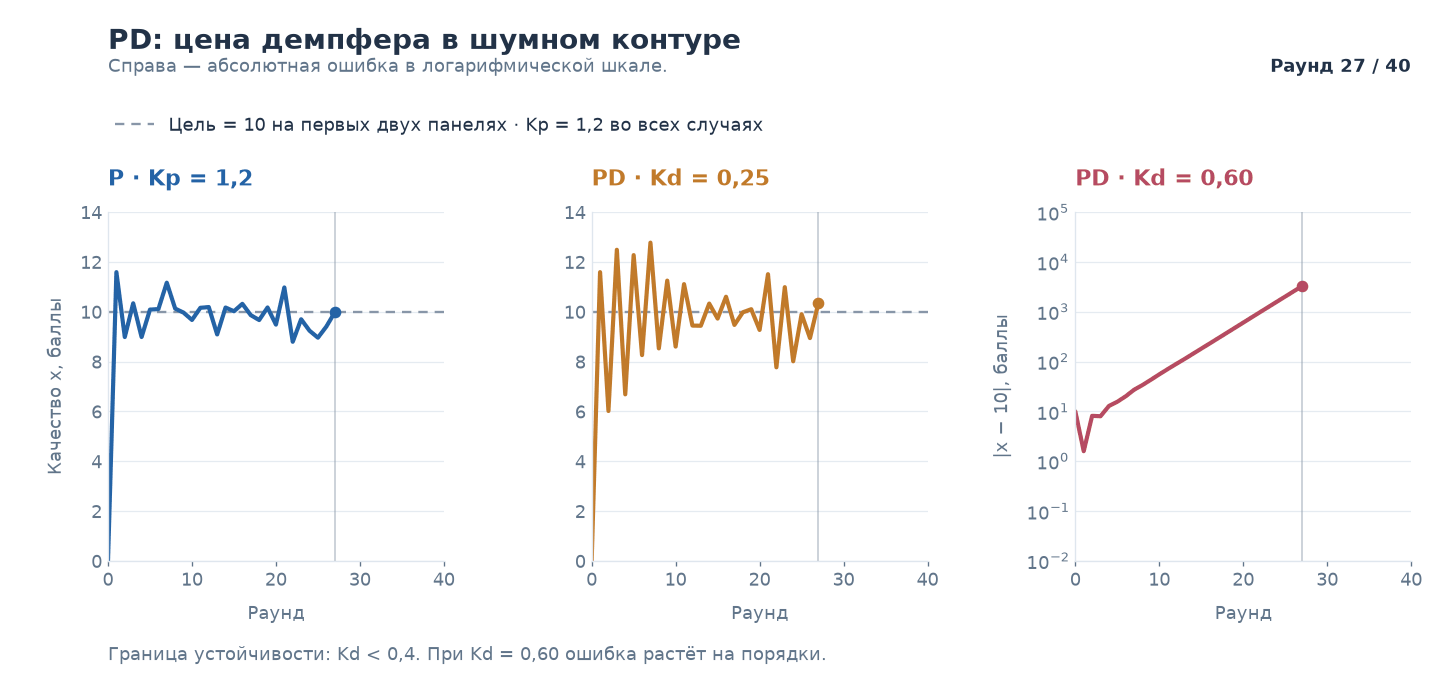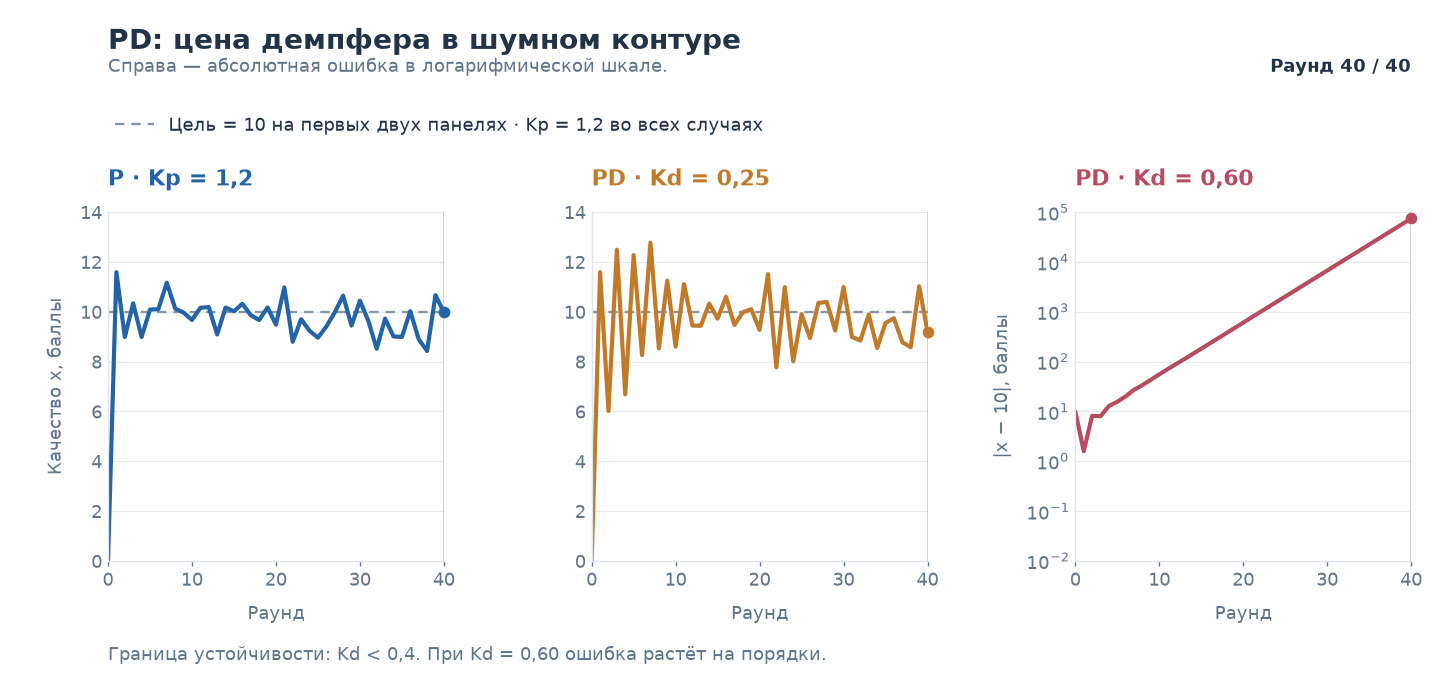
Дополнительные проверки показывают, как контур реагирует на сбои. Если критик ошибается на четыре балла, обычный фильтр сдвигает оценку вслед за ним. Введение специальной проверки (гейта) позволяет отбрасывать аномальные выбросы инноваций, сохраняя стабильность оценок. Задержка отклика также критична: запаздывание применения правок приводит к колебаниям и нарастанию ошибки.
Смена шкалы критика (когда оценки искусственно завышаются или занижаются) заставляет фильтр интерпретировать это как изменение самого артефакта. Для выявления подобных ситуаций используется детектор серий отклонений, который подает сигнал о необходимости проверки калибровки, а не автоматического исправления.
Рабочая инструкция: симптом, что проверить и что попробовать
Анализ результатов позволяет сопоставить типовые проблемы с практическими действиями. Если раунды кончились, а цель не достигнута, стоит добавить проверку качества, сохранив предел раундов как страховку. Когда исходный заказ потерян из-за постоянной смены требований, необходимо жестко версионировать первоначальные критерии. При расхождении между оценками и тестами следует проверять критиков на эталонных задачах.
