
Мой блог
Межкластерный перенос ML-эксперимента: как ускорить запуск моделей на GPU

Эффективное управление вычислительными мощностями при обучении нейросетей требует разделения сред разработки и масштабных вычислений. В современной инфраструктуре машинного обучения специалисты часто сталкиваются с проблемой, когда прототип, созданный в интерактивной среде, крайне сложно запустить на мощном GPU-кластере из-за различий в окружении и зависимостях. Чтобы решить эту задачу, инженеры разрабатывают инструменты, обеспечивающие бесшовный межкластерный перенос ML-эксперимента, сокращая время подготовки среды с нескольких дней до считанных минут.
Основная сложность заключается в том, что современный ML-проект — это не просто набор исполняемых скриптов, а слоистая структура, включающая системные библиотеки, специфические версии фреймворков и пользовательский код. В материале рассматривается архитектурный подход к автоматизации этого процесса на примере внутреннего инструмента j2c, который позволяет упаковывать и доставлять эксперименты в целевую вычислительную среду без избыточного копирования тяжелых системных компонентов.
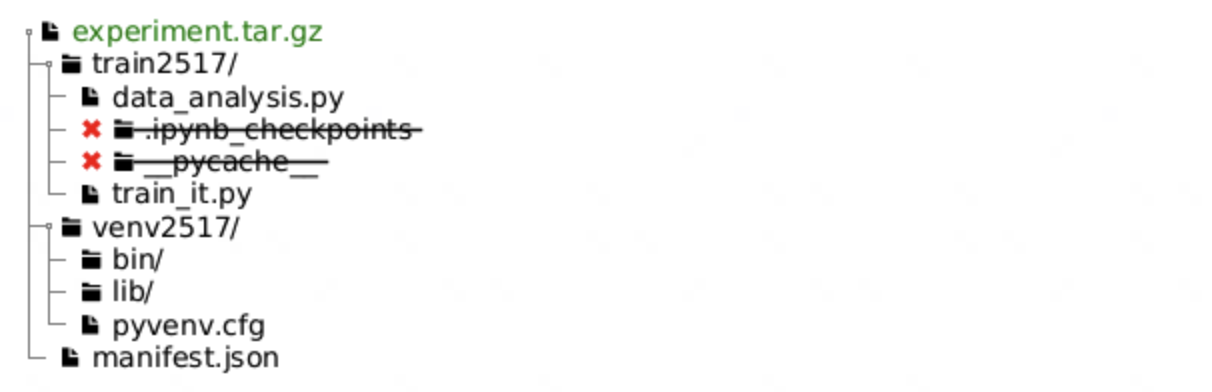
Распределение мощностей по этапам разработки
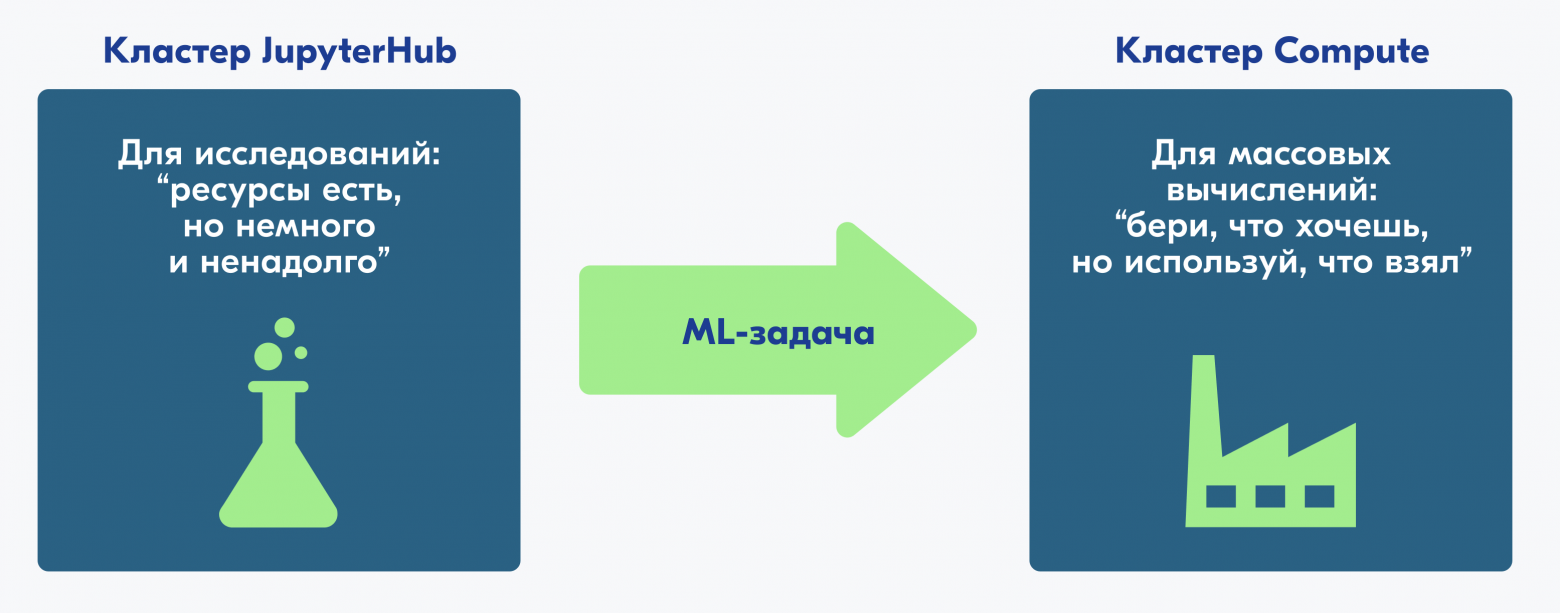
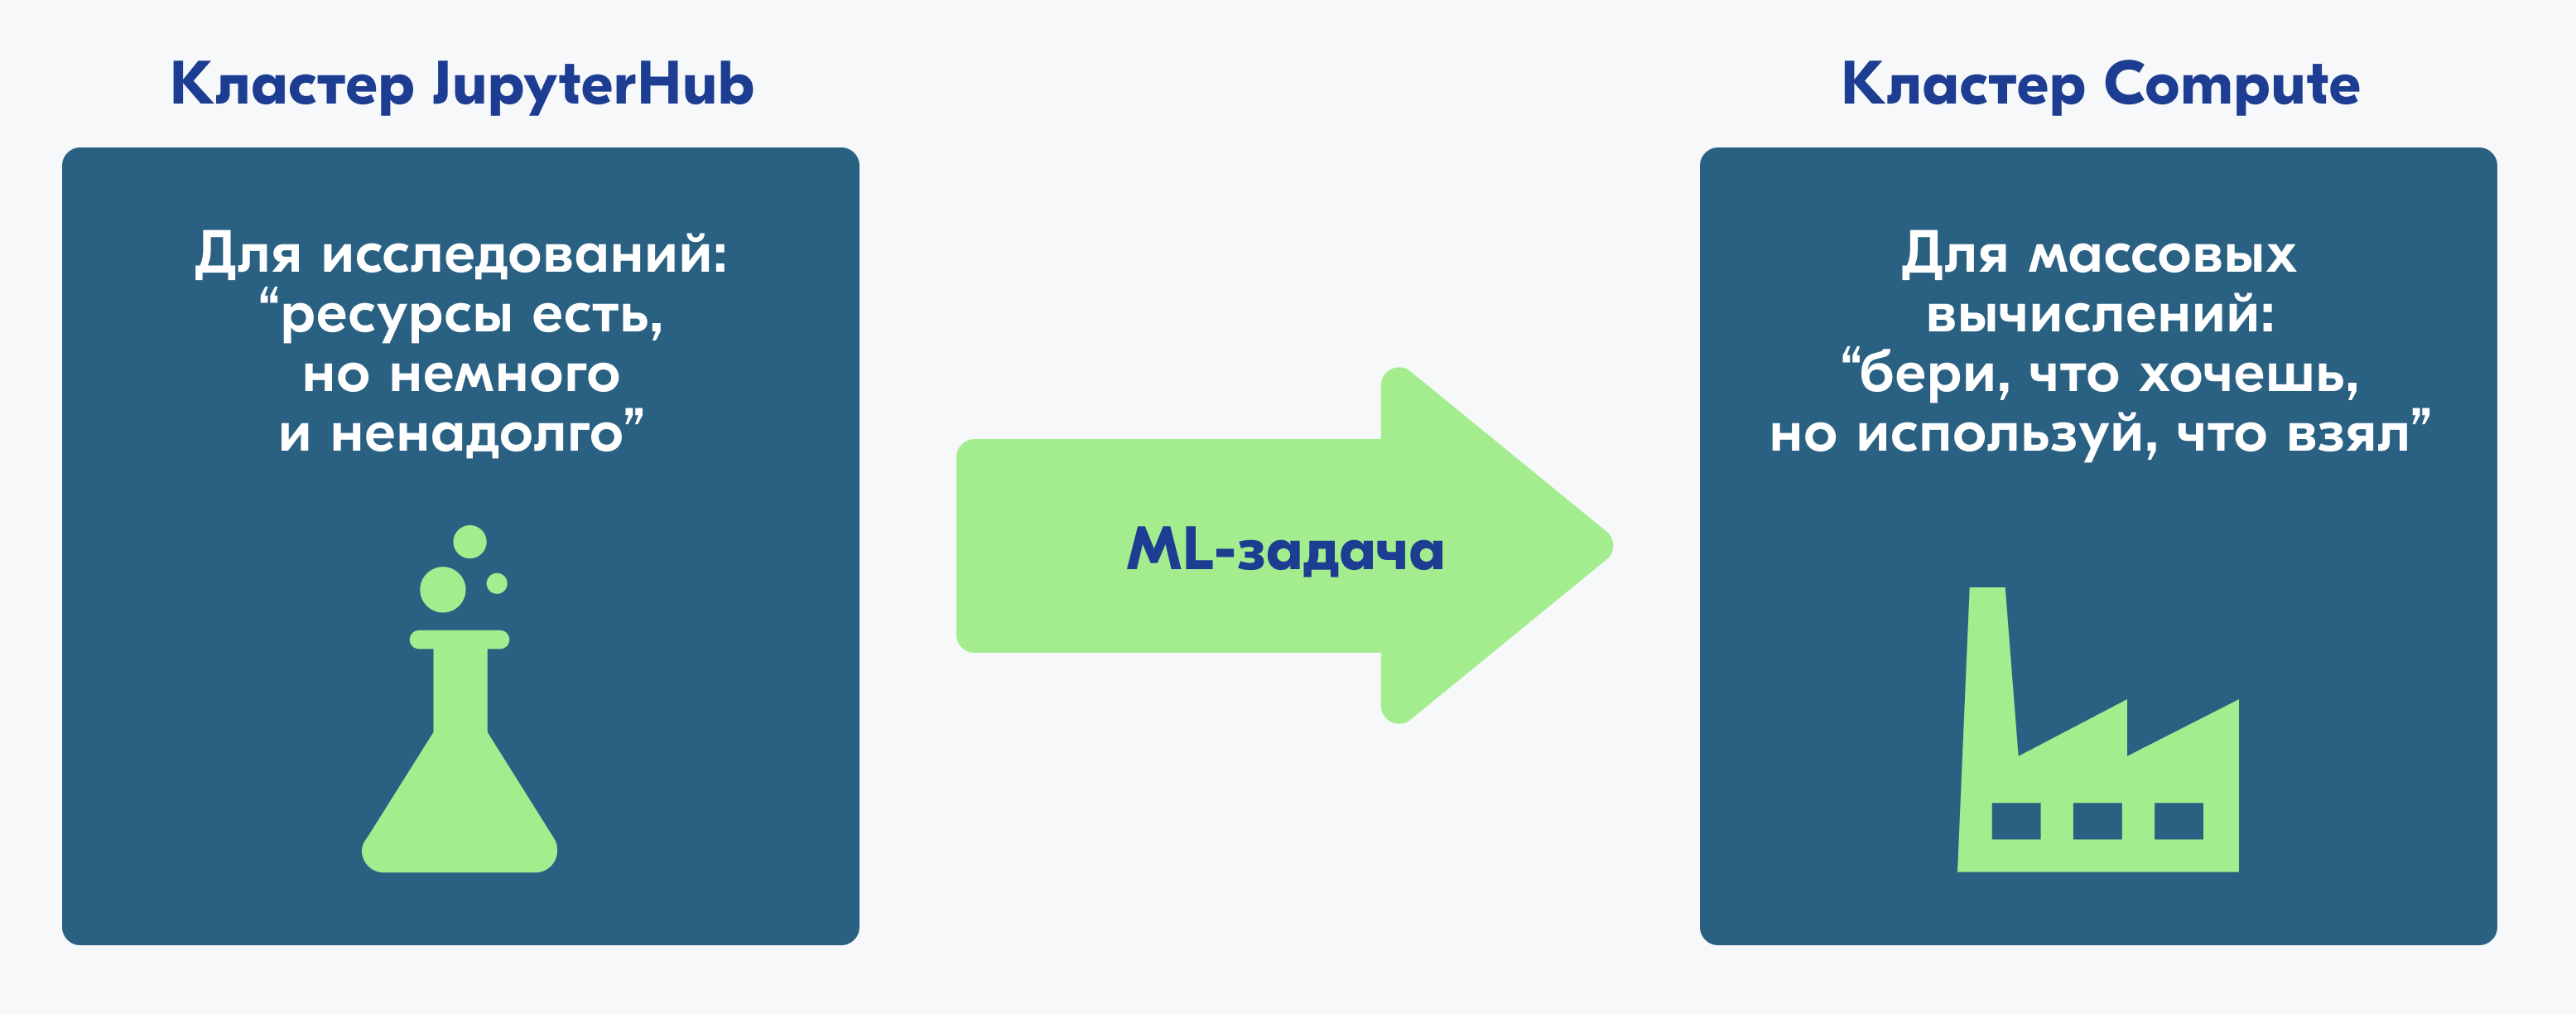
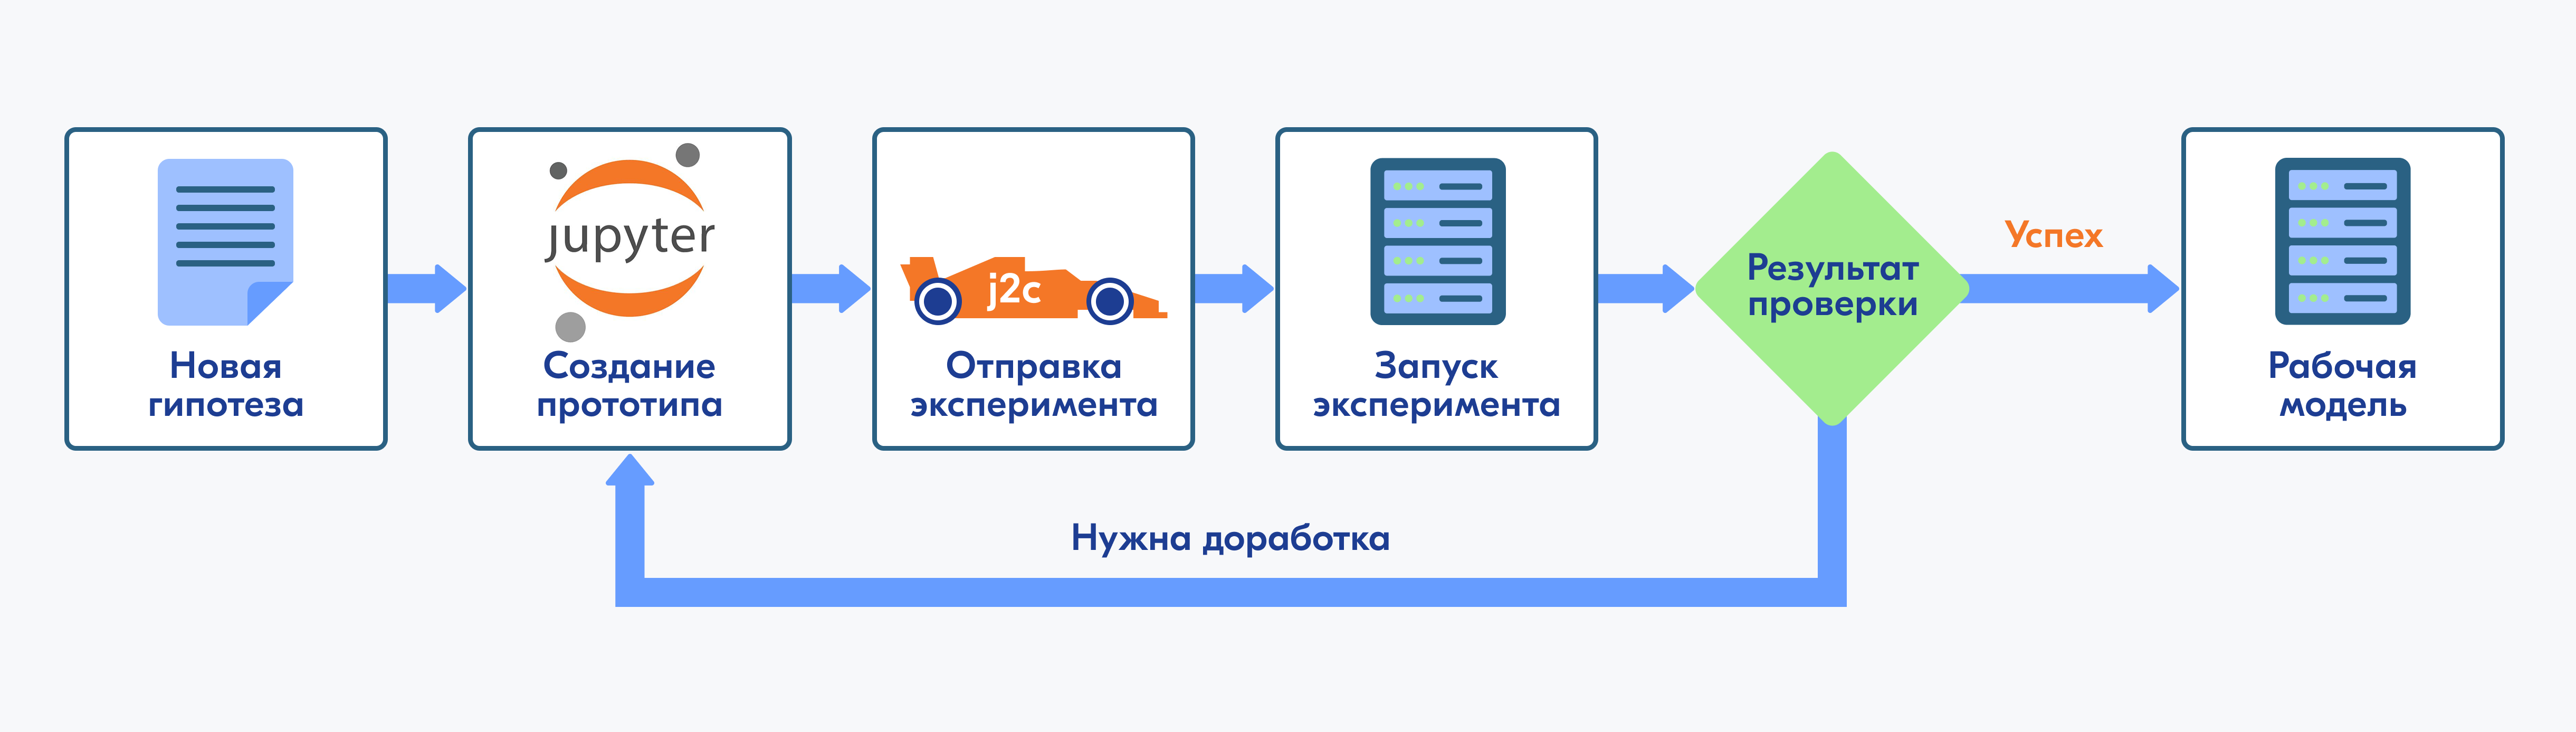
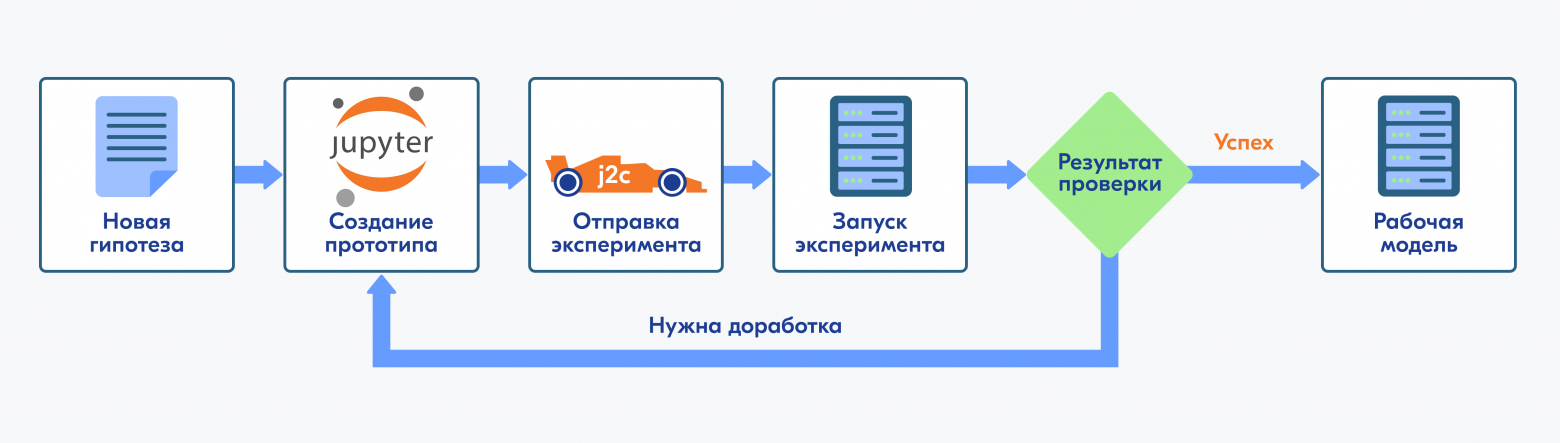
Типичный жизненный цикл ML-проекта начинается с проверки гипотез и написания прототипа. На этой стадии дата-сайентисты используют кластеры вроде JupyterHub. Здесь важна интерактивность: возможность быстро менять код, устанавливать новые библиотеки и сразу видеть результат. Для таких задач не требуются сотни топовых видеокарт — достаточно ресурсов CPU или среднего сегмента GPU. Основной акцент делается на гибкости инструментов и удобстве интерфейса, будь то веб-версия Jupyter или подключение через SSH.
Когда гипотеза подтверждена, наступает этап масштабного обучения на полных датасетах. Здесь требования меняются: необходима высокая производительность, специализированные сетевые интерфейсы между узлами и строгая система планирования ресурсов. В промышленном кластере (Compute) вычислительные мощности предоставляются под конкретные задачи. Система планирования жестко контролирует утилизацию: если выделенная видеокарта простаивает, ресурс возвращается в пул, а задача приостанавливается. Прямое использование интерактивных инструментов в таком кластере нерационально, так как ручное управление приводит к простоям дорогостоящего оборудования.
Сложности воспроизведения окружения
Перенос эксперимента между лабораторией и промышленным кластером — это не просто копирование файлов с расширением .py. В материале выделяются пять критических слоев, формирующих среду выполнения:
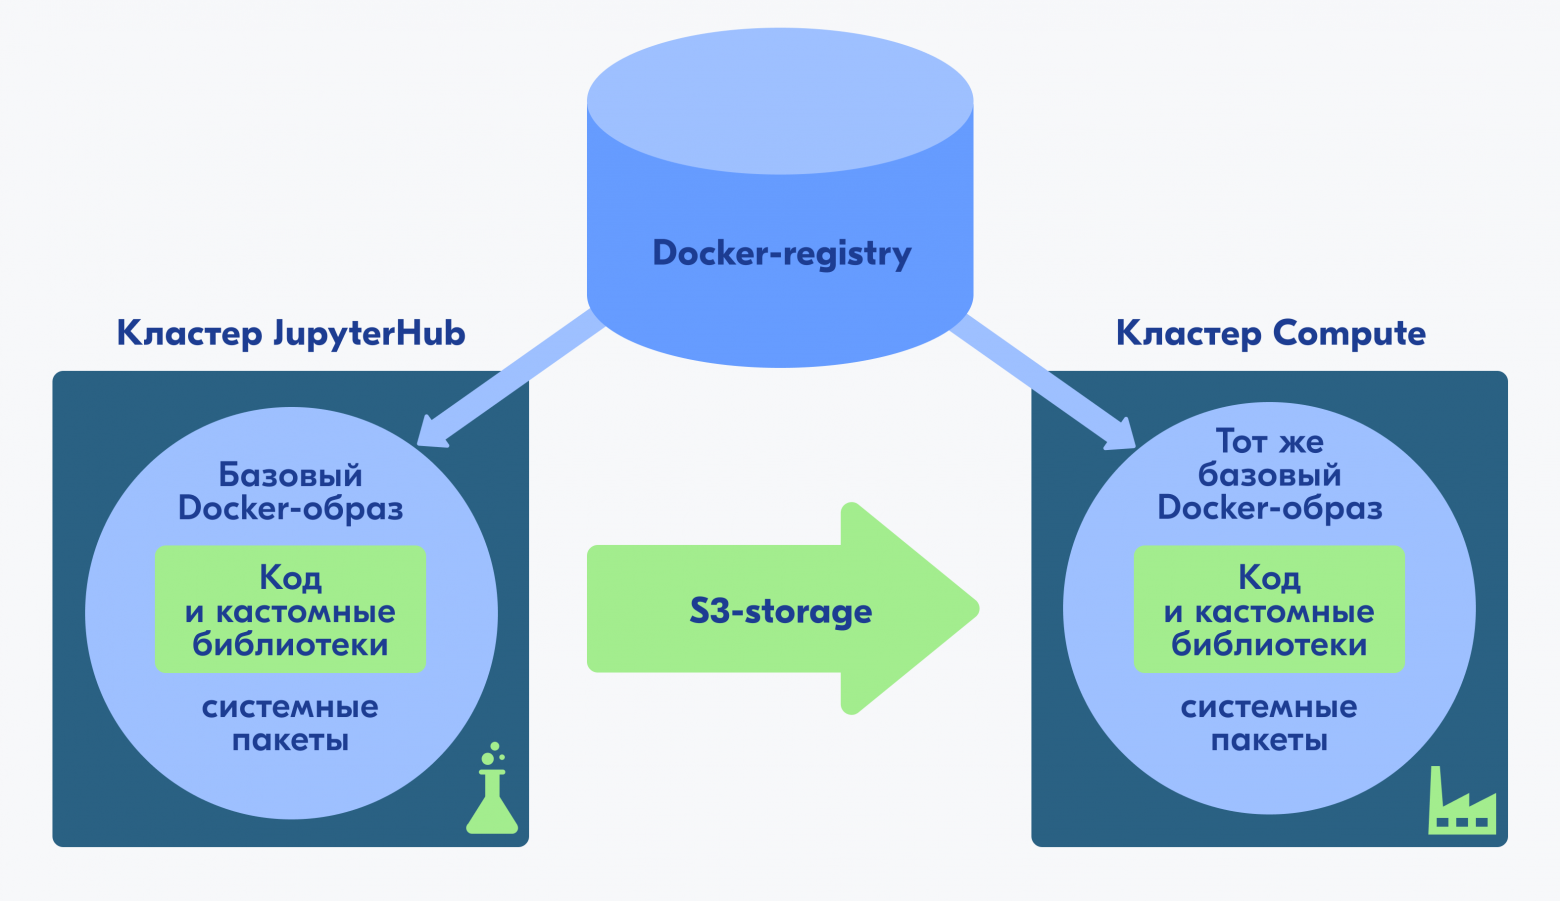
- Данные и артефакты: наборы данных для обучения и веса моделей.
- Пользовательский код: скрипты обучения и предобработки.
- Пользовательские зависимости: библиотеки вроде transformers или кастомные пакеты.
- Системные зависимости: версии Python, PyTorch, CUDA runtime и системные библиотеки (libc).
- Инфраструктура: Docker-образы и конфигурации оркестратора.
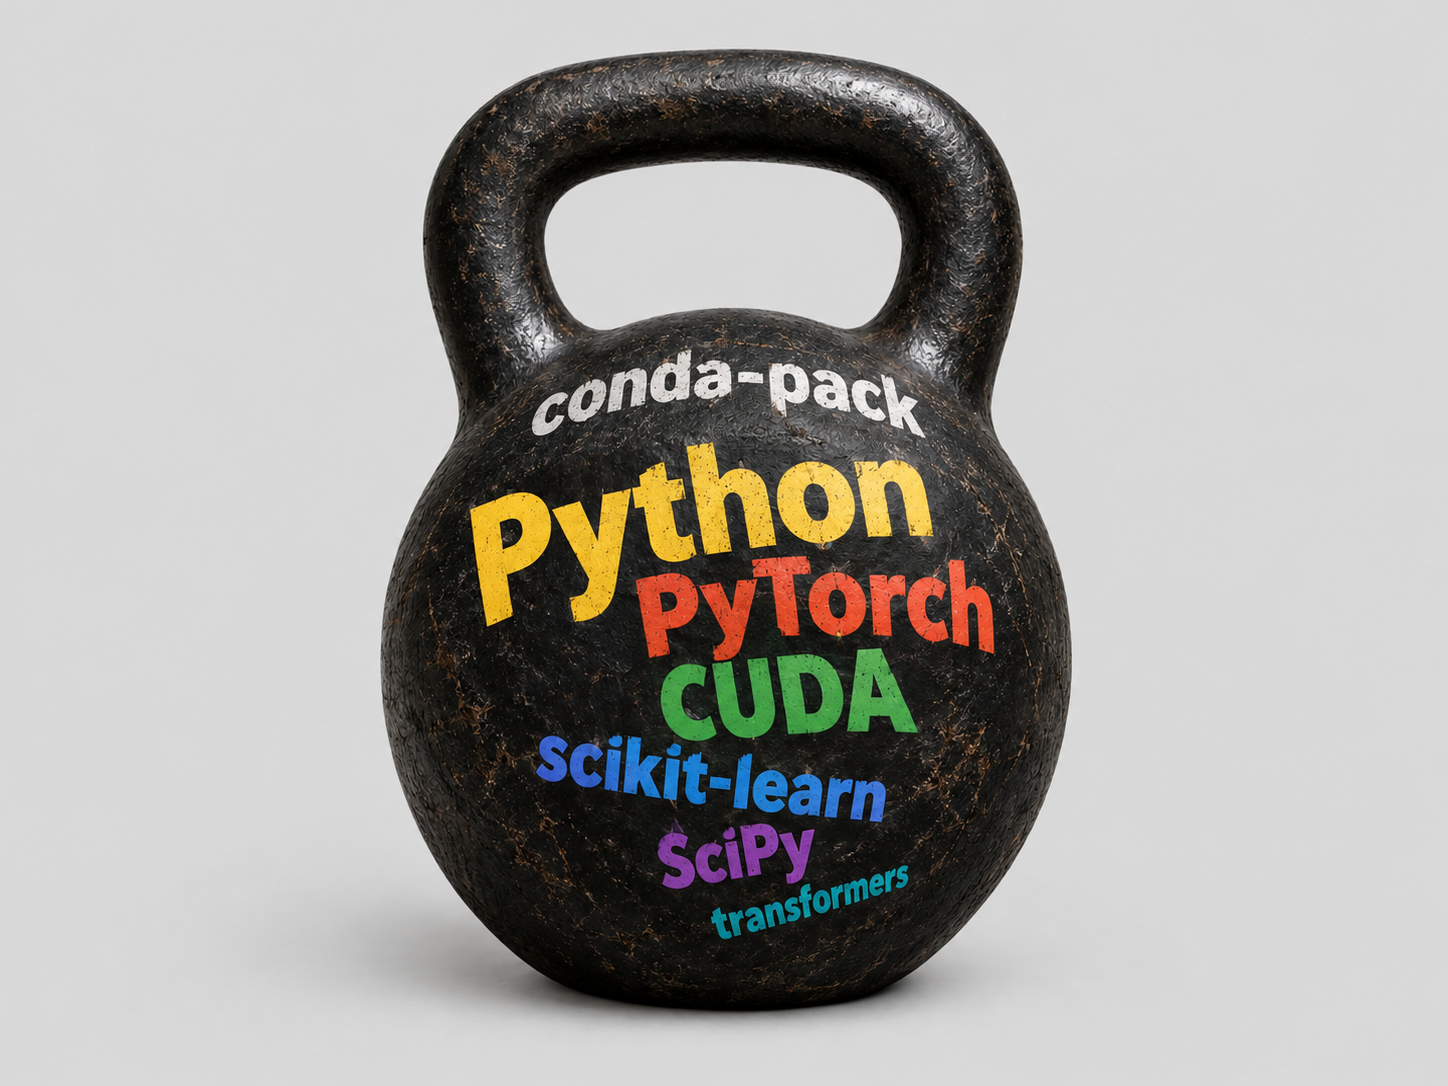
Традиционные способы решения этой задачи имеют свои недостатки. Простая передача requirements.txt заставляет целевой сервер каждый раз скачивать и компилировать пакеты, что долго и нестабильно. Использование полных Docker-образов надежно, но избыточно: малейшее изменение в коде требует пересборки тяжелого контейнера. В поиске компромисса разработчики часто обращаются к инструментам вроде conda-pack, которые создают самодостаточные архивы. Однако при включении в архив Python и CUDA размер пакета разрастается до десятков гигабайт, а сборка может занимать больше часа.
Использование единой экосистемы для оптимизации
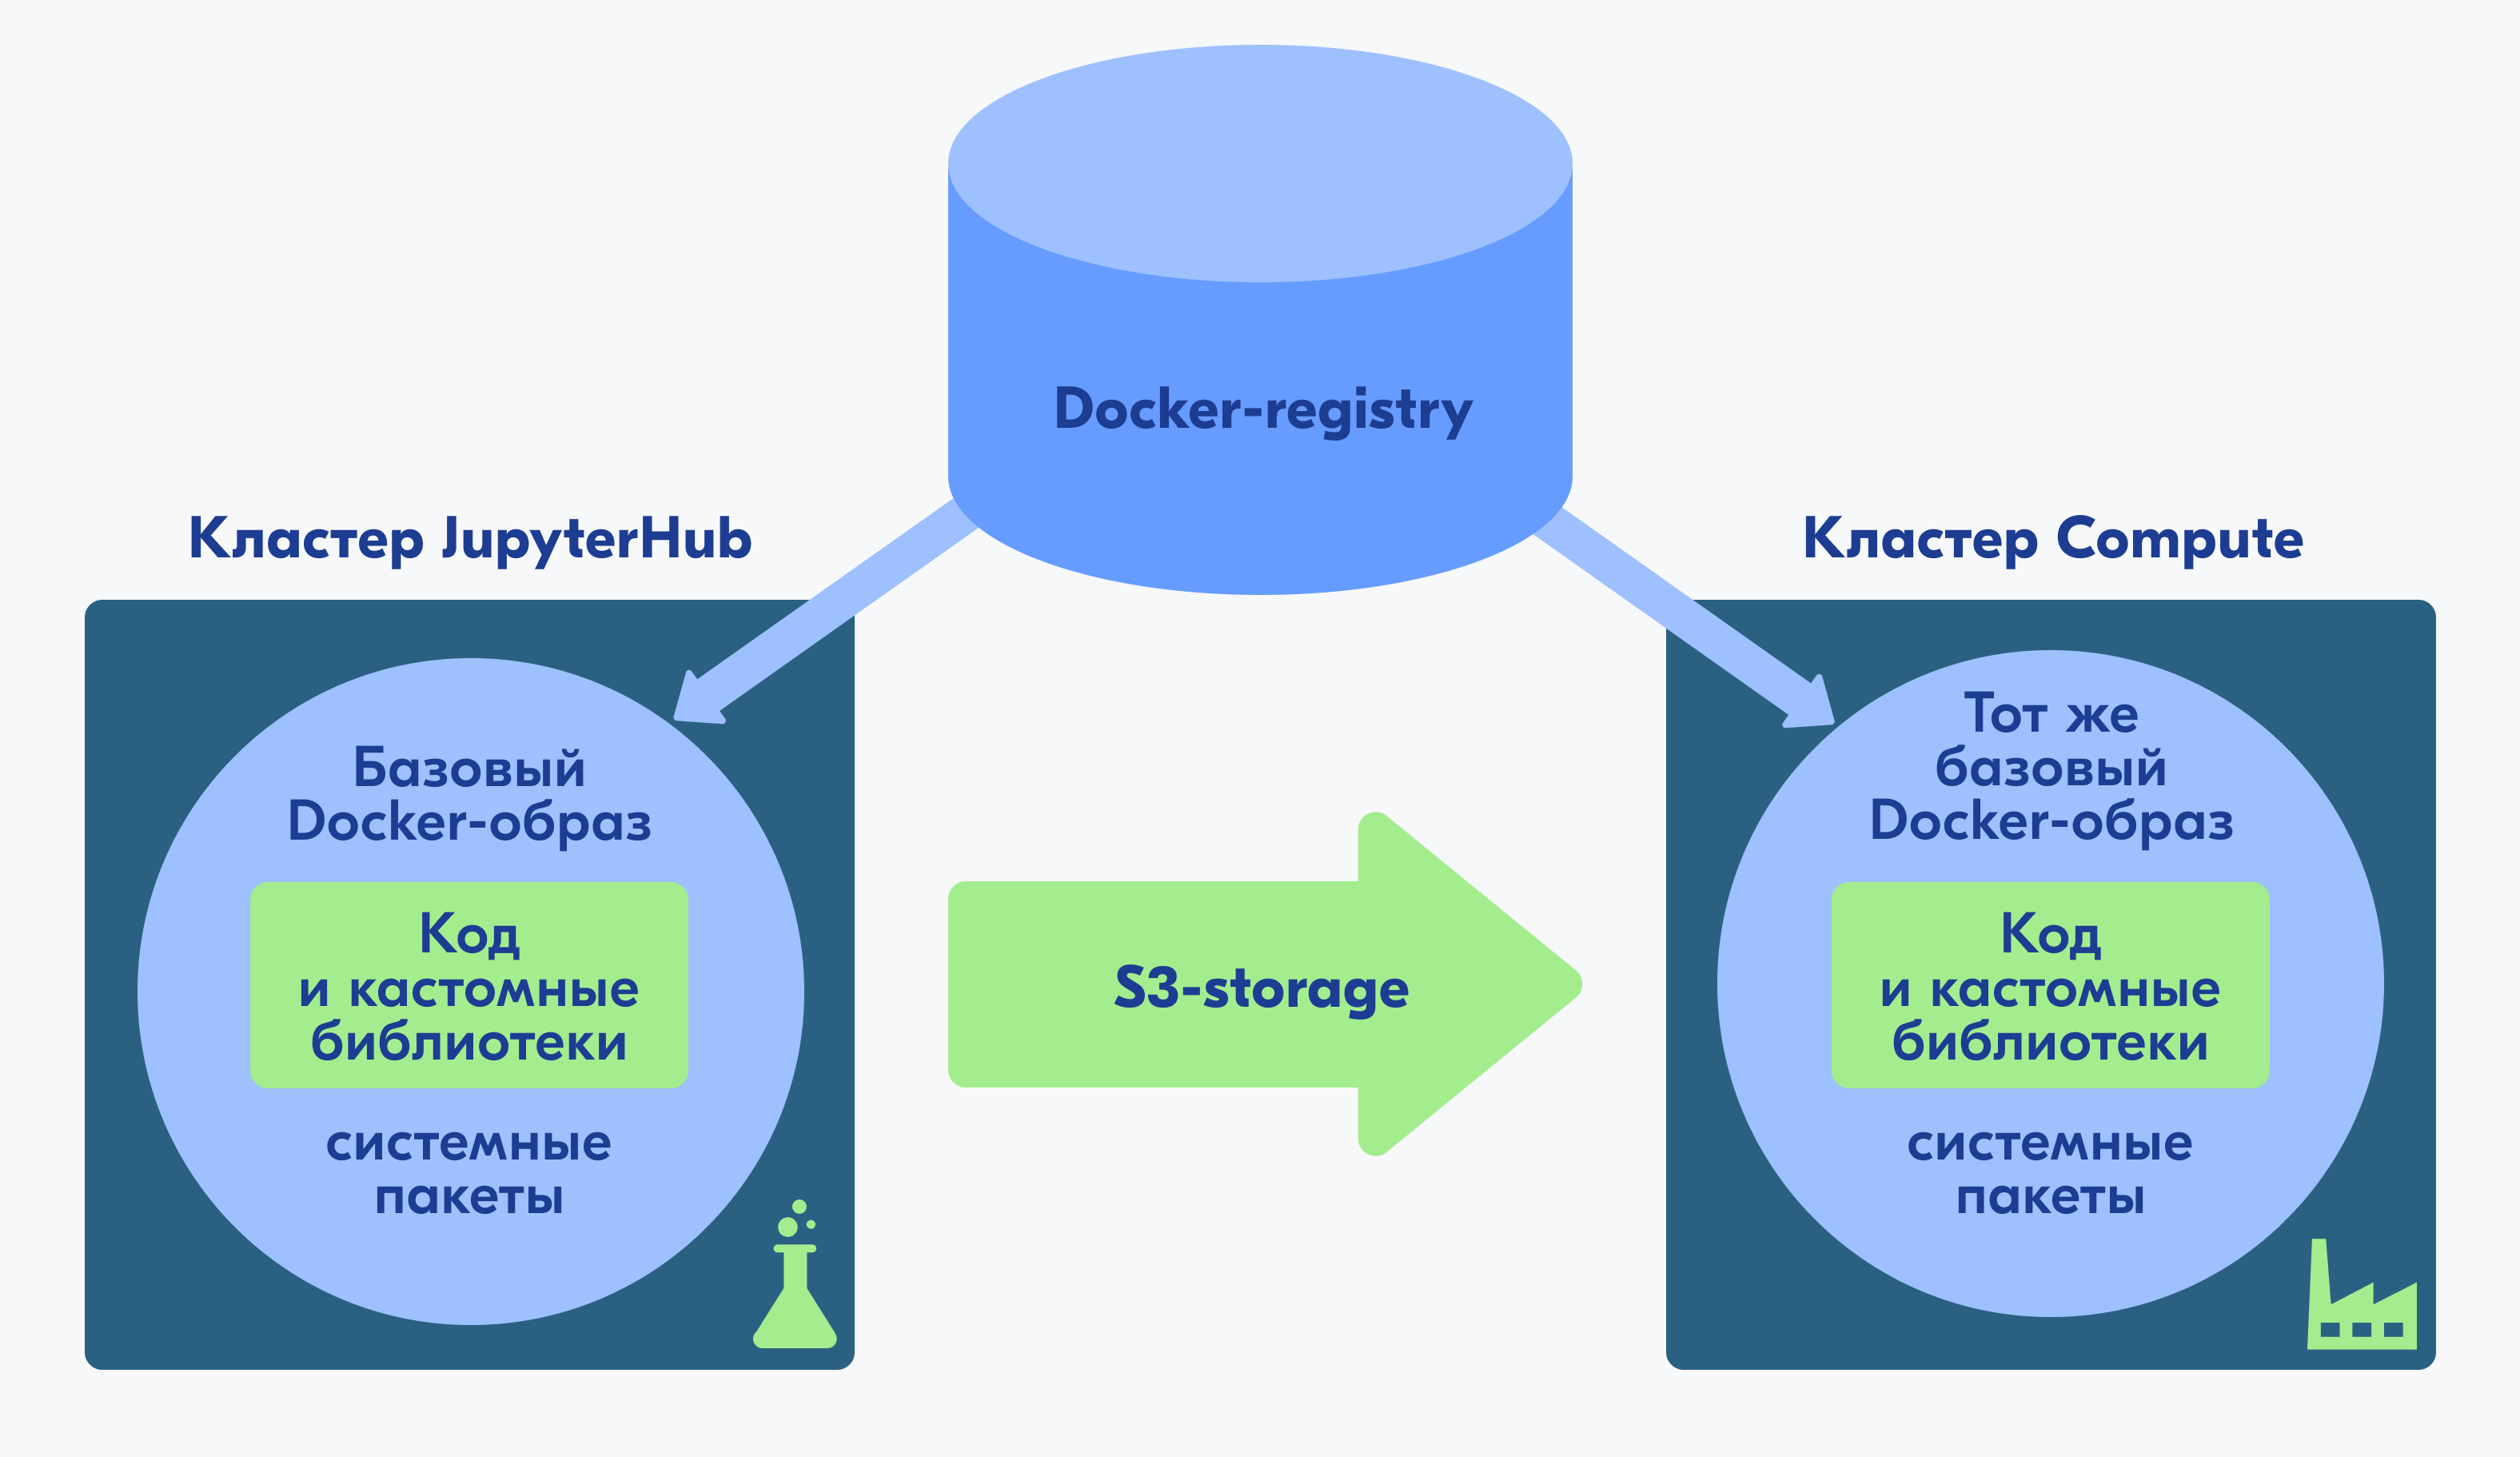
Оптимальный путь заключается в отказе от полной автономности архива в пользу ресурсов общей платформы. Если оба кластера (исследовательский и вычислительный) используют Docker-образы из одного хаба, нет смысла переносить системные библиотеки, которые уже присутствуют в целевой среде. В материале показано, что в базовый образ платформы целесообразно заранее включить:
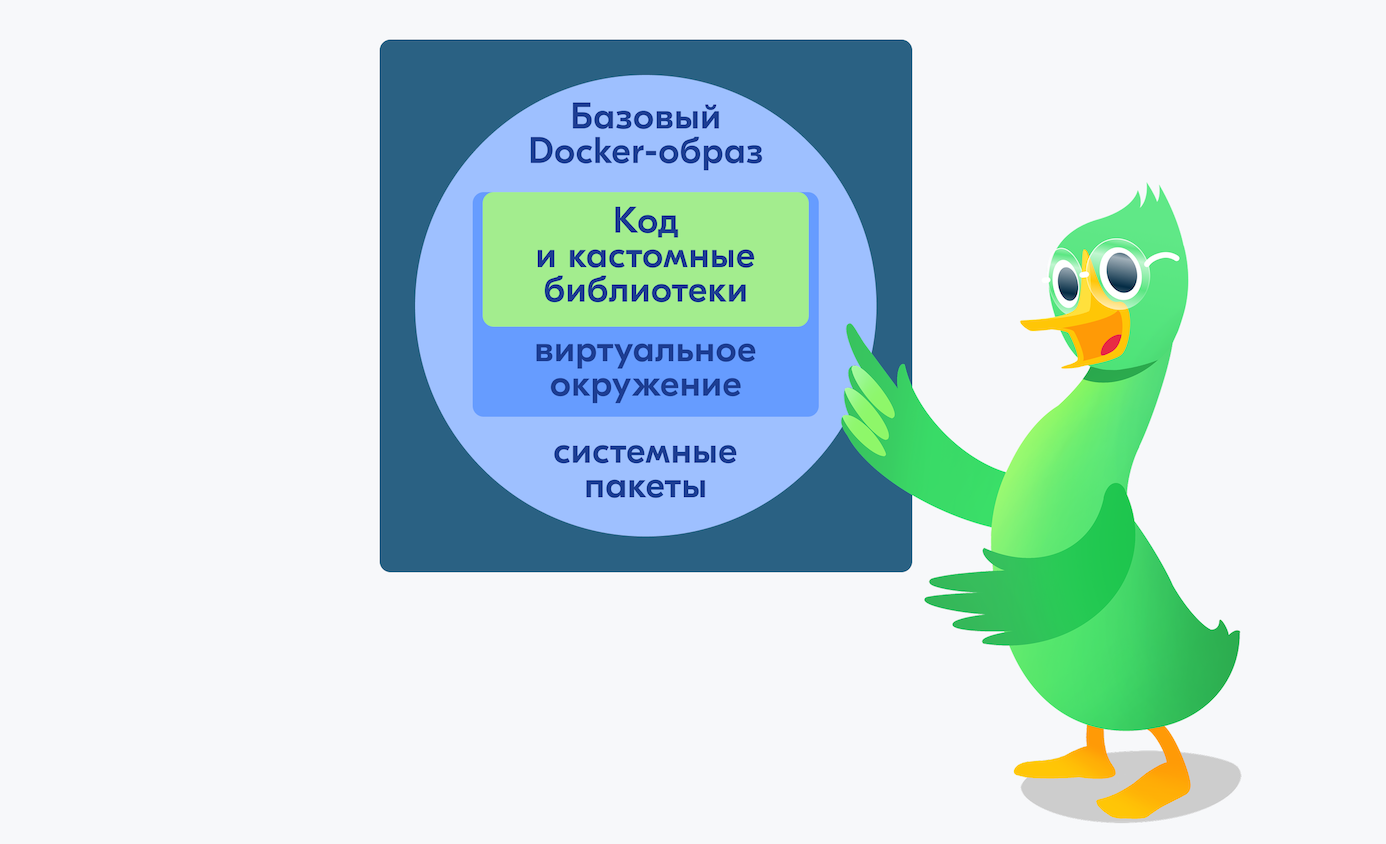
- стандартные версии Python и PyTorch;
- CUDA runtime;
- базовый набор ML-фреймворков и инструментов мониторинга.
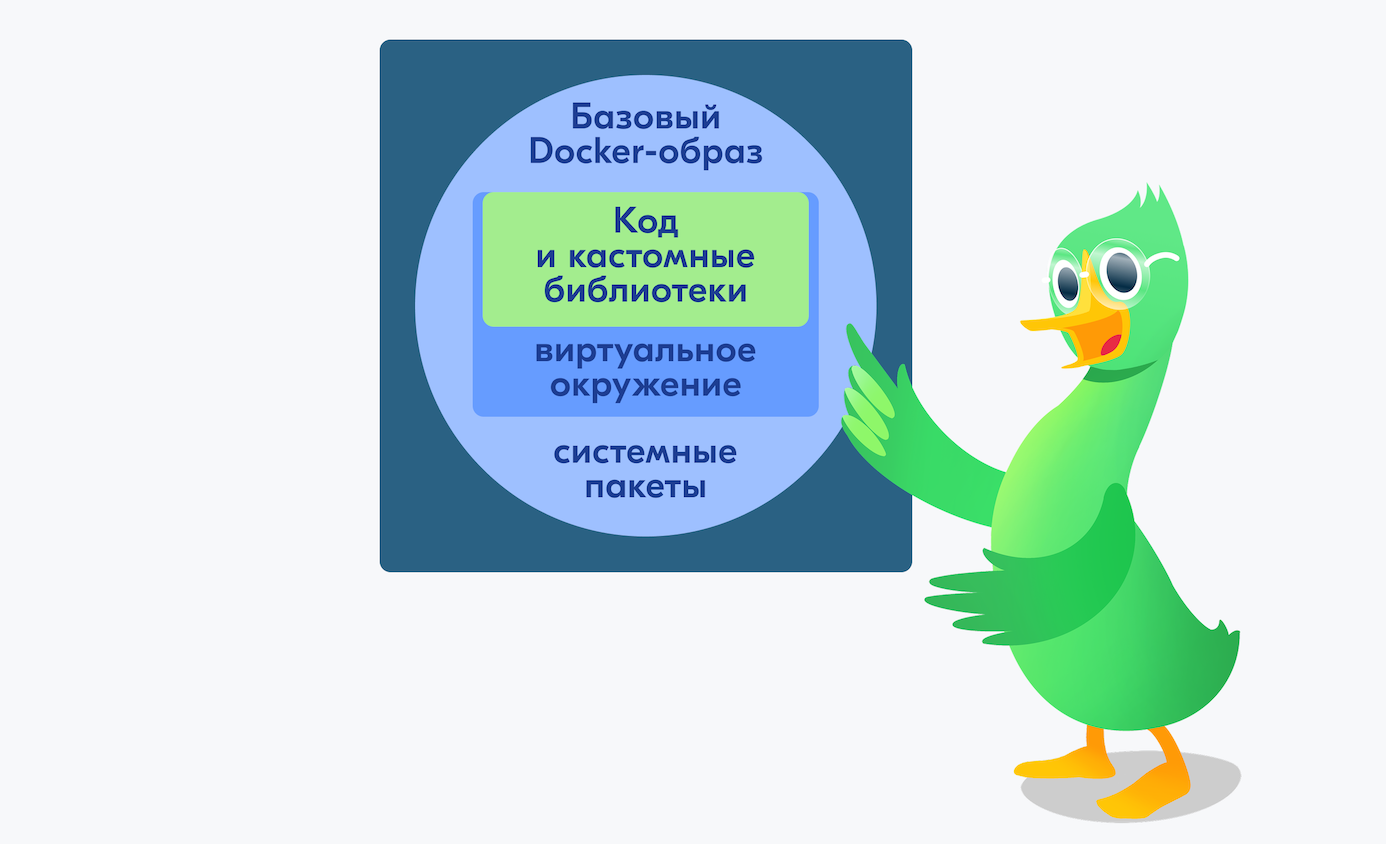
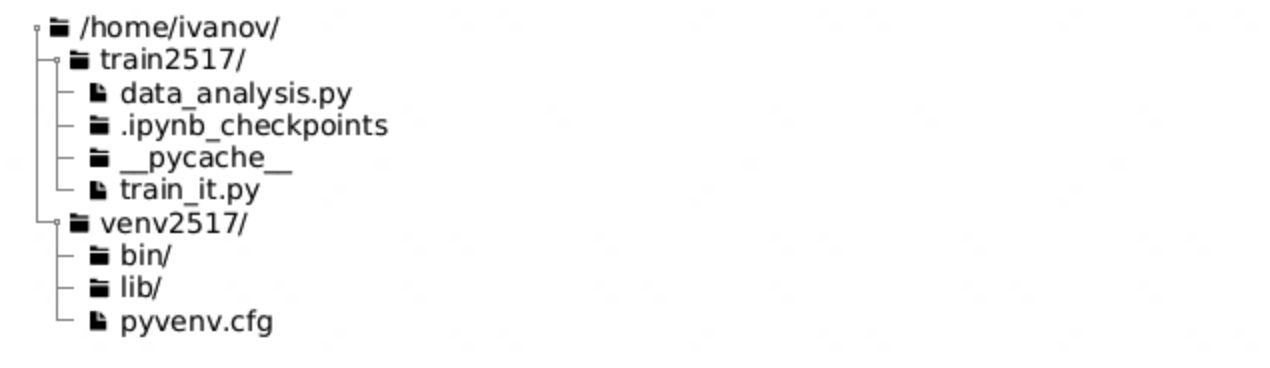
При таком подходе переносимыми становятся только пользовательский код и специфические библиотеки. Для их изоляции применяется механизм виртуальных окружений (venv). Если создавать окружение с флагом --system-site-packages, оно будет наследовать системные пакеты из образа, но хранить только явно установленные пользователем дополнения. Это позволяет упаковывать в архив лишь директорию venv, объем которой на порядки меньше полного дистрибутива Python с CUDA.
Архитектура инструмента j2c и этапы его работы
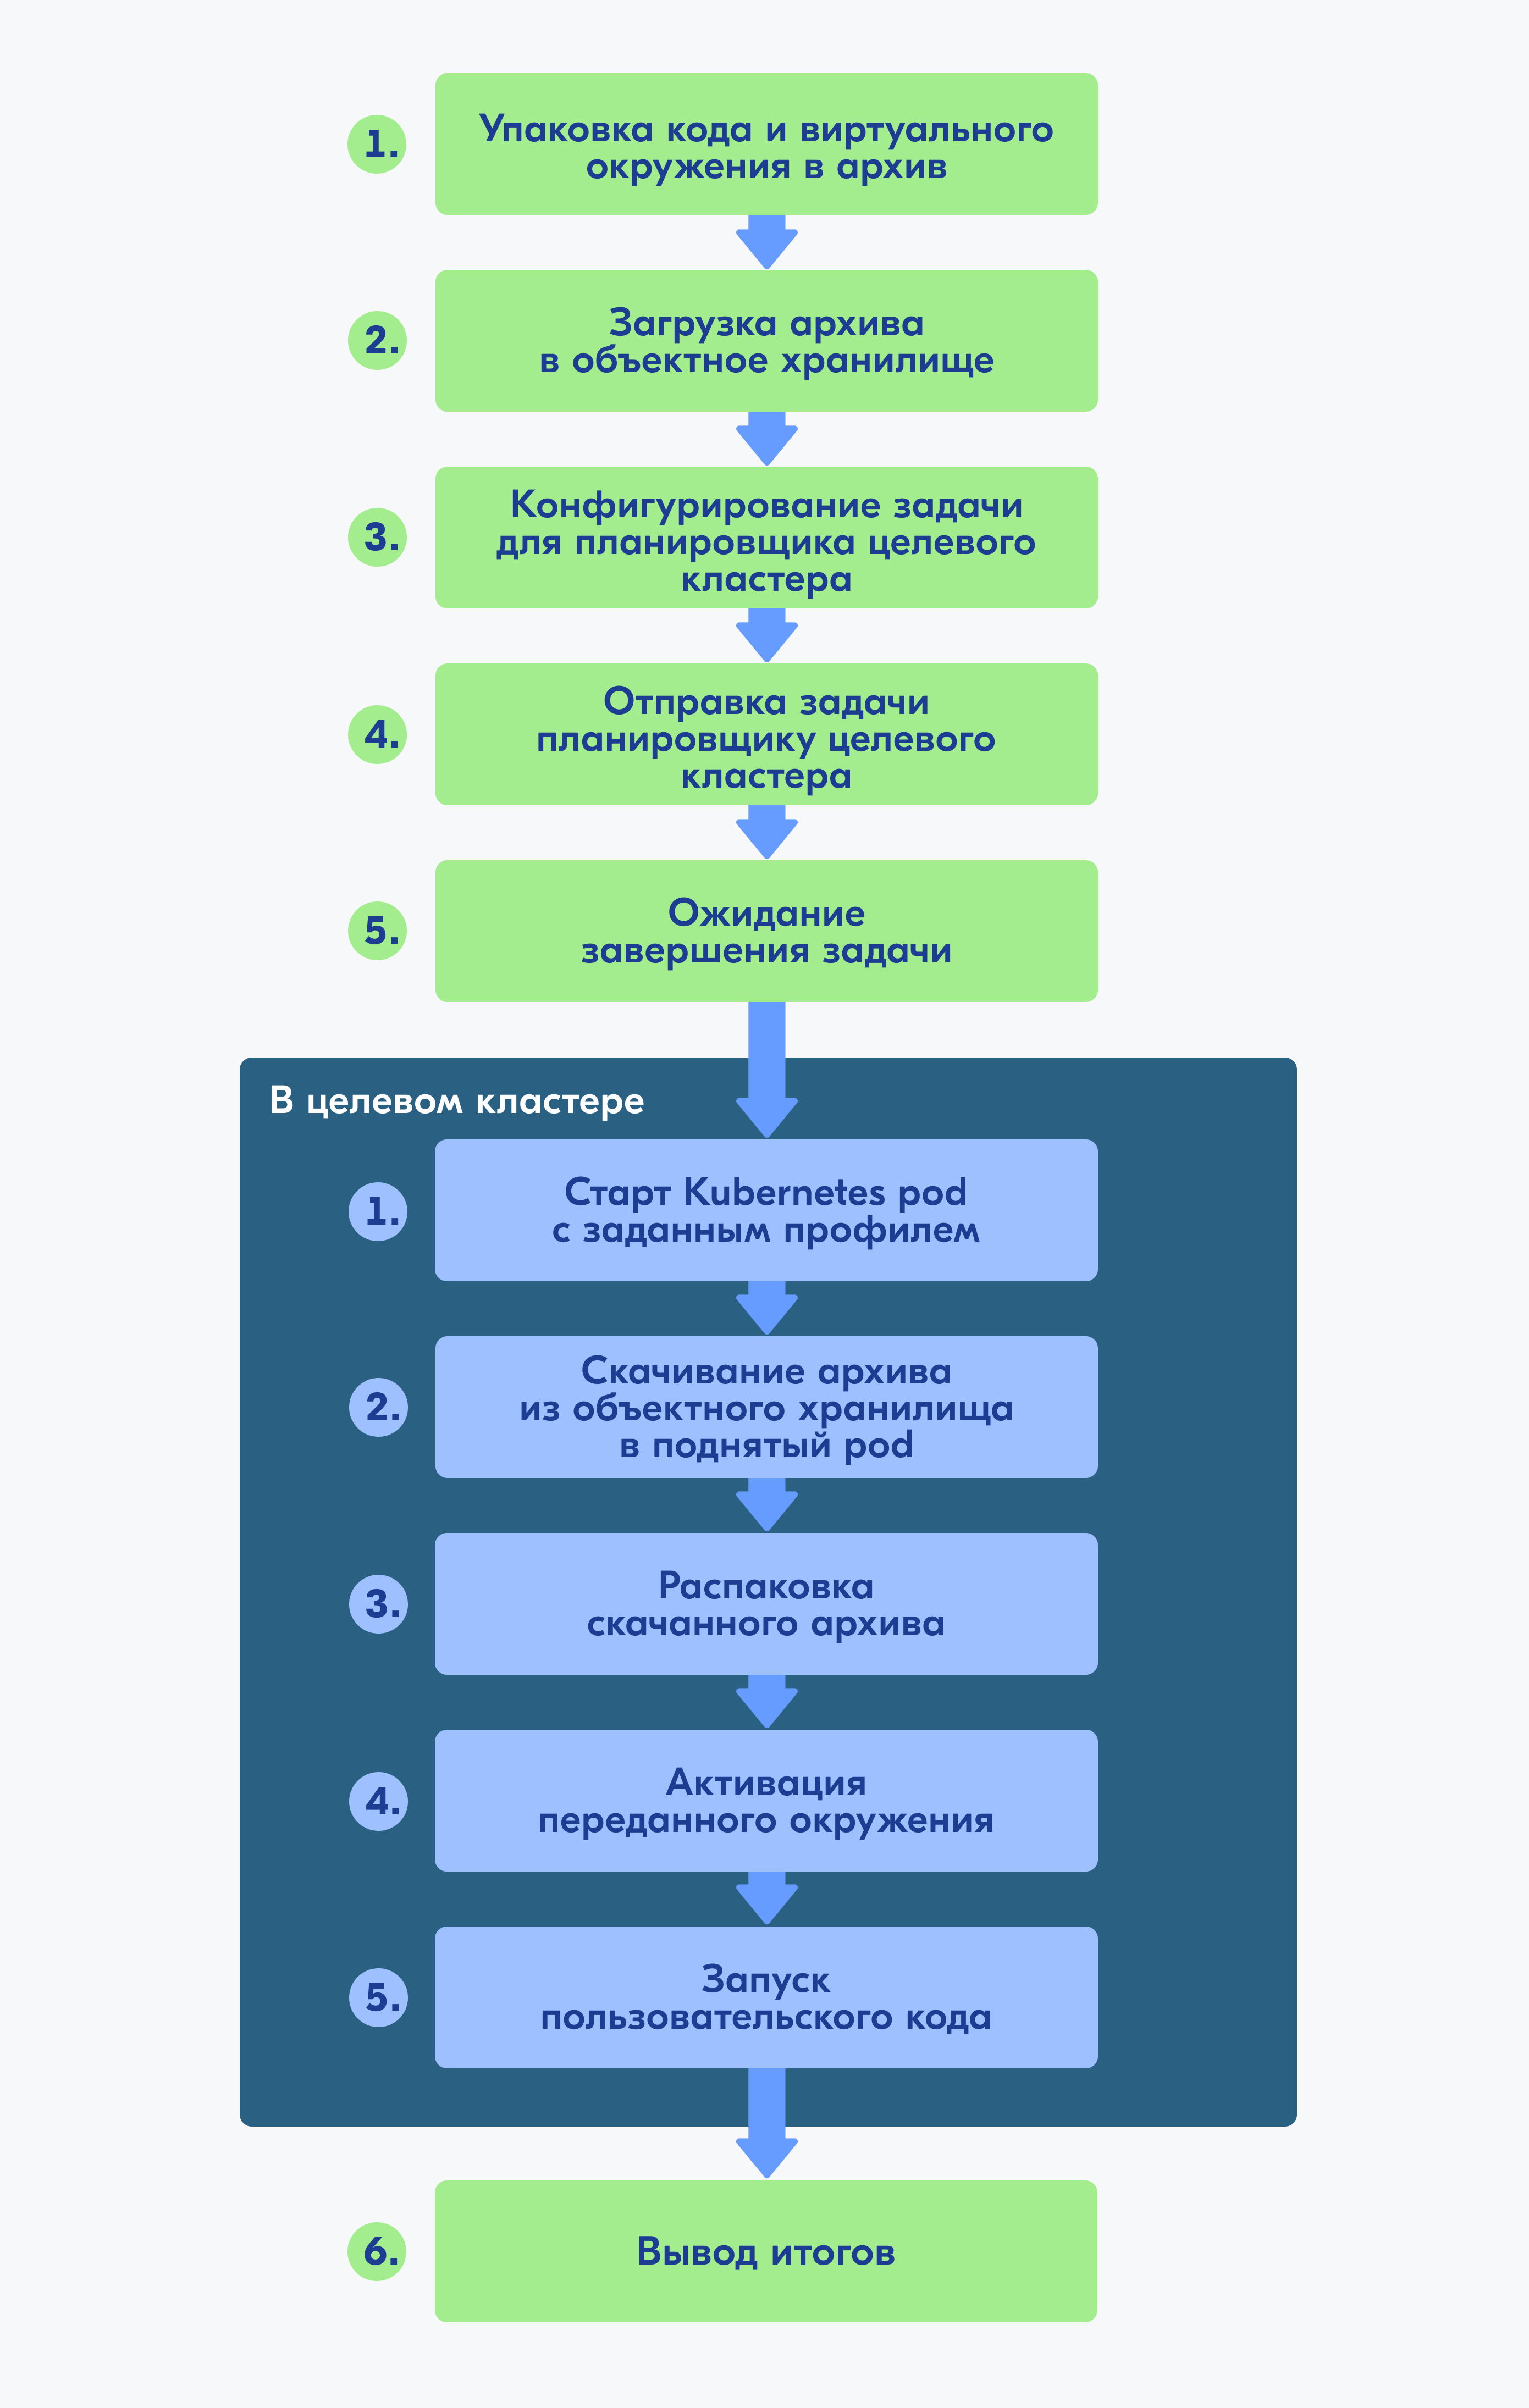
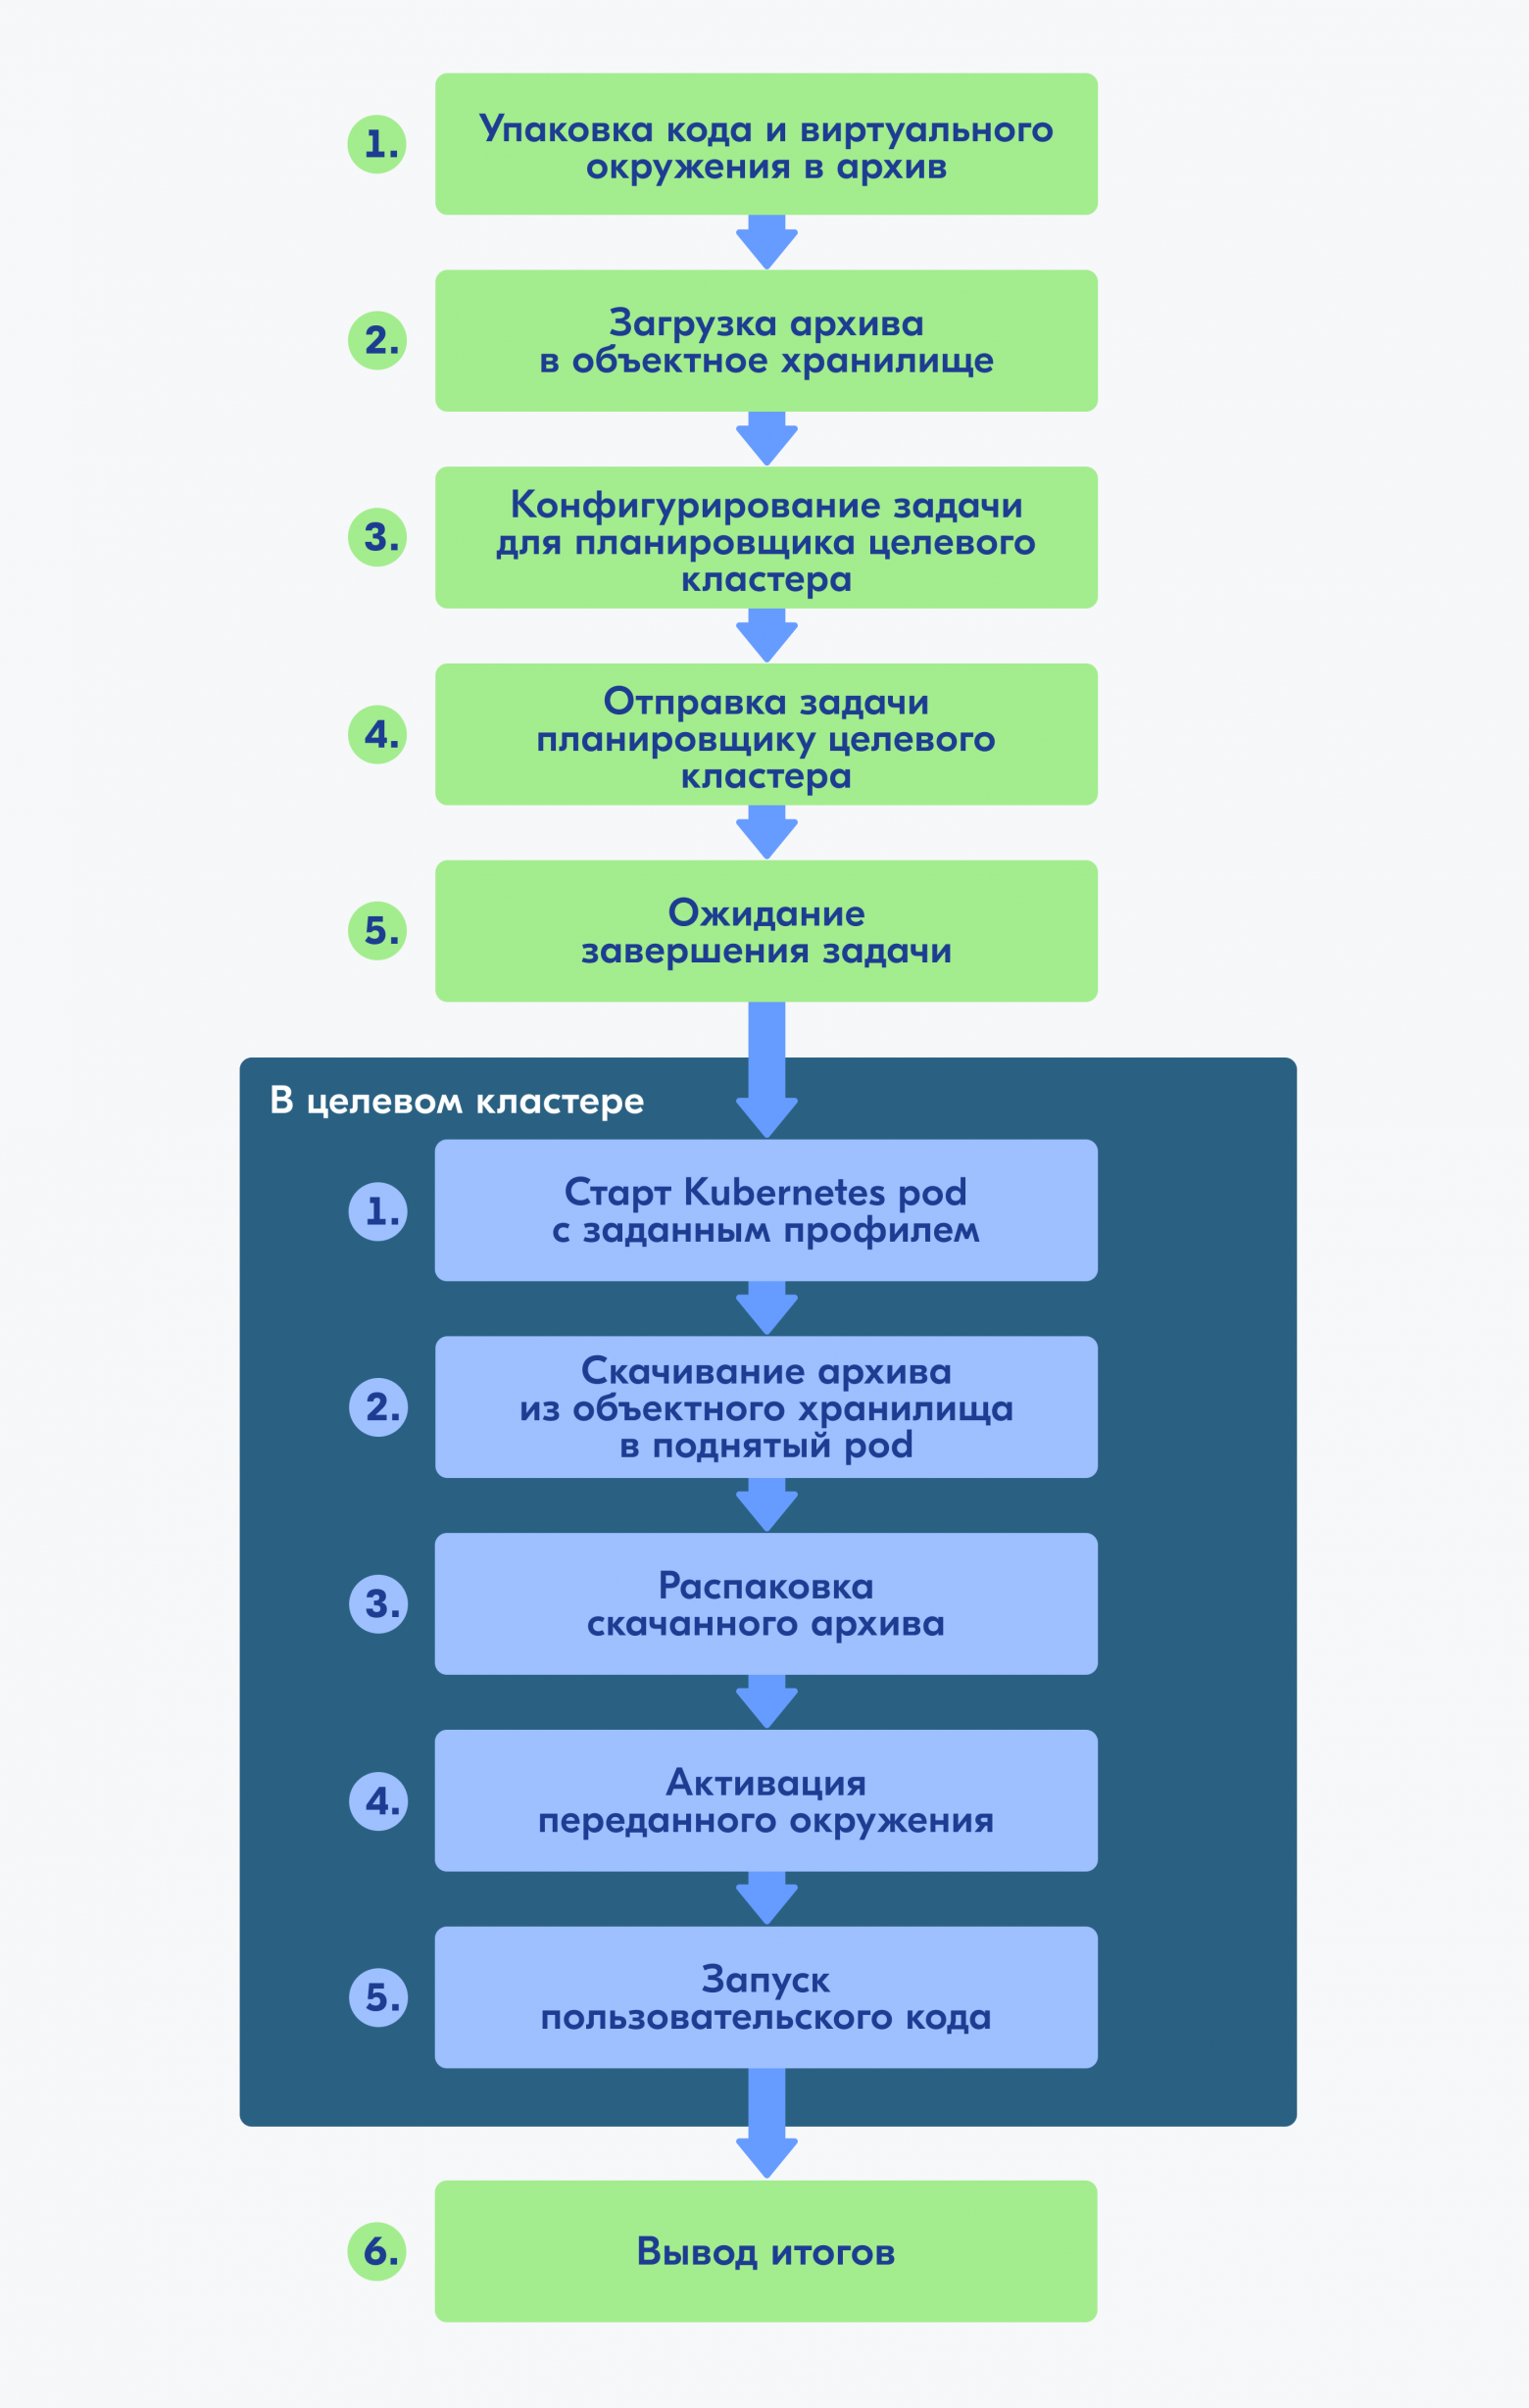
Инструмент j2c (JupyterHub to Compute) представляет собой CLI-библиотеку на Python, которая автоматизирует весь цикл доставки кода. Пользователю достаточно одной команды j2c pack с указанием путей к коду и виртуальному окружению. Процесс разделен на несколько автоматизированных стадий.
Упаковка и хранение
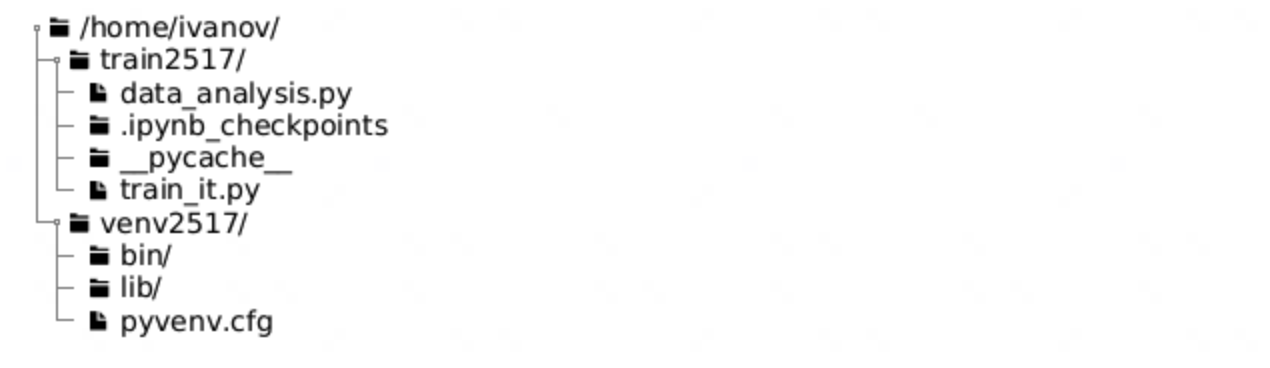
На первом этапе библиотека собирает файлы проекта и содержимое виртуального окружения. Важным нюансом реализации является исключение служебных файлов (вроде __pycache__ или .git) и обработка вложенных директорий, чтобы избежать дублирования данных. В архиве создается manifest.json, где фиксируются точки входа и пути внутри проекта.
Готовый архив загружается в S3-совместимое объектное хранилище. Это хранилище выступает общей точкой доступа для обоих кластеров. Использование промежуточного хранилища позволяет запускать один и тот же эксперимент многократно без повторной сборки.
Планирование и запуск
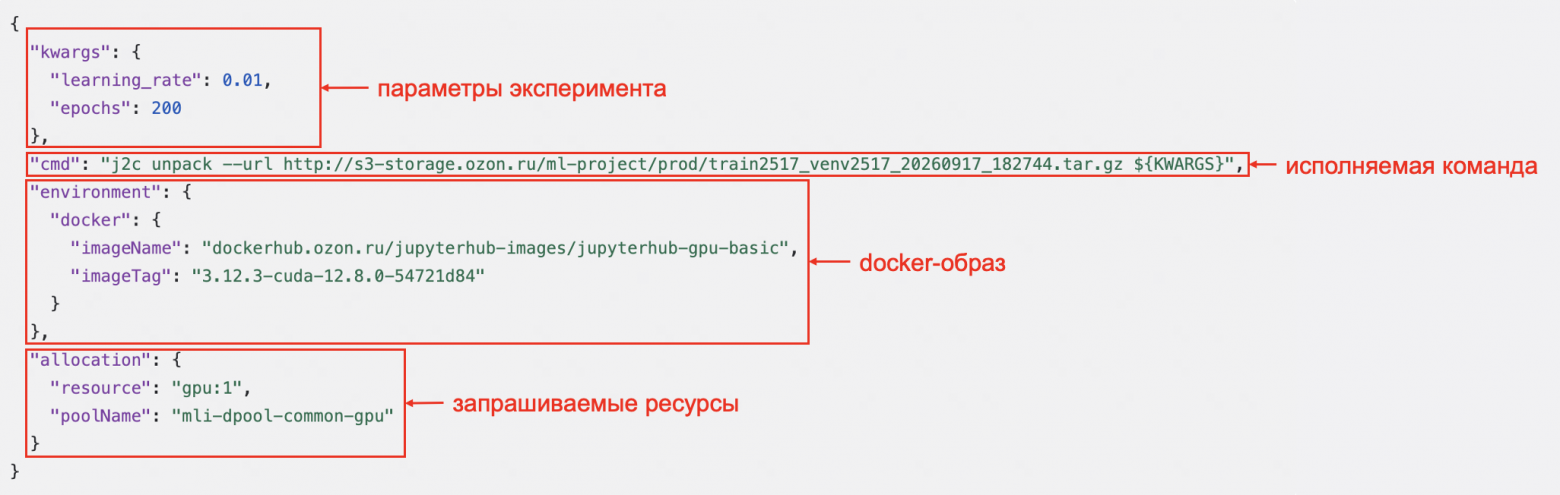
Библиотека формирует конфигурацию для планировщика задач в формате JSON. В ней указывается необходимый Docker-образ, объем ресурсов (GPU, RAM) и команда запуска. В качестве исполняемой команды на целевом узле всегда выступает j2c unpack. Этот процесс в Compute-кластере выполняет следующие действия:
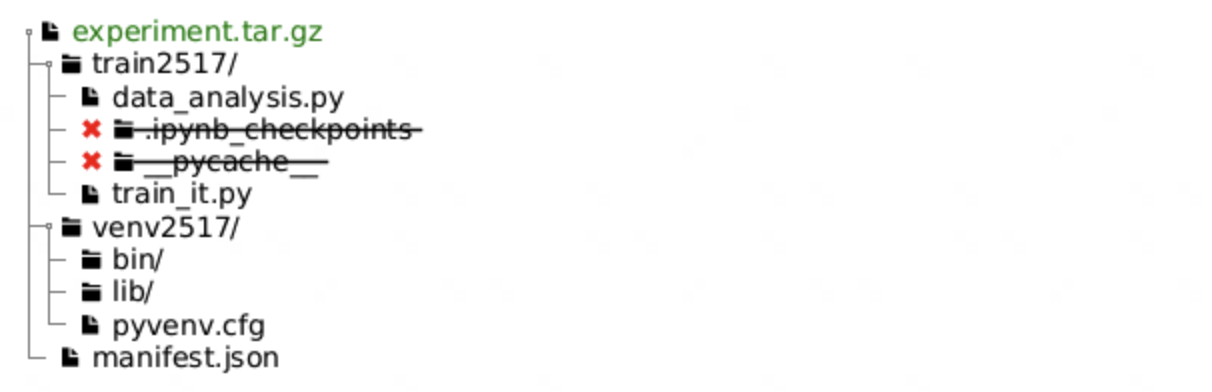
- скачивает архив из объектного хранилища;
- разворачивает его в рабочей директории контейнера;
- активирует переданное виртуальное окружение;
- запускает скрипт обучения с пользовательскими аргументами.
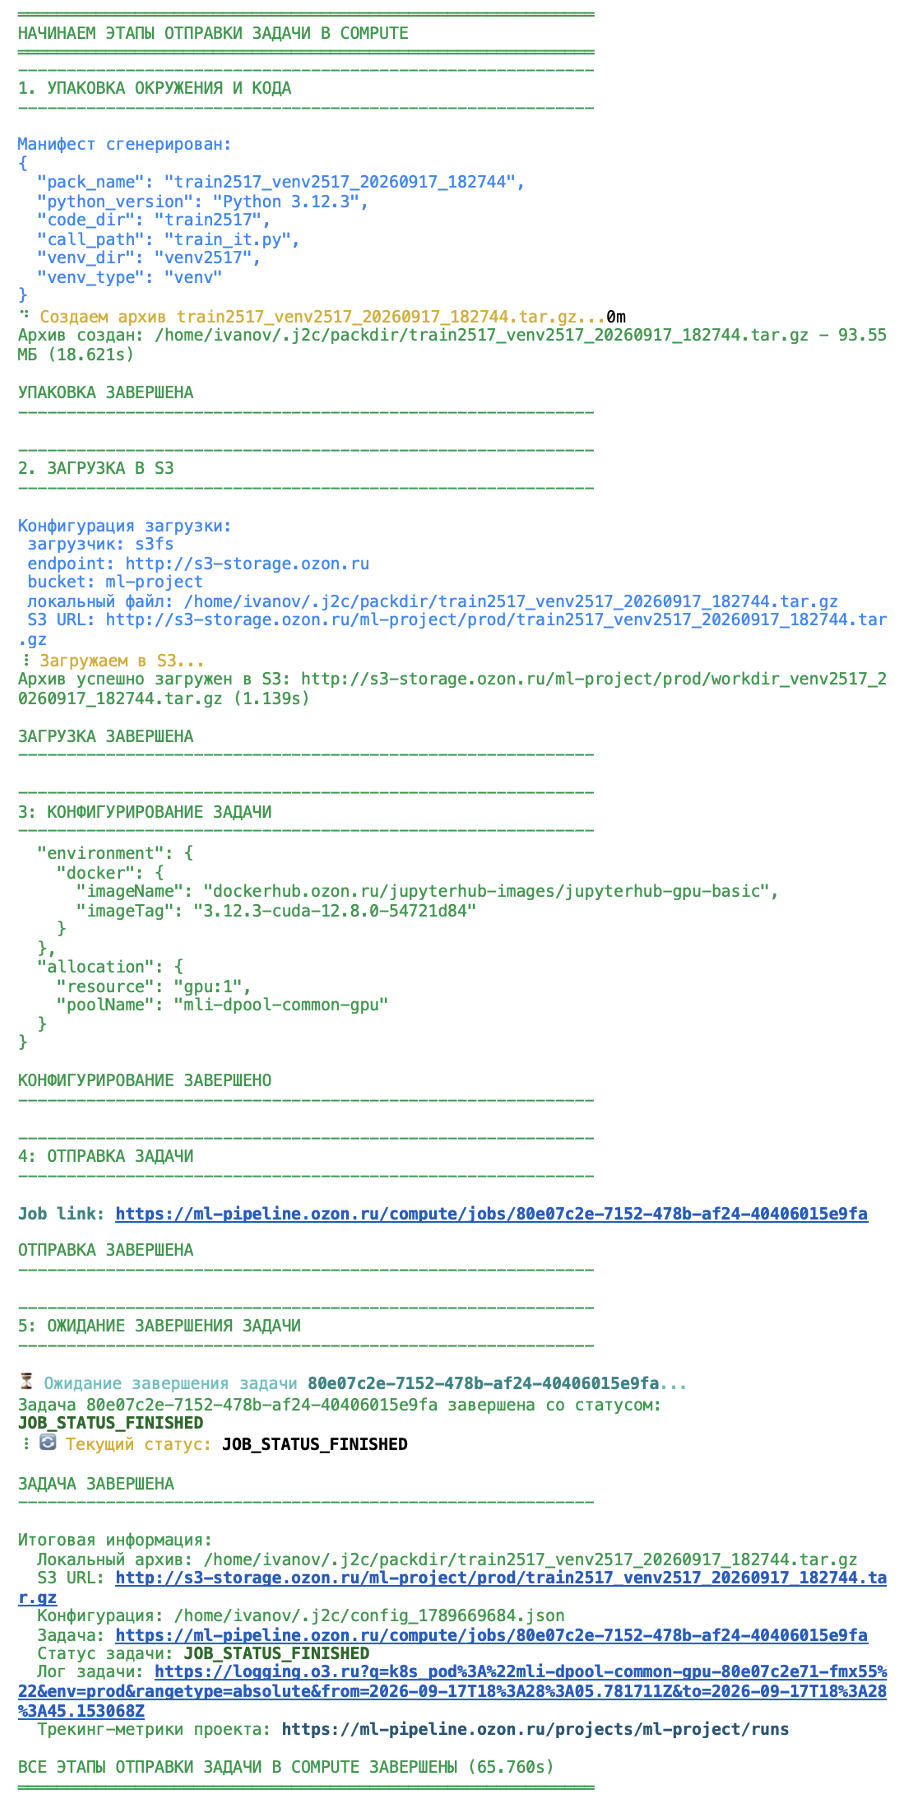
В материале отмечается, что j2c unpack гарантированно присутствует в целевой среде, так как является частью системного образа платформы. После отправки задачи инструмент переходит в режим ожидания, транслируя логи выполнения в реальном времени. Если процесс прервется, механизмы идемпотентности позволяют возобновить работу с последнего успешного этапа (например, не загружая архив в S3 повторно).
Результаты внедрения и влияние на разработку
Переход от ручного переноса к автоматизированному инструменту позволяет сократить время вывода ML-продуктов на рынок (Time-To-Market). Вместо того чтобы тратить часы на настройку окружения в другом кластере, исследователь выполняет перенос за минуты. При этом не требуется закупка дополнительных GPU для исследовательских сред — мощности Compute-кластера используются максимально эффективно за счет автоматического планирования и контроля утилизации, которая в промышленных условиях может достигать 80%.
Ключевой вывод заключается в том, что создание удобной инфраструктуры — это не только предоставление доступа к оборудованию, но и построение экосистемы, где инструменты осознанно используют общие компоненты платформы. Это делает ML-эксперименты менее зависимыми от конкретного кластера и позволяет легко масштабировать вычисления там, где ресурсы наиболее доступны в данный момент.
