
Мой блог
NVIDIA BioNeMo Inference Runtime: как библиотека BioIR ускоряет предсказание структуры белков в 2,9 раза

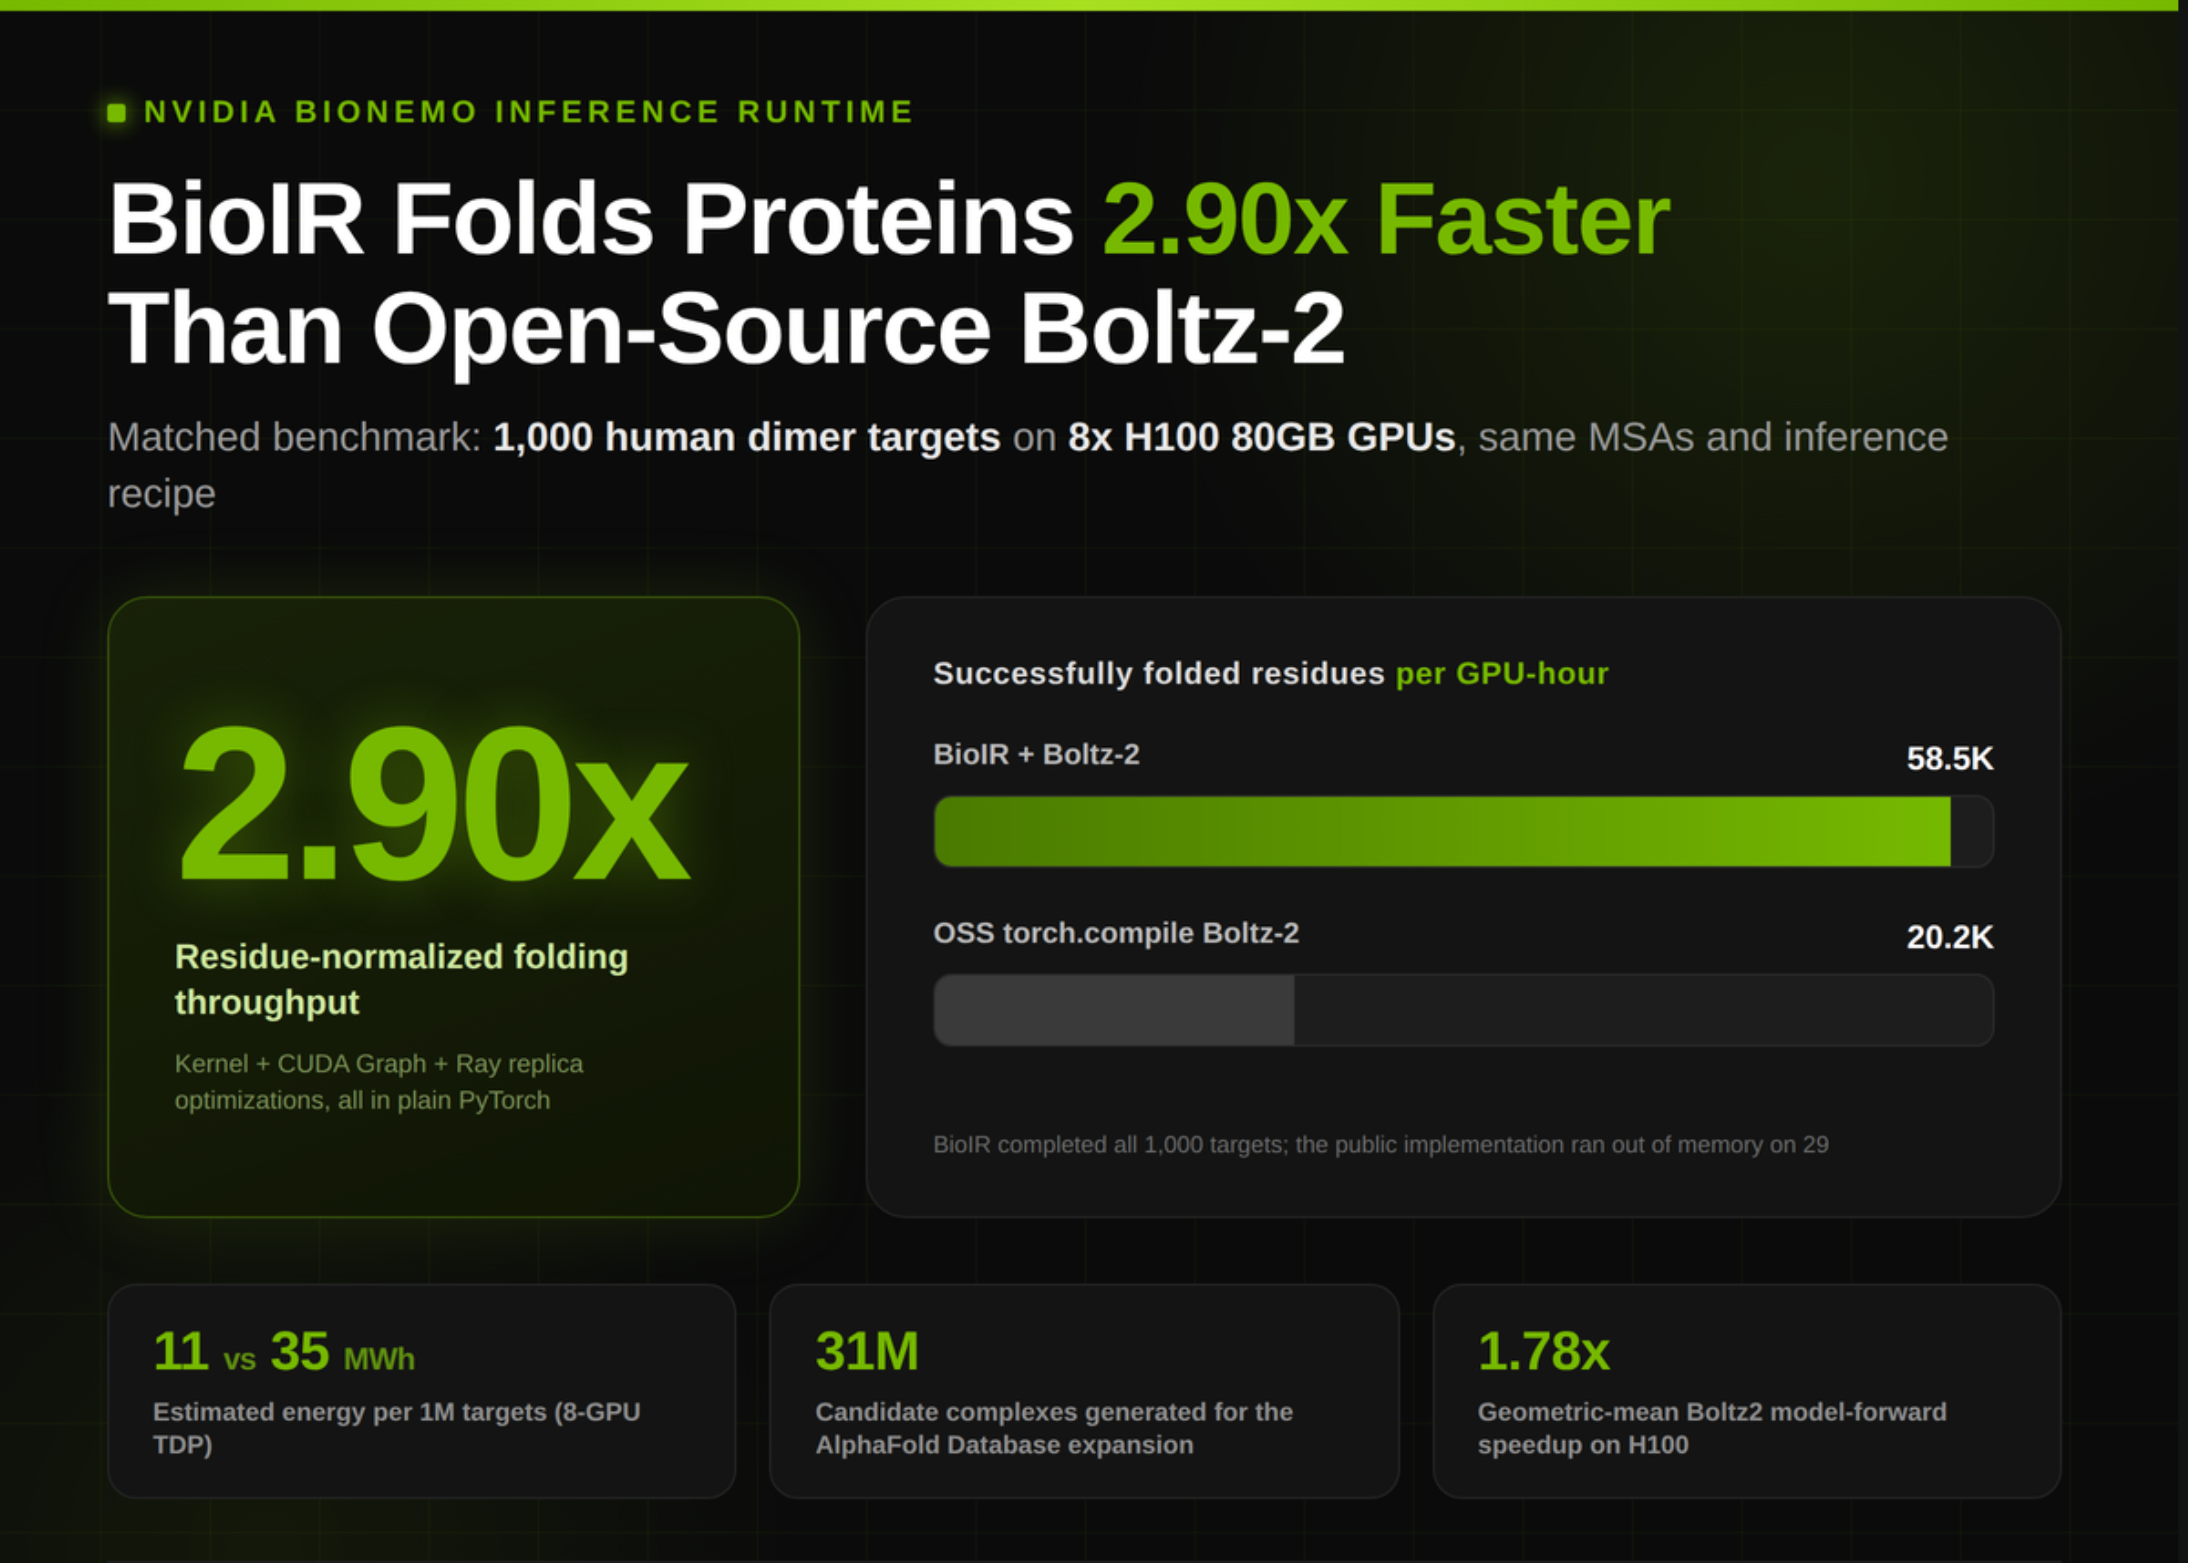
Прогнозирование трехмерной структуры белковых комплексов окончательно перешагнуло этап одиночных лабораторных расчетов и превратилось в задачу масштабной обработки целых протеомов. Сегодня главный затор в биоинформатике кроется не в том, способна ли нейросеть «свернуть» конкретный белок, а в том, насколько быстро инфраструктура прокачивает непрерывный поток данных: от парсинга последовательностей и генерации признаков до инференса на GPU и записи итоговых файлов PDB или mmCIF.
Компания NVIDIA представила подробный технический разбор библиотеки BioNeMo Inference Runtime (BioIR). Это специализированная Python-среда, призванная ускорить инференс передовых нейросетей для предсказания структуры биомолекул на графических процессорах NVIDIA, сохраняя привычную гибкость фреймворка PyTorch. Я внимательно изучил опубликованную документацию и результаты бенчмарков, чтобы разобраться, за счет чего инженерам удалось добиться ускорения свертки белковых димеров в 2,9 раза на модели Boltz-2.
Важно отметить, что BioIR уже доказал свою работоспособность в условиях реальной промышленной нагрузки. Именно этот фреймворк использовался для недавнего масштабного обновления базы данных AlphaFold Database, в рамках которого было сгенерировано свыше 31 миллиона гипотетических комплексов для 4777 протеомов (1,81 миллиона из которых вошли в релиз как структуры с высокой степенью достоверности).
Развертывание библиотеки максимально упрощено: BioIR доступен в виде готового Wheels-пакета с предварительно скомпилированными CUBIN-бинарниками в открытом репозитории GitHub. Для работы требуется среда Python 3.12+, совместимый видеоускоритель NVIDIA с актуальной версией драйвера, подготовленные веса моделей и множественные выравнивания последовательностей (MSA) в формате A3M. При этом устанавливать nvcc, исходные файлы CUDA, CMake или весь комплекс CUDA Toolkit не требуется.
Что представляет собой BioNeMo Inference Runtime (BioIR)
Специализированные биоинформатические архитектуры содержат сложнейшие вычислительные блоки, которые стандартные движки инференса общего назначения обрабатывают далеко не самым эффективным образом. BioIR фокусируется на точечной оптимизации таких компонентов, как слои Pairformer и Evoformer, операции с треугольными матрицами внимания (triangle operations), парное внимание (pairwise attention), диффузионные трансформаторы и модули атомарного уровня.
При этом нейросети остаются стандартными объектами torch.nn.Module. Разработчикам не нужно выполнять длительные процедуры экспорта, конвертации моделей или сборки специализированных движков между загрузкой весов и выполнением прямого прохода.
Архитектура библиотеки предусматривает два основных сценария использования:
- Сквозной процессор (End-to-End Processor): полностью берет на себя управление жизненным циклом запроса (
InputRequest). Он автоматически выполняет парсинг, токенизацию, генерацию признаков, запускает инференс на GPU и формирует итоговые файлы в форматах PDB или mmCIF. В эталонных примерах продемонстрирована работа с моделью Boltz-2 (model_source="boltz-2"). Для каждой белковой цепи требуется входное выравнивание A3M (поддерживаются как парные, так и непарные MSA). Поскольку встроенные инструменты вроде HHsearch или HMMsearch в библиотеку не входят, шаблоны структур передаются вручную. Процессор способен предсказывать структуры комплексов с лигандами, но не рассчитывает аффинность связывания. - Прямая интеграция с PyTorch: позволяет разработчикам конструировать поддерживаемые модели или вызывать отдельные оптимизированные модули напрямую внутри собственного кода на PyTorch.
Три уровня оптимизации вычислений
Инженеры NVIDIA заложили в BioIR трехслойную систему ускорения, решающую узкие места на разных этапах выполнения задач:
- Выбор ядер (Kernel Selection): при вызове поддерживаемых операций библиотека автоматически выбирает наиболее эффективную реализацию — кастомные ядра BioIR, оптимизированные библиотеки cuEquivariance или базовые фолбеки PyTorch. Выбор зависит от архитектуры конкретного GPU, типа данных, формы тензоров и конфигурации модели.
- Оптимизация модулей (Module Optimization): специализированный механизм
optimize()активирует захват CUDA Graph для совместимых блоков. Это полностью исключает накладные расходы на запуск ядер (launch overhead) со стороны CPU при повторных итерациях. - Масштабирование пайплайна (Pipeline Scaling): исполнитель на базе Ray разворачивает по одной полной копии модели (replica) на каждом доступном графическом ускорителе в узле и параллельно распределяет между ними независимые задачи из очереди. Процессы CPU (парсинг, подготовка фичей, запись результатов на диск) перекрываются по времени с инференсом на GPU.
Обратите внимание на важное ограничение: Ray работает в режиме репликации и распределяет отдельные задачи из очереди, но не распараллеливает один прямой проход (forward pass) одной молекулы между несколькими GPU. Контекстно-параллельная свертка гигантских белков пока находится в разработке. Формула распределения ресурсов проста: произведение этапа вычислений на количество GPU (engine_stage.compute x num_gpus) не должно превышать число физически доступных карт.
На уровне выполнения прямого прохода модели NVIDIA приводит следующие показатели геометрического среднего ускорения по сравнению с базовым torch.compile:
- OpenFold3: 1,55x на H100 и 1,54x на H200;
- Boltz-2: 1,78x на H100 и 1,75x на H200;
- OpenFold2 (мономер): 2,56x на H100 и 2,61x на H200.
Эти тесты проводились на наборе из 17 входных структур с длиной цепей от 29 до 1734 аминокислотных остатков.
Сравнительный бенчмарк: 1000 человеческих димеров на сервере с 8xH100
Чтобы измерить реальную производительность в сквозном сценарии, команда NVIDIA провела прямое сравнение BioIR-ускоренной Boltz-2 с открытой базовой реализацией Boltz-2, скомпилированной через torch.compile. Тестирование проходило на сервере с 8 видеокартами NVIDIA H100 (80 ГБ).
В качестве тестового набора использовались 1000 человеческих белковых димеров суммарной длиной до 2800 остатков. Обе системы работали с одинаковыми MSA, идентичной конфигурацией GPU и одинаковым рецептом инференса: 3 цикла рециклинга (recycles), 200 шагов сэмплирования и 5 диффузионных образцов.
Результаты бенчмарка:
- BioIR Boltz-2: успешно обработал все 1000 мишеней, продемонстрировав пропускную способность 58 500 свернутых остатков на один GPU-час.
- Открытая реализация Boltz-2: показала результат 20 200 остатков на GPU-час и аварийно завершила работу из-за нехватки видеопамяти (Out of Memory) на 29 мишенях.
В конечном счете BioIR обеспечил повышение итоговой пропускной способности в 2,90 раза при полной стабильности работы со сложными белками.
Следует подчеркнуть: данные цифры относятся строго к фазе свертки на конкретной аппаратной конфигурации и данном датасете. Они не включают время на генерацию MSA, предварительную подготовку на CPU, операции ввода-вывода и повторные попытки.
Энергоэффективность при масштабировании до миллиона молекул
При проведении суперкомпьютерных кампаний масштаба целого протеома энергопотребление становится критическим фактором затрат. Экстраполируя полученные данные на массив из 1 миллиона аналогичных белков, инженеры оценили суммарный расход энергии:
- По показателю TDP (расчетная тепловая мощность 8 GPU): BioIR требуется всего 11 МВт·ч против 35 МВт·ч у стандартного опенсорсного решения.
- По максимальной мощности всего сервера: энергопотребление составляет 21 МВт·ч у BioIR против 64 МВт·ч у базовой сборки.
Таким образом, экономия от 23 до 43 МВт·ч на каждый миллион проанализированных белковых комплексов позволяет существенно сократить операционные расходы дата-центров и нагрузки на инфраструктуру.
Итоги и ключевые выводы
Библиотека BioNeMo Inference Runtime показывает, как грамотная низкоуровневая оптимизация тензорных операций и графов вычислений позволяет выжать максимум из графических процессоров NVIDIA архитектуры Hopper:
- Поддержка моделей Boltz-2, OpenFold2 и OpenFold3 при сохранении чистого кода PyTorch.
- Прирост производительности в 2,90 раза на сервере 8xH100 (58,5 тыс. остатков против 20,2 тыс. на GPU-час).
- Полная устранимость ошибок Out-of-Memory на сложных димерах.
- Снижение энергозатрат на 1 миллион молекулярных мишеней с 35 до 11 МВт·ч.
- Готовность к продакшену, подтвержденная генерацией 31 млн структур для AlphaFold DB.
Исходный код библиотеки, подробная документация и инструменты оркестрации BioNeMo Agent Toolkit доступны в официальном репозитории NVIDIA на GitHub.
Источник: www.marktechpost.com
