
Мой блог
Обзор Redis LangCache: управляемый семантический кэш, сокращающий расходы на LLM до 90%

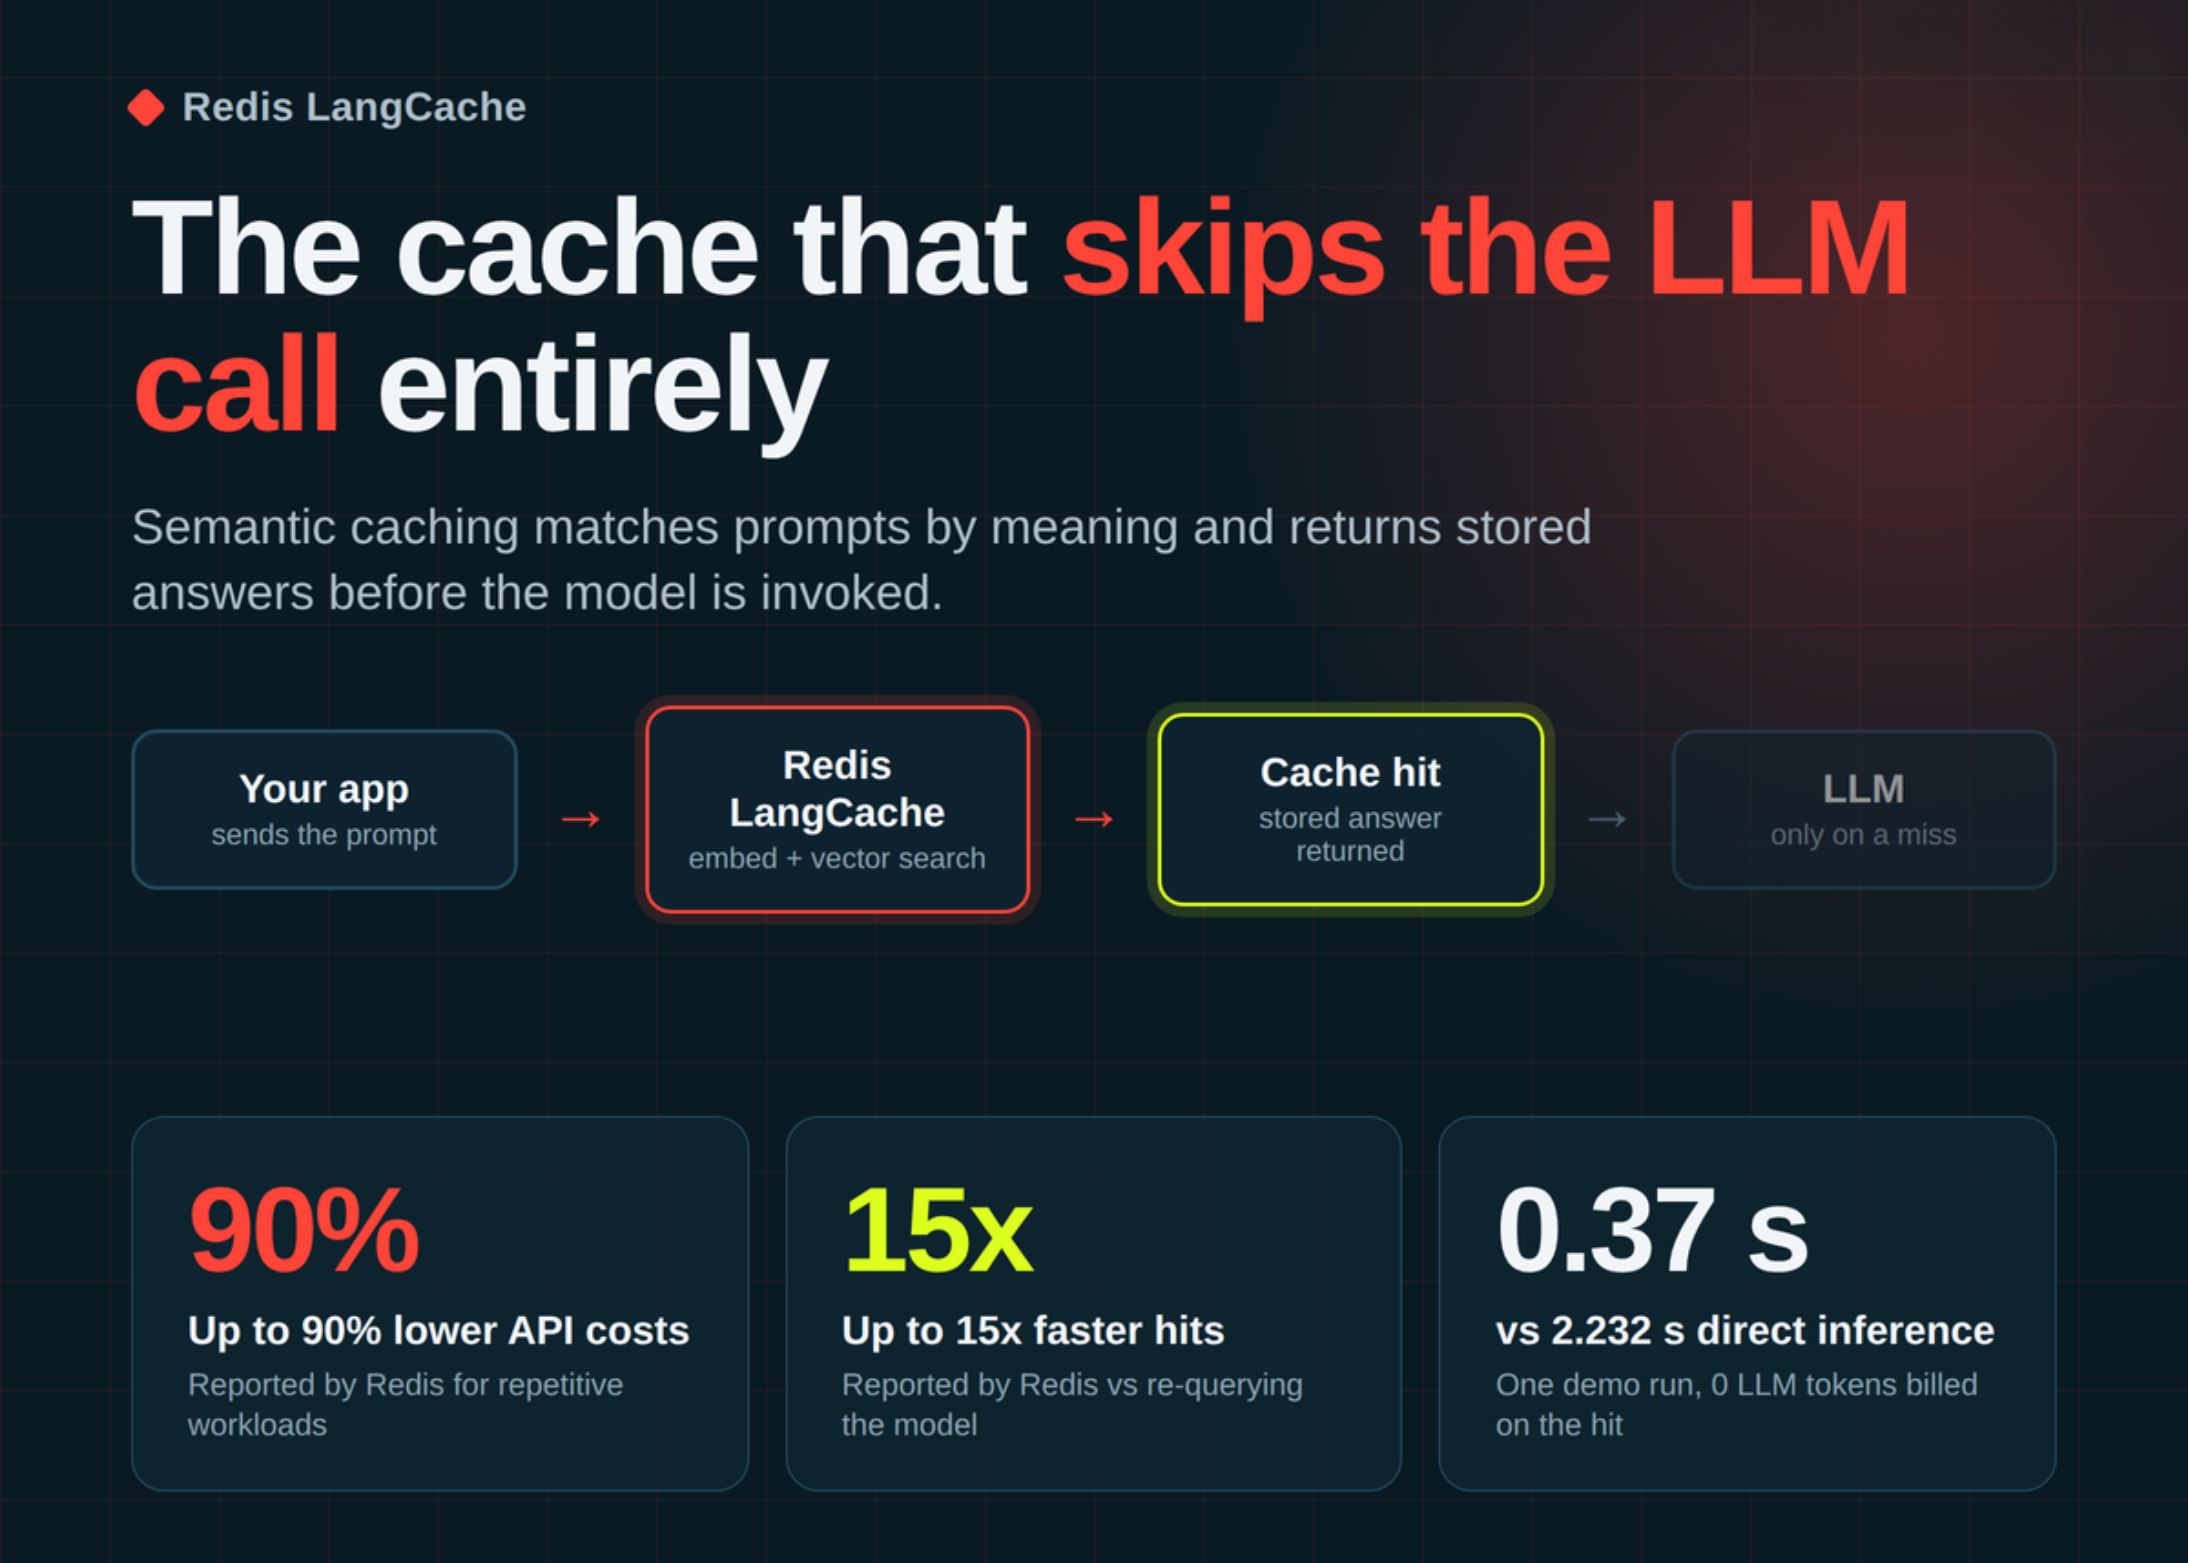
В практической разработке приложений на базе больших языковых моделей (LLM) редкие запросы оказываются абсолютно уникальными. В сервисах клиентской поддержки, диалоговых ботах и системах RAG (Retrieval-Augmented Generation) пользователи регулярно задают одни и те же по смыслу вопросы, но используют разные формулировки. Без специальной оптимизации большинство архитектур воспринимают каждый такой промпт как совершенно новый запрос, повторно отправляют его в нейросеть и оплачивают полный цикл генерации.
Компания Redis запустила решение этой проблемы — полностью управляемый сервис семантического кэширования LangCache. Он размещается между вашим приложением и моделью, анализируя входящие промпты по их смыслу, а не по буквальному совпадению текста. Если найден сохраненный ответ с достаточным уровнем смыслового сходства, LangCache отдаёт его мгновенно. По заявлению разработчиков, такой подход позволяет урезать затраты на LLM API вплоть до 90 %, а скорость выдачи ответов при попадании в кэш увеличивается до 15 раз.
Сейчас LangCache доступен в статусе публичного превью на платформе Redis Cloud. Интеграция выполняется через REST API или с помощью готовых SDK для Python и JavaScript. Поскольку проект находится в стадии публичного тестирования, Redis предупреждает о возможном изменении функций и логики работы в будущих обновлениях.
Проблема: почему перефразированные запросы сжигают бюджет LLM
Чтобы понять логику работы семантического кэша, рассмотрим три типичных обращения в службу поддержки:
- «Могу ли я вернуть деньги после покупки месячной подписки?»
- «Предусмотрен ли возврат средств за подписку на месяц?»
- «Как отменить план и забрать уплаченные деньги?»
Текстовые строки различаются, но суть вопроса и итоговый ответ абсолютно идентичны. В стандартных системах без семантического кэширования каждая из этих фраз запускает полный процесс обработка входных токенов, декодирование выходных токенов и ожидание ответа пользователем.
Существующая технология префиксного кэширования (prefix caching) решает эту проблему лишь частично. Когда запросы содержат общий системный промпт или одинаковый массивный контекст, движок нейросети повторно использует ранее вычисленные состояния ключей и значений (KV-кеш) для этого префикса. Однако сам запрос всё равно отправляется в LLM, где модель тратит ресурсы на обработку новых токенов и полное формирование текста ответа. Попадание в префиксный кэш удешевляет генерацию, но не исключает сам вызов нейросети.
Как устроена архитектура Redis LangCache
Redis LangCache выносит кэш за пределы языковой модели и сохраняет готовый сгенерированный ответ. Взаимодействие построено на цикле из двух последовательных вызовов:
- Поиск перед вызовом модели: Приложение отправляет входящий промпт на эндпоинт
POST /v1/caches/{cacheId}/entries/search. LangCache генерирует векторный эмбеддинг для этого текста и выполняет поиск по сохраненным записям. Если найденное совпадение превышает установленный порог сходства (similarity threshold), сервис сразу возвращает кэшированный ответ. Вызов LLM в этом случае не производится. - Сохранение после промаха: Если в кэше нет подходящего ответа (cache miss), приложение обращается к выбранной LLM в стандартном режиме. Полученный от нейросети результат передаётся на эндпоинт
POST /v1/caches/{cacheId}/entriesвместе с исходным промптом для сохранения и использования в будущих запросах.
Формирование эмбеддингов берут на себя внутренние алгоритмы сервиса — можно использовать базовые модели по умолчанию или подключать собственные решения. Инженеры могут гибко изменять поведение кэша: задавать пороги сходства, время жизни записей (TTL), правила вытеснения (eviction policies) и адаптивные параметры для точной настройки соотношения полноты и точности (precision/recall).
В качестве фундамента LangCache используется векторная база данных Redis. Благодаря формату REST API решение совместимо с любыми провайдерами языковых моделей и языками программирования. Отслеживать показатели попаданий в кэш и общую экономию средств можно непосредственно в консоли управления Redis Cloud.
Реальная экономия: ускорение и сокращение расхода токенов
Попадание в кэш полностью сводит к нулю затраты на входные и выходные токены, а также устраняет задержку, связанную с декодированием ответа моделью.
В ходе демонстрационного теста при сравнении обработки перефразированного вопроса были получены следующие результаты:
- Прямая генерация через LLM: заняла 2,232 секунды, потратив 514 входных и 250 выходных токенов.
- Ответ через LangCache: вернулся за 0,37 секунды при нулевом расходе входных и выходных токенов LLM (приблизительно в 6 раз быстрее).
Разработчики Redis отдельно разъясняют механику финансовой выгоды. Кэшированный ответ полностью избавляет от трат на выходные токены (output tokens). Затраты на обработку входных токенов обычно компенсируются расходами на генерацию векторных эмбеддингов и хранение данных в базу. Оценка потенциальной выгоды рассчитывается по формуле:
Оценочная месячная экономия = (Ежемесячные затраты на выходные токены) × (Доля попаданий в кэш)
Например, если общий бюджет на LLM составляет $200 в месяц, из которых 60 % ($120) уходит на выходные токены, то при 50 % попаданий в кэш удастся сберечь $60 ежемесячно. Для долгосрочных расчетов Redis предоставляет калькулятор годовой экономии.
В официальном анонсе публичного превью Redis указывает на ускорение ответов до 15 раз и сокращение расхода токенов до 70 %, а на текущей странице продукта заявлена экономия бюджета до 90 %. Практический пример использования приводит компания Mangoes.ai: в их голосовом приложении для ухода за пациентами доля попаданий в кэш достигла 70 %, что снизило затраты на LLM на 70 % и задержку ответов в 4 раза. Итоговый эффект зависит от объёма повторяющихся смысловых запросов в конкретном продукте.
Где семантический кэш требует осторожности
Определение допустимости повторного использования ответа для разных вопросов — это серьезный архитектурный нюанс, а не обычная настройка параметров. Если установить слишком низкий порог сходства, клиент, спрашивающий об обновлении функций, может случайно получить стандартный ответ о правилах возврата средств. При завышенном пороге кэш будет постоянно пропускать перефразированные запросы к LLM, потеряв финансовую целесообразность.
Для стабильной эксплуатации семантического кэша в продакшене требуются:
- Грамотная калибровка порогов сходства;
- Настройка правил устаревания (TTL) для своевременной очистки неактуальных ответов;
- Изоляция данных между клиентами или тенантами (multi-tenancy);
- Системный мониторинг некорректных совпадений.
LangCache предлагает инструменты контроля: области доступа (access scopes), кастомную фильтрацию, параметры TTL и системы вытеснения, а также панель мониторинга в Redis Cloud. Данные хранятся на серверах Redis клиента. Компания подтверждает, что не имеет доступа к информации пользователей и не применяет её для обучения сторонних моделей.
Главные выводы и ключевые тезисы
- Принципиальное отличие: Префиксный кэш удешевляет обработку входящего контекста, тогда как семантический кэш полностью исключает вызов LLM при успешном совпадении.
- Двухэтапная интеграция: Работа с LangCache строится по REST API — сначала выполняется поиск перед обращением к нейросети, затем сохранение при промахе.
- Структура экономии: Главная финансовая выгода достигается за счёт снижения расхода выходных токенов по формуле стоимость выходных токенов × hit rate.
- Производительность: В заявленных тестах Redis указывает ускорение до 15x и экономию до 90 %, а контрольные прогоны демонстрируют 6-кратный прирост скорости.
- Точность работы: Эффективная работа семантического кэша напрямую зависит от правильной настройки порогов точности, TTL и изоляции данных.
Источник: www.marktechpost.com
