
Тэг
Оптимизация AI
01.
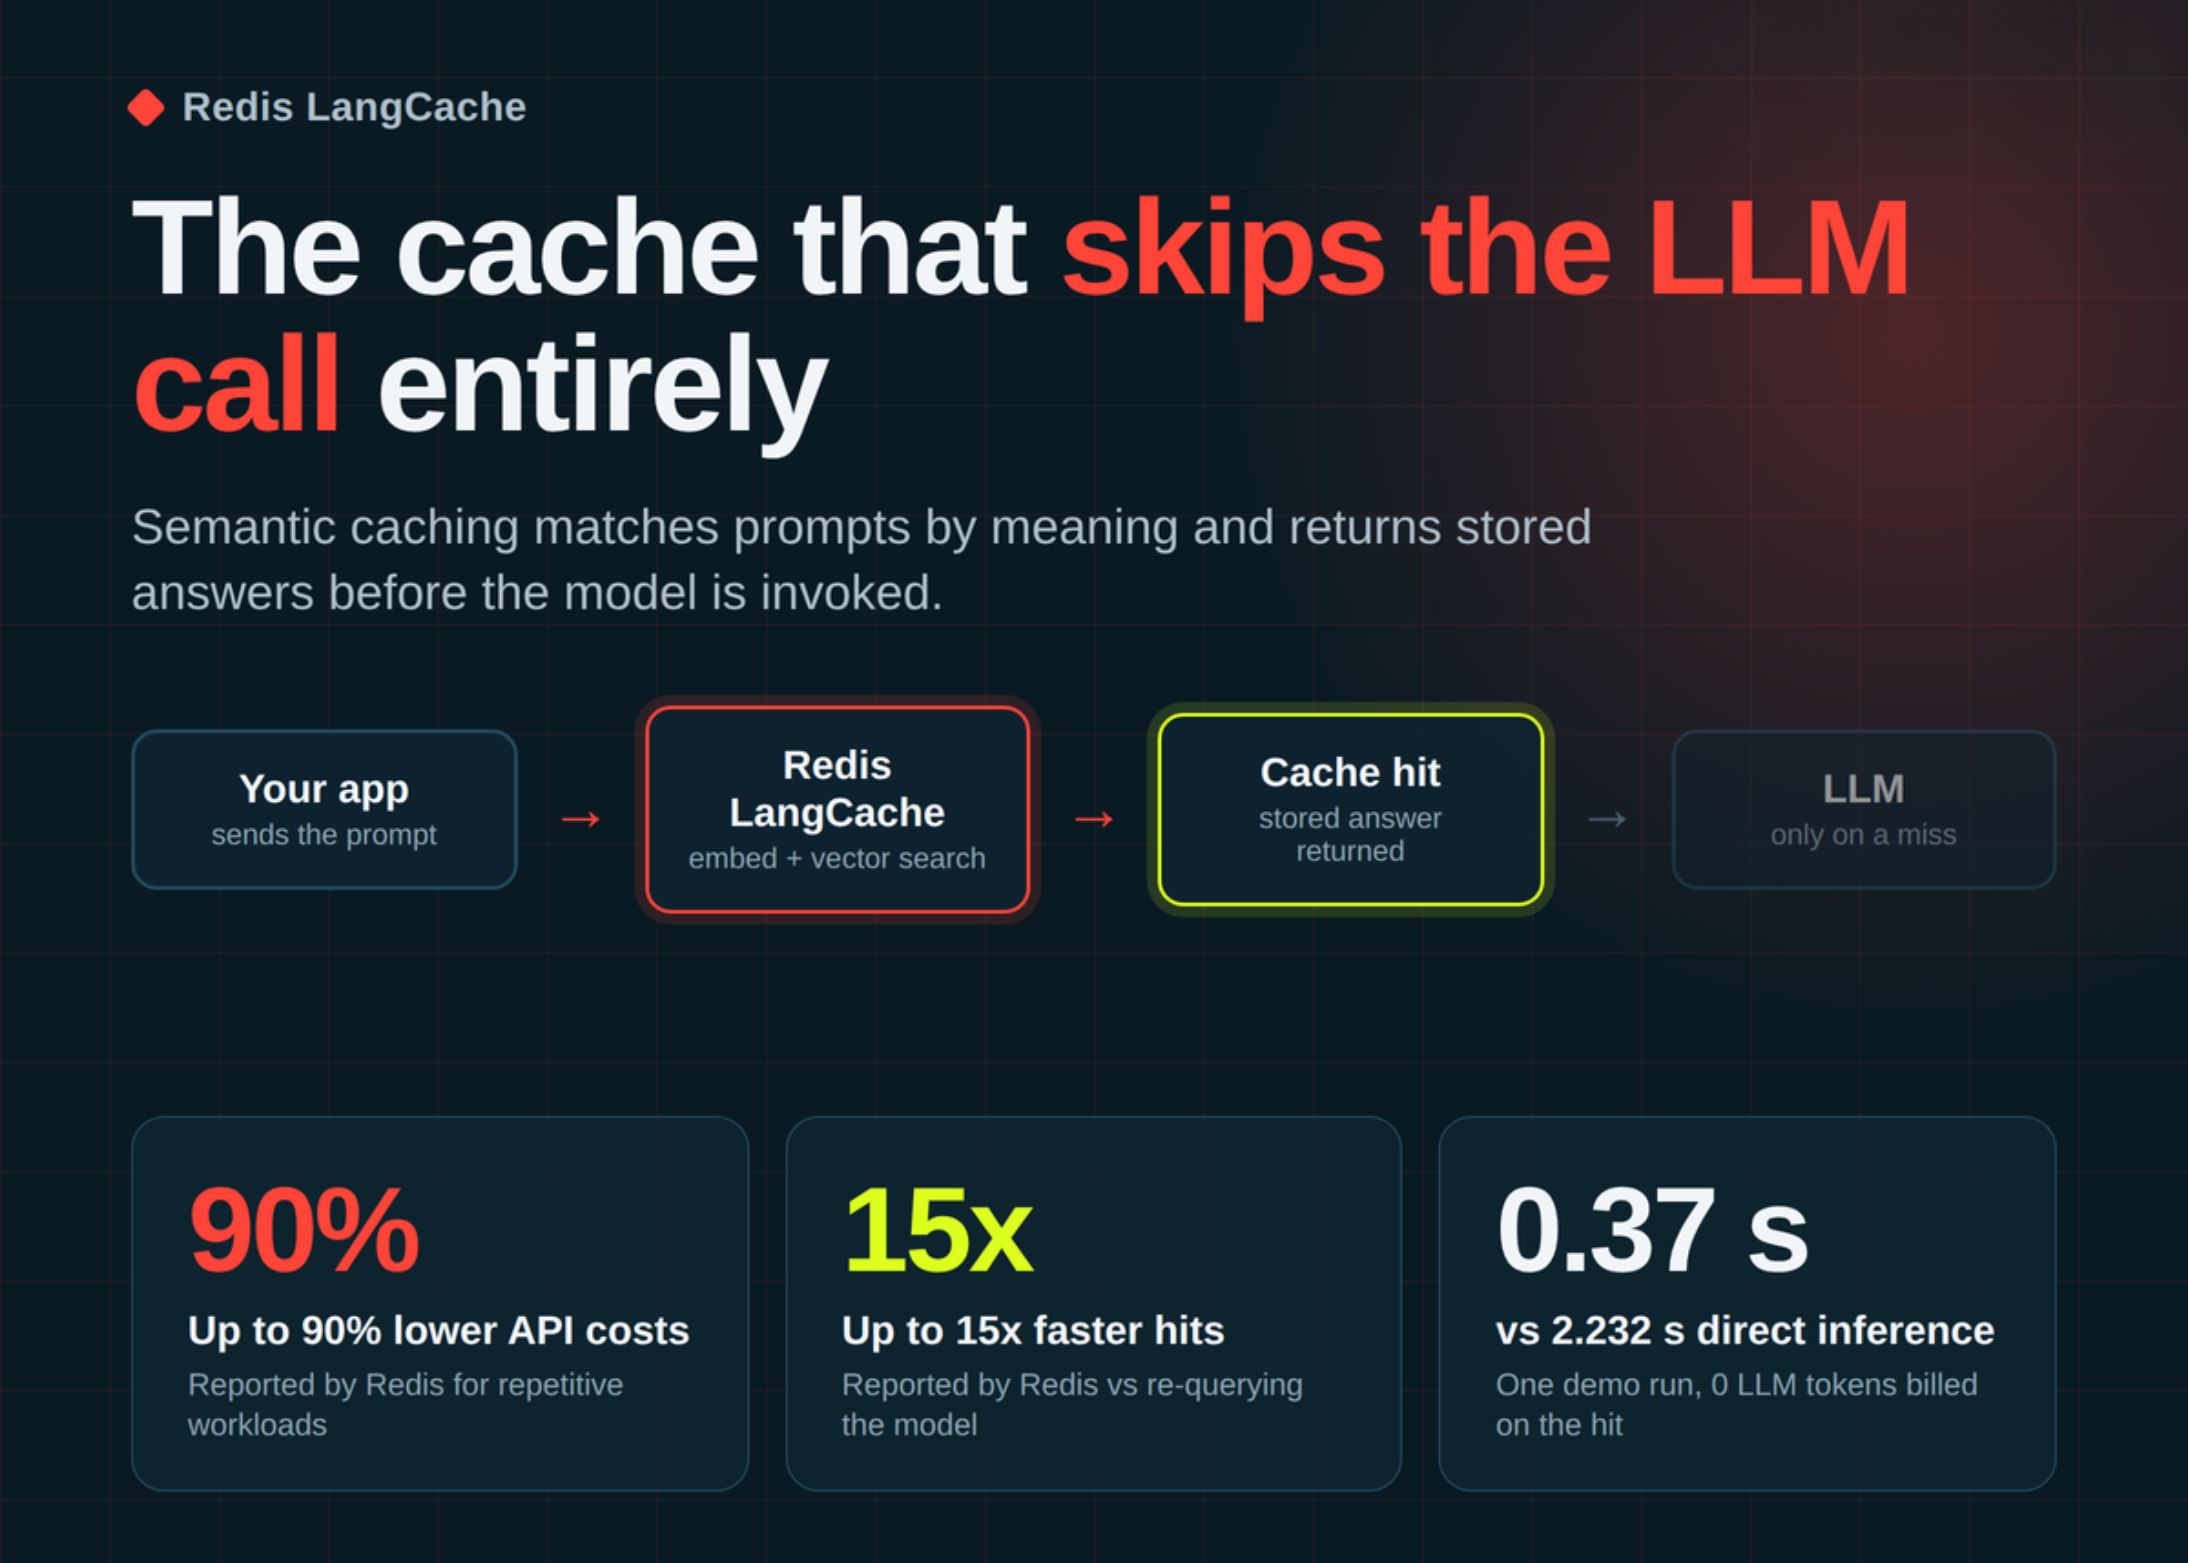
Обзор Redis LangCache: управляемый семантический кэш, сокращающий расходы на LLM до 90%
Разбор Redis LangCache — управляемого сервиса семантического кэширования для LLM, который позволяет сократить расходы на API до 90% и ускорить выдачу ответов до 15 раз.
Читать далее
02.
Токеномика и Big-T нотация: как прогнозировать и снижать расходы на LLM и ИИ-агентов
Разбираем нотацию Big-T для оценки расходов на токены в LLM и ИИ-агентах. Анализ классов сложности, тарифов Yandex AI Studio и способов оптимизации затрат.
Читать далее

01.
