
Мой блог
Насколько надежны большие языковые модели в оценке новизны научных идей

Современные исследования в области искусственного интеллекта все чаще затрагивают автоматизацию научной работы. Однако за генерацией гипотез следует сложнейшая задача: определить, действительно ли предложенное направление является инновационным, а не просто копирует уже существующие труды с помощью оценки новизны научных идей.
В рамках масштабного исследования была изучена способность больших языковых моделей оценивать оригинальность научных исследований. Разработчики представили новый бенчмарк, набор данных и код для тестирования таких судей, а также автоматизированный конвейер для создания проверочных выборок на основе реальных рецензий конференций.
Создание бенчмарка для оценки новизны
Чтобы проверить, насколько точно модели различают оригинальные и вторичные направления, исследователям потребовалась надежная база примеров. Вместо того чтобы полагаться исключительно на факт принятия или отклонения научных работ, авторы проанализировали тексты рецензий ICLR 2026 года, выделив фрагменты, где эксперты явно обсуждали оригинальность вклада.
Для формирования пула высокой новизны были отобраны принятые статьи из топ-10% своей области, чью уникальность рецензенты подтвердили без споров. Противоположный пул составили отклоненные работы, у которых эксперты нашли проблемы с оригинальностью. Совокупность этих данных образовала набор «Human-Only».
Тестирование на человеческих и сгенерированных идеях
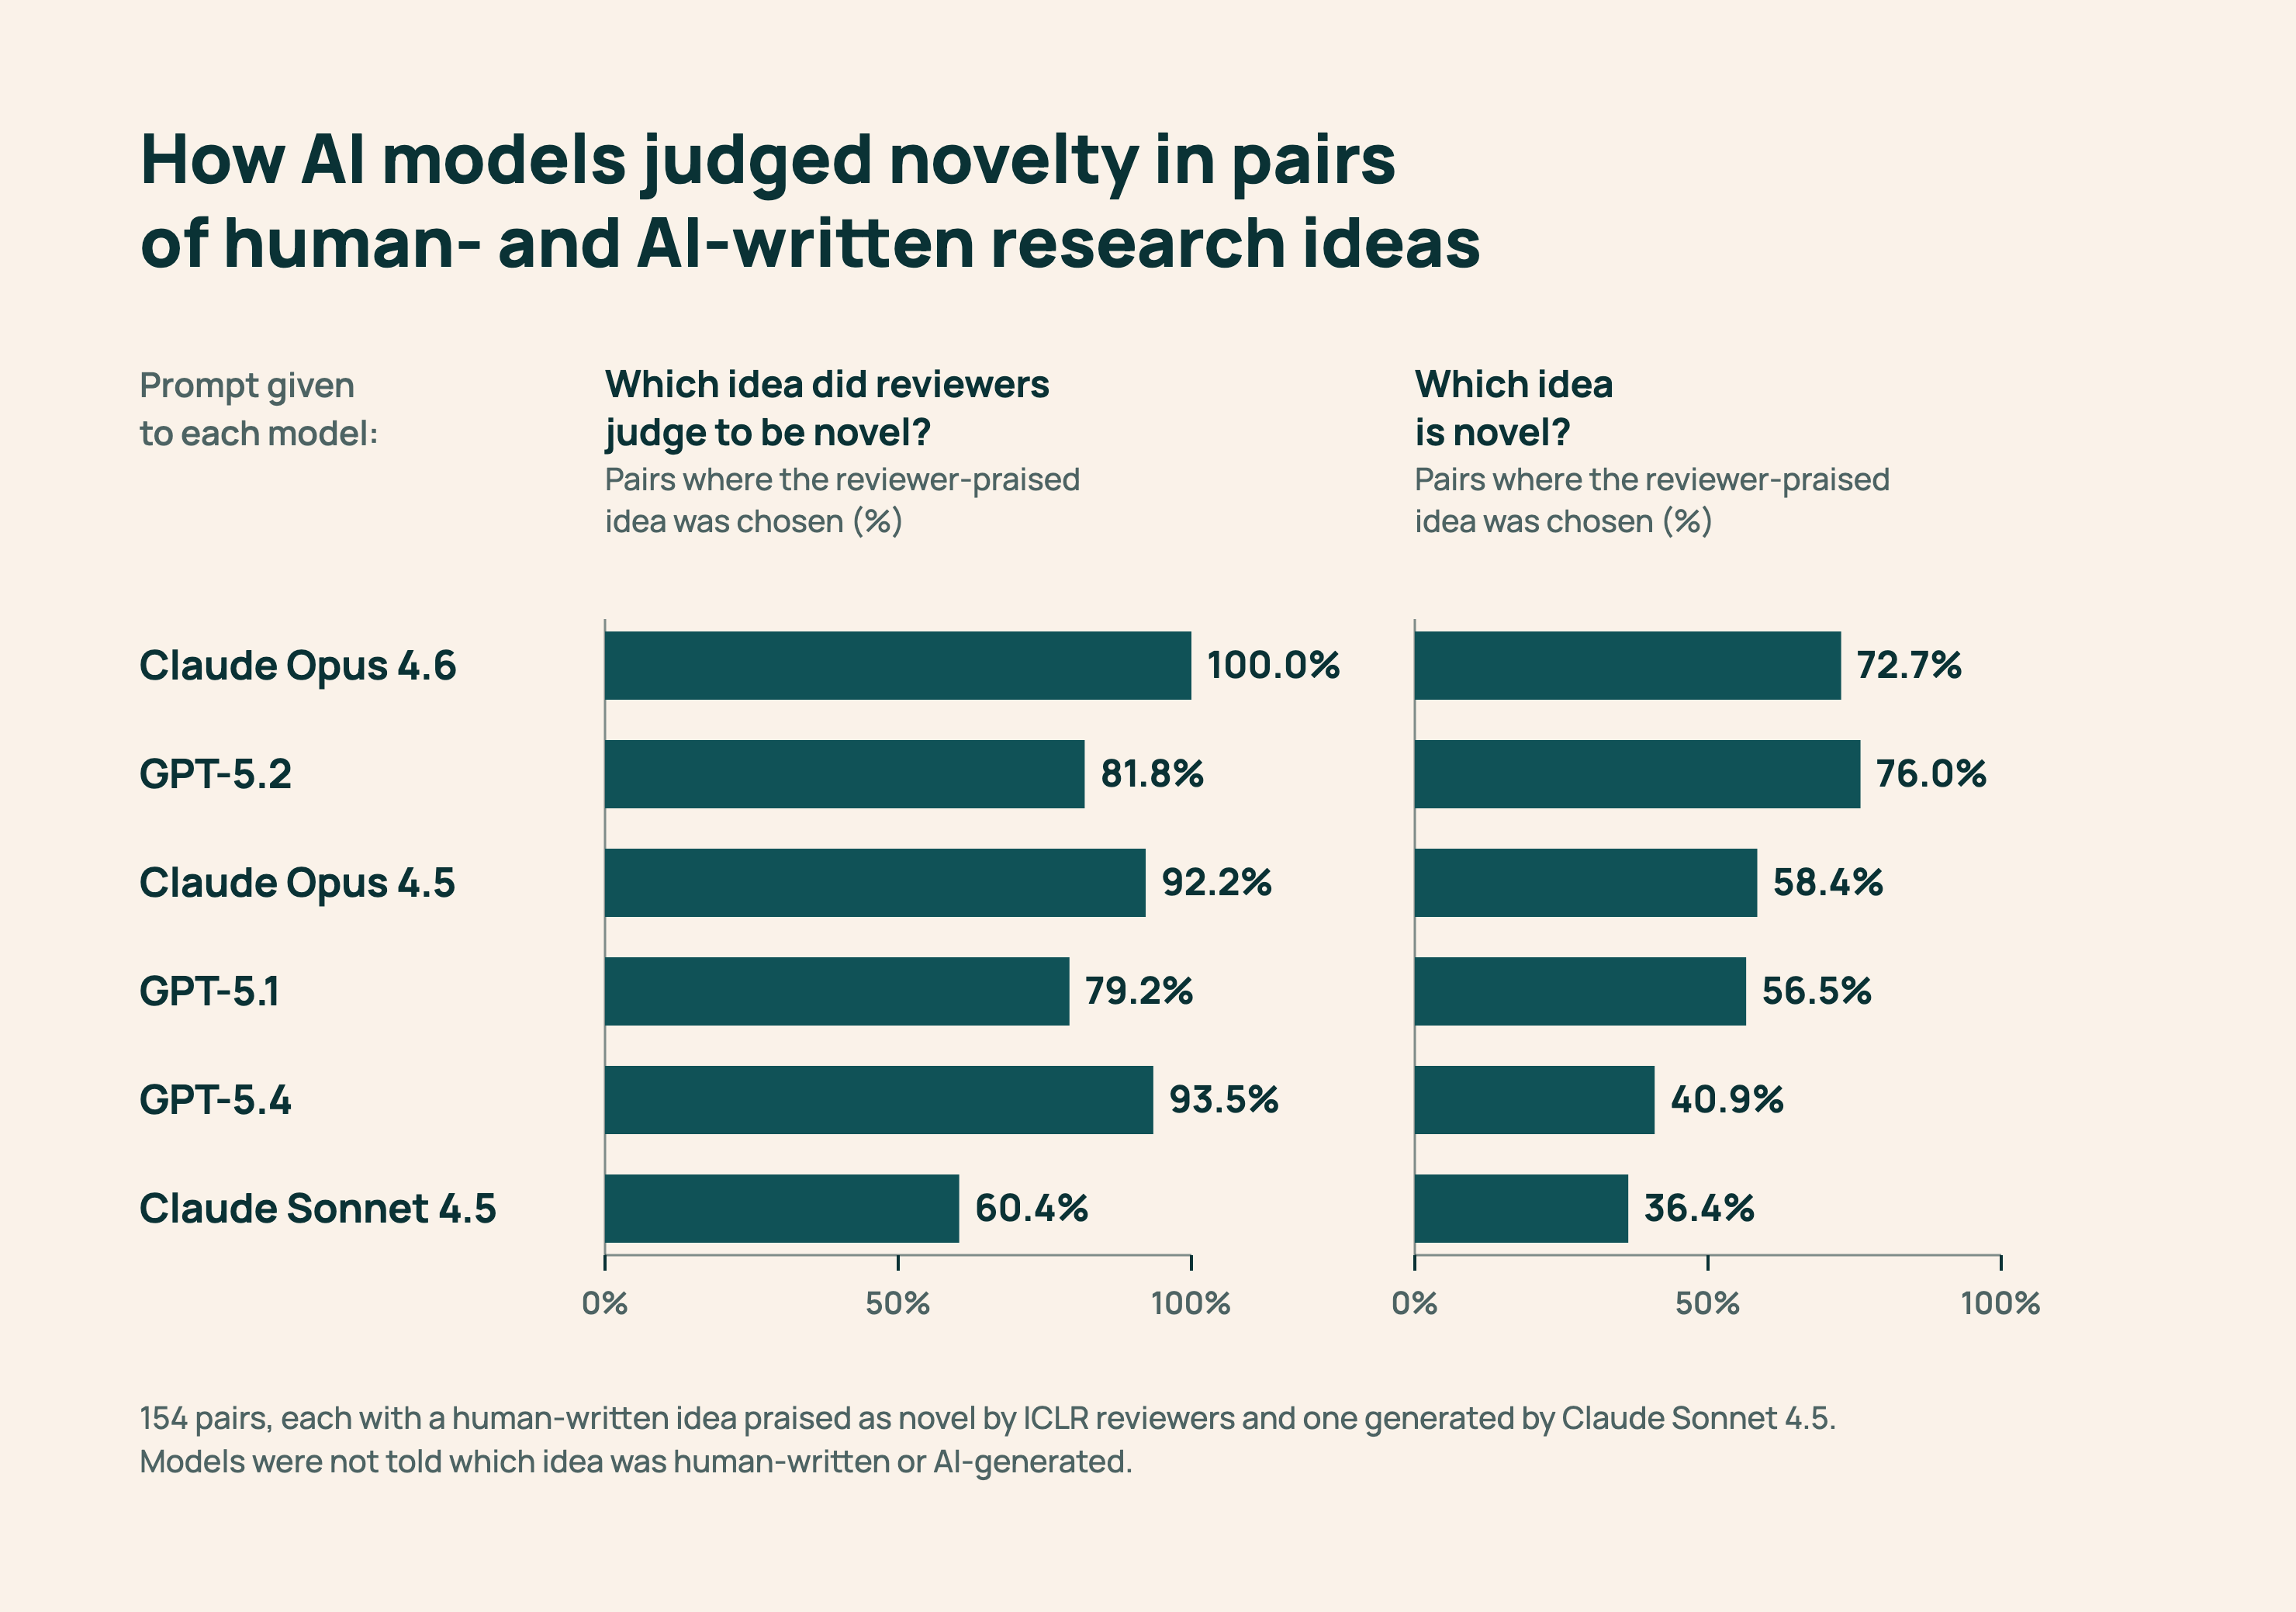
Поскольку ИИ-системы все чаще применяются для проверки сгенерированных текстов, исследователи создали второй набор данных — «Human+Generated». В него вошли 154 проверенные человеческие идеи в паре с 154 концептами, созданными базовым генератором без доступа к поиску литературы. Экспертная проверка подтвердила, что сгенерированные варианты уступают по уровню оригинальности.
Для контроля качества эксперты независимо оценили часть пар, а также переписали идеи в единую структуру, чтобы исключить влияние особенностей стиля изложения. Многие ключевые выводы работы при этом не зависят от жесткости разметки: нестабильность вердиктов сама по себе указывает на уязвимость методов.
Небольшие изменения в настройках меняют результаты
Испытания шести популярных языковых моделей (различных версий серий GPT и Claude) показали, что модели крайне чувствительны к деталям настройки. Оценка проводилась как в абсолютных баллах, так и в парном сравнении идей.
Наибольшие колебания точности вызвали формулировки промптов. Например, изменение вводной инструкции для GPT-5.4 привело к тому, что точность определения более новой идеи упала с 93,5% до 40,9%, а модель изменила свое мнение более чем для половины пар. На человеческих данных разброс оказался менее резким, но все равно заметным.
Влияние вычислительных ресурсов и поисковых агентов
Дополнительные затраты на вычисления и углубленный поиск не гарантировали рост качества. Агент с расширенным бюджетом рассуждений и живым поиском по arXiv показал результаты хуже, чем простые базовые конфигурации, при этом оказавшись значительно дороже в исполнении. Специализированные конвейеры реранкинга также уступили по точности простым подсказкам для моделей.
Перспективы надежной оценки научных исследований
Полученные данные демонстрируют, что автоматическая оценка оригинальности остается сложной нерешенной задачей. Судьи, стабильно работающие с человеческими текстами, могут вести себя иначе на материалах, сгенерированных нейросетями.
Дальнейшие исследования должны быть направлены на создание развивающихся бенчмарков, улучшение интеграции предшествующей литературы и тестирование алгоритмов на тех типах задач, с которыми они сталкиваются на практике.
