
Мой блог
Что такое отравление данных в ИИ: как злоумышленники компрометируют модели и наборы данных

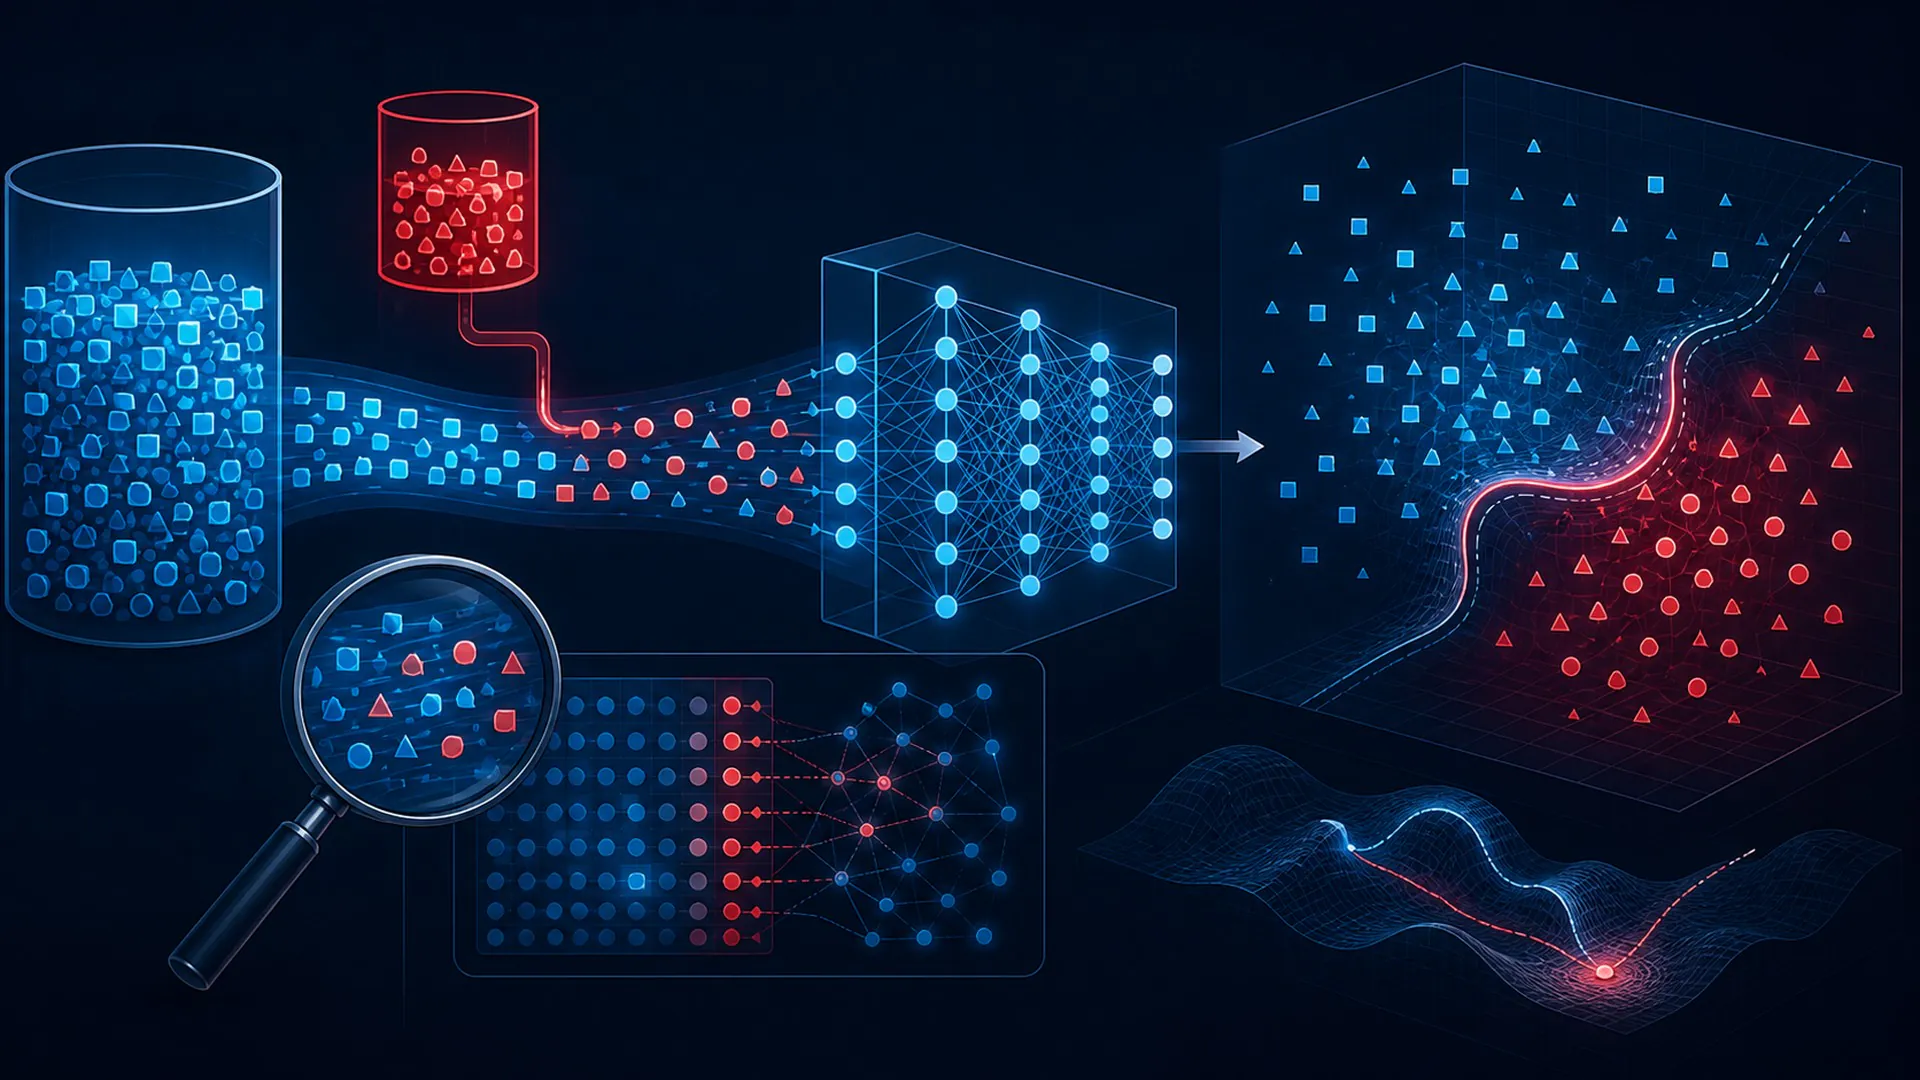
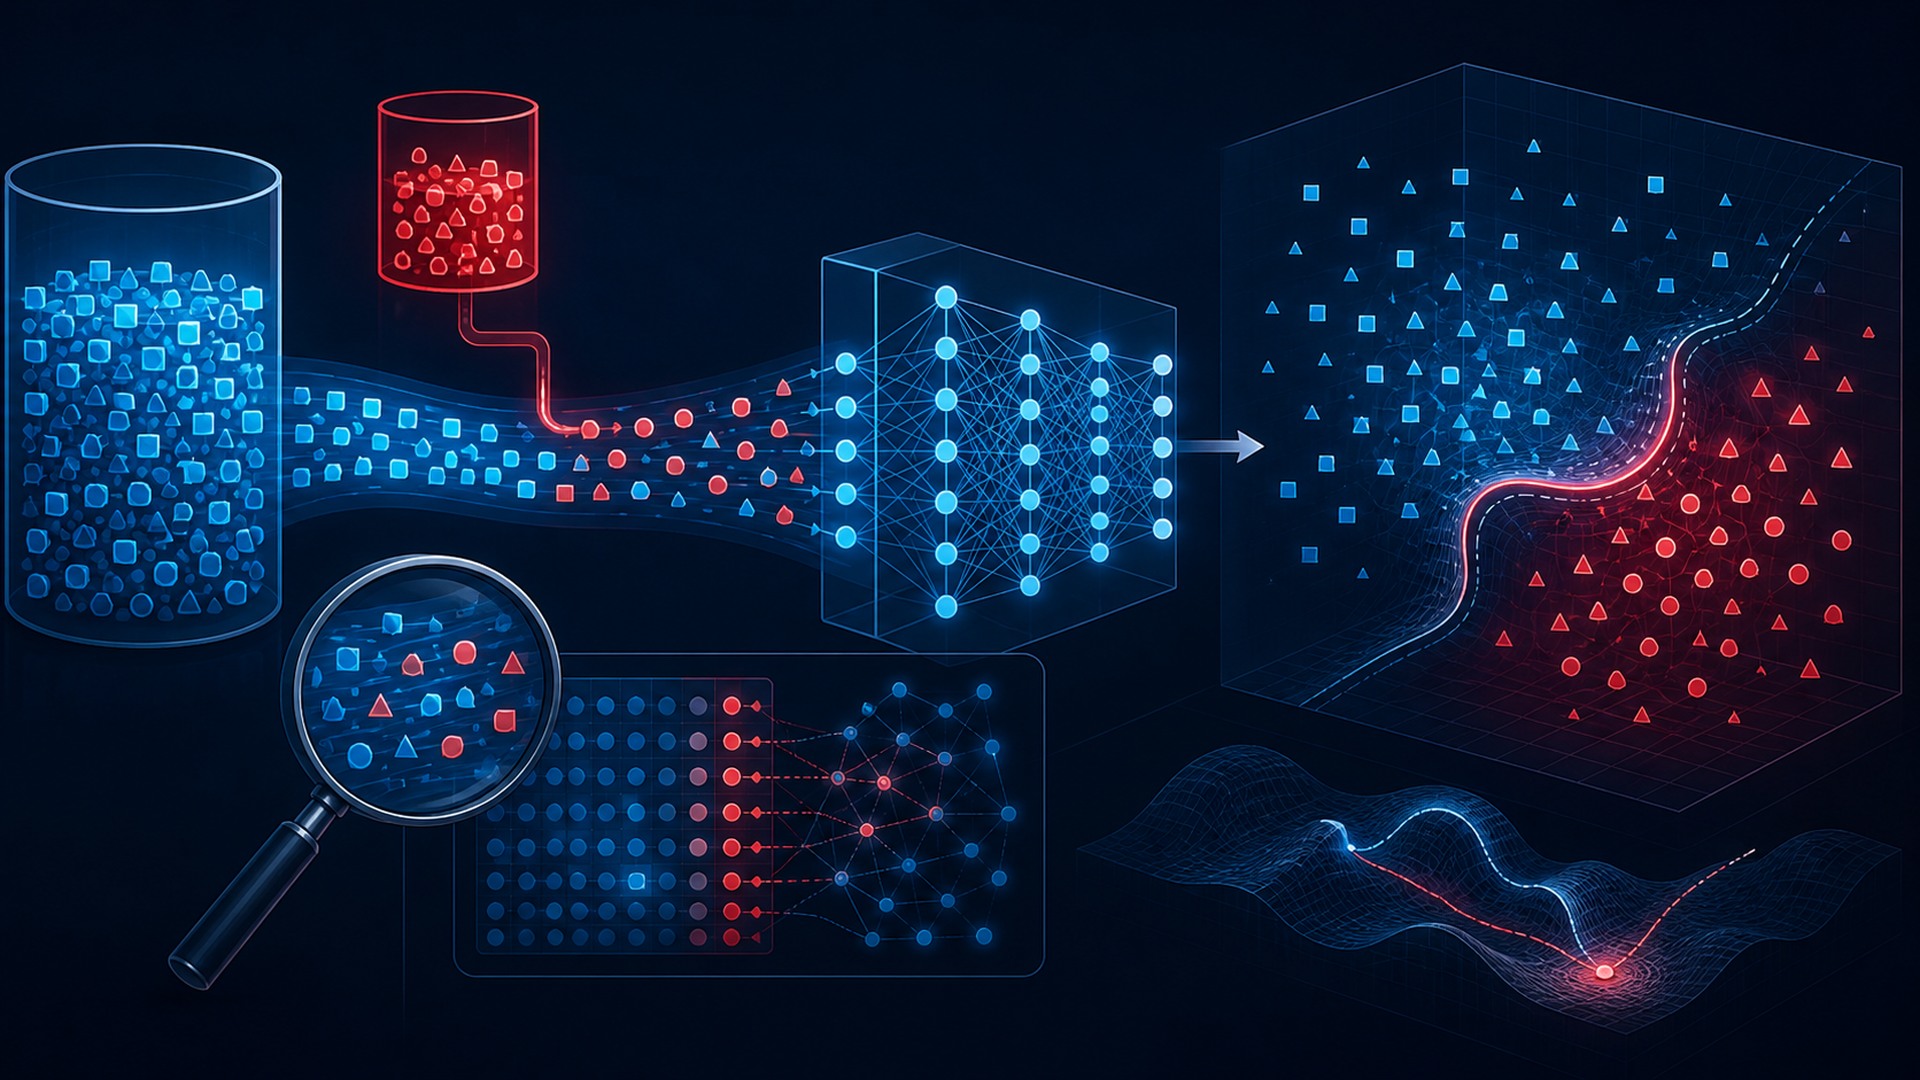
Под отравлением данных в ИИ (data poisoning) понимается намеренное изменение обучающих, дообучающих, оценочных или поисковых массивов информации с целью заставить систему искусственного интеллекта усвоить искаженную логику поведения или выдавать заданные злоумышленником результаты. Понимание этого механизма критически важно для обеспечения безопасности современных цифровых технологий.
В данном материале рассматриваются базовые принципы работы таких угроз, границы применимости термина, структура операционных этапов, а также практические методы оценки и предотвращения подобных рисков в реальных инфраструктурах.
Определение, границы и назначение отравления данных
Корректное описание рассматриваемого явления требует четкого понимания информационной логики, параметров обучения и архитектурных границ. Попытки представить его в качестве синонима общего термина «продвинутый ИИ» лишают любые заявления возможности эмпирической проверки. Концепция опирается на три практических требования: наличие идентифицируемого источника информации, характерное преобразование или решение, а также измеримый результат, который можно сопоставить с первоначальной целью.
Надежность систем искусственного интеллекта подтверждается доказательствами на всех этапах жизненного цикла. Контрольный механизм имеет смысл только тогда, когда четко определены его владелец, зона охвата, триггер срабатывания, ожидаемое поведение и методика верификации. На практике производительность может зависеть от сопутствующих баз, интерфейсов, аппаратного обеспечения и персонала даже в тех случаях, когда базовая модель остается неизменной. Поэтому важно разграничивать выученное поведение алгоритма и программный продукт, который управляет применением этих данных.
Наиболее частым заблуждением является путаница с атакой уклонения (evasion attack), которая применяется уже после развертывания модели. Хотя внешне такие инциденты могут быть похожи, они кардинально различаются по причинно-следственной связи: для них требуются разные ресурсы, иные доказательства успешности и совершенно другие защитные меры.
Пятиэтапная операционная карта отравления данных
Процесс модификации информации можно представить в виде компактной последовательности из пяти взаимосвязанных операций. Данная схема не означает, что любое вредоносное воздействие обязательно реализуется через пять обособленных программных модулей — некоторые архитектуры объединяют или циклически повторяют шаги. Тем не менее карта полезна тем, что требует фиксировать владельца, входные и выходные данные для каждого изменения.
1. Получение влияния на источник данных
На начальном этапе система должна обрести возможность влиять на информационный массив. Ключевой вопрос заключается не просто в самом факте такого вмешательства, а в том, какие сведения оно задействует, какое состояние изменяет и какие факты подтверждают легитимность изменений. Эксперты должны уметь отличать эту процедуру от постинтеграционных атак уклонения.
Переход к следующему шагу фиксирует исходную задачу и подготавливает почву для внедрения размеченных с отклонениями примеров. На этом этапе фиксируются неопределенности, отклоненные альтернативы и задействованные программные или человеческие элементы контроля.
2. Внедрение размеченных с искажениями или триггерных примеров
На втором этапе происходит интеграция предвзятых, ошибочно промаркированных или содержащих скрытые триггеры элементов. Анализ этого процесса помогает понять, какая информация потребляется и каким образом трансформируется исходная среда для обхода стандартных проверок.
Специалисты фиксируют затраты ресурсов и параметры контроля на границах подсистем, чтобы своевременно выявлять потенциальные аномалии до того, как они достигнут критических компонентов.
3. Преодоление фильтрации и дедупликации
Внедренные элементы должны успешно пройти этап очистки, фильтрации и удаления дубликатов. На данном этапе проверяется устойчивость вредоносных данных к стандартным процедурам предобработки, используемым разработчиками для очистки массивов.
Успешное прохождение фильтров позволяет искажениям напрямую влиять на процесс обучения модели или формирование контекста при поисковой выдаче (RAG).
4. Изменение обучаемой модели или извлекаемого контекста
Четвертый этап затрагивает непосредственное обновление весов модели либо внедрение искажений в базу знаний, используемую для генерации ответов. Здесь устанавливаются строгие границы верификации для оценки того, как именно изменилось внутреннее представление информации.
Результатом этого шага становится подготовка условий для активации скрытого бэкдора или широкого снижения точности работы системы при определенных условиях.
5. Активация деградации или целевого бэкдора
Завершающий этап приводит к срабатыванию заложенных аномалий: либо в виде масштабного ухудшения качества работы сервиса, либо в виде узкоспециализированной уязвимости, реагирующей на скрытые триггеры.
Анализ карты в обратном направлении позволяет диагностировать причины сбоев. Если система выдает некорректный результат, ретроспективный анализ помогает найти уязвимое звено на ранних этапах подготовки информации.
Практический пример и анализ предположений
В качестве иллюстрации рассматривается ситуация, когда злоумышленники внедряют в обучающую выборку примеры, обучающие классификатор воспринимать редкий визуальный паттерн как доверенную метку. Такой сценарий позволяет связать угрозу с наблюдаемыми входами, промежуточными состояниями и конечным итогом.
Строгое тестирование требует создания наборов обычных, сложных и намеренно вводящих в заблуждение кейсов. Изменение хотя бы одного базового допущения — например, ограничение вычислительных ресурсов, удаление обязательного входного параметра или изменение целевой аудитории — позволяет проверить устойчивость защитных механизмов.
Сравнение с наиболее частым операционным сокращением
На практике рассматриваемую угрозу нередко ошибочно сводят исключительно к атакам уклонения на развернутую модель. Такое упрощение стирает критически важную границу, что может приводить к некорректному сравнению программных продуктов и неправильной интерпретации результатов исследований.
Разница заключается в том, что отравление затрагивает этапы формирования данных и ядро обучающей трансформации, в то время как простые атаки уклонения оперируют готовой системой без изменения ее глубинной структуры. Анализ должен учитывать весь стек компонентов: от маршрутизации и кеширования до пользовательских интерфейсов и политик безопасности.
Актуальность проблемы для современных систем искусственного интеллекта
Проблема приобретает особую остроту из-за того, что современные ИИ-архитектуры задействуют расширенные контексты, мультимодальные данные, значительные вычислительные мощности и глубоко интегрируются в бизнес-процессы организаций. В таких условиях уязвимости, которые ранее считались лишь теоретическими деталями исследований, напрямую влияют на безопасность, задержки отклика и правовую ответственность.
Оценивать эффективность систем следует не по единичным впечатляющим демонстрациям, а по устойчивости результатов в репрезентативных условиях. Важно отслеживать распределение ошибок, задержки в хвосте распределения (tail latency) и воздействие на различные подгруппы пользователей.
Потенциальные преимущества контролируемого применения
В контексте академических исследований и тестирования безопасности аналогичные методы могут применяться для оценки прочности моделей. В зависимости от реализации это позволяет улучшить обоснованность ответов (grounding), повысить точность представлений, добиться лучшей генерализации или выстроить более надежные границы между предложениями модели и реальными действиями системы.
Положительные эффекты должны выражаться через измеримые метрики: уровень ошибок на сложных кейсах, скорость восстановления после поступления противоречивых данных или процент запросов, удерживаемых в рамках заданных лимитов полномочий.
Ключевые режимы отказов и методы контроля
Главным ограничением остается сложность обнаружения миниатюрных целевых подмножеств данных на фоне веб-масштабных массивов. Эта проблема должна учитываться на всех стадиях — от сбора информации до развертывания системы мониторинга.
Защитные механизмы должны срабатывать до того, как наступят необратимые последствия. Для этого определяются ранние предвестники сбоев, устанавливаются пороговые значения правил, назначаются ответственные лица и тестируются сценарии восстановления, включая откат моделей или экстренную остановку операций.
План оценки защищенности
Процедура валидации устойчивости к подобным угрозам включает несколько обязательных шагов:
- Формулирование решений, которые должны подтверждаться собранными доказательствами.
- Использование независимых тестовых наборов в контролируемой среде перед переходом к продакшену.
- Версионирование всех компонентов пайплайна: исходных данных, токенизаторов, весов моделей, конфигураций и аппаратных допущений.
- Определение критериев фальсификации гипотез для предотвращения превращения оценки в маркетинговый инструмент.
- Регулярный аудит процессов с привлечением профильных экспертов по безопасности.
Вопросы перед внедрением и первоисточники
Перед развертыванием критически важных ИИ-систем инженерам следует проанализировать исходные цели, используемые механизмы трансформации данных, качество базовых альтернатив, а также возможные операционные издержки и сценарии восстановления.
Авторитетными отправными точками для изучения стандартов безопасности в этой сфере выступают профильные руководства NIST (например, AI Risk Management Framework и Privacy Framework), а также спецификации C2PA, которые следует изучать в сочетании с технической документацией конкретных моделей и используемого аппаратного обеспечения.
