
Мой блог
Как устроена инфраструктура эмбеддингов Perplexity: разбор архитектуры Ivy, Tulip и ROSE

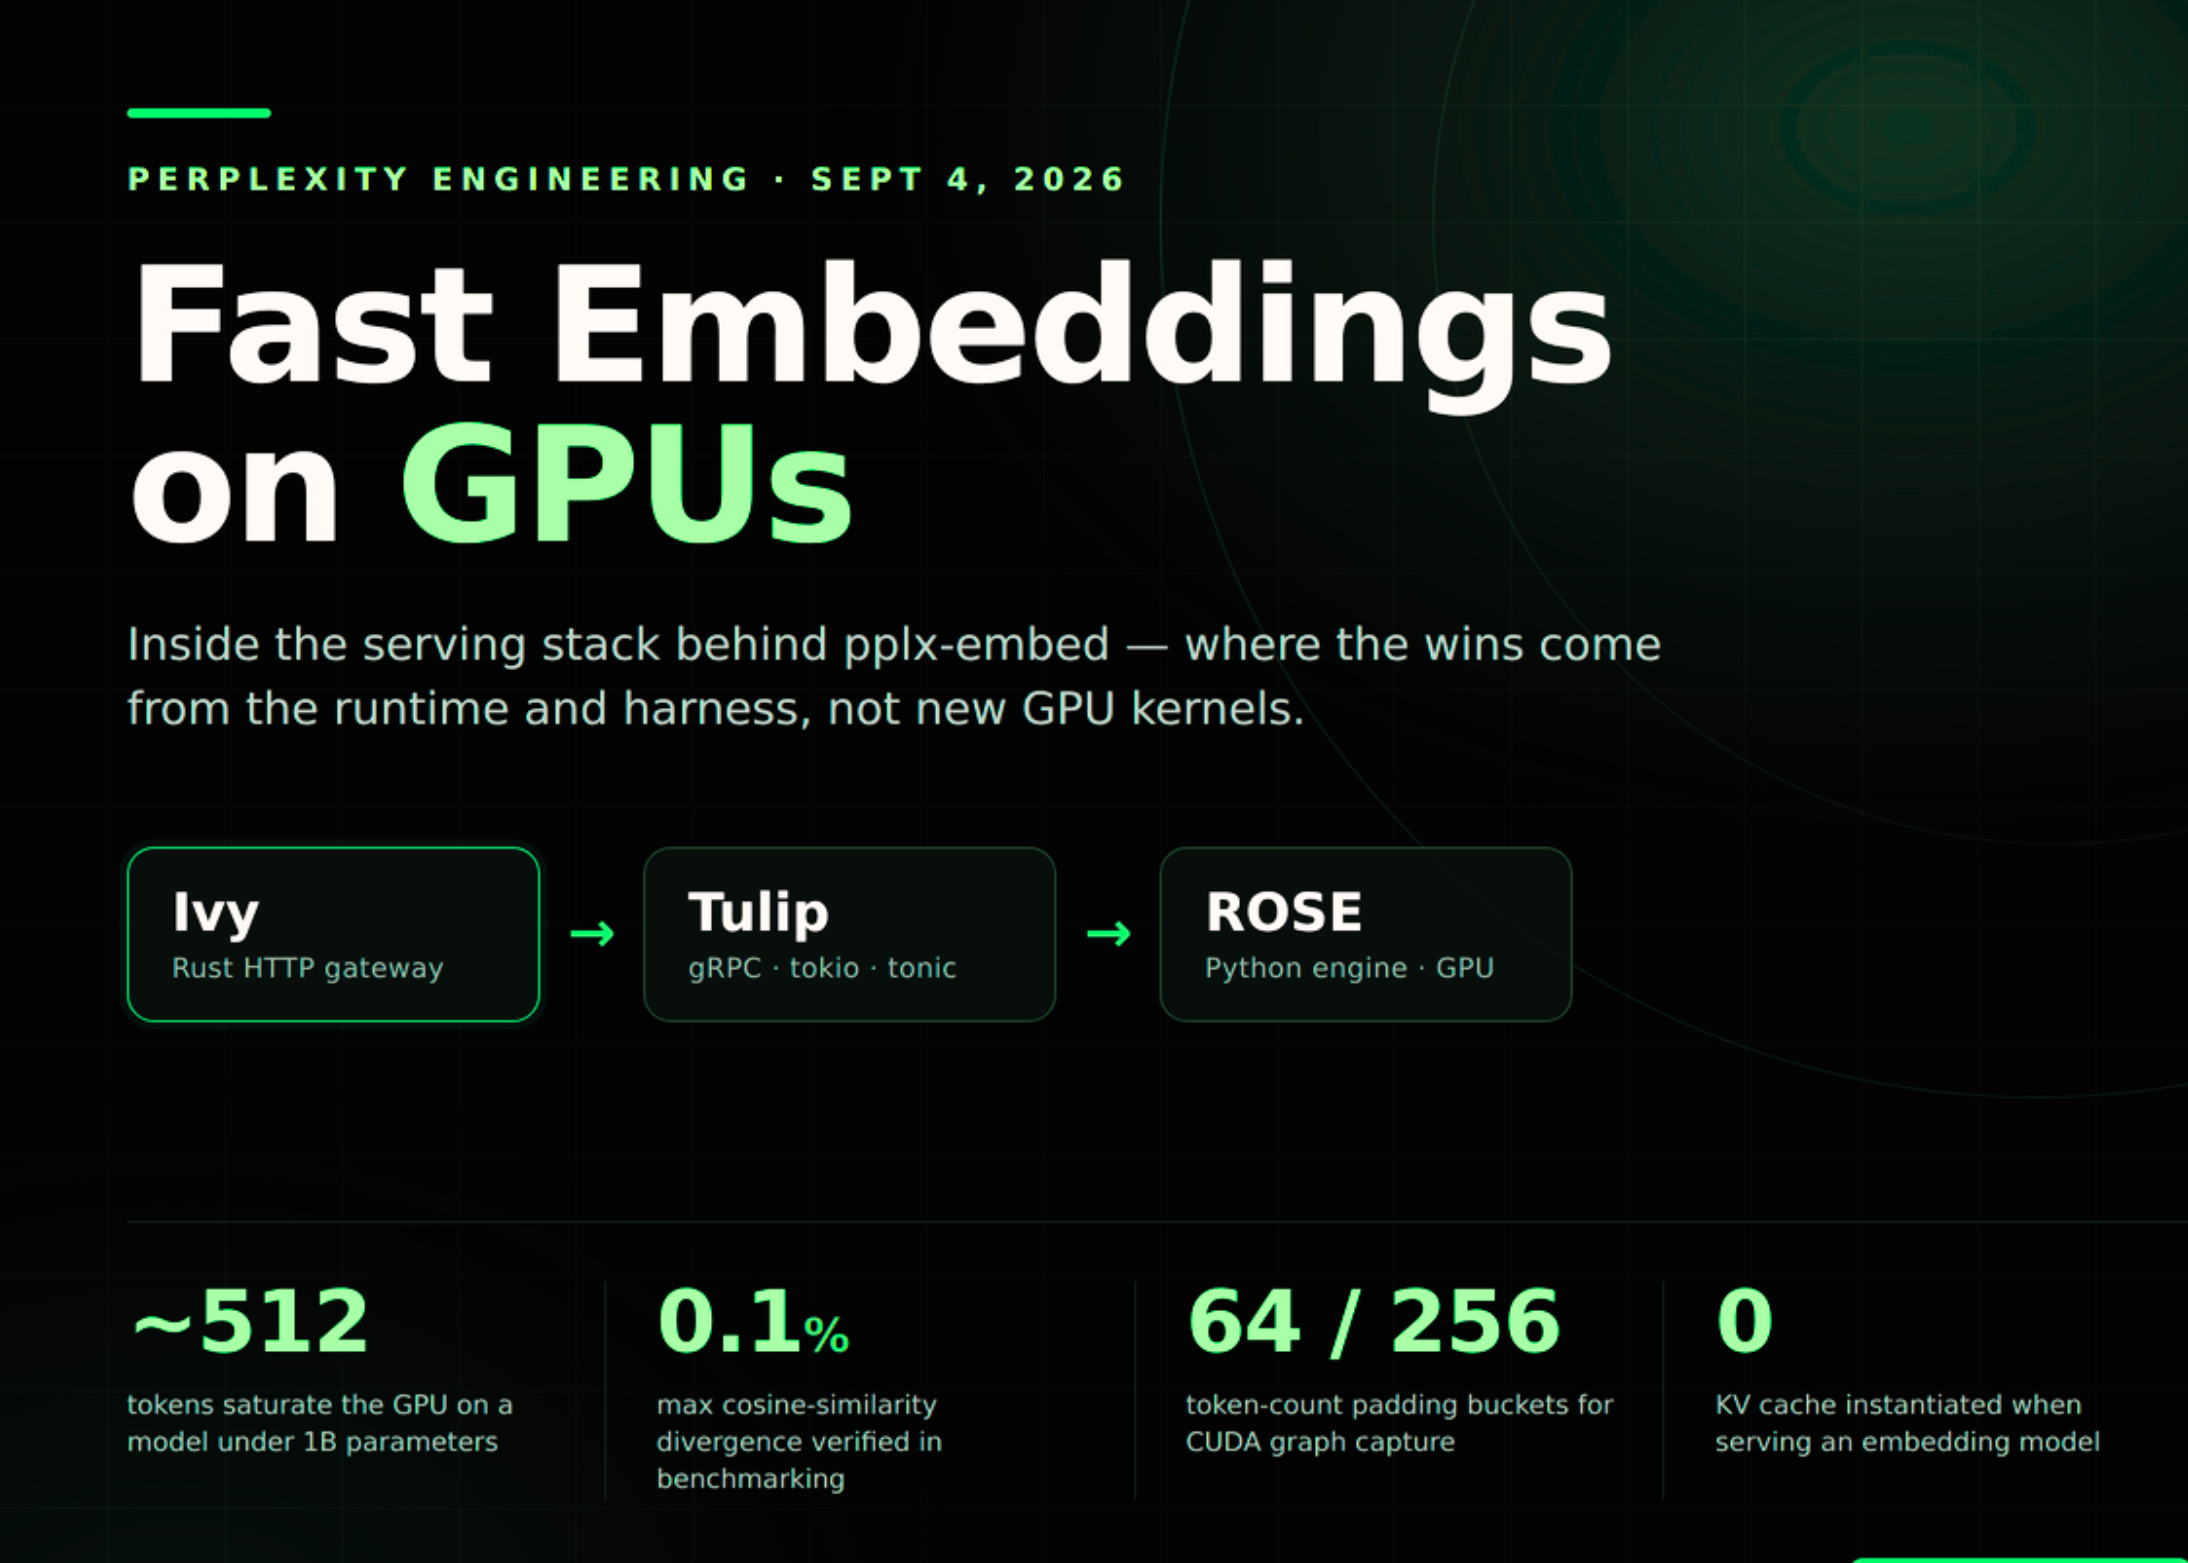
Зачем Perplexity потребовался собственный стек эмбеддингов
В современных AI-поисковиках и рекомендательных сервисах качество работы напрямую упирается в два ключевых параметра: насколько точна используемая модель векторных представлений (эмбеддингов) и насколько дешево её можно исполнять по всему поисковому индексу. Команда инженеров Perplexity опубликовала подробное техническое исследование под названием «Fast Embeddings on GPUs». В нём раскрывается архитектура внутреннего сервиса, обеспечивающего работу модели pplx-embed, а также систем ранжирования в Perplexity Search, Computer и API-платформе.
Разработчики отмечают, что на уровне самого железа инференс эмбеддингов на современных ускорителях NVIDIA Hopper и Blackwell практически достиг предельной производительности во всех популярных движках. По этой причине основной потенциал оптимизации сместился в сторону обвязки модели и среды исполнения (runtime): точной работы с графами CUDA, асинхронной абстракции отслеживания результатов и высокопроизводительного конвейера обработки на языке Rust.
Один инференс-движок для двух разных типов нагрузки
Инженеры Perplexity разделяют весь поток задач по генерации векторных представлений на два основных сценария:
- Пакетная генерация (Batch embedding): применяется при построении или переиндексации векторной базы данных. Здесь главная цель — максимальная пропускная способность для снижения удельной стоимости обработки.
- Онлайн-инференс (Online embedding): происходит непосредственно в момент пользовательского запроса. Здесь обрабатывается короткая фраза, и приоритетом становится минимально возможная задержка (latency).
- Ранжирование и оценка документов (Scoring): промежуточный этап, когда после векторного поиска ранжируется большой массив найденных материалов, балансируя между скоростью и эффективностью.
Ключевым архитектурным решением Perplexity стал отказ от разработки отдельного изолированного движка под эмбеддинги. Поскольку модели векторных представлений являются небольшими трансформерами, пакетная обработка по своей природе аналогична этапу prefill в больших языковых моделях (LLM) и ограничена вычислительной мощностью GPU (compute-bound). В свою очередь, онлайн-инференс коротких запросов из нескольких токенов похож на этап декодирования (decode) и ограничен пропускной способностью памяти (memory-bound). В итоге команда просто адаптировала и повторно использовала уже готовые ядра prefill и decode из своего стандартного стека LLM.
Тройка Ivy, Tulip и ROSE: распределение обязанностей
Для обработки входного потока запросов Perplexity спроектировала трехкомпонентную систему:
- Ivy — высокопроизводительный HTTP-шлюз на языке Rust. На стороне процессора он выполняет парсинг JSON, токенизацию, подстановку шаблонов и разделение батчей. Затем Ivy преобразует вызовы в кастомный gRPC-протокол. Если поступает слишком крупный пакет, Ivy дробит его на части и балансирует между репликами, нивелируя неравномерность нагрузки от разнородных пользовательских запросов.
- Tulip — интерфейс сервера инференса, написанный на Rust с использованием асинхронного стека tokio и tonic. Он отвечает за планирование и формирование пакетов перед передачей их в вычислительный движок.
- ROSE (Runtime-Optimized Serving Engine) — непосредственный движок исполнения моделей. Написанный преимущественно на Python, он содержит слои, кастомные ядра и определения моделей, отвечает за управление графами CUDA и предоставляет серверу Tulip единый метод
step().
Почему планировщик Tulip намеренно сделан простым
Вместо усложненных алгоритмов динамической группировки, планировщик Tulip собирает последовательности по общему принципу FCFS (First-Come, First-Served — «первым пришел, первым обслужен»).
Такая простота оправдана результатами измерений: для небольших моделей эмбеддингов при длинах контекста, используемых Perplexity, линейные затраты на полносвязные (dense) слои существенно преобладают над квадратичной сложностью механизмов внимания (attention). Из этого следует, что итоговая задержка коррелирует с суммарным количеством токенов в пакете, а не с числом отдельных последовательностей.
Как только пакет полностью насыщает вычислительные блоки GPU — а для моделей размером менее 1 млрд параметров это происходит примерно при 512 токенах — дальнейшая упаковка дополнительных последовательностей в батч перестает давать прирост производительности.
Графы CUDA и механизмы LazyTensor для устранения задержек CPU
На небольших пакетах накладные расходы процессора на запуск ядер (kernel launch) могут превышать само время вычислений на видеокарте. Чтобы устранить эту задержку, Perplexity формирует полные графы CUDA (whole-model CUDA graphs) для всех поддерживаемых моделей. Это позволяет упаковать сотни вызовов драйвера в один единственный запуск.
Переломный момент, когда работа GPU начинают преобладать над overhead процессора, достигается при размерах пакетов в тысячи токенов и десятки последовательностей. Однако некоторые реализации механизмов внимания блокировали создание полных графов из-за динамических входных данных на стороне хоста. Инженеры Perplexity подготовили и внесли необходимые изменения напрямую в upstream-репозиторий FlashInfer, открыв возможность статического захвата графа.
Графы необходимо компилировать под каждую конкретную конфигурацию, поэтому число токенов дополняется (padding) до фиксированных бакетов, кратных 64 или 256. В результате формируются тысячи графов, а их предкомпиляция занимает несколько минут при старте. Чтобы не замедлять запуск системы, инженеры применили подход Lazy Capture (ленивый захват):
- При первом вызове новой конфигурации выполняется быстрый прогревочный проход (eager warmup run).
- При повторном обращении к этой же конфигурации фоном запускается захват и воспроизведение графа CUDA.
- Это сглаживает задержки 99-го перцентиля (p99) при старте, распределяя минутную предкомпиляцию на часы работы.
Второй важной абстракцией стал LazyTensor. Вместо того чтобы синхронно блокировать хост-процессор до завершения операций на GPU, метод step() сразу возвращает объект LazyTensor. Он отслеживает заблокированный буфер оперативной памяти (page-locked host buffer), асинхронную передачу cudaMemcpyAsync и событие CUDA event. Это позволяет асинхронному Rust-процессу подготавливать батч N+1 на CPU в то время, пока видеокарта выполняет вычисления для батча N.
Выбор ядер внимания и отказ от KV-кеша в ROSE
Для эффективной работы с последовательностями переменной длины (ragged inputs) движок ROSE поддерживает сразу несколько бэкендов внимания: FlashInfer 2, FlashInfer 3 и FlashAttention 4.
В ходе тестов выяснилось, что FlashAttention 4 показывает лучшую скорость в большинстве стандартных условий. Однако FlashInfer 3 обгоняет его на моделях семейства Qwen при работе со сверхдлинными контекстами. Поэтому выбор вычислительного бэкенда осуществляется динамически под конкретную задачу.
Кроме того, при обслуживании моделей эмбеддингов ROSE принципиально не выделяет память под KV-кеш (Key-Value cache) и вызывает вариации ragged attention напрямую, исключая накладные расходы на дополнение нулями (padding).
Результаты бенчмарков и выводы
Разработанную архитектуру Perplexity протестировала в сравнении с движком vLLM версии v0.22.0 в формате BF16 на реальных весах. Качество проверялось с помощью контрольных прогонов: расхождение косинусного сходства (cosine similarity divergence) не превышало 0.1%.
Тестирование проводилось по четырем сценариям:
- Low-latency embeddings: размер батча 1, длины 128, 512 и 4096 токенов.
- Low-latency scoring: размеры батча 5, 25 и 50 при длине 512 токенов.
- High-throughput embeddings: батч 100 в 4 параллельных процессах.
- High-concurrency embeddings: нагрузка от 1 до 16 одновременных запросов с учетом токенизации Ivy и сетевых расходов.
Переиспользование LLM-ядер prefill и decode, ленивый захват графов CUDA и асинхронный паттерн LazyTensor позволили Perplexity создать высокоэффективный стек, который обеспечивает работу их внутреннего поиска и доступен разработчикам через Embeddings API.
Источник: www.marktechpost.com
