
Мой блог
Маршрутизация моделей ИИ: как системы выбирают оптимальную нейросеть для каждого запроса

Что такое маршрутизация моделей: определение и границы технологии
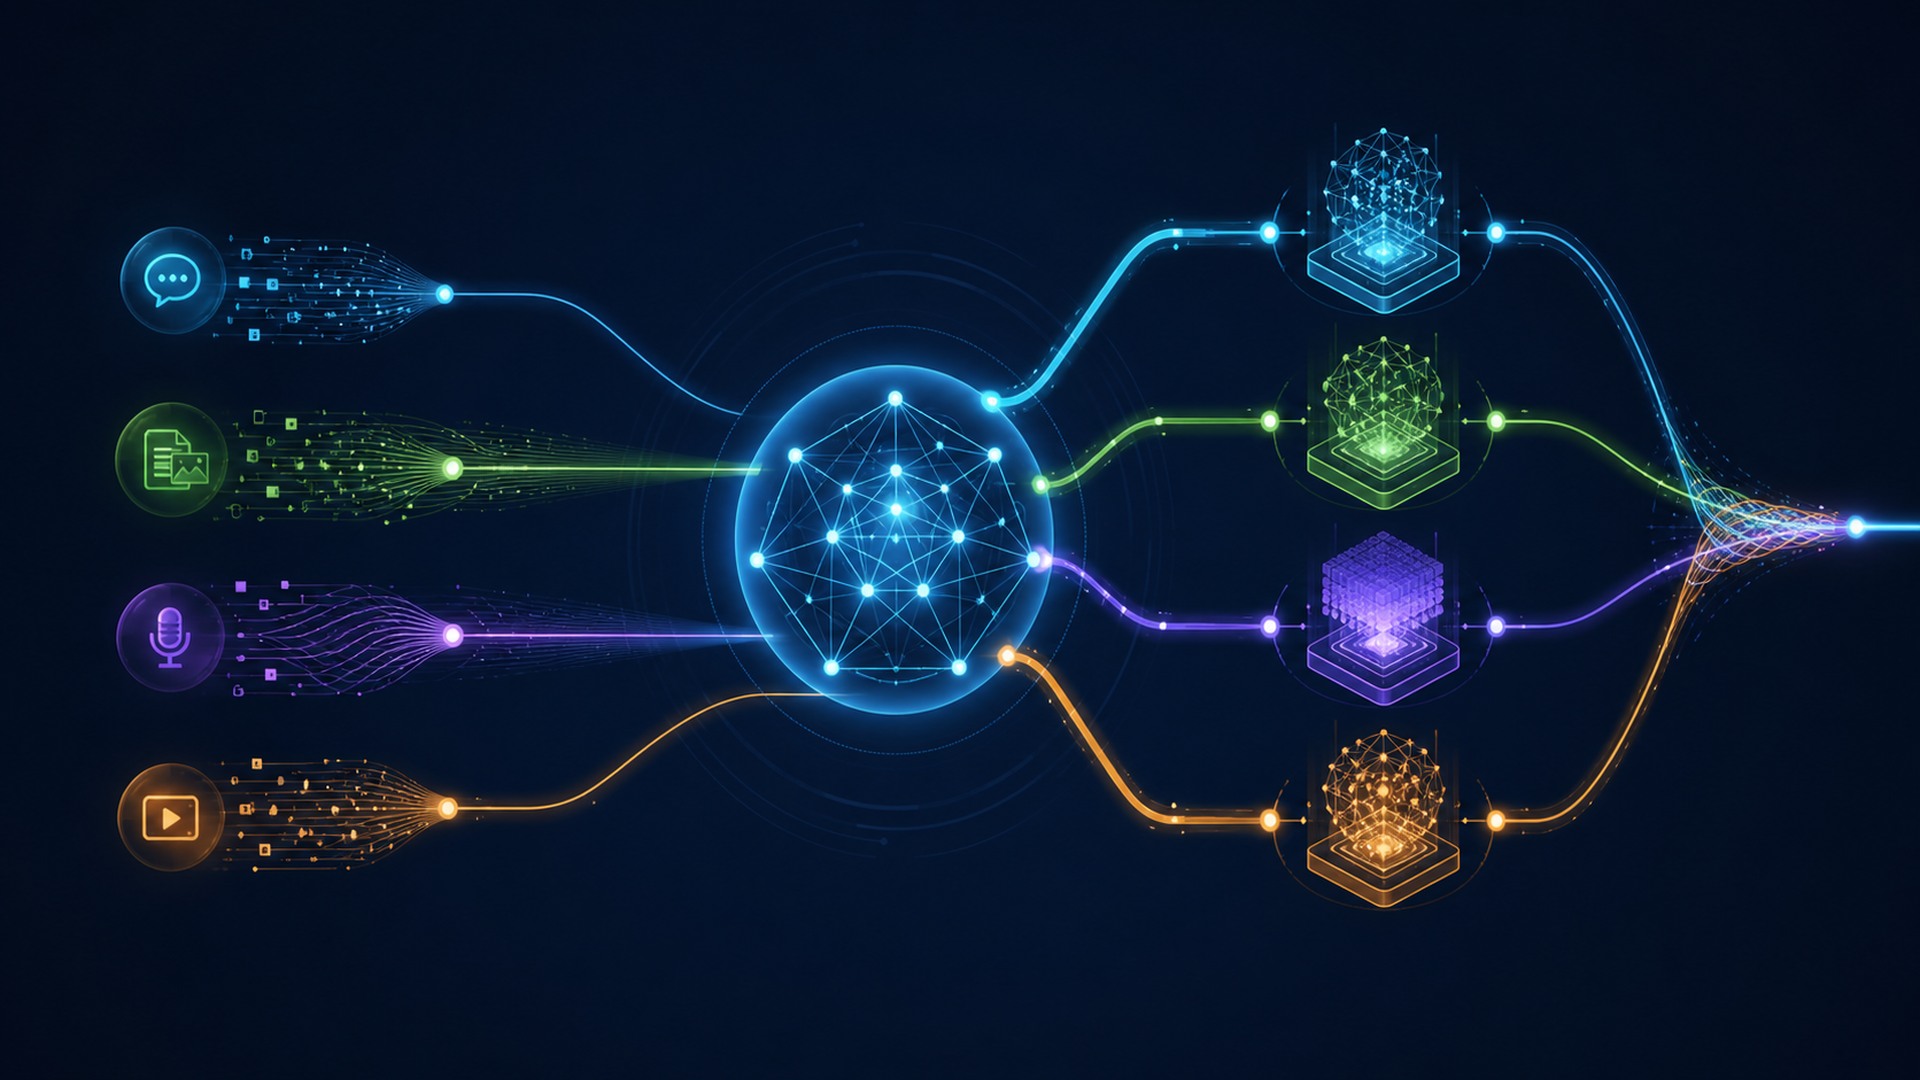
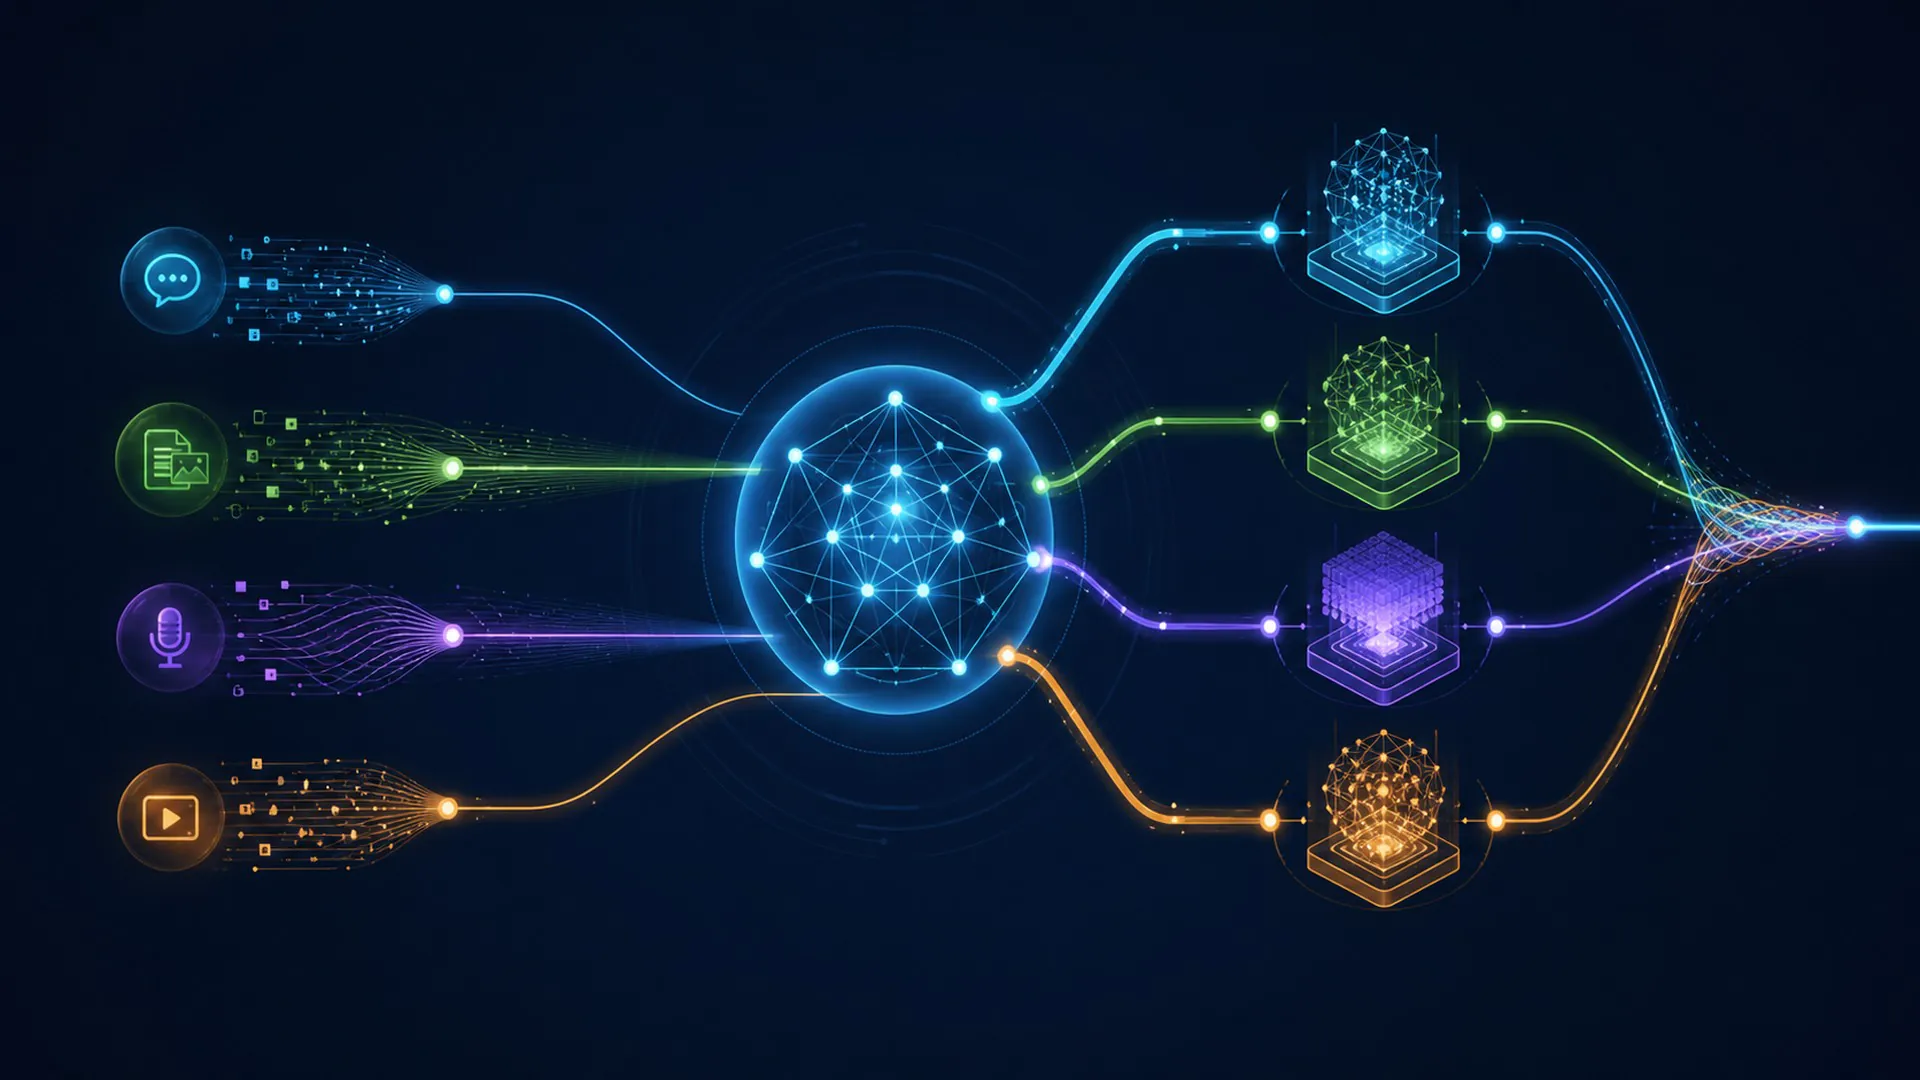
В современной практике разработки искусственного интеллекта концепция маршрутизации моделей (Model Routing) занимает ключевое место. Когда мы строим масштабные сервисы на базе нейросетей, отправлять абсолютно каждый запрос в самую крупную и продвинутую модель становится катастрофически невыгодно и медленно. Маршрутизация моделей — это динамический механизм, который для каждого входящего запроса выбирает наиболее подходящую нейросеть, инструмент или конфигурацию параметров, основываясь на требуемой мощности, рисках, задержке (latency), доступности вычислительных ресурсов и итоговой стоимости.
Для меня как инженера важно подчеркнуть: маршрутизация — это не абстрактная идея «продвинутого ИИ», а четко определенный поток информации и программный механизм времени исполнения (runtime). Чтобы правильно оценить эффективность системы, необходимо разграничивать собственное поведение обученной модели и внешнюю логику приложения, которая определяет, когда, куда и с какими правами передается запрос.
Производительность инференса — это системное свойство. Оно складывается из архитектуры нейросети, точности вычислений (quantization), скорости перемещения данных в памяти, планирования задач, сетевых задержек, аппаратной части и характера нагрузки. Неверная маршрутизация может полностью уничтожить преимущества даже самого мощного вычислительного кластера.
Пятиэтапная операционная карта маршрутизации моделей
Чтобы понять, как проходит обработка запроса, удобнее всего представить процесс в виде пяти последовательных шагов. Каждая стадия должна иметь понятного владельца, входящие данные, измеряемый результат и критерии проверки.
1. Классификация запроса и ограничений
На первом этапе система принимает пользовательский ввод и проводит его первичный анализ. Задача компонента — определить намерение пользователя, выявить явные и неявные ограничения, зафиксировать требуемый контекст и проверить входящие параметры. Здесь важно фиксировать любые отклоненные альтернативы и неопределенность, чтобы заранее отследить ошибки классификатора до того, как они приведут к некорректным действиям на выходе.
2. Оценка сложности и требуемой модальности
После первичной классификации система оценивает, насколько сложна поставленная задача и какие модальности (текст, код, аудио, изображение) необходимо задействовать. Простой запрос на извлечение даты из текста не требует запуска модели с десятками миллиардов параметров — с этим справится компактная локальная нейросеть. На этом этапе формируется представление о необходимых вычислительных затратах.
3. Применение политик и правил локализации данных
Это важнейший барьер безопасности и соответствия нормативным требованиям (governance). Маршрутизатор анализирует правила хранения данных (data residency), конфиденциальность персональной информации и корпоративные политики доступа. Если запрос содержит чувствительные данные, система обязана направить его только в локальную модель или защищенный контур, полностью исключая внешние API.
4. Выбор модели и резервного сценария (fallback)
Здесь происходит непосредственно принятие решения: назначается целевая модель или инструмент, а также фиксируется резервный путь на случай сбоя (fallback path). Если выбранная модель недоступна, превысила лимит запросов или выдала ошибку задержки, система автоматически перенаправляет поток на альтернативный алгоритм без срыва обслуживания пользователя.
5. Измерение результатов для улучшения маршрутизатора
Финал процесса — сбор обратной связи и метрик. Маршрутизатор фиксирует время отклика, качество сформированного ответа, расход ресурсов и корректность сделанного выбора. Эти данные используются для дообучения классификатора и коррекции правил выборки. Для диагностики сбоев систему анализируют в обратном порядке: от ошибочного или дорогого ответа назад к начальным допущениям первого этапа.
Практический пример маршрутизации в реальной системе
Рассмотрим жизненный сценарий из практики. В сервис поступает два разных запроса. Первый — извлечь сумму и дату из скана кассового чека. Второй — провести глубокий юридический анализ формулировок договора на предмет скрытых рисков.
При грамотно настроенной маршрутизации первый запрос мгновенно уходит на небольшую специализированную модель извлечения сущностей. Это занимает миллисекунды и стоит доли цента. Второй запрос определяется как высокорискованный и сложный: он перенаправляется на флагманскую мультимодальную нейросеть, а при необходимости — отправляется в очередь на валидацию экспертом-человеком.
Тестирование таких цепочек требует проверки не только на идеальных примерах, но и на зашумленных, неоднозначных и заведомо провокационных запросах. Если система падает при изменении хотя бы одного параметра нагрузки, значит, архитектура не готова к реальной эксплуатации.
Маршрутизация против самого распространенного упрощения
Самая частая ошибка при проектировании ИИ-систем — отсылать вообще весь трафик в самую большую и дорогую модель. Такое упрощение уничтожает сам смысл концепции маршрутизации.
Давайте сравним эти два подхода:
- Полноценная маршрутизация: динамически сопоставляет сложность задачи с минимально достаточным ресурсом, минимизирует задержки, строго соблюдает политики безопасности и гибко переключается на резервные варианты.
- Наивный подход («все в топовую модель»): приводит к кратному перерасходу бюджета, создаёт критические задержки на простых задачах, увеличивает зависимость от одного провайдера и маскирует ошибки локальных компонентов.
В научных статьях под маршрутизацией часто понимают отдельный алгоритм или нейросетевой классификатор. Однако в промышленном сервисе в этот контур входят системы кэширования, векторы RAG, проверка прав доступа, очереди, веб-интерфейсы и непрерывный мониторинг.
Почему маршрутизация моделей становится критически важной
Сегодня ИИ-системы получают огромные контекстные окна, многомодальные входы, доступ к исполнению кода и прямую интеграцию с бизнес-процессами предприятий. Деталь, которая раньше казалась академическим экспериментом, сегодня напрямую определяет себестоимость продукта, время отклика, юридическую ответственность и энергетический след компании.
При оценке маршрутизации нельзя ограничиваться усредненными цифрами. Я всегда рекомендую смотреть на распределения показателей при реальной параллельной нагрузке. Оценивайте следующие параметры:
- Время до первого токена (TTFT) и общее время генерации;
- Задержку в худших случаях (tail latency, 99-й перцентиль);
- Пропускную способность и коэффициент утилизации оборудования;
- Долю успешных операций и итоговую стоимость одного полезного ответа.
Какую пользу дает внедрение маршрутизатора
Главное преимущество маршрутизации — точечное устранение узких мест вашей инфраструктуры. В зависимости от конфигурации вы получаете:
- Существенное снижение финансовых затрат на вызовы API или аренду GPU;
- Мгновенный отклик сервиса для простых сценариев использования;
- Снижение нагрузки на оперативную память и сокращение перемещения данных;
- Четкое разграничение полномочий нейросетей при выполнении критических действий;
- Повышение точности ответов за счет передачи узкоспециализированных задач профильным моделям.
Ключевой сценарий сбоя: где кроется главная опасность
Центральный риск любой системы маршрутизации — слабая работа самого классификатора. Если маршрутизатор по ошибке пометит сложную или высокорискованную задачу как простую и отправит ее в слабую модель, сервис выдаст недостоверный или опасный результат.
Чтобы предотвратить такой сбой, механизмы контроля должны срабатывать ДО совершения необратимого действия. В архитектуру необходимо заложить следующие превентивные шаги:
- Раннее определение признаков аномалий и высокой неопределенности;
- Жесткие пороги отказа от выполнения (abstain) при сомнениях классификатора;
- Автоматический перехват управления человеком (human-in-the-loop);
- Мгновенная остановка цепочки вызовов при выходе за пределы допустимых полномочий.
План проверки и тестирования системы маршрутизации
Для объективной оценки маршрутизатора я рекомендую придерживаться системного плана тестирования:
- Сформулируйте целевую метрику: четко опишите, какую именно проблему должна решить маршрутизация (например, снизить стоимость на 40% при сохранении 95% точности).
- Используйте изолированный тестовый датасет: проводите сравнение на наборе данных, который не участвовал в настройке правил.
- Поэтапное внедрение: протестируйте систему в теневом режиме (shadow mode), затем через канареечные релизы (canary deployment) и лимиты частоты запросов.
- Версионирование всех элементов: фиксируйте не только вес моделей, но и версии токенизаторов, промптов, индексов RAG, конфигураций и кода сервиса.
- Критерий опровержения: зафиксируйте результаты, при которых вы признаете гипотезу о пользе маршрутизации неверной и откажетесь от внедрения.
Вопросы, которые стоит задать перед внедрением
Прежде чем писать код или покупать готовый маршрутизатор, ответьте на семь ключевых вопросов:
- Какое конкретное измеряемое узкое место мы пытаемся устранить?
- На каком из пяти этапов происходит ключевое преобразование данных?
- Как наша система показывает себя в сравнении с простым базовым уровнем (отправкой всего трафика в одну модель)?
- Какие результаты показывает маршрутизатор на сложных, краевых и вредоносных запросах?
- Каковы суммарные накладные расходы на работу самого маршрутизатора (задержка, память, поддержка)?
- Как мы узнаем о том, что маршрутизатор ошибочно занизил сложность опасного запроса?
- Есть ли у системы безопасный сценарий отката (fallback) до того, как пользователь получит ответ?
Первоисточники для глубокого изучения темы
Если вы хотите детально разобраться в вычислительных механизмах, окружающих маршрутизацию моделей, советую изучить фундаментальные технические работы:
- Исследования по технологии FlashAttention (оптимизация работы памяти при повышенных контекстах);
- Архитектуру vLLM и алгоритм PagedAttention (эффективное управление оперативной памятью GPU);
- Работы по спекулятивному декодированию (Speculative Decoding), где параллельно задействуются малые и крупные модели.
Главные выводы
Маршрутизация моделей — это инженерный и управленческий инструмент, а не просто громкий маркетинговый термин. Ее реальная ценность заключается в улучшении конкретных метрик продуктивности и безопасности в четко заданных условиях эксплуатации.
Главное практическое правило: сформулируйте понятную цель, сравните решение с базовым вариантом, протестируйте самые критические сценарии сбоев и сохраняйте полную прослеживаемость метрик. Только при таком подходе маршрутизация станет надежной основой вашей ИИ-инфраструктуры.
Источник: www.unite.ai
