
Мой блог
Perplexity обучает компьютерного агента на реальных ошибках с помощью подсказок

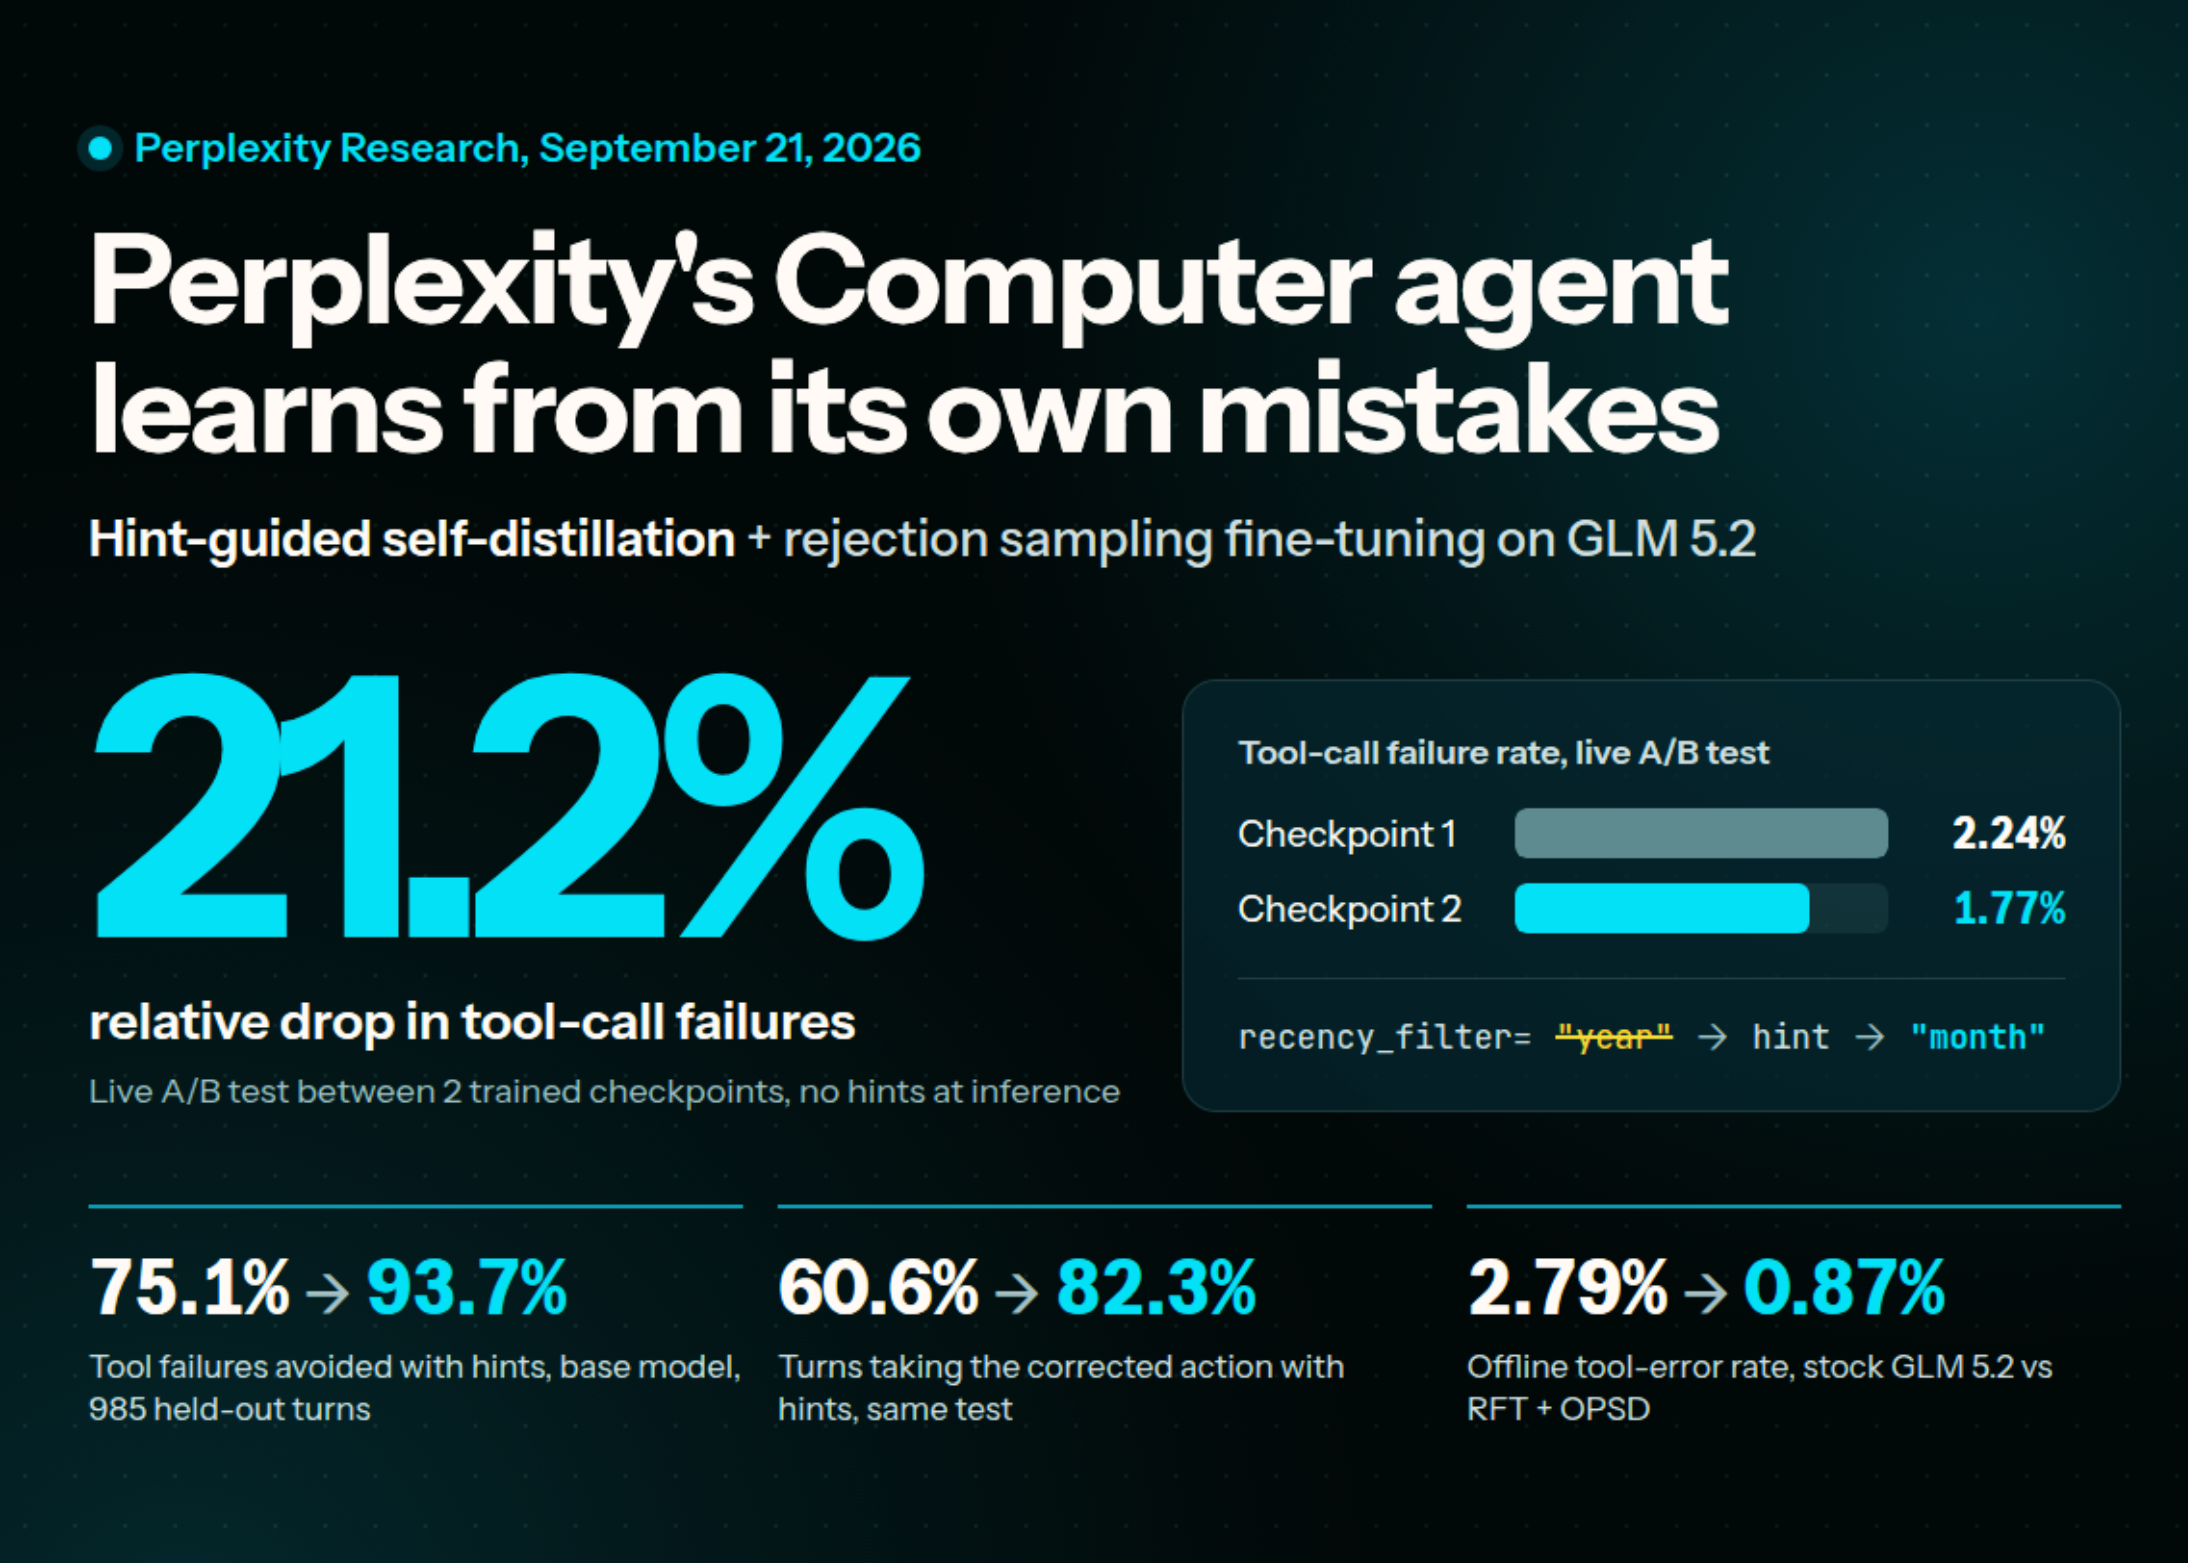
Подробности изложены в материале первоисточника. Исследовательское подразделение Perplexity представило новую методику постобучения компьютерных агентов. В основе подхода лежит пост-тренинговое исследование, объединяющее традиционную выборку по отклонению с дистилляцией знаний на основе подсказок.
Новая архитектура позволяет модели учиться не только на успешных сессиях пользователей, но и на совершенных сбоях. Подобный подход помог существенно снизить количество неудачных вызовов инструментов в реальных условиях эксплуатации.
Почему традиционная фильтрация по результату неэффективна
Стандартный метод тонкой настройки на основе выборки отклонений (RFT) оценивает каждую сессию целиком и копирует исключительно те варианты, которые привели к успеху. Однако положительный конечный результат далеко не всегда означает, что каждый отдельный шаг алгоритма был выполнен безупречно. Полноценный агент способен успешно восстановиться после некорректного обращения к внешнему инструменту и выдать правильный итоговый ответ.
Если слепо имитировать всю подобную траекторию целиком, можно закрепить в памяти модели нежелательные паттерны поведения. С другой стороны, полный отказ от неудачных сессий приводит к потере ценнейшей информации об очевидных и предотвратимых промахах.
Стратегия разделения: имитация, исправление или контекст
Чтобы избежать подобных проблем, команда разработчиков разделила процесс принятия решений на две самостоятельные задачи. Специалисты научились четко определять, какие именно сессии содержат полезное для копирования поведение, а в каких конкретных шагах кроются ошибки, требующие исправления.
Обработка шагов ассистента
Каждое действие модели в диалоге получает один из трех возможных вариантов обработки:
- Имитация: обычные шаги без ошибок в успешных сессиях задействуют функцию потерь перекрестной энтропии (CE).
- Исправление: шаги с ошибками, для которых подготовлена проверенная подсказка, используют дивергенцию Кульбака — Лейблера (KL) независимо от общего успеха сессии.
- Контекст: оставшиеся действия остаются частью входящего потока данных, но не участвуют в расчете штрафов.
Таким образом, удачные сессии могут служить источником как для имитации правильных действий, так и для коррекции выявленных огрехов. В то же время неуспешные сессии поставляют исключительно материал для исправления.
Как подсказка превращается в обучающий сигнал
Подсказкой в данном контексте выступает короткая корректирующая инструкция, которая опирается на факты, уже известные системе. Например, во время одного из поисковых запросов параметр фильтрации по времени был ошибочно установлен как «год», хотя системная схема допускала исключительно значения «день», «неделя» или «месяц». Подсказка четко указывает на проблемный вызов, содержит информацию о системной ошибке валидации и предлагает разрешенное значение либо полный отказ от необязательного поля.
Принцип работы самодистилляции
Для исправления ошибок применяется методика наглядной самодистилляции на политике (OPSD). Модуль обучения дважды запускает одну и ту же контрольную точку модели GLM 5.2 на записанном шаге диалога. Первый проход преподавателя учитывает подготовленную подсказку, а второй проход студента выполняется без нее. В обоих случаях используется принудительное обучение учителем, поэтому генерация альтернативных ответов не производится.
Вероятности токенов, полученные на учительском проходе, отделяются и служат мягким ориентиром через прямой метод KL. Совокупные потери рассчитываются как сумма перекрестной энтропии и умноженного на коэффициент лямбда параметра дивергенции, разделенная на количество скопированных токенов. Принудительное обнуление этого коэффициента возвращает систему к классическому методу SFT, а наличие компоненты CE не позволяет преподавателю и студенту достигать консенсуса простым игнорированием контекста.
Поиск истинных причин пользовательских жалоб
Описанный конвейер обработки данных формируется на основе сессий, допущенных к обучению и обслуживаемых моделью GLM 5.2. Из общего массива предварительно исключаются любые сеансы, содержащие персональные данные пользователей, а также случаи, когда клиенты явно отказались от участия в сборе информации. Специальные языковые модели выступают в роли судей, отбирая задачи с оценкой сложности 4 или 5 баллов по пятибалльной шкале. Для подтверждения успеха сессии требуется единогласное одобрение двух независимых судей.
Для анализа жалоб пользователей привлекаются уже три независимых ИИ-судьи, двое из которых должны прийти к консенсусу при поиске ответственного за сбой шага. Это критически важно, поскольку последнее действие ассистента перед отправкой жалобы является первопричиной проблемы лишь примерно в половине случаев. Каждая подсказка дополнительно сверяется с данными, доступными системе до совершения ошибки, что помогает минимизировать предвзятость ретроспективного анализа. Показательным примером служит ситуация, когда пользователь запросил форму W-3, система ошибочно приняла запрос за опечатку в форме W-2 и начала искать не тот документ. Подсказка нацелена на исправление этой первоначальной неверной интерпретации, а не только на финальный результат.
Результаты проведенных оценок
Проведенные тесты демонстрируют высокую эффективность предложенного подхода на различных этапах работы алгоритмов.
Метрики и показатели тестов
Подсказки демонстрируют результативность еще до начала полноценного обучения. На тестовой выборке из 985 зафиксированных сбоев инструментов базовая модель без дообучения избегала изначальной ошибки в 93,7% случаев при наличии подсказок (против 75,1% без них). Доля корректных действий возросла с 60,6% до 82,3%. В сценариях с пользовательской обратной связью показатели успешности для явных доказательств увеличились с 40,0% до 75,0%, а для выведенного из контекста намерения — с 32.5% до 80,0%.
В офлайн-тестах частота сбоев инструментов снизилась с 2.79% у стандартной GLM 5.2 до 1.35% при использовании только RFT, а комбинированный подход с OPSD улучшил показатель до 0.87%. При этом в живых A/B-тестах с участием около 100 000 пользователей на каждую группу ранняя контрольная точка показала незначительное изменение с 2.82% до 2.94% неудачных вызовов. Более поздний контрольный срез продемонстрировал статистически значимое сокращение ошибок на 21.2% (падение с 2.24% до 1.77%) без использования подсказок на этапе инференса.
Основные выводы
Исследование Perplexity доказывает, что современные ИИ-агенты способны эффективно обучаться на собственных промахах, а не только на идеальных сценариях. Использование верифицированных подсказок трансформирует предотвратимые ошибки в ценные ориентиры для коррекции через дивергенцию, используя одну и ту же модель в ролях учителя и студента. Несмотря на отсутствие прямого доступа к обученным весам для сторонних разработчиков, демонстрация снижения числа сбоев в реальной среде открывает перспективные направления для дальнейшего развития агентных архитектур.
