
Мой блог
Как спрогнозировать заказы ПВЗ за 50 дней до открытия: опыт геоаналитики

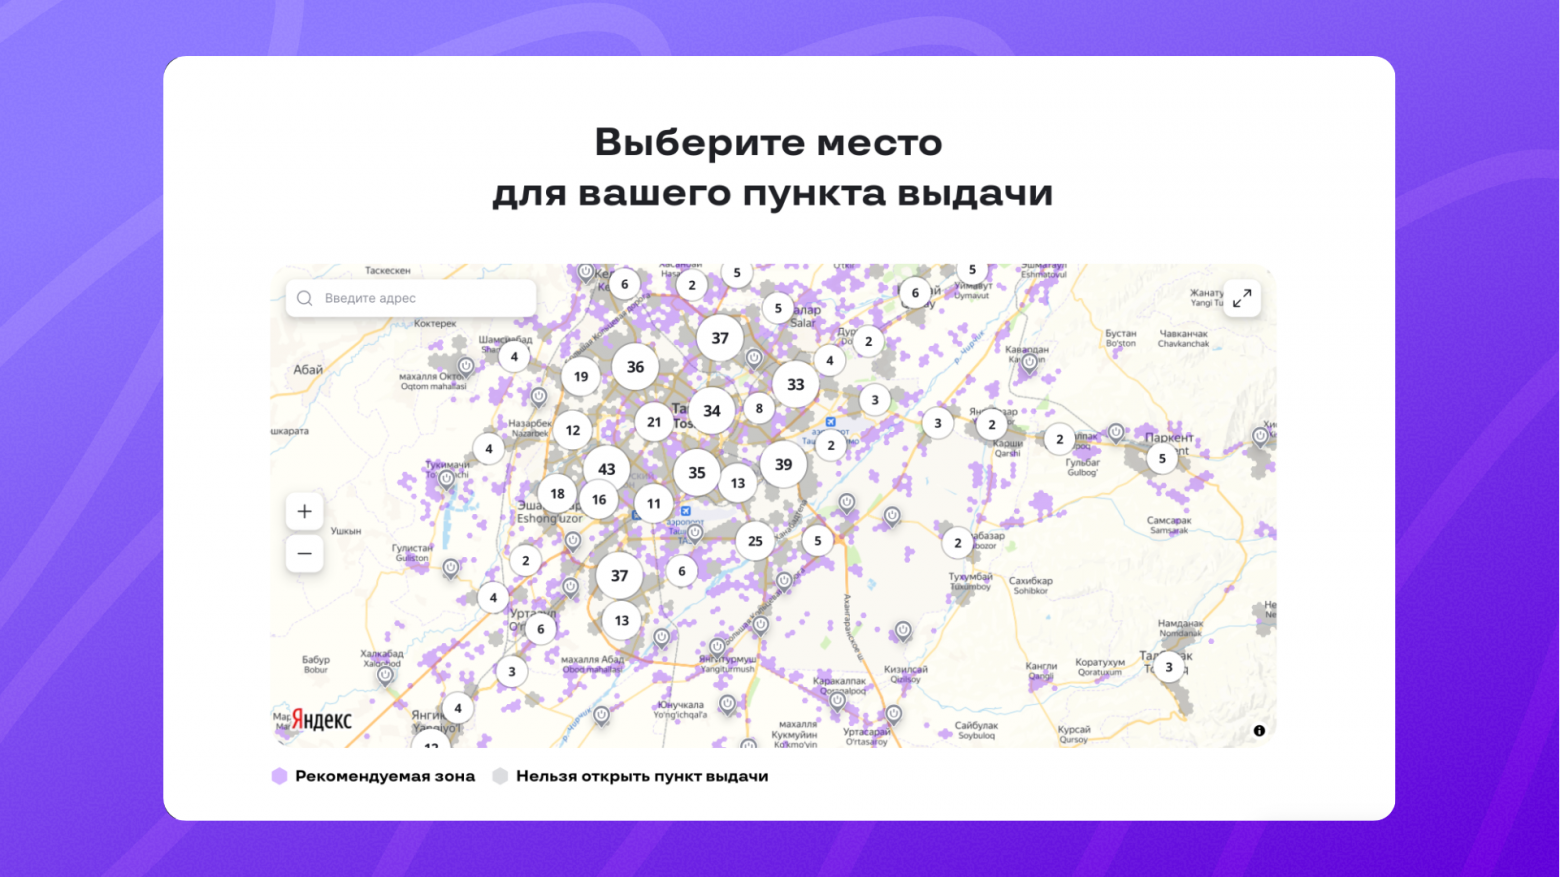
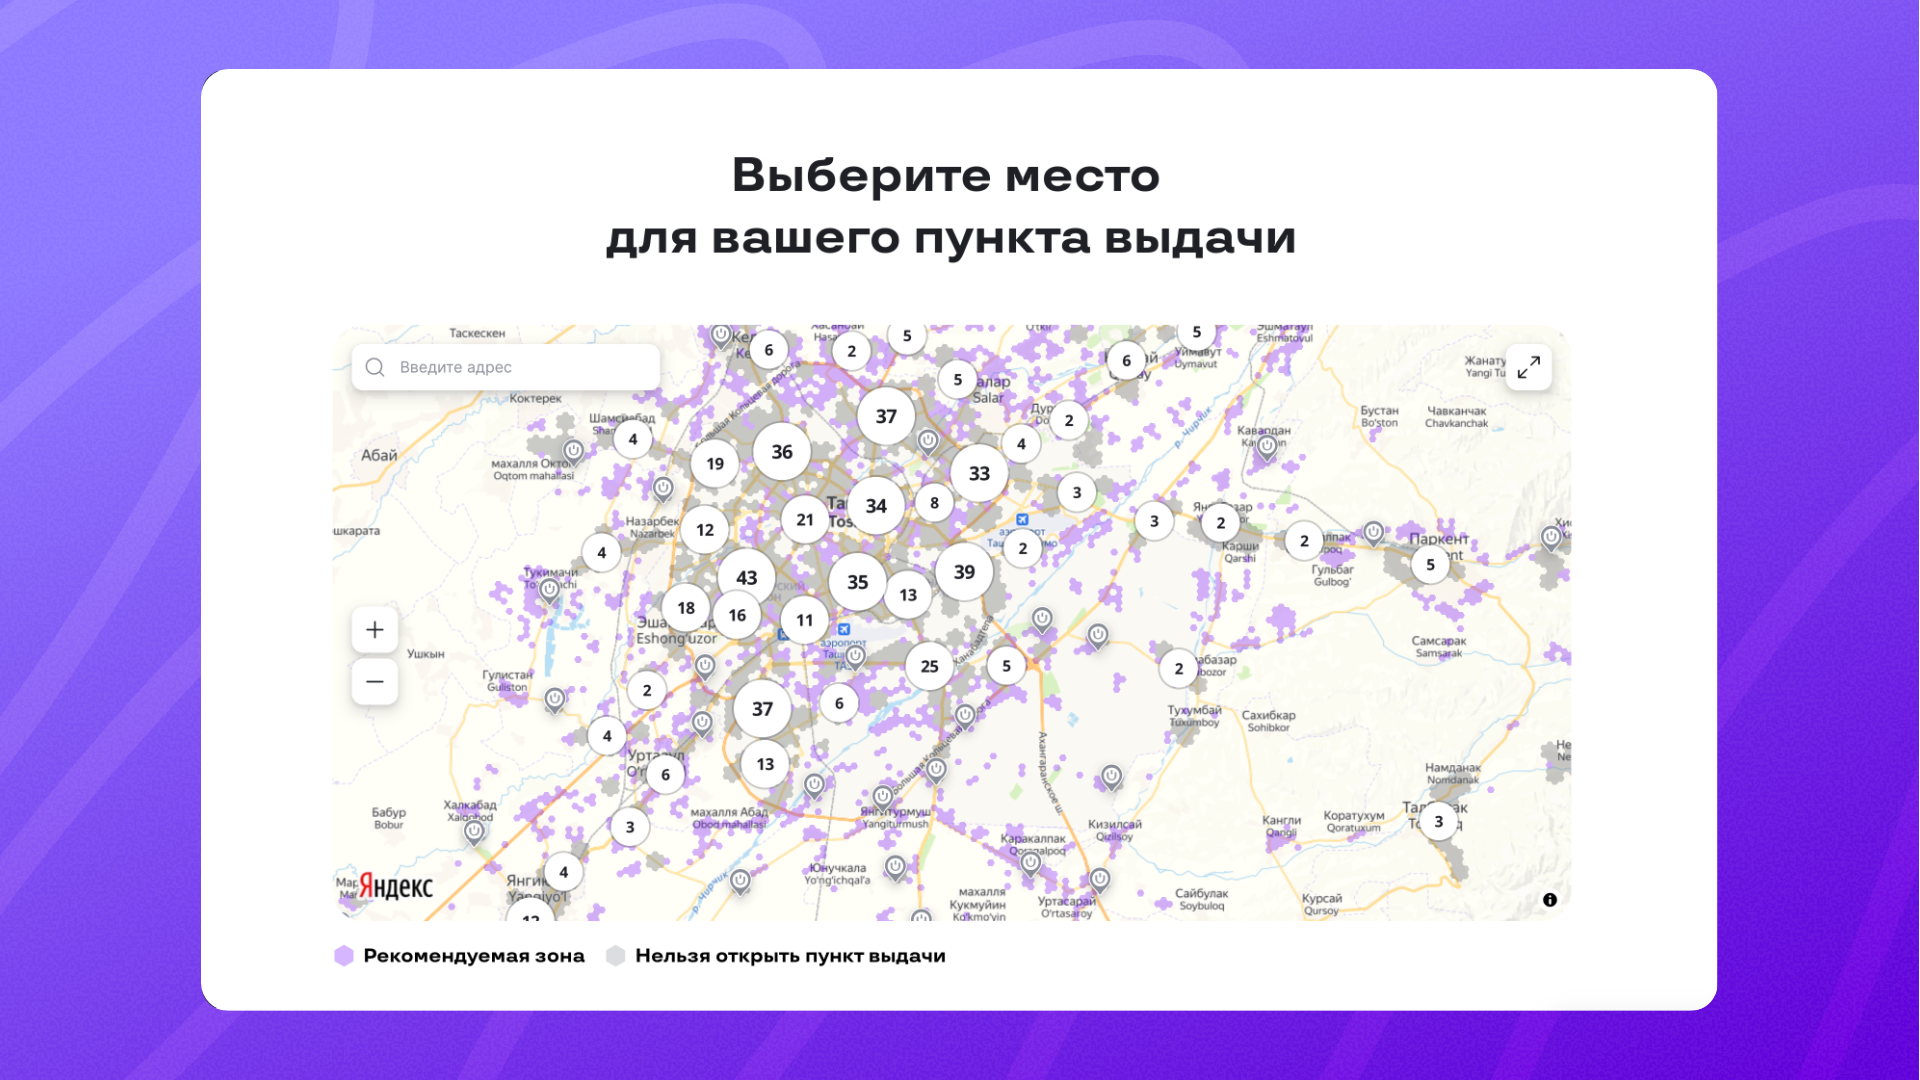
Развитие сети пунктов выдачи заказов требует точного прогнозирования спроса и оценки локаций задолго до старта работы. В материале рассматривается методика, позволяющая успешно спрогнозировать заказы ПВЗ за 50 дней до открытия, учитывая специфику данных о населении, плотность застройки и потенциальную каннибализацию трафика.
При масштабировании сети точек выбор удачного места перестает зависеть только от интуиции. Авторы анализируют ключевые аспекты геомаркетинга, сравнивают покупные базы данных с собственными подомовыми расчетами и объясняют технические детали построения ML-моделей для регрессии и пространственной оптимизации.
Три задачи, которые легко перепутать
Когда речь заходит о геоаналитике для розничной торговли, обычно выделяют три принципиально разные задачи. Первое направление заключается в оценке конкретного предложенного помещения, когда арендодатель называть конкретный адрес и требуется предсказать будущие показатели. Вторая задача состоит в выборе лучших вариантов из доступного пула при ограниченном бюджете. Третье направление — это поиск идеального места для открытия точки на карте независимо от наличия свободных квадратных метров в данный момент.
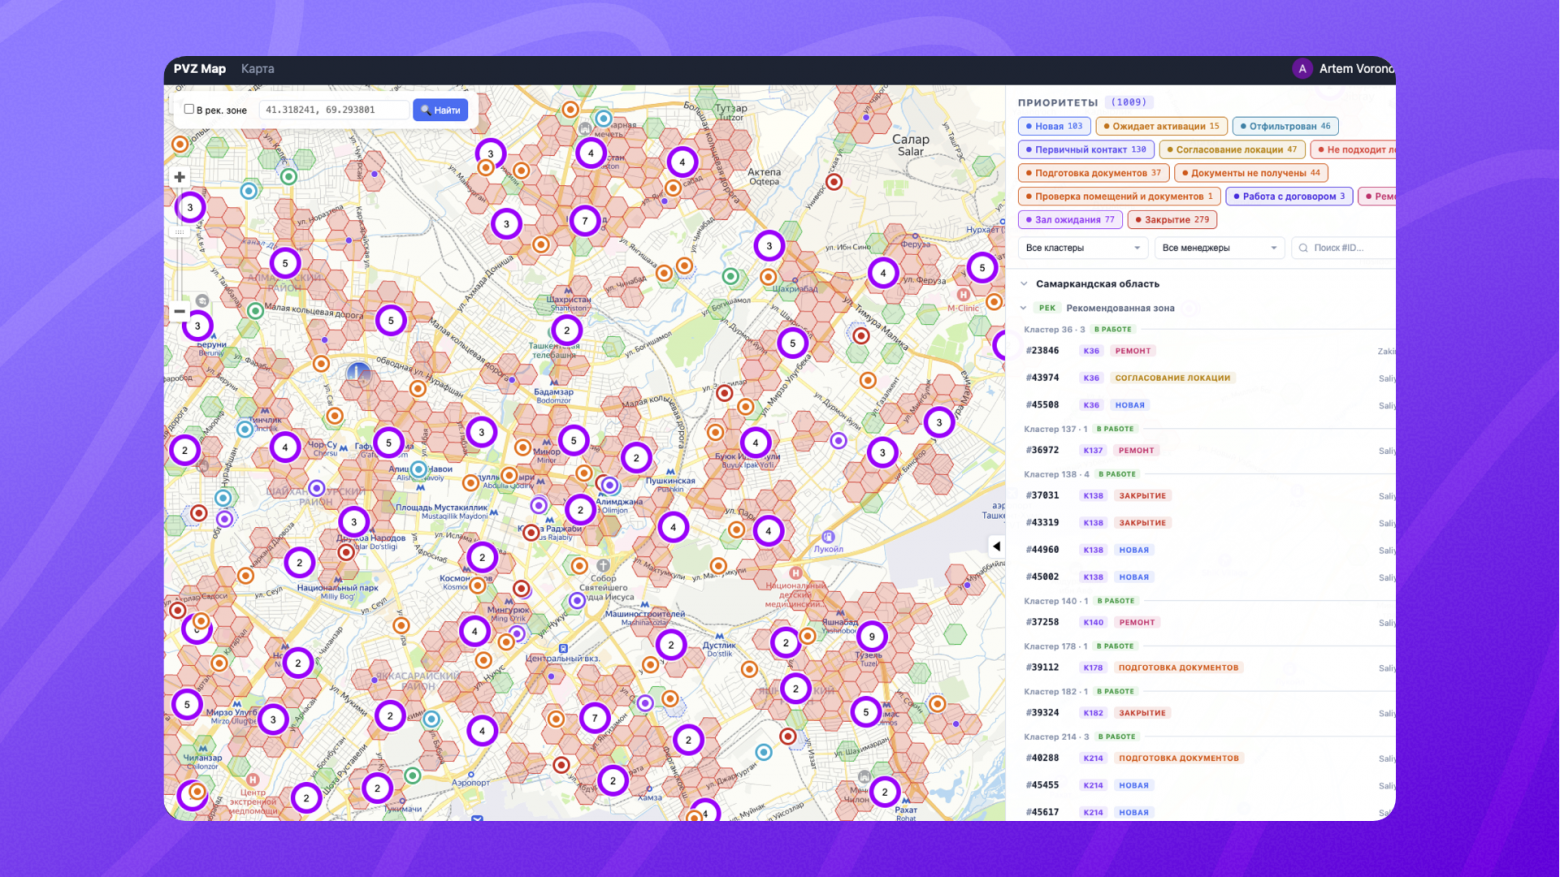
С точки зрения математики первая задача решается методами регрессии, где по набору признаков локации и истории прогнозируется число заказов. Вторая задача использует полученное ранжирование. Третья относится к комбинаторной оптимизации, цель которой — улучшить общую доступность сети для жителей при существующем распределении спроса. Каждая из этих задач требует собственных метрик и исходных данных.
Данные и проблемы их сбора
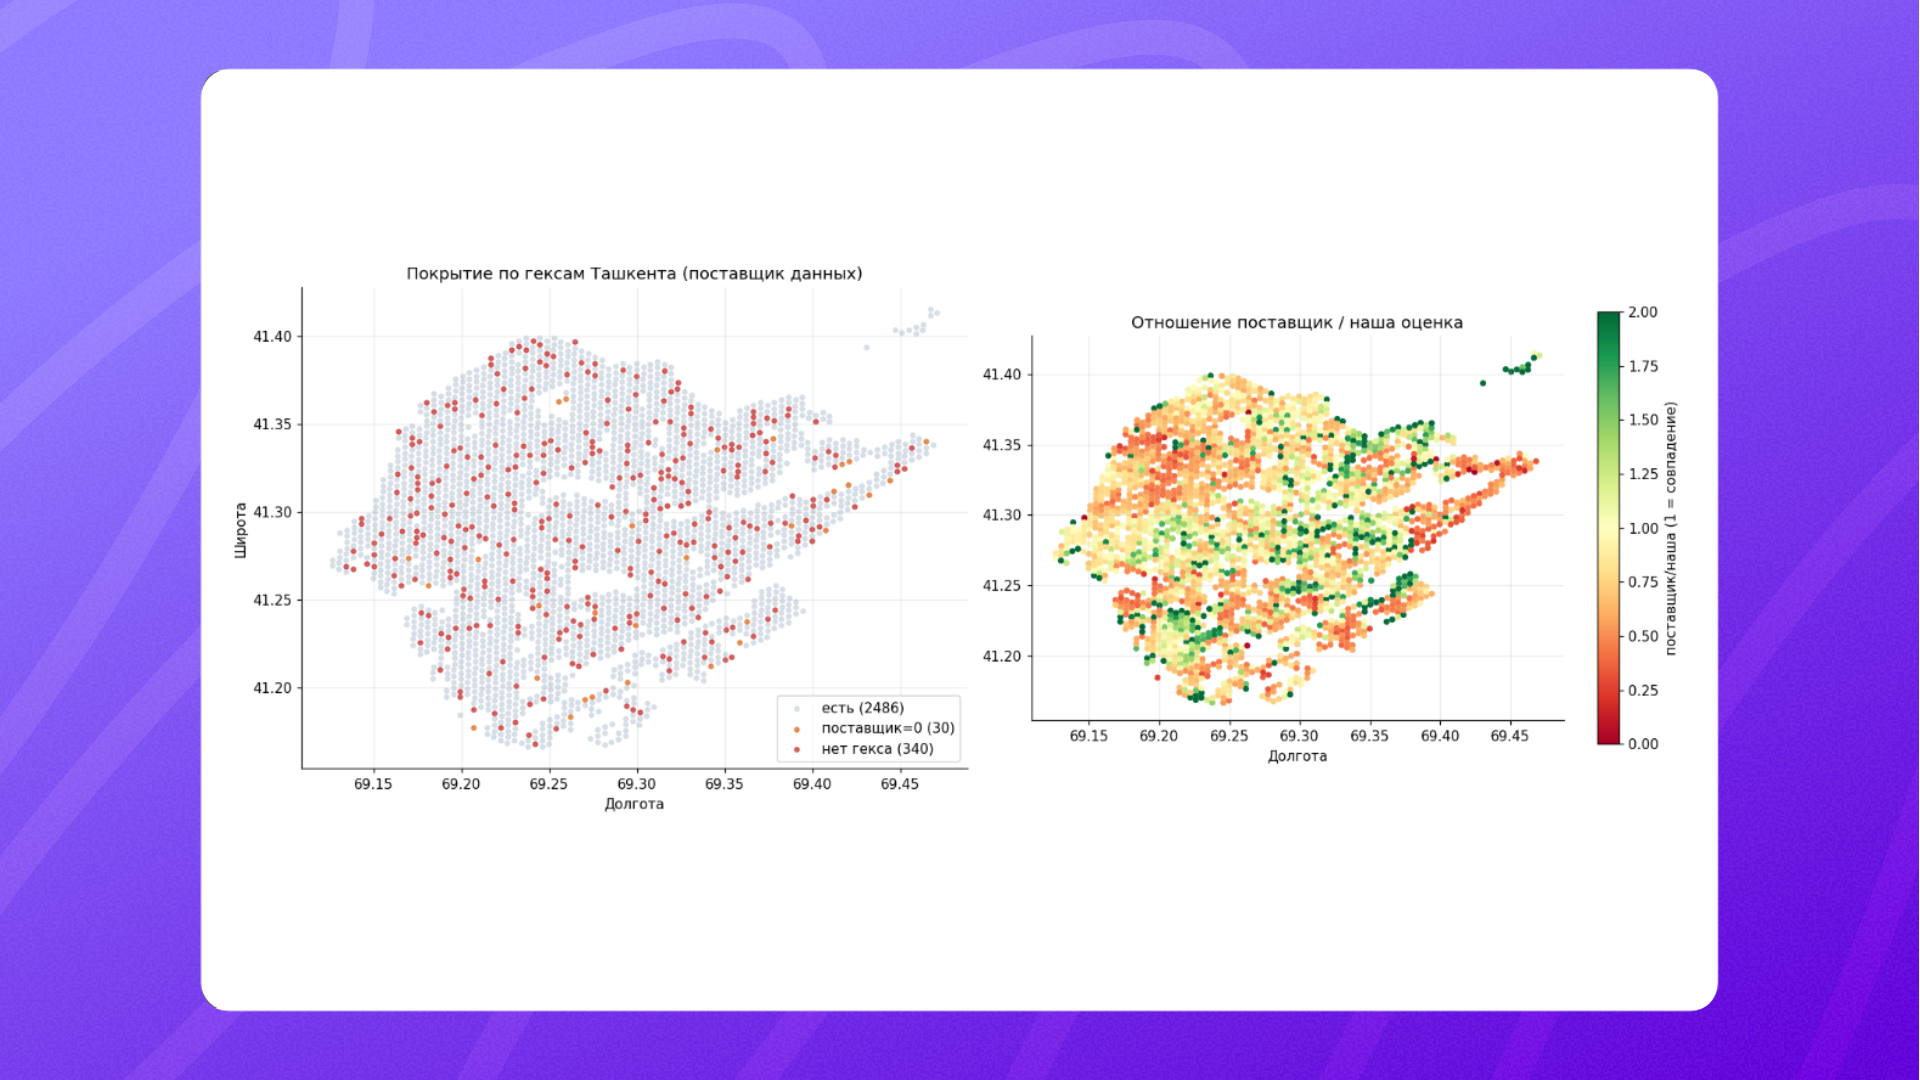
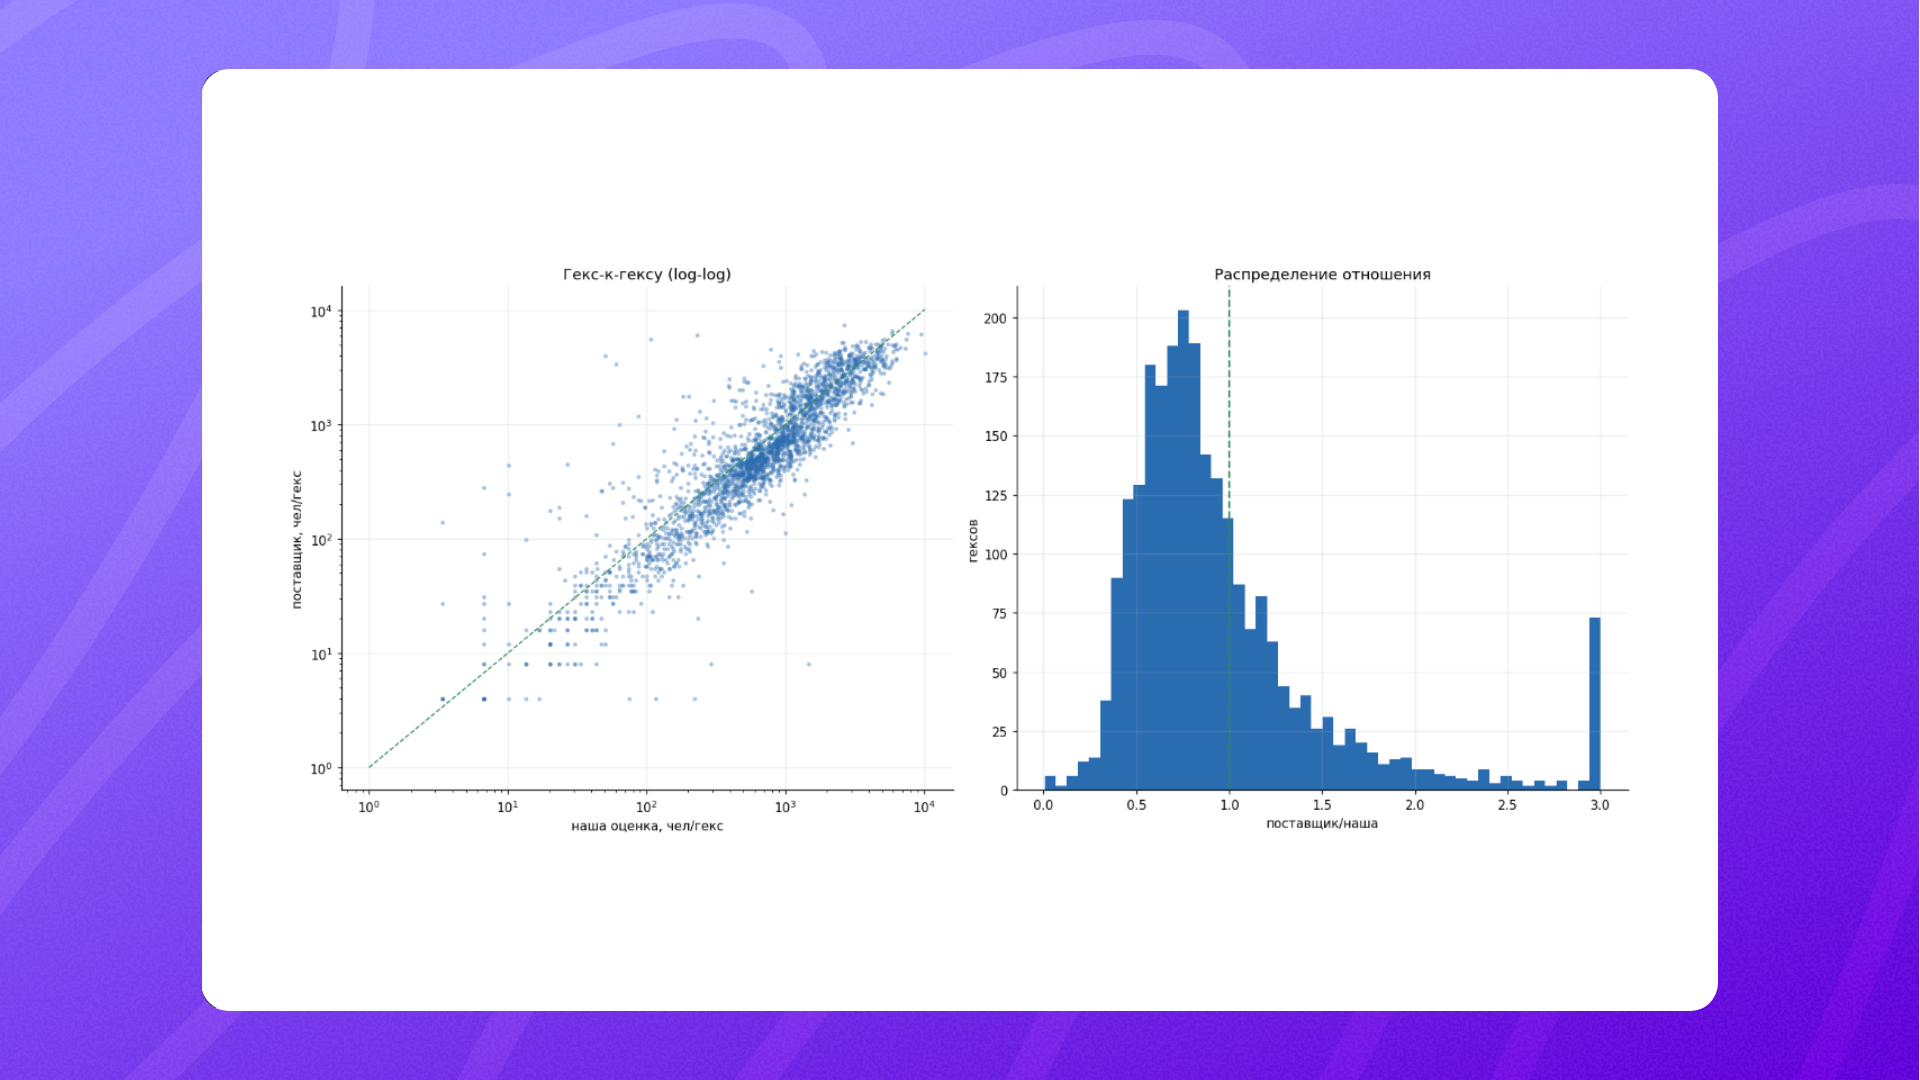
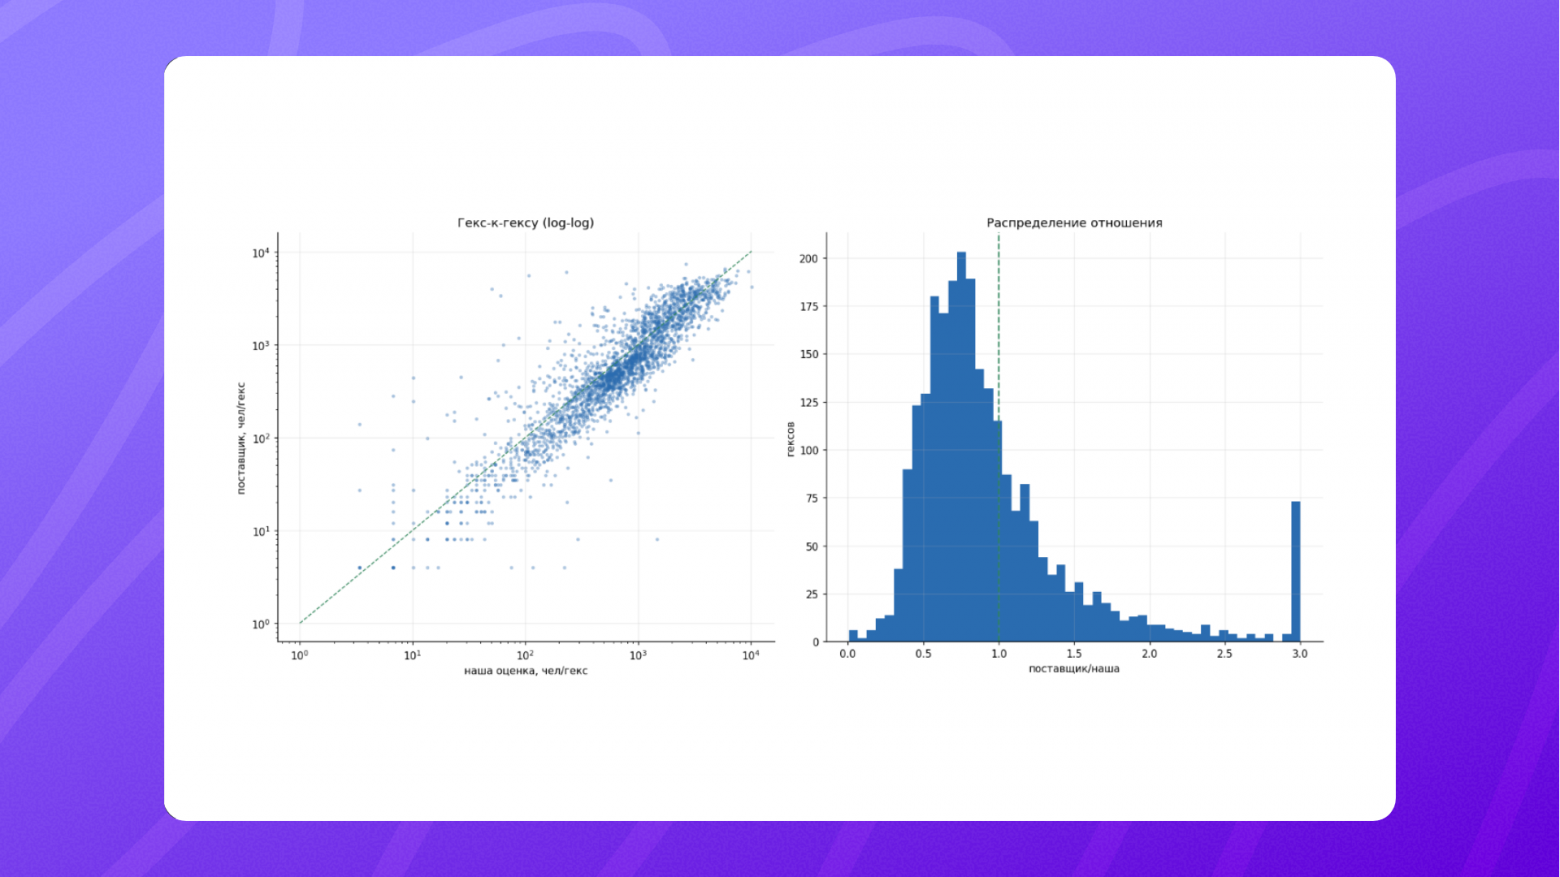
Для оценки спроса по стране обычно применяются покупные геоданные от коммерческих поставщиков, содержащие оценку численности населения и индекс пешеходного трафика в разрезе гексагонов. Однако сопоставление этих данных с собственными разработками для Ташкента выявило серьезные расхождения. В частности, в тринадцати процентах гексагонов с жилой застройкой официальные покупные данные содержали нулевые значения или отсутствовали вовсе, что приводило к выпадению целых жилых кварталов из аналитических моделей.
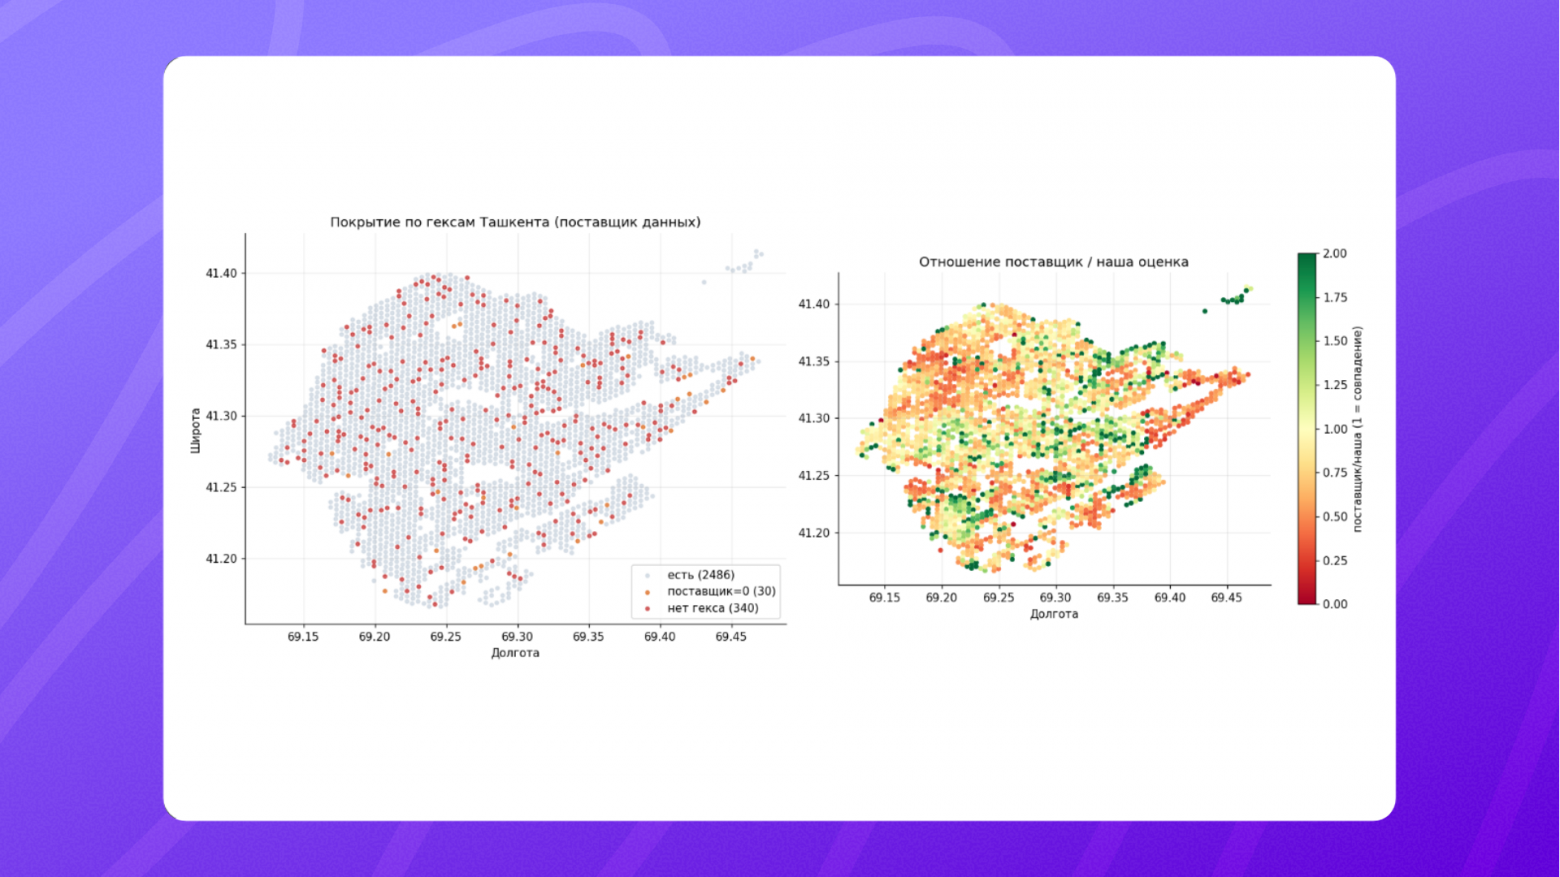
Собственная подомовая модель строилась на основе координат зданий, их типов, площадей и этажности. Поскольку единого адресного реестра и данных по оборотам конкурентов не было, разработчикам пришлось самостоятельно обрабатывать массивы информации, включая контуры построек и предварительные итоги переписи населения. Это позволило выявить слепые зоны покупной геоаналитики и точнее распределить жителей по объектам.
Прогноз заказов за 50 дней до открытия
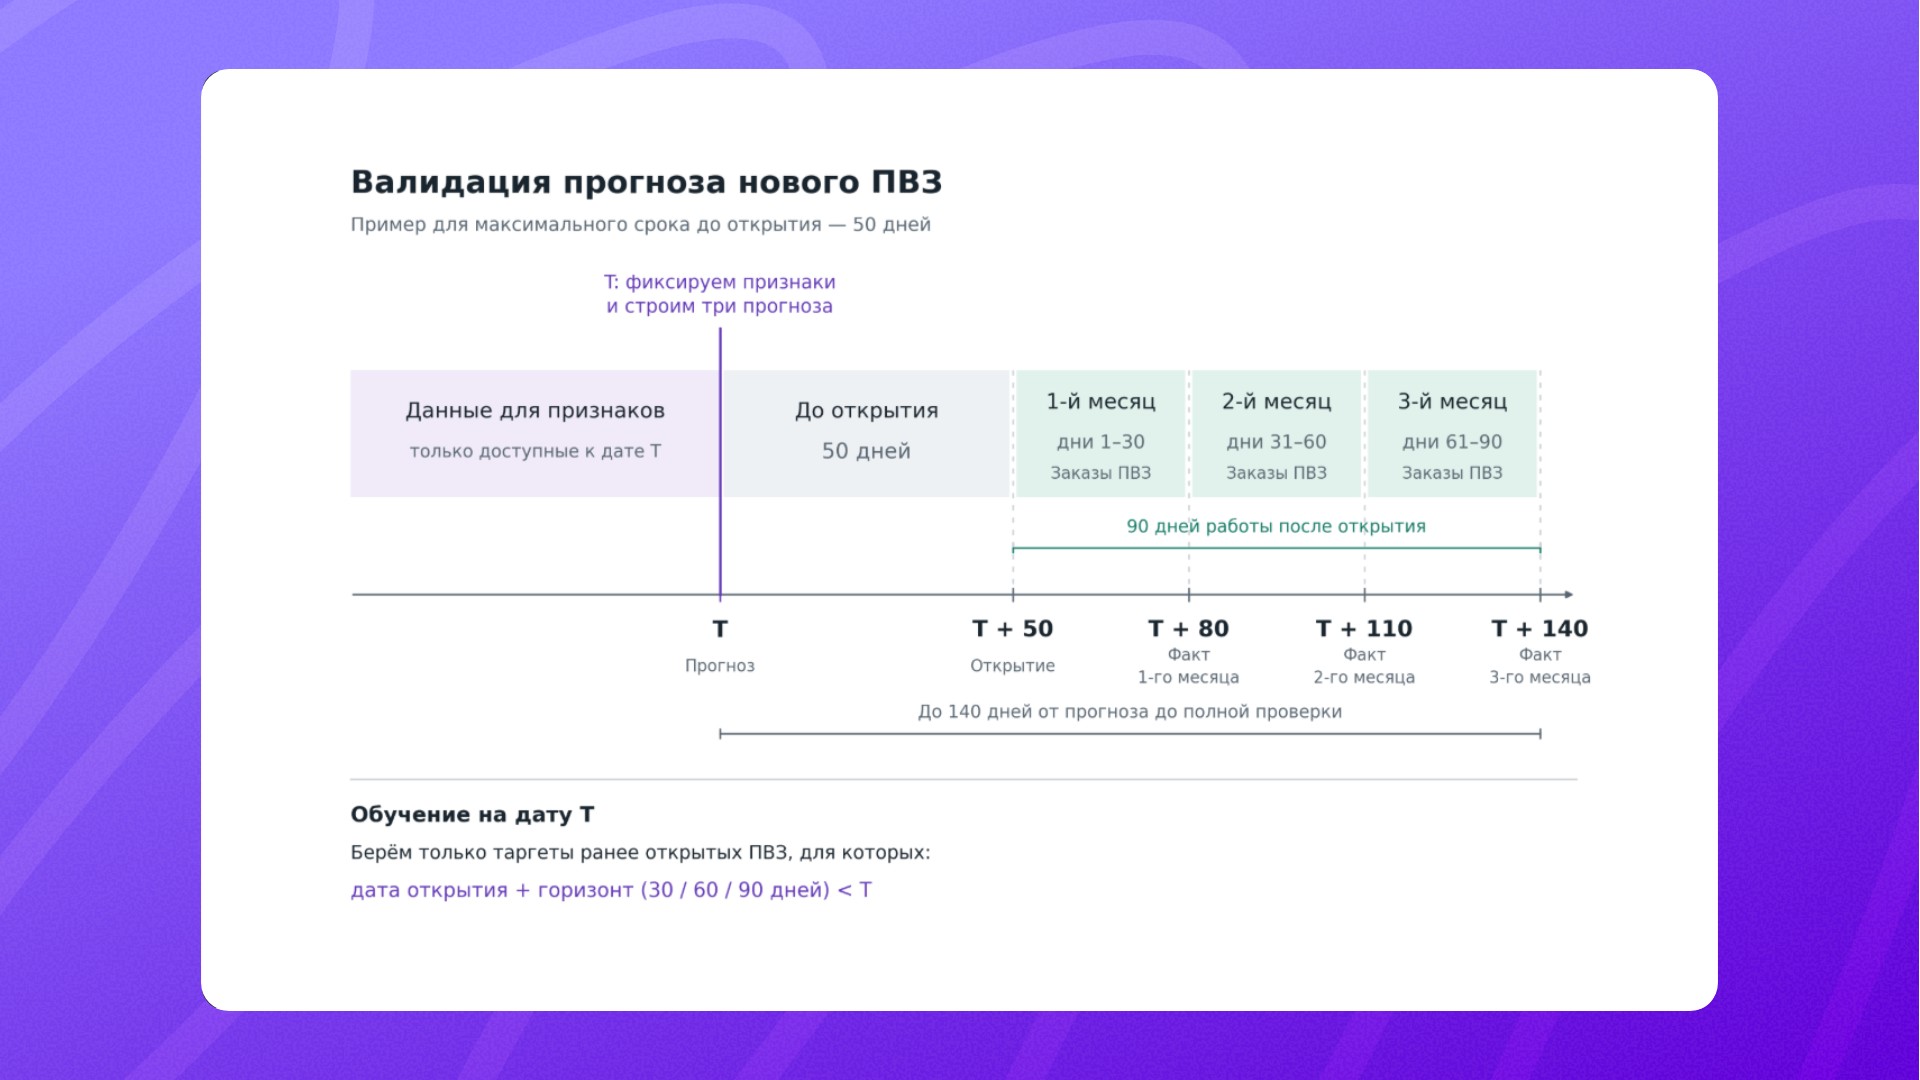
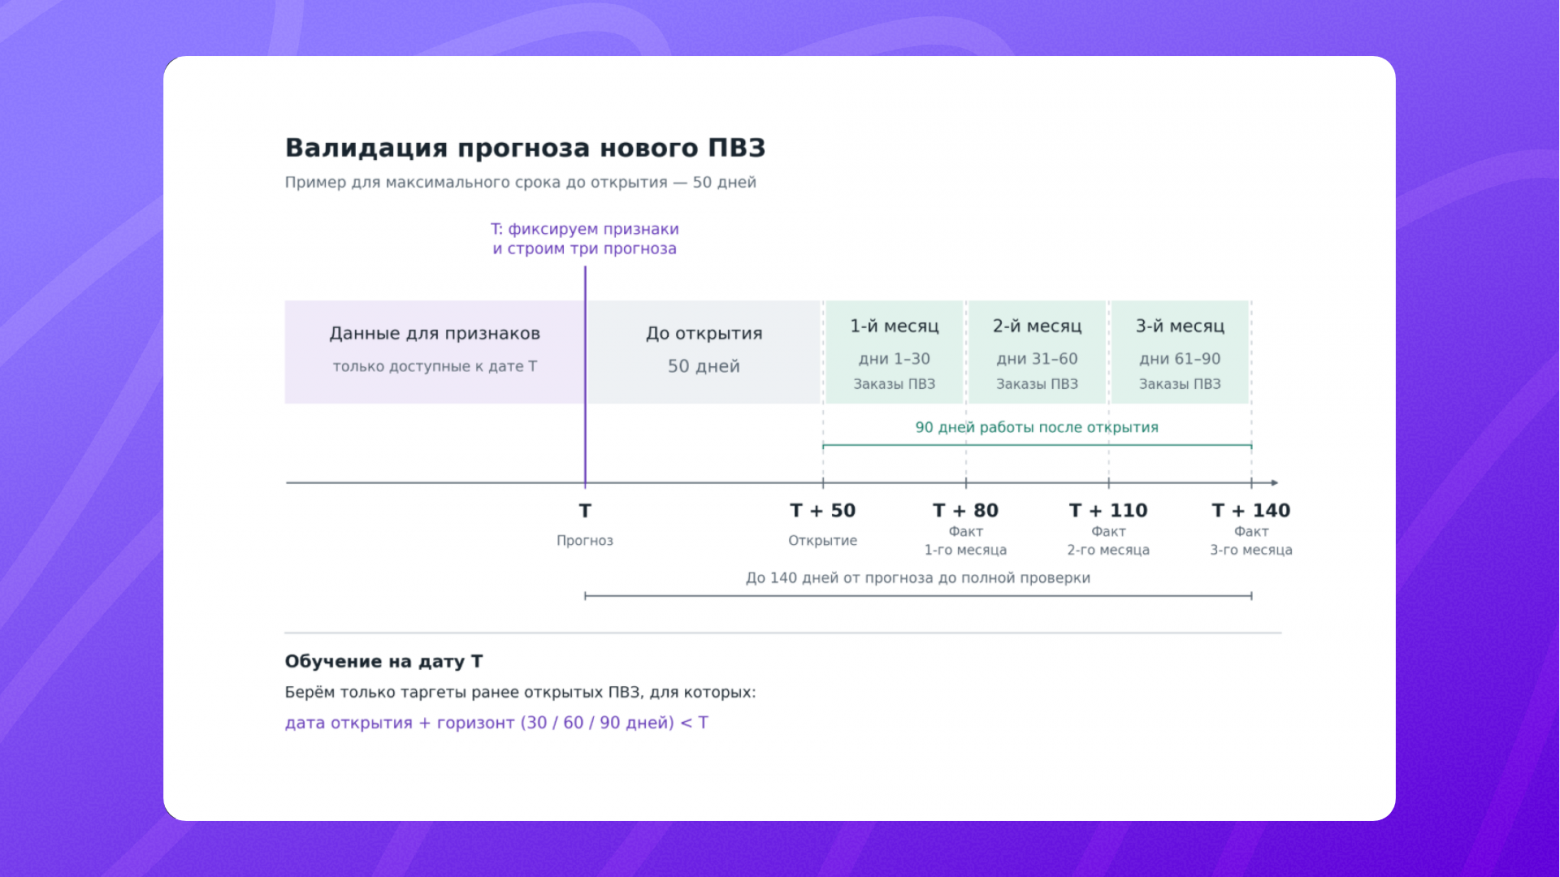
Главная практическая цель системы заключается в предсказании числа заказов для каждого из первых трех месячных периодов работы пункта с горизонтом в пятьдесят дней до запуска. В качестве базовой единицы наблюдения используется ячейка сетки H3 девятого разрешения в сочетании с временными интервалами в 30, 60 и 90 дней.
Кольцевые признаки и валидация
Для обучения моделей активно применяются кольцевые агрегаты. С помощью функции h3kRing определяются расстояния в кольцах от центрального кандидата, после чего считаются накопительные суммы населения, пешеходного трафика и исторических заказов. Всего используется свыше пятидесяти признаков, описывающих активность пользователей, плотность окружения и удаленность от других объектов инфраструктуры.
Поскольку между моментом расчета признаков и полной проверкой трехмесячного таргета проходит значительное время, разработчики ограничили глубину бустинга и применили жесткие требования к минимальному число наблюдений в листьях дерева. Это помогает избежать переобучения на ограниченной выборке новых точек.
Эволюция моделей: от V1 к V2
Первая версия алгоритма опиралась на псевдо-uplift-подход с прогнозированием единственного горизонта и функцией потерь Tweedie. Она имела ряд недостатков, включая резкие перепады прогнозов на административных границах регионов и появление ненулевых предсказаний в пустых зонах. Позже от сложной конструкции отказались в пользу единой регрессионной модели на базе CatBoostRegressor, где горизонт прогноза стал обычным числовым признаком.
Переход на ежедневное автоматическое переобучение позволил существенно снизить метрику WAPE и устранить разрыв между качеством на исторических и самых свежих данных. Расстояние до ближайших пунктов выдачи также было переведено в разряд стандартных признаков, благодаря чему модель самостоятельно учитывает фактор внутренней конкуренции.
Оценка каннибализации и переход к уровню зданий
Прогнозирование показателей новой точки не дает полного понимания того, какая доля заказов уйдет из уже работающих поблизости пунктов. Для оценки этого эффекта применяется алгоритм ближайших соседей. Система находит пять наиболее похожих успешных открытий с помощью L1-метрики в пространстве признаков, после чего рассчитывает взвешенное среднее фактической каннибализации за первые два месяца.
Гексагональная сетка удобна для глобальной агрегации, но оказывается слишком грубой для выбора конкретного помещения. Соседние ячейки могут разделять сотни метров, что критично для пешеходной доступности. Перенос части признаков на уровень отдельных зданий и уменьшение радиусов анализа позволили дополнительно улучшить точность прогнозов.
Оптимизатор размещения и подомовая модель
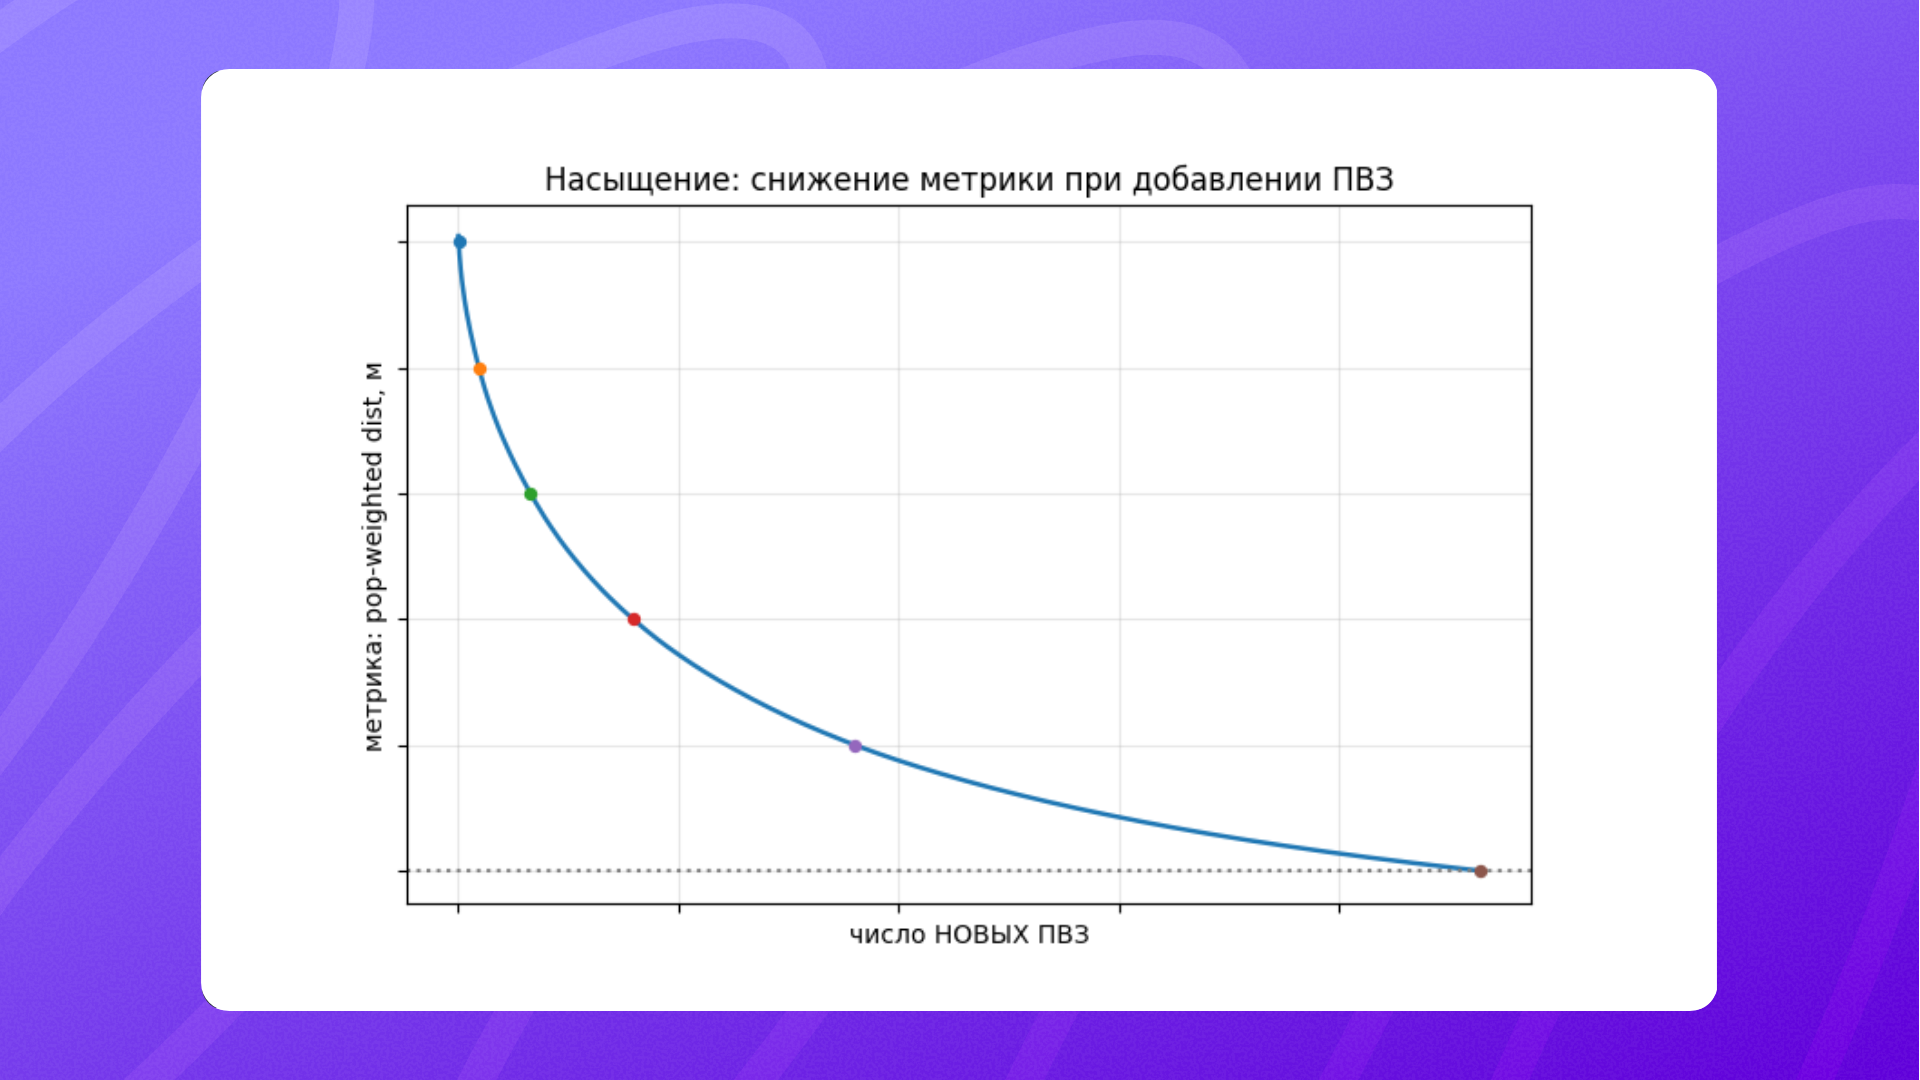
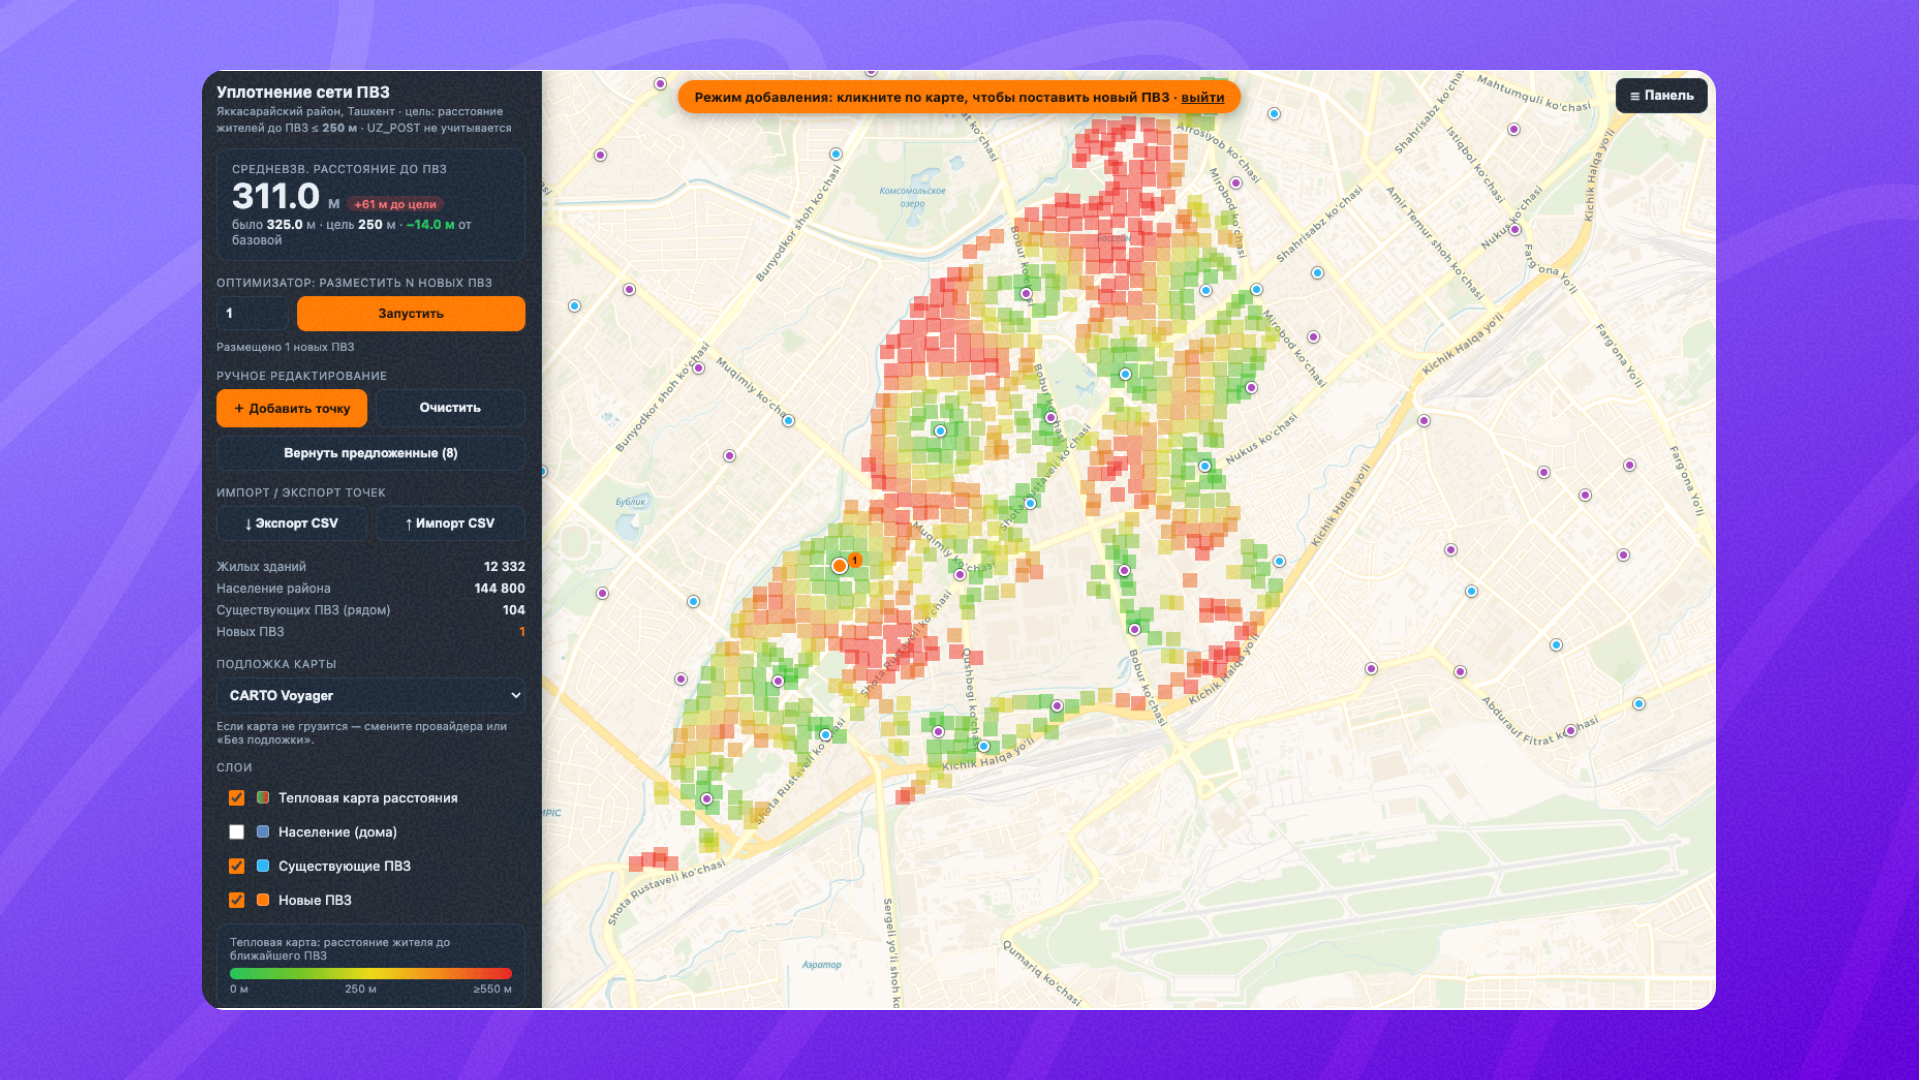
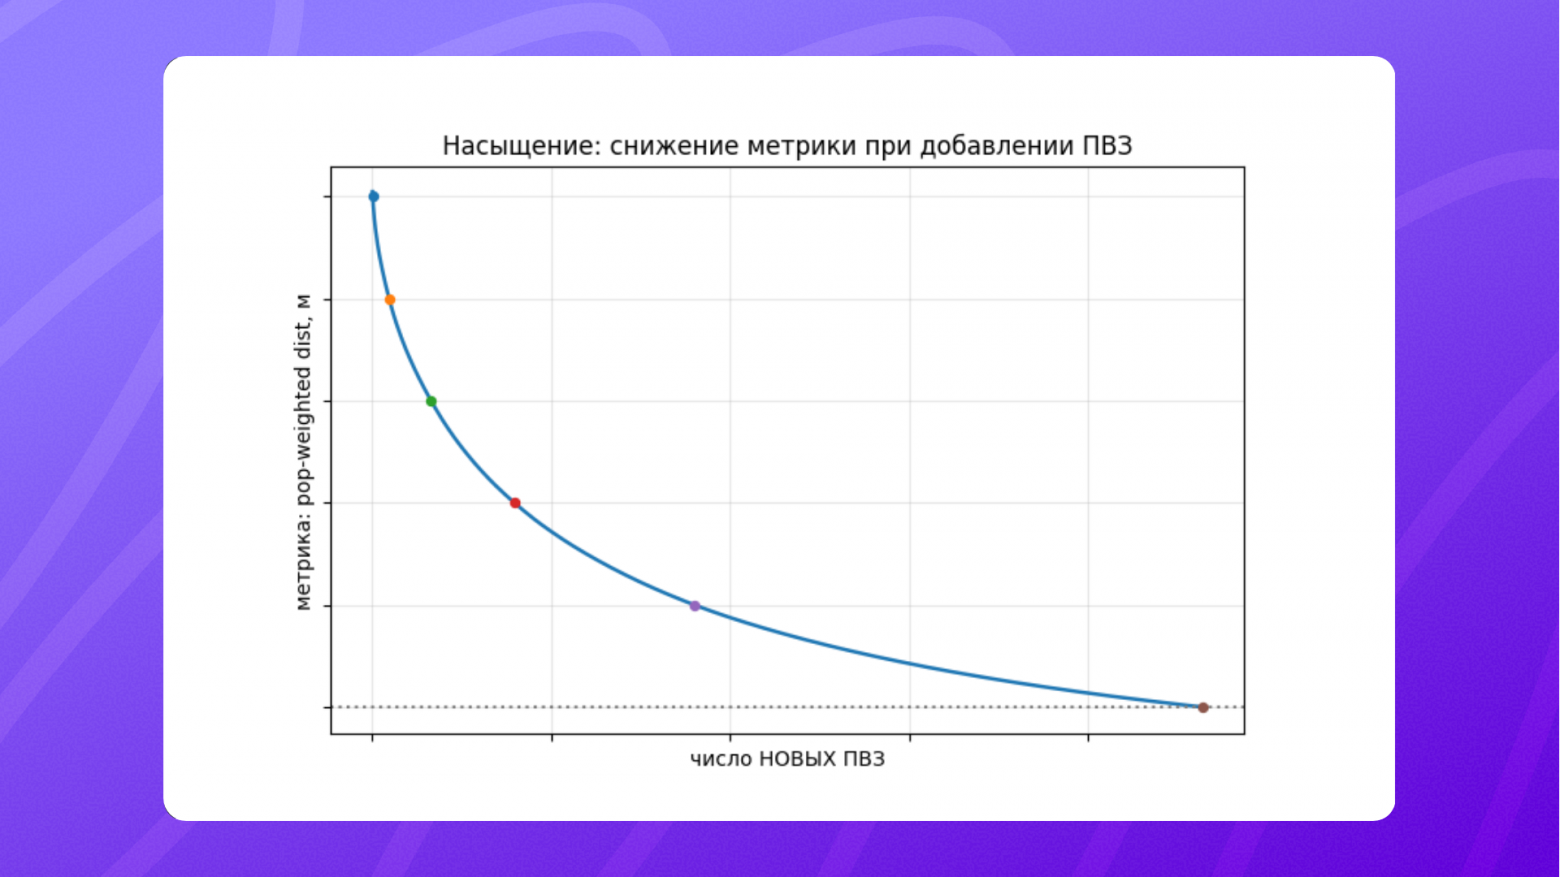
Для стратегического планирования развития сети применяется метрика средневзвешенного расстояния от жителей до ближайшего активного пункта выдачи заказов. Дискретная задача размещения решается с помощью жадной эвристики, которая на каждом шаге выбирает точку с максимальным приростом доступности. Чтобы избежать излишне оптимистичных оценок для точек, попавших в одну ячейку со зданием, вводится минимальное ограничение расстояния.
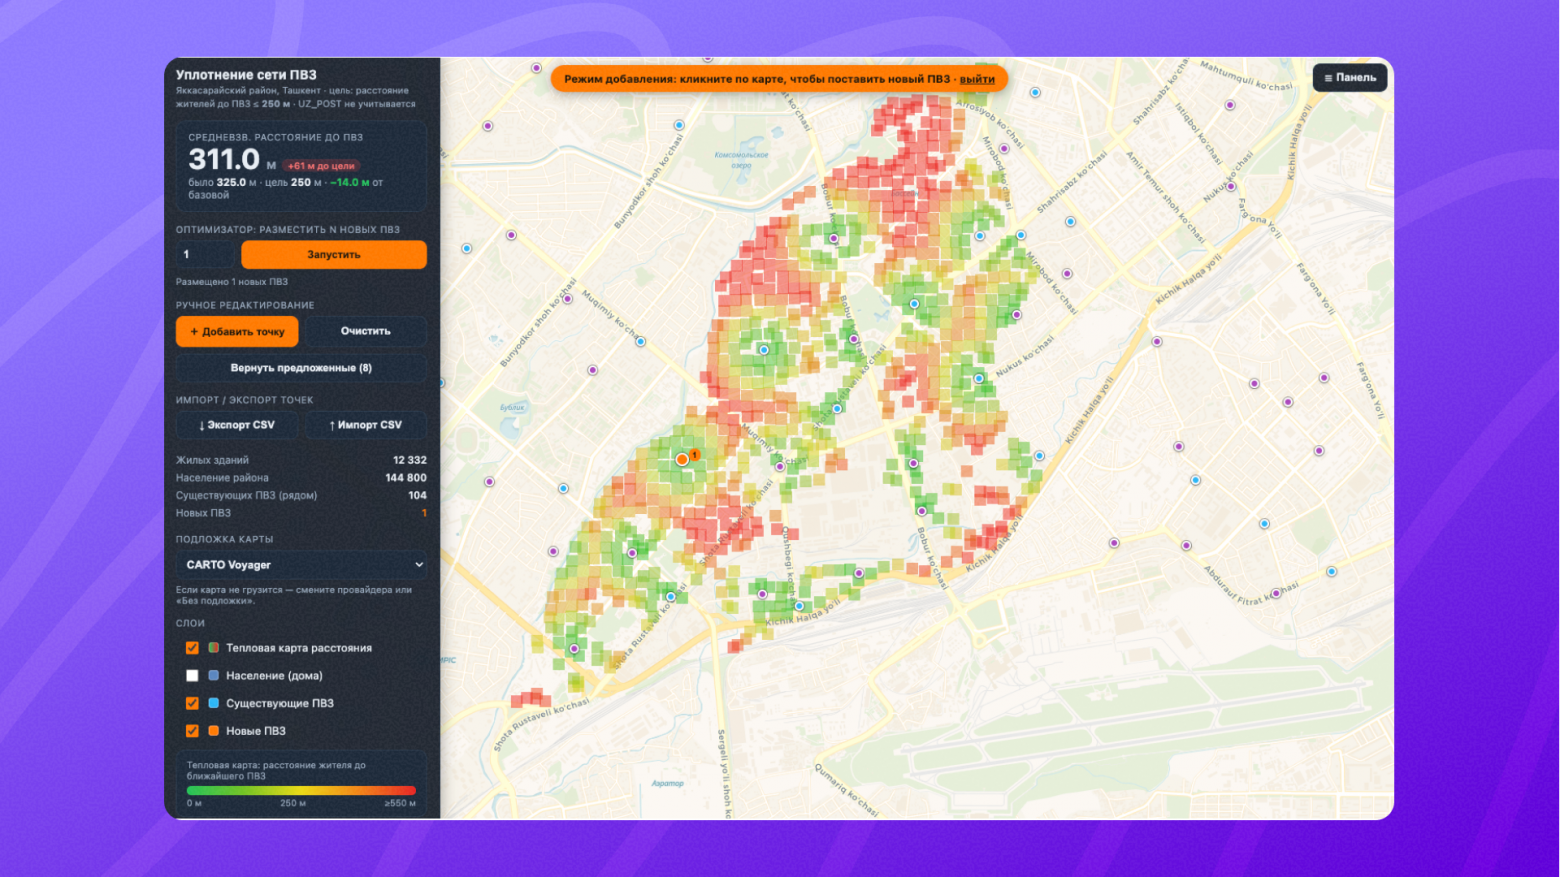
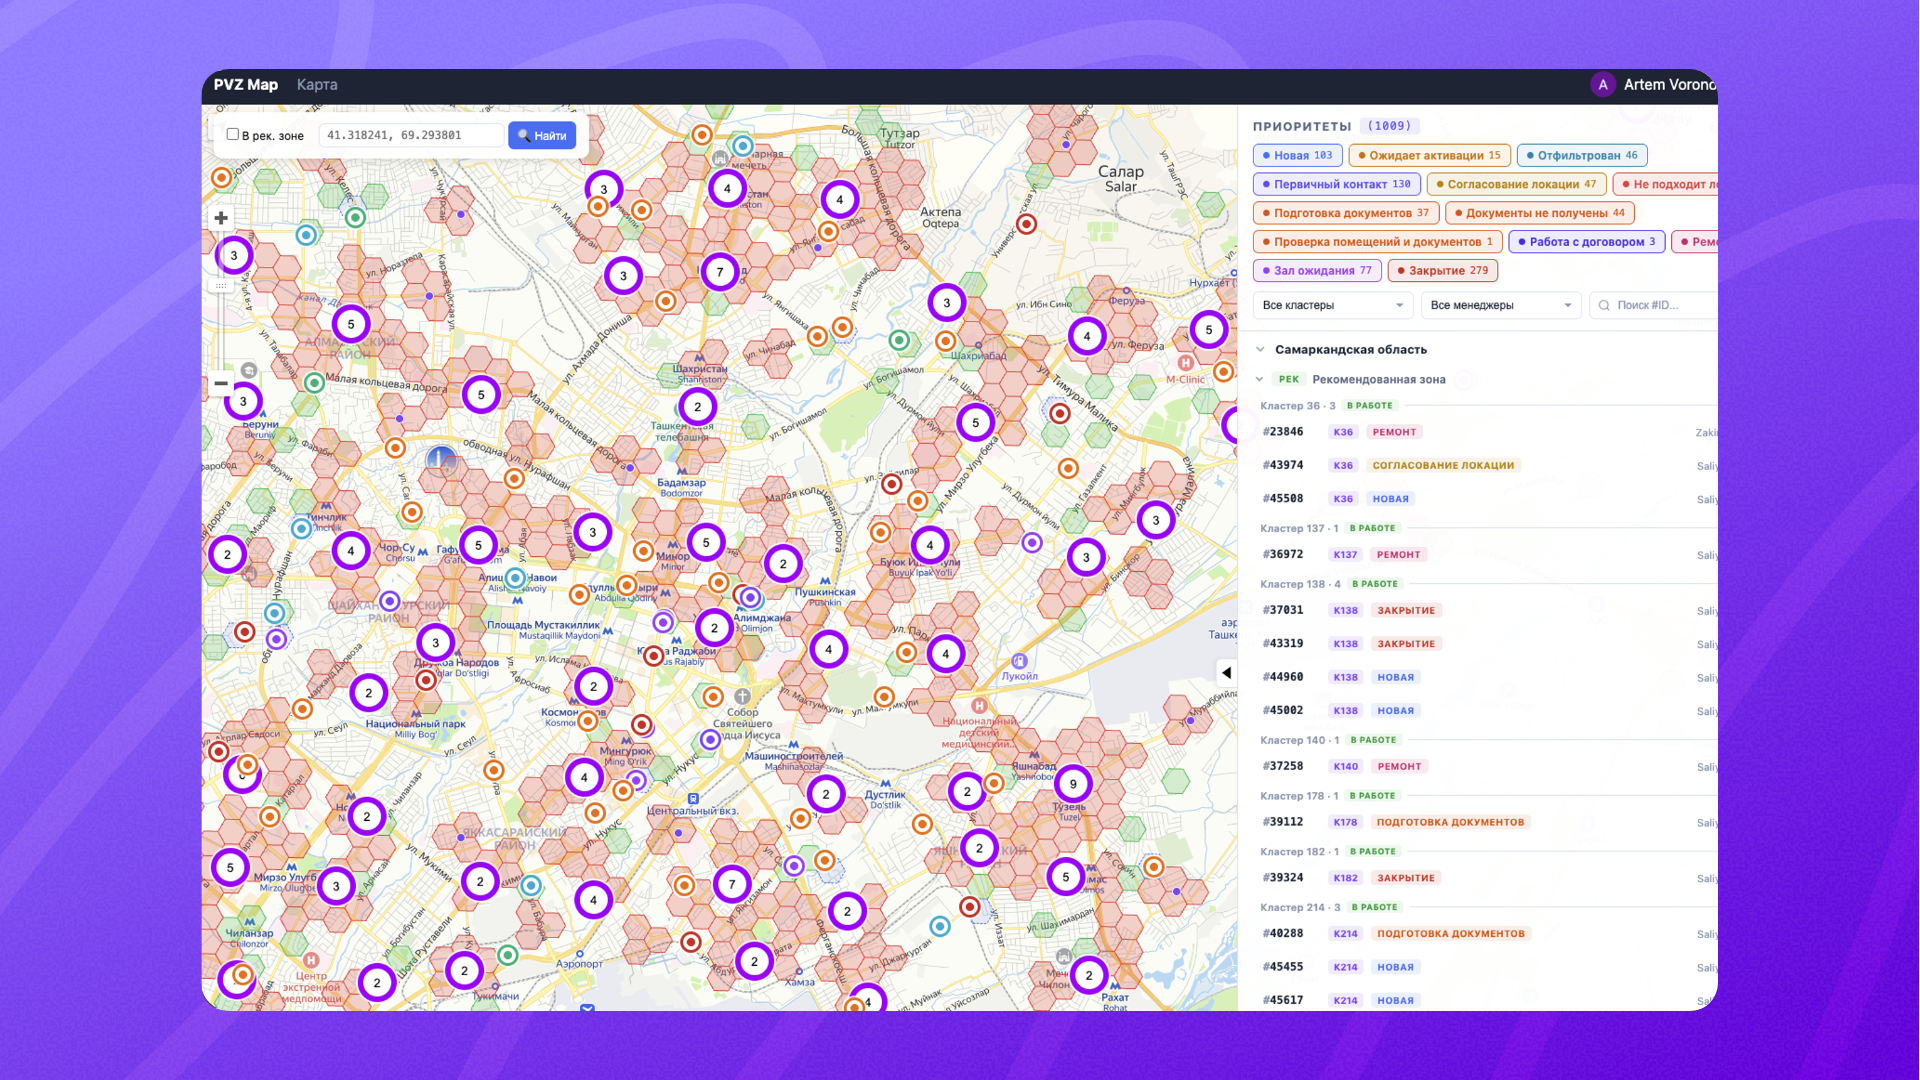
Созданный интерактивный инструмент позволяет проводить what-if-сценарии: вручную добавлять, удалять или сдвигать координаты предлагаемых точек, мгновенно пересчитывая показатели доступности для каждого из районов города. Подошвенная модель распределения населения по сотням тысяч зданий Ташкента обеспечивает необходимую детализацию спроса даже в условиях неполноты данных об этажности построек.
