
Мой блог
Как создать self-hosted RAG-систему с агентом LangGraph и локальными LLM

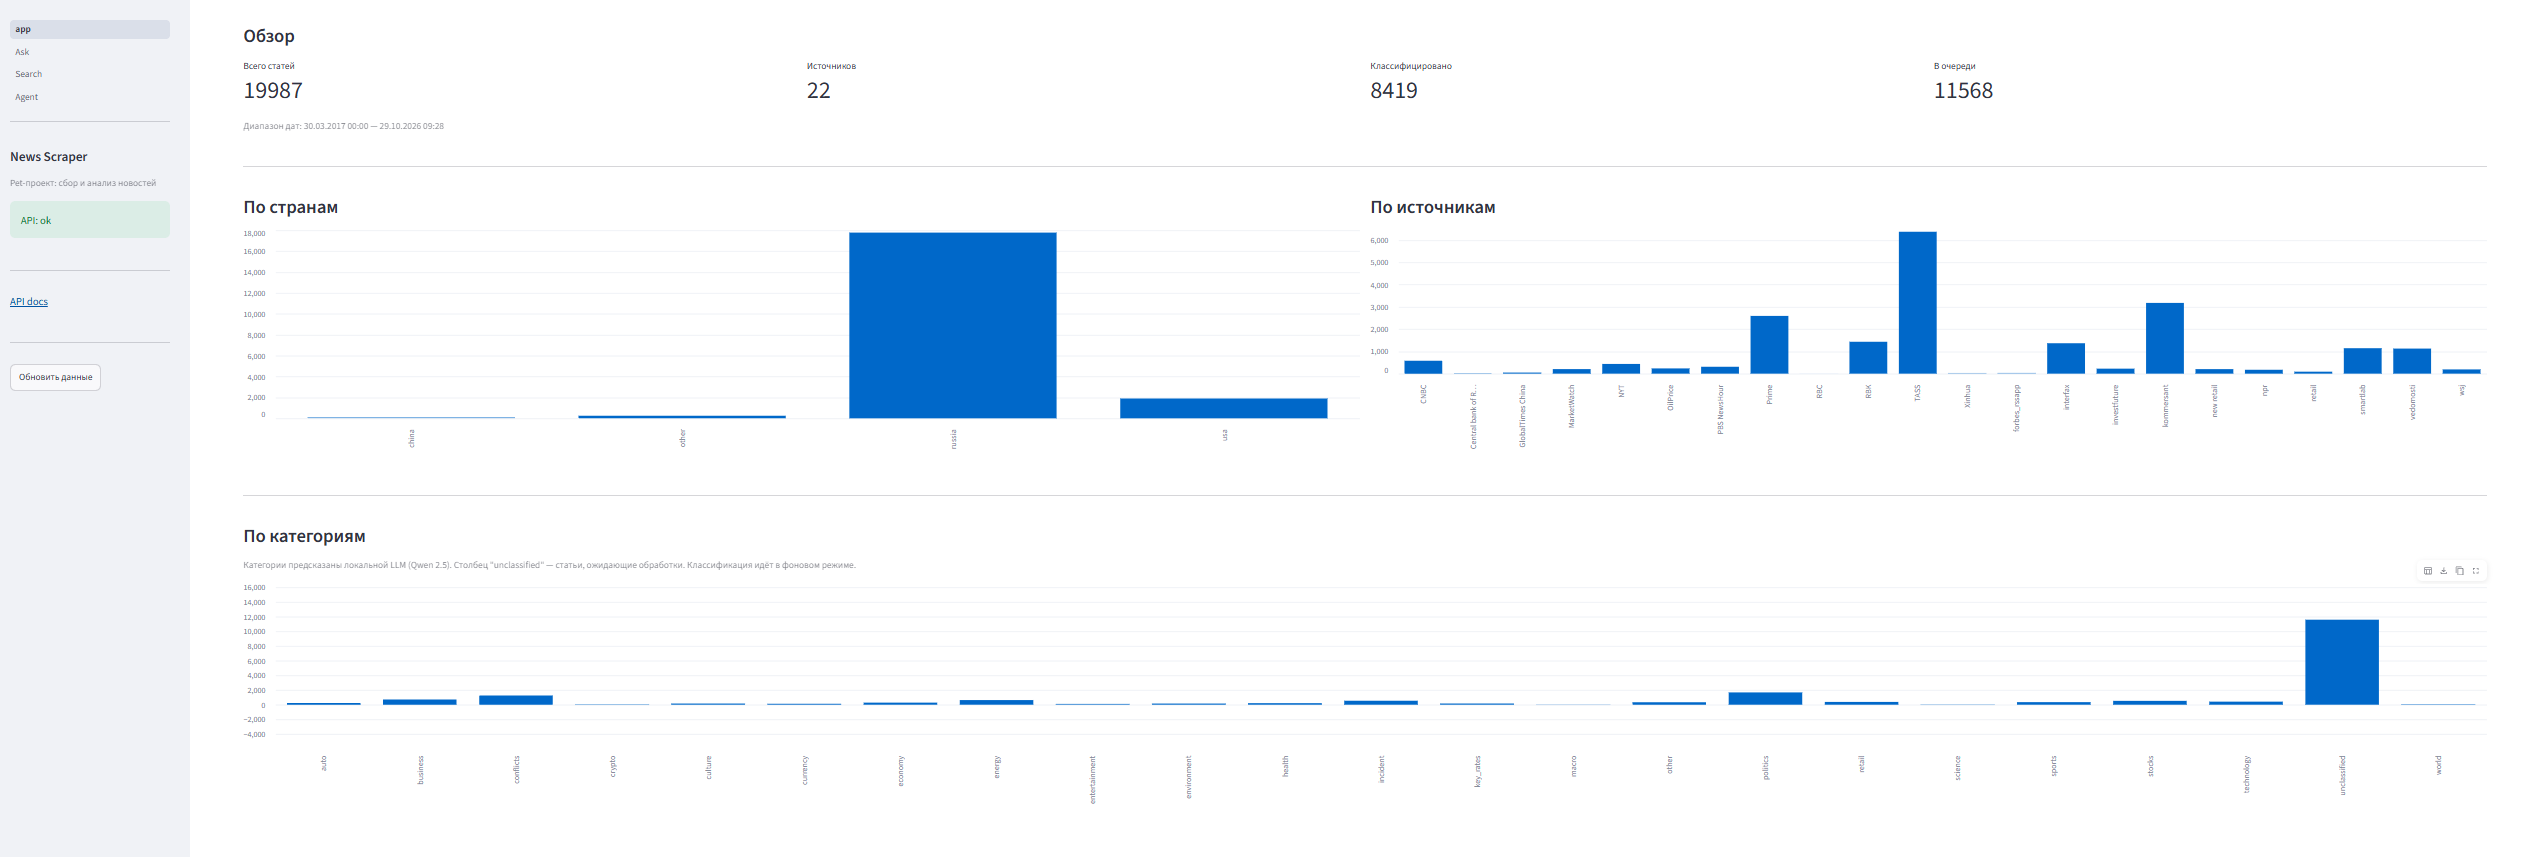
Разработка автономных информационных решений часто упирается в использование облачных API и управляемых баз данных. Однако для независимости от сторонних провайдеров создается self-hosted RAG-система, работающая исключительно на локальном программном обеспечении и моделях.
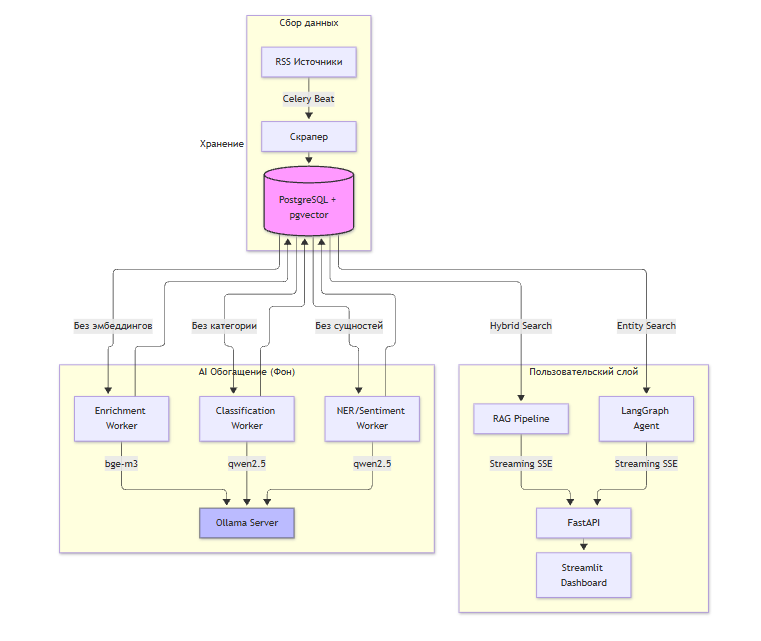
В данном материале рассматриваются архитектурные подходы, выбор инструментов и инженерные решения, позволившие развернуть полностью автономный конвейер — от парсинга RSS-лент до умных агентов с вызовом функций. Используемый стек включает Python 3.12, FastAPI, PostgreSQL с расширением pgvector, Celery, LangGraph, Ollama (Qwen 2.5 14B и BGE-M3), Streamlit, Langfuse и Docker.
Архитектура проекта
Программный комплекс разделен на изолированные слои: domain, db, scraper, rag, agents и api. Ключевым принципом проектирования выступает полная изоляция доменной логики от сторонних фреймворков. Подобное разделение дает возможность беспрепятственно заменять используемые языковые модели или библиотеки, не затрагивая при этом базовые бизнес-процессы.
Оптимизация поиска информации
На этапе первичной индексации более 12 000 статей были преобразованы в векторные эмбеддинги с помощью модели BGE-M3, после чего выполнялся поиск по косинусному расстоянию. Хотя простые запросы отрабатывали корректно, сложные формулировки приводили к появлению нерелевантных результатов из-за семантической омонимии. Например, запрос со словом «золото» возвращал материалы о спортивных победах фигуристов вместо финансовых новостей о котировках драгоценного металла.
Для устранения этой проблемы был внедрен гибридный поиск (Hybrid Search). Он объединяет семантический векторный поиск с точным лексическим поиском BM25 на базе PostgreSQL tsvector через алгоритм ранжирования RRF (Reciprocal Rank Fusion). Лексический поиск успешно находит специфические термины вроде точных названий или индексов, в то время как векторы отвечают за синонимы, что позволило существенно повысить показатель качества поиска Recall@5.
Классификация контента и решение проблемы категории Other
Первоначальные попытки классифицировать массив собранных документов с помощью языковой модели столкнулись с масштабным сбоем: около 74 процентов статей попадали в категорию other, поскольку модель стремилась перестраховаться при определении рубрики.
Ситуация была исправлена путем доработки текстовых промптов. В системные инструкции добавили детальные описания каждой категории (включая retail, macro и incident), а также убрали инструкцию использовать неопределенную категорию при сомнениях. В результате объем нераспознанных материалов снизился до 0.03 процента, сформировав структурированный датасет. Дополнительная ручная проверка случайной выборки документов подтвердила общую точность автоматической разметки на уровне 85 процентов.
LangGraph: агент для аналитических задач
Для перехода от простого извлечения текстов к глубокой аналитике была спроектирована конечная автомат-машина (State Machine) на базе библиотеки LangGraph. Агент получил в свое распоряжение три специализированных инструмента:
- search_articles для классического гибридного поиска по базе документов;
- get_metrics для выполнения SQL-агрегаций (например, подсчета публикаций по энергетике за определенный период);
- search_by_entity для извлечения имен упоминаемых компаний, оценки тональности и поиска по сущностям (NER/Sentiment).
Благодаря такому набору инструментов при поступлении комплексного запроса агент самостоятельно определяет, какой именно метод необходимо вызвать для формирования ответа.
Наблюдаемость и отладка процессов
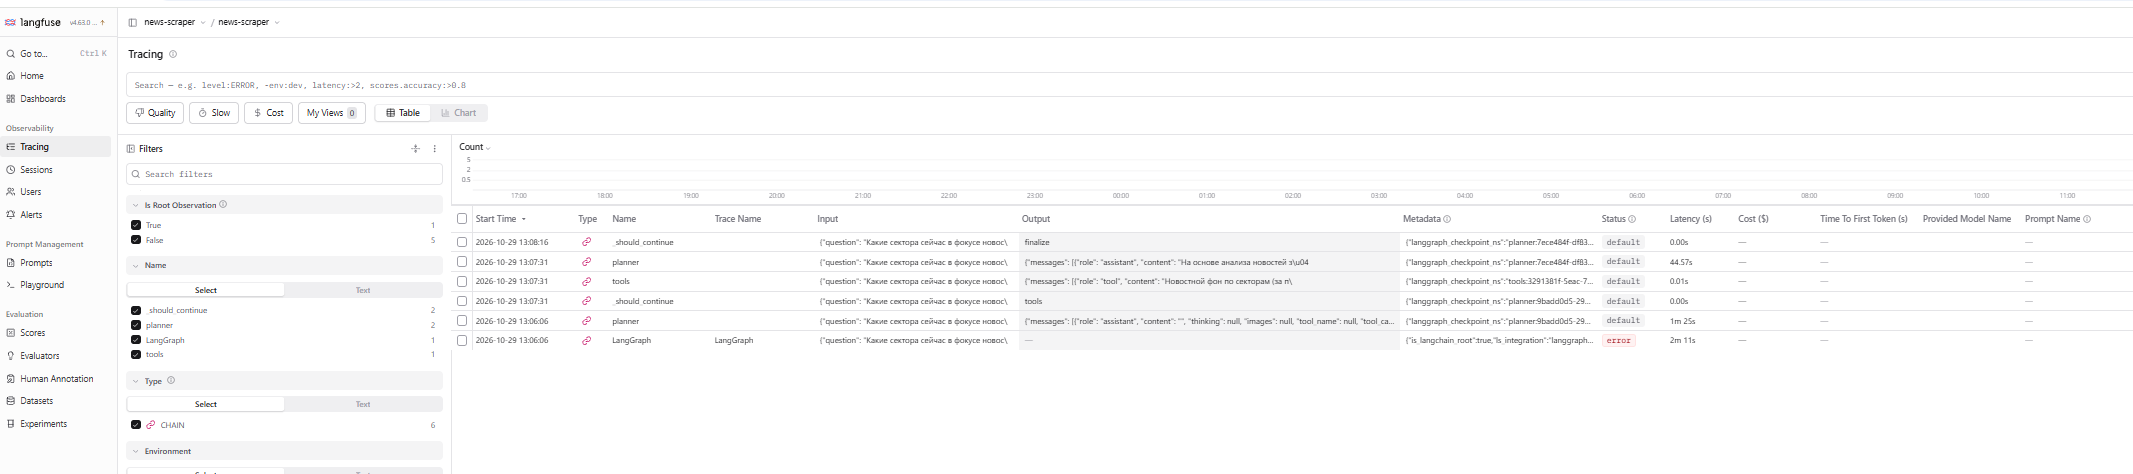
Для контроля над выполнением фоновых задач в инфраструктуре развернута система self-hosted Langfuse. Она фиксирует каждый этап работы агента — от планировщика до вызова инструментов и финальной генерации, отслеживая расход токенов и переданные аргументы, что критически важно для анализа ошибок.
Технические сложности и способы их решения
В процессе сборки и запуска инфраструктуры разработчики столкнулись с рядом неочевидных инженерных проблем и успешно их преодолели:
- VRAM Ping-Pong: локальный сервер Ollama выгружал модели из памяти при переключении, из-за чего обработка одного запроса затягивалась до минуты. Проблема решилась ограничением количества одновременно загруженных моделей через переменную окружения OLLAMA_MAX_LOADED_MODELS=2.
- Накладные расходы LangChain: использование ChatOllama со встроенной потоковой агрегацией приводило к девятикратному замедлению пайплайна. Отказ от LangChain в пользу прямого использования ollama.AsyncClient устранил этот недостаток.
- Конфликты Celery и Async: асинхронные пулы соединений SQLAlchemy привязывались к конкретным циклам событий, и после принудительного завершения задач воркерами Celery соединения зависали. Корректное закрытие пула через вызов await engine.dispose() после каждой фоновой задачи полностью стабилизировало работу с базой данных.
- Параллелизация запросов: последовательная обработка классификации статей занимала около 10 секунд на документ. Увеличение параметра OLLAMA_NUM_PARALLEL с 1 до 2 позволило ускорить процедуру обработки более чем в полтора раза.
Дальнейшее развитие проекта
В текущий момент программный продукт реализован в статусе Public MVP и демонстрирует возможности построения подобных систем на локальных ресурсах. Следующим этапом запланирован переход к персональной биржевой аналитике, предусматривающий привязку обрабатываемых новостей к тикерам Московской биржи, извлечение рыночных показателей и формирование прогнозных аналитических дашбордов. Исходный код проекта является открытым и опубликован на платформе GitHub.
Заключение
Создание готовой к эксплуатации искусственной среды на базе локальных моделей доказало свою практическую жизнеспособность. Такой подход обеспечивает максимальный уровень информационной безопасности, полный контроль над персональными данными и независимость от внешних поставщиков облачных услуг при полной контейнеризации инфраструктуры и ее автоматизированном тестировании.
