Тэг
LLM

Интеграция бэкенда transformers в vLLM достигла нативной скорости работы
Библиотека transformers теперь обеспечивает нативную скорость инференса в vLLM для сложных моделей благодаря динамической оптимизации графов и слиянию операторов на лету.
Читать далее
Google DeepMind представила Gemini 3.8 Flash и 3.8 Flash Cyber: одна модель, два уровня доступа
Google DeepMind представила Gemini 3.8 Flash и закрытую версию Flash Cyber. Подробный разбор характеристик, бенчмарков, изменений в API и условий доступа.
Читать далее
Тестируем DFlash от Nvidia: почему вместо обещанных 15x мы получаем 2,3x и когда технология бесполезна
Провел детальное тестирование технологии DFlash от Nvidia на видеокарте RTX 6000 PRO. Разбираем, почему вместо обещанного 15-кратного ускорения LLM получается 2,3x при одиночном запросе и просадка при батчинге.
Читать далее
Обзор мини-ПК FEVM на Ryzen AI Max+ 395: 128 ГБ объединённой памяти для локальных ИИ-моделей
Разбор мини-ПК FEVM на AMD Ryzen AI Max+ 395 со 128 ГБ памяти LPDDR5X-8000: производительность в LLM, скорость работы в llama.cpp, охлаждение и экономика покупки.
Читать далее
Как метод BenchMIRT раскрывает реальные способности языковых моделей: аудит бенчмарков на уровне промптов
Разбираем новый метод BenchMIRT от Allen Institute for AI: как психометрика и многомерная IRT помогают проверять бенчмарки языковых моделей и точно измерять их реальные возможности.
Читать далее
Полный разбор ChatGPT Work: архитектура, встроенные инструменты и реальные отличия от Chat
Подробный разбор ChatGPT Work: чем облачная версия отличается от обычного чата, как устроены headless-браузер, сетевой Code Interpreter, хостинг ChatGPT Sites и какие риски безопасности это несёт.
Читать далее
Что такое агентный ИИ: как автономные системы планируют, используют инструменты и решают задачи
Подробный разбор концепции агентного ИИ (Agentic AI): принципы работы цикла планирования и действий, отличие от генеративных моделей, сферы применения и методы безопасного контроля.
Читать далее
Нейросеть Qwen 3.8 27B: обзор возможностей, проблемы с логикой и оптимизация скорости
Разбираем особенности новой модели Qwen 3.8 27B от Alibaba, ее склонность к избыточным размышлениям по умолчанию и способы ускорения работы на локальном железе.
Читать далее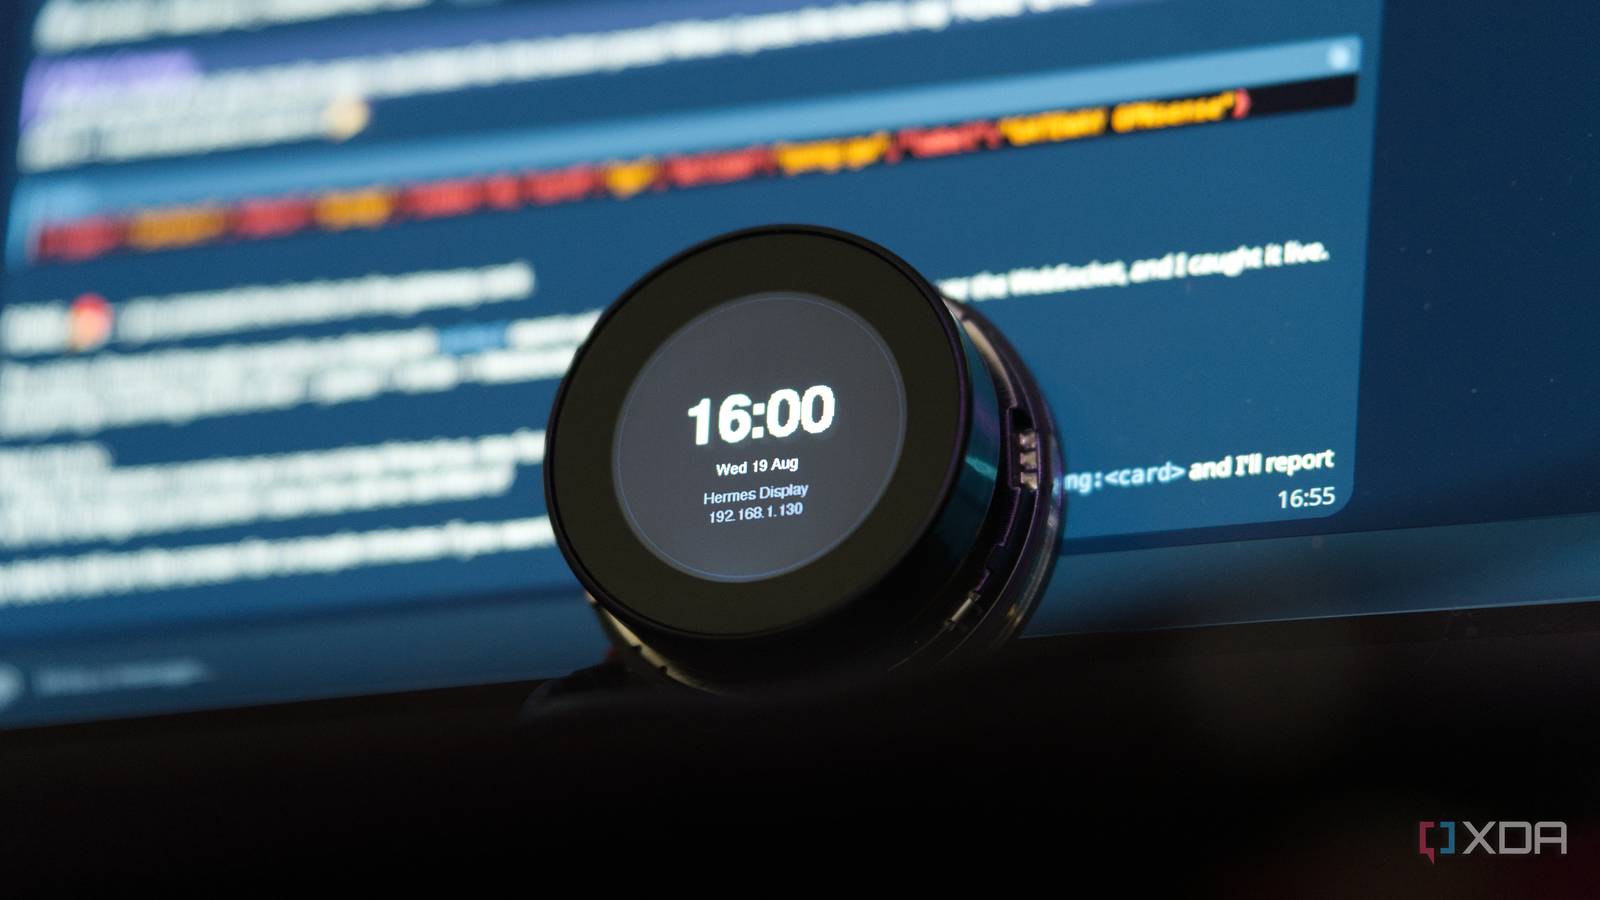
Как подружить локальную LLM с дешевым дисплеем ESP32: интерактивный экран для каждого вопроса
Автор проекта подключил локальную языковую модель к компактному круглому дисплею ESP32 за 30 долларов, научив ее самостоятельно генерировать интерфейс под каждый пользовательский запрос.
Читать далее
Модель Qwen 3.8 27B: возможности локального запуска, избыточные рассуждения и методы ускорения
Обзор открытой языковой модели Qwen 3.8 27B с поддержкой работы с изображениями. Оцениваем её производительность на потребительском «железе», проблему избыточных рассуждений по умолчанию и способы оптимизации.
Читать далее