Тэг
Машинное обучение

Дообучение языковой модели для структурированного вывода за 100 шагов GRPO
Разбор процесса эффективного дообучения компактной языковой модели с помощью алгоритма GRPO для стабильного получения структурированных JSON-ответов.
Читать далее
Разбор DeepSeek R1: как китайская нейросеть изменила рынок искусственного интеллекта
Разбор технологии и экономики DeepSeek R1: как архитектуры MLA, MoE и оптимизация на уровне PTX позволили создать топовую языковую модель и изменить рынок AI.
Читать далее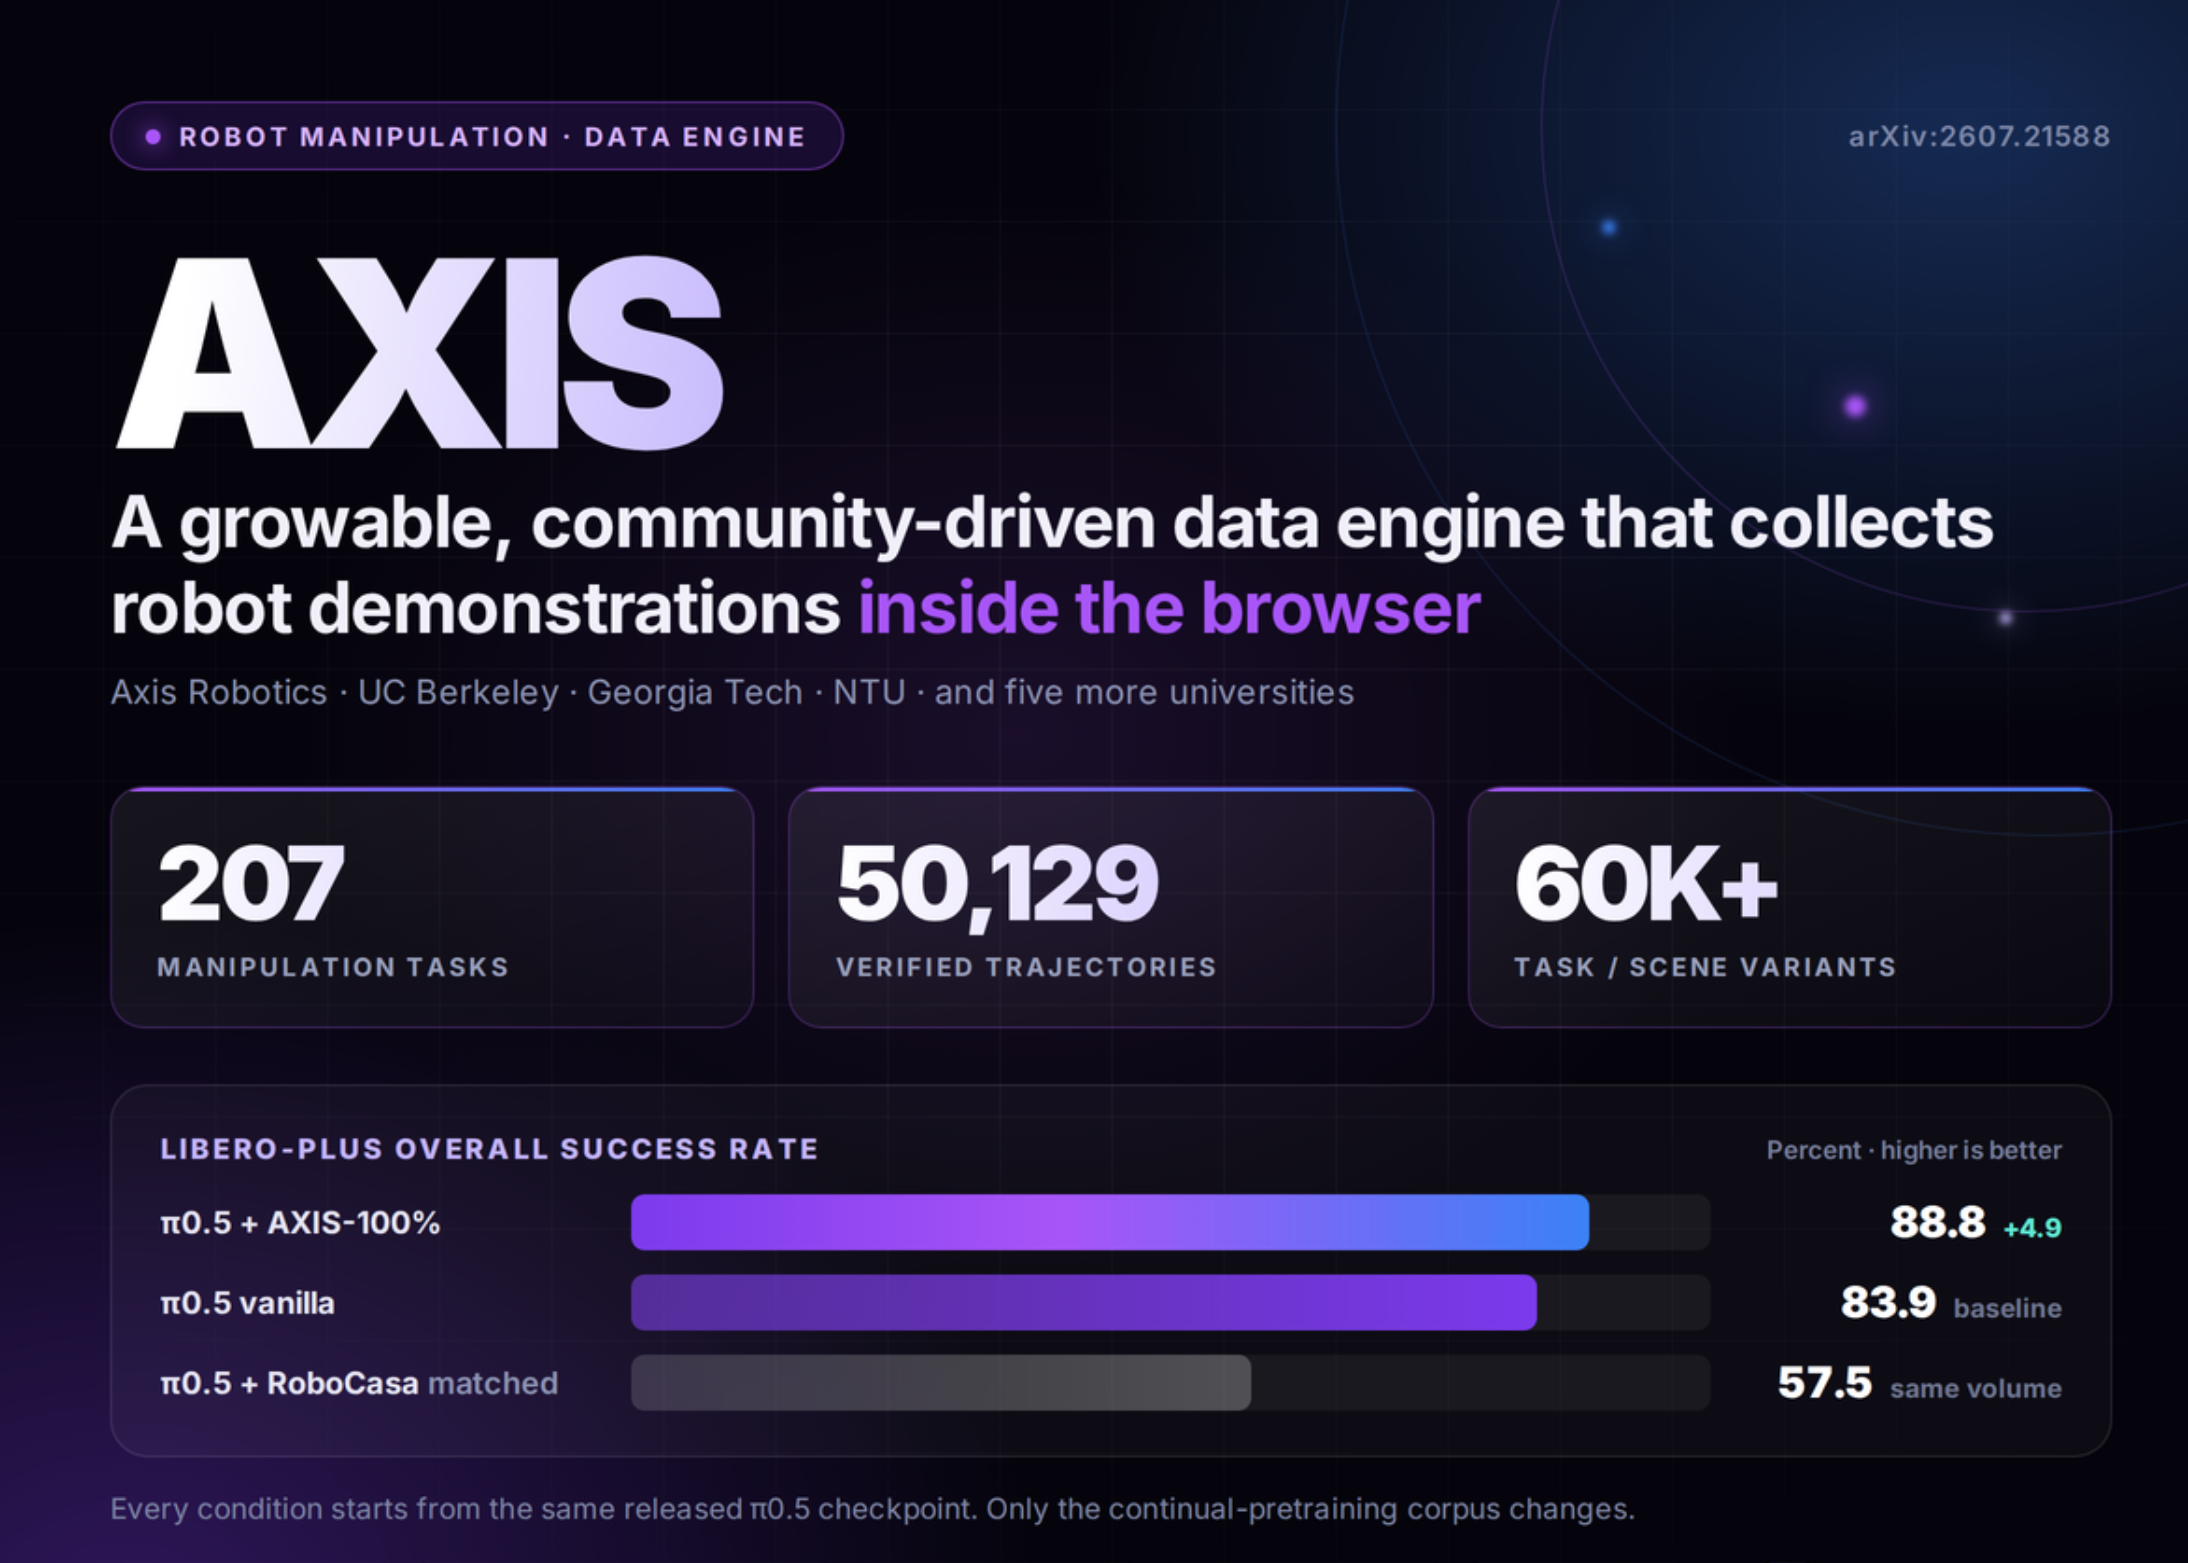
Движок AXIS от Axis Robotics: сбор данных для роботов прямо в браузере
Axis Robotics представила AXIS — браузерный движок для сбора траекторий роботов с использованием MuJoCo WebAssembly и IsaacSim. Разбираем архитектуру платформы и результаты обучения моделей.
Читать далее
Что такое базовые модели ИИ: принципы устройства, 5 этапов работы и правила внедрения
Разбираем устройство базовых моделей (Foundation Models) в ИИ: 5 этапов жизненного цикла, способы тонкой настройки, сравнение с узкими моделями и методы безопасного внедрения в продакшен.
Читать далее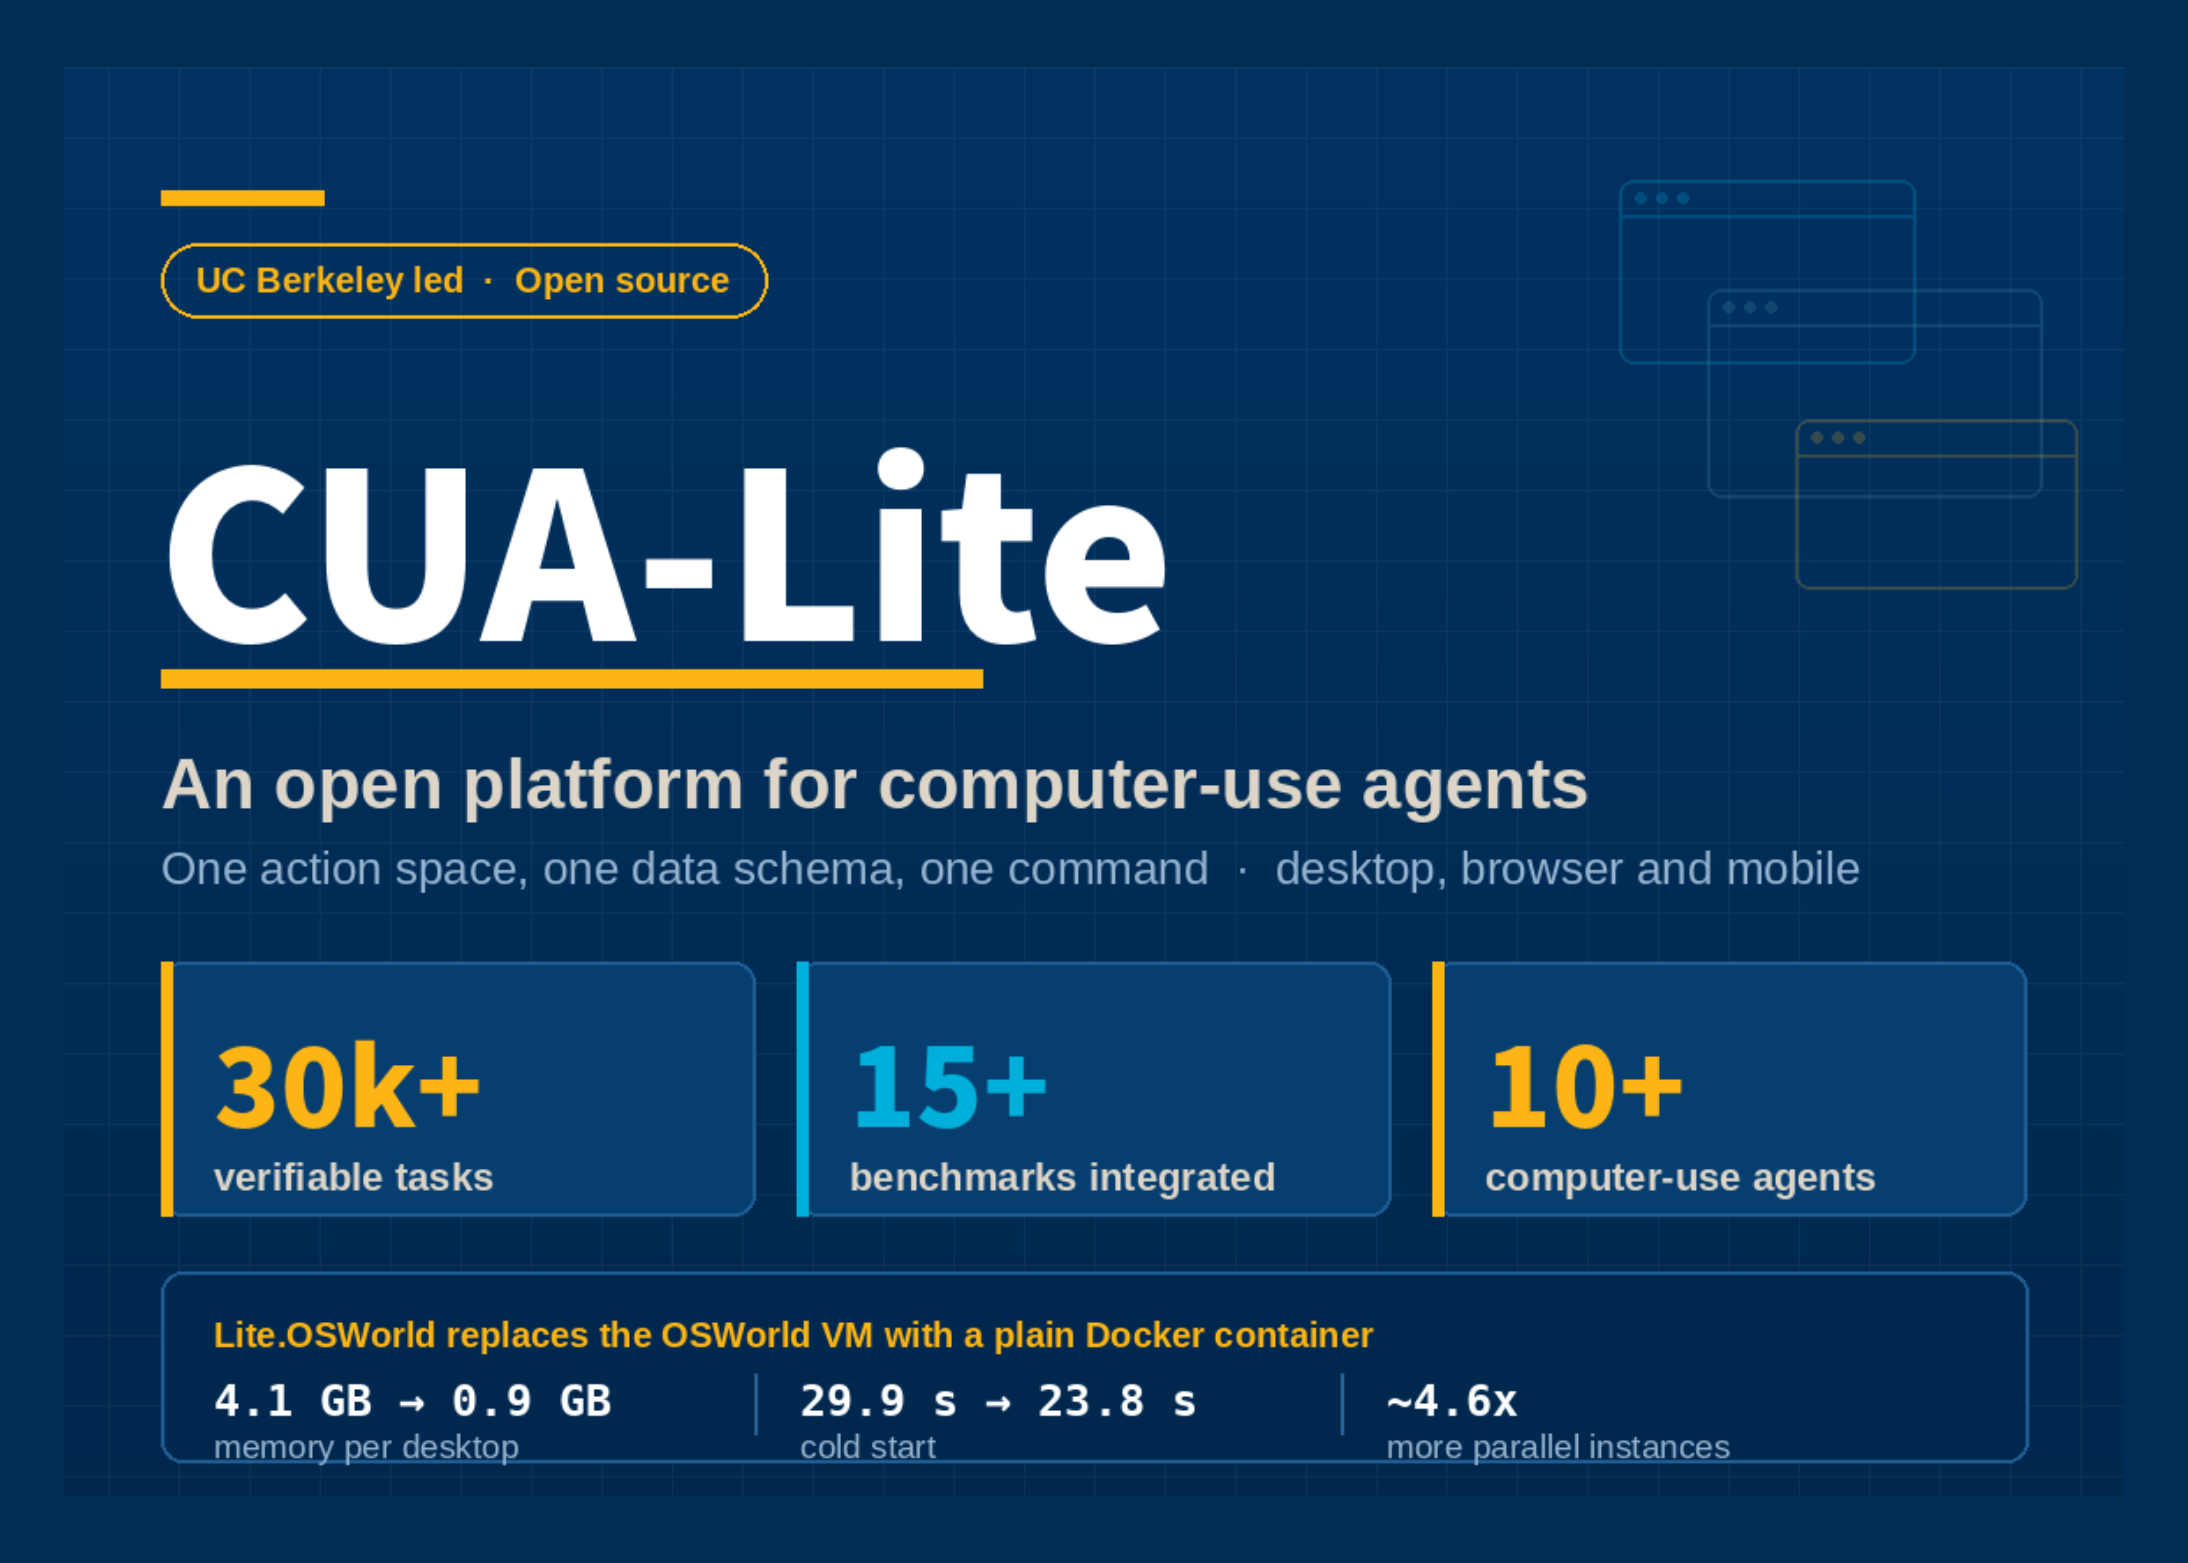
Обзор CUA-Lite: открытая платформа UC Berkeley для обучения и оценки ИИ-агентов
Исследователи из UC Berkeley представили открытую платформу CUA-Lite, которая объединяет среды, данные и обучение AI-агентов в Docker без использования виртуальных машин QEMU/KVM.
Читать далее
Почему идеальный датасет без ошибок может навредить нейросети: парадоксы машинного обучения
Разбираемся, почему абсолютная чистота датасета не гарантирует качественную работу нейросети и как контролируемый шум помогает ИИ избегать переобучения.
Читать далее
Как работают автономные ИИ-агенты: архитектурный разбор модели, инструментов, памяти и цикла управления
Подробный архитектурный разбор автономных ИИ-агентов: как взаимодействуют модель, инструкции, инструменты, память и цикл управления, и как проектировать надежные агентированные системы.
Читать далее
Подготовка датасета для офлайн-оценки рекомендательных моделей: практическое руководство и аудит с SplitLight
Полный разбор нюансов предобработки и временного разбиения данных при обучении рекомендательных алгоритмов. Практический чек-лист и обзор возможностей утилиты SplitLight.
Читать далее
LLM зацикливается в продакшене: как локализовать петлю повтора без слепой смены параметров
Полный разбор причин зацикливания LLM в продакшене: почему слепое увеличение repetition_penalty вредит системе, как работать с vLLM, анализировать logprobs и оптимизировать промпты.
Читать далее
Интеграция бэкенда transformers в vLLM достигла нативной скорости работы
Библиотека transformers теперь обеспечивает нативную скорость инференса в vLLM для сложных моделей благодаря динамической оптимизации графов и слиянию операторов на лету.
Читать далее