
Мой блог
Alibaba представила Qwen3.8-LiveTranslate: нейросеть для синхронного перевода с задержкой 2,3 секунды

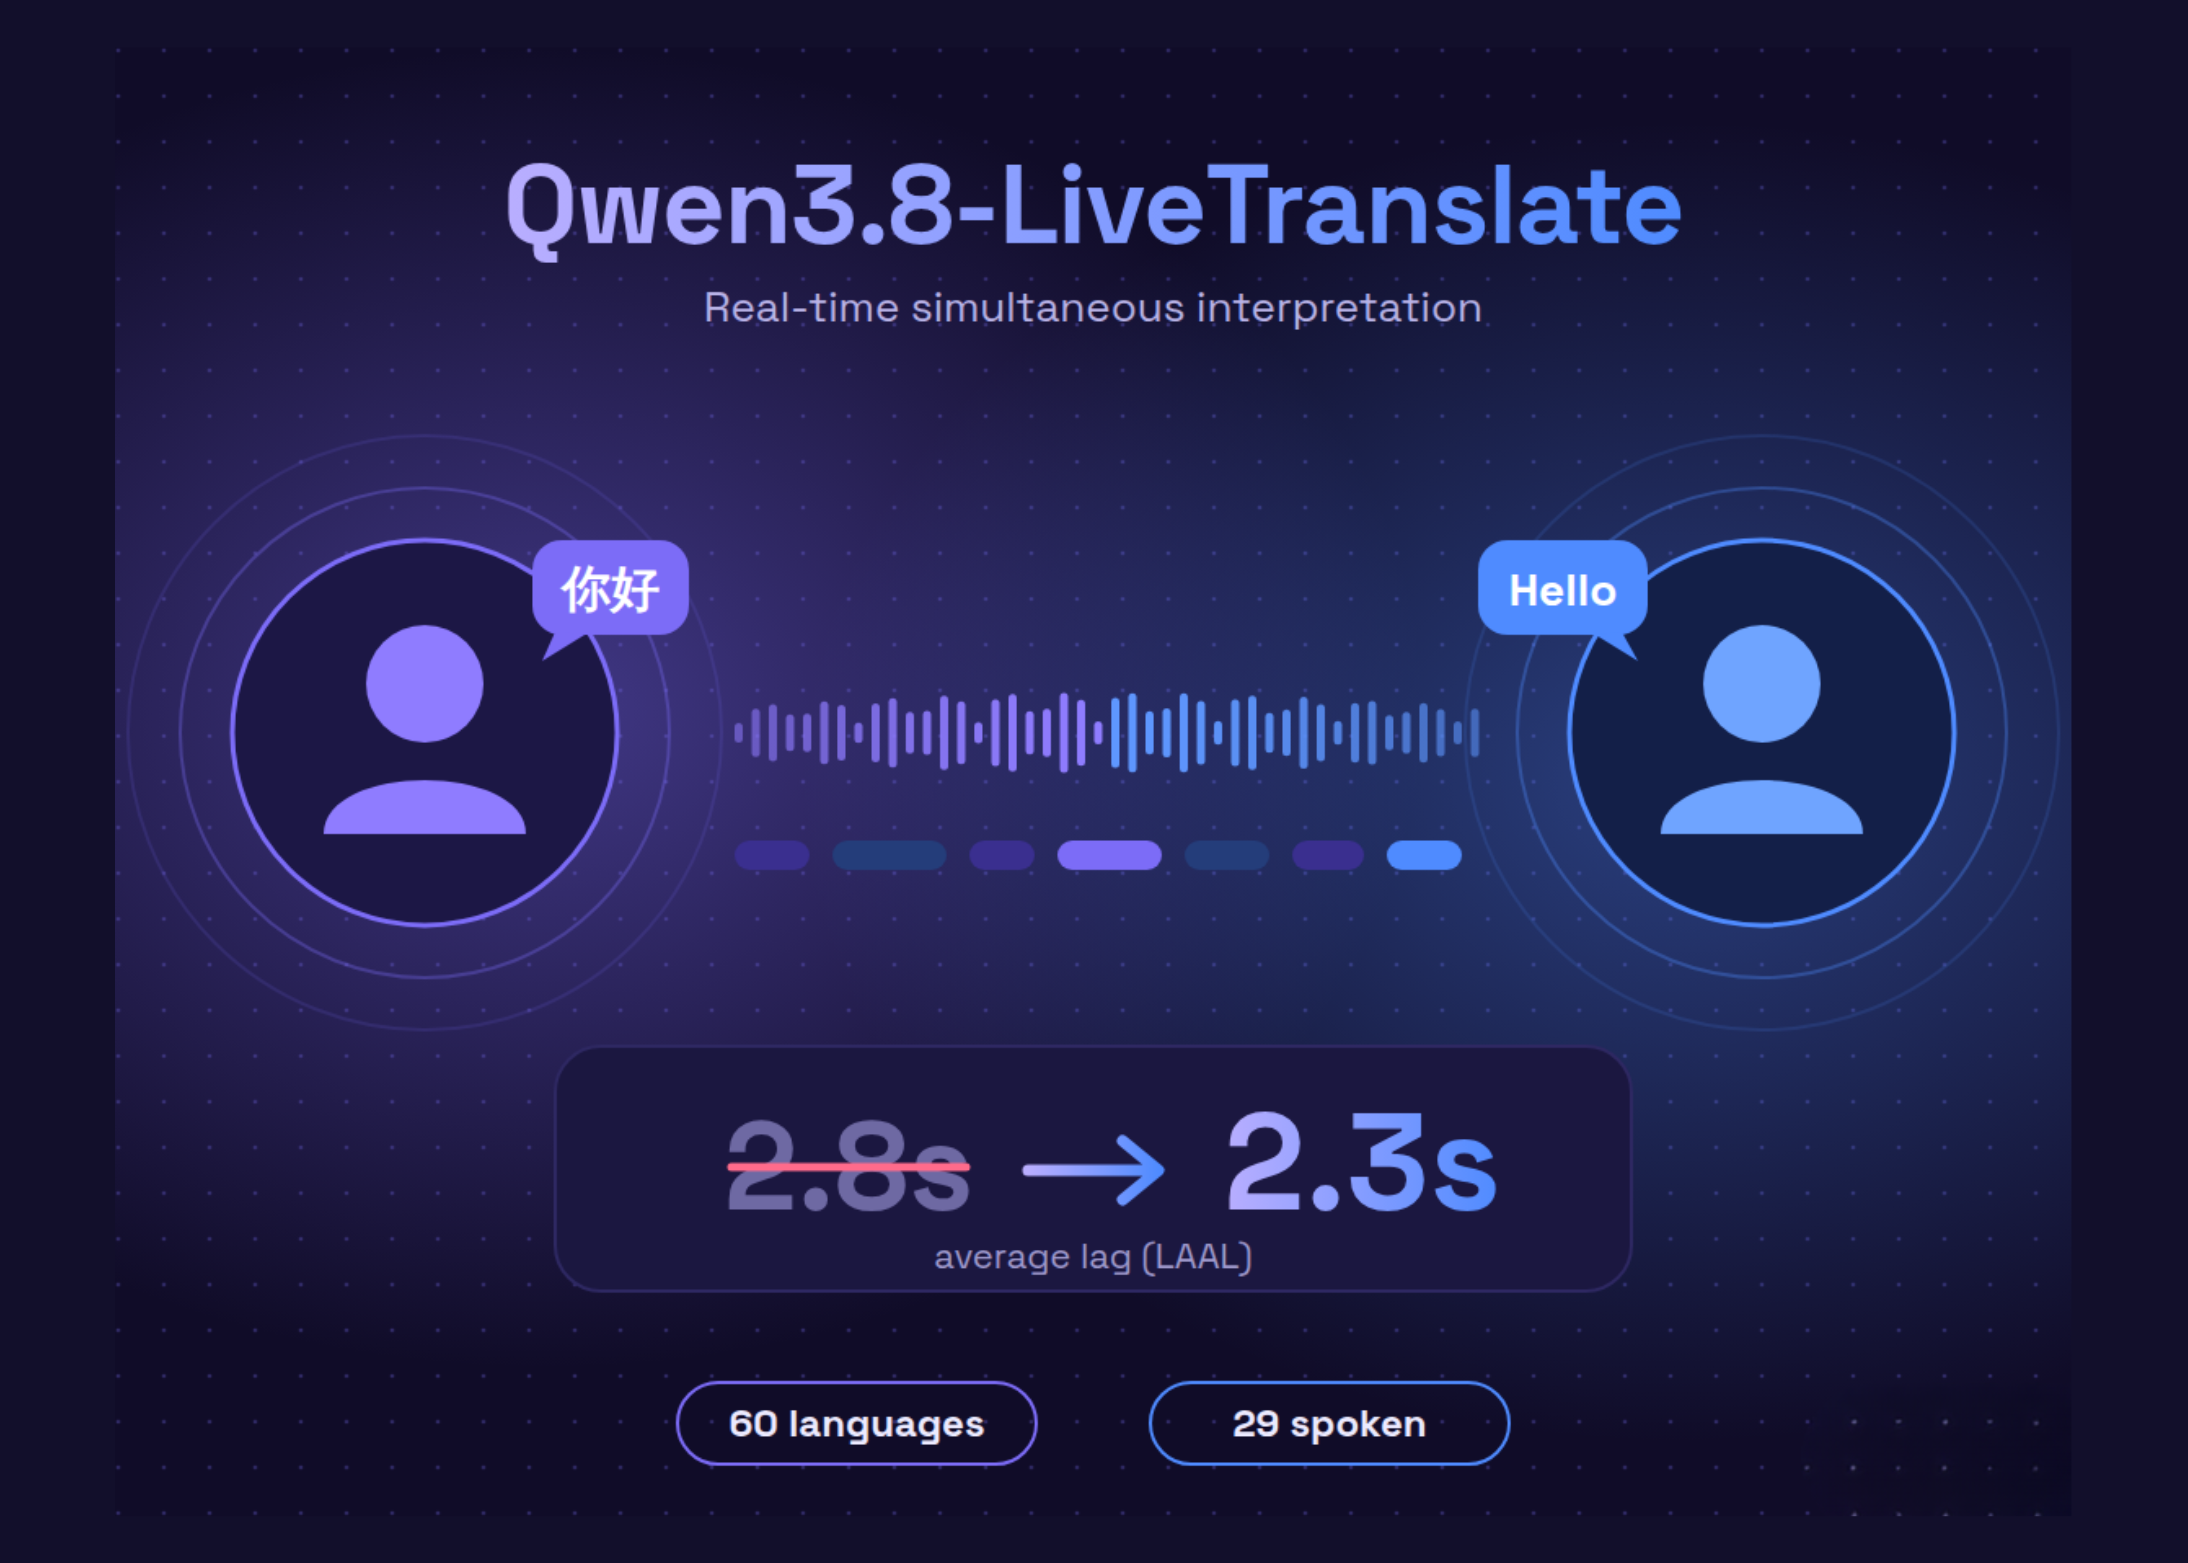
Команда Alibaba Cloud анонсировала масштабное обновление своего стека мультимодальных нейросетей: команда разработчиков Qwen представила специализированную модель Qwen3.8-LiveTranslate. Это решение предназначено для полноценного синхронного перевода речи в реальном времени. Модель способна слушать входной аудиопоток, считывать параллельный видеоряд и генерировать переведенный текст вместе с огласовкой прямо во время выступления спикера, не дожидаясь завершения фраз.
Архитектурно новая модель опирается на принцип сменяемого потока (Interleave architecture), что позволило существенно улучшить качество перевода по показателям точности, естественности и лаконичности. Среднее отставание перевода от оригинала снизилось с 2,8 до 2,3 секунды. Модель уже доступна в виде облачного API через протокол WebSocket на платформах Alibaba Cloud Model Studio и QwenCloud под идентификатором qwen3.8-livetranslate-flash-realtime.
Что изменилось в архитектуре модели
Синхронный перевод всегда требует поиска компромисса между задержкой и качеством. Если модель слишком долго ждет окончания фразы, она получает больше контекста и делает перевод точнее, но слушатель сталкивается с некомфортной паузой. Если же система начинает говорить слишком рано, повышается риск ошибок и домысливания. В Qwen3.8-LiveTranslate этот баланс пересмотрели с помощью архитектуры Interleave.
Главной метрикой оценки задержки в этой модели выступает LAAL (Length-Adaptive Average Lagging) — адаптивный показатель среднего отставания перевода от исходной речи, который учитывает длительность произнесения и предотвращает искусственное «завышение» оценок у систем с избыточной генерацией. Сокращение LAAL с 2,8 до 2,3 секунды означает снижение задержки примерно на 18%, что критически важно для живого общения.
С технической точки зрения Qwen3.8-LiveTranslate является потоковой версией офлайн-модели Qwen3.8-LiveTranslate-Flash. Она построена на базе стека Qwen-Omni, использует масштабные мультимодальные обучающие данные, механизмы межъязыкового и межмодального выравнивания, а также алгоритмы визуального усиления. К слову, исходная модификация Flash сохраняет возможность автономной обработки предзаписанных аудио- и видеофайлов.
Три ключевые новые функции
В релизе Qwen3.8-LiveTranslate инженеры выделили три основных технологических новшества, направленных на повышение удобства использования во время живых мероприятий и онлайн-встреч:
1. Разделение спикеров в реальном времени (Speaker Diarization). Модель умеет уверенно распознавать и разделять голоса нескольких участников диалога. При этом система сохраняет индивидуальность каждого спикера благодаря улучшенным алгоритмам клонирования голоса. В API предусмотрено несколько режимов клонирования, включая режим принудительного повторного клонирования перед каждым ответом, что идеально подходит для многопользовательских сессий.
2. Синхронный двухъязычный вывод (Bilingual Display). Модель способна одновременно транслировать как оригинальную расшифровку речи, так и ее перевод. В структуре API транскрипция исходного аудио передается отдельным потоком событий параллельно с переведенным текстом и синтезируемым звуком.
3. Учет контекста длительной беседы (Long-context Disambiguation). Модель анализирует всю предыдущую историю разговора для корректной интерпретации имен собственных, специфических терминов и сложных формулировок. Если редкое имя или узкоспециализированное понятие прозвучало в самом начале многочасового совещания, система сохранит его единообразный перевод до самого конца сессии.
Поддерживаемые языки, мультимодальный ввод и компьютерное зрение
Qwen3.8-LiveTranslate поддерживает распознавание речи и текста на 60 языках мира. При этом двусторонний аудиоперевод (вывод и текста, и синтезированного голоса) доступен для 29 языков, среди которых китайский, английский, арабский, немецкий, французский, испанский, японский, корейский, хинди и другие. Для остальных 31 языка генерируется только текстовый перевод.
Входными данными для модели могут служить не только аудиопотоки, но и графические кадры. Выходные данные включают текст и звук. Визуальный контекст — например, артикуляция губ спикера, его жесты или текст на презентационных слайдах — помогает модели точнее разбирать фразы в шумных помещениях и неоднозначных ситуациях. В документации разработчики рекомендуют передавать не более 2 кадров в секунду.
Для корпоративных пользователей предусмотрена система горячих слов (hotwords). Она позволяет принудительно задавать правила перевода для брендов, аббревиатур или узких терминов. Пользователи могут настроить словарь объемом до 1000 фиксированных терминологических пар.
Параметры API, стоимость использования и технические ограничения
Интеграция с сервисом выполняется через WebSocket Realtime API с указанием ID модели qwen3.8-livetranslate-flash-realtime. По умолчанию режим определения смены говорящего установлен как speaker_detection. Клиентское приложение непрерывно стримит аудиоданные на сервер и получает отклики в режиме реального времени.
Стандартные аудиопараметры: PCM 16 кГц на вход и PCM 24 кГц на выход. Голосом по умолчанию выступает диктор Tina. Через переменную session.output_modalities можно выбрать желаемый формат ответа: только текст или текст вместе с аудио. В коде клиента важно обязательно отправлять команду session.finish перед закрытием соединения, иначе последний сегмент речи будет потерян.
Тарификация построена на базе потраченных токенов (за 1 миллион токенов). В регионе Сингапур установлены следующие цены:
- Входное аудио: $7,50
- Входные изображения: $0,55
- Выходной текст: $20,00
- Выходное аудио: $30,00
В дата-центре Пекина расценки ниже: $5,653 за аудиовход, $0,466 за картинки, $14,133 за текст и $22,613 за аудиовыход. Расход токенов составляет 7 токенов в секунду для входного аудио и 12,5 токенов в секунду для генерируемого голоса. Таким образом, один час непрерывного аудиоперевода (ввод + вывод голоса) в регионе Сингапур обойдется примерно в $1,54 без учета текстовых и визуальных токенов.
Контекстное окно модели составляет 53 248 токенов (49 152 токена отведено под входной поток и 4 096 — под сгенерированный ответ). Действуют базовые лимиты: 10 запросов и 100 000 токенов в минуту. В текущей версии через Model Studio не поддерживаются вызов функций (function calling), структурированный вывод, пакетная обработка (batch inference) и тонкая настройка (fine-tuning).
Главные выводы
Выход Qwen3.8-LiveTranslate — это заметный шаг вперед в сфере нейросетевого синхронного перевода. Модель демонстрирует не только высокую скорость реакции (задержка снизилась до 2,3 секунды), но и качественную работу с мультимодальными данными — звуком, видеорядом и контекстом беседы. Возможность клонирования голосов и работы с 60 языками делает этот API отличным инструментом для интеграции в сервисы онлайн-конференций и трансляций.
