Мой блог
Архитектура Kimi K3: как открытая модель с миллионным контекстом конкурирует с лидерами рынка

Открытые языковые модели длительное время уступали закрытым проприетарным решениям из-за колоссальной разницы в доступных вычислительных мощностях и объемах обучающих данных. Ситуация изменилась с выходом модели с открытыми весами, которая на независимых тестах демонстрирует результаты, сопоставимые с системами от OpenAI и Anthropic. Опубликованный технический отчет разработчиков Kimi K3 раскрывает инженерные решения, позволившие объединить контекстное окно на миллион токенов, сверхглубокую структуру и массивную смесь специализированных экспертов.
За высокими показателями модели стоит глубокая инженерная переработка базовых принципов трансформера. Вместо экстенсивного наращивания вычислительного кластера создатели сосредоточились на преодолении фундаментальных ограничений: вычислительной деградации длинного контекста, затухания сигналов в глубоких слоях и неэффективного распределения ресурсов между сотнями независимых подсетей.
Как архитектура Kimi K3 удерживает миллион токенов контекста
Классические архитектуры трансформеров используют KV-кэш для сохранения ранее обработанных токенов, что избавляет модель от повторного вычисления истории на каждом новом шаге. При коротких промптах такой механизм работает без сбоев, однако размер кэша увеличивается линейно относительно длины последовательности, а сложность внимания возрастает квадратично. При обработке контекста объемом в один миллион токенов стандартный KV-кэш переполняет видеопамять современных ускорителей.
Инженеры Kimi K3 отказались от непрерывно растущего кэша в пользу фиксированной матрицы состояния S, размер которой остается неизменным вне зависимости от длины документа. Обновление состояния происходит по алгоритму delta-rule: входящий токен частично стирает предшествующую информацию и записывает новые параметры на ту же область памяти. Этот процесс регулируется двумя переменными: коэффициентом записи β (определяет силу перезаписи) и коэффициентом забывания α (задает скорость затухания старых следов).
Непрерывное перемножение коэффициента α на каждом токене создало риск вычислительного коллапса: число меньше единицы, возведенное в большую степень при длинной последовательности, устремляется к нулю и выходит за границы формата BF16. Ситуация усугублялась при параллельной обработке блоков текста, где требуется операция деления на результат этого перемножения, что приводило к делению на околонулевое значение и переполнению диапазона. Разработчики обошли ограничение жестким математическим барьером: значение α ограничили интервалом от e⁻⁵ до 1, предотвратив как обнуление исходных величин, так и появление бесконечностей при делении.
Трехуровневая параллелизация последовательных обновлений
Последовательная перезапись матрицы состояния плохо сочетается с параллельной архитектурой графических процессоров. Для сохранения высокой скорости обработки инженеры выстроили вычисления на трех раздельных уровнях.
Уровень чипа: специализированное ядро FlashKDA
Мультипроцессоры видеокарты рискуют простаивать, если передача состояния между сегментами текста идет строго последовательно. Чтобы решить эту проблему, было создано вычислительное ядро FlashKDA на базе библиотеки CUTLASS. Обработка разбита на два шага: токены внутри одного блока вычисляются полностью параллельно, а последующая передача состояния распределяется одновременно по всем независимым головам внимания.
Уровень графического ускорителя: планировщик длинного контекста
На этапе предварительной обработки длинного контекста (prefill) стандартные алгоритмы задействуют ограниченное число голов внимания, оставляя вычислительные блоки чипа недогруженными. Встроенный планировщик разбивает последовательность на сегменты и вычисляет матричные переходы для разных фрагментов параллельно на свободных ядрах внутри одной видеокарты без обращения к соседним устройствам. Затем промежуточные результаты объединяются в строго выверенное итоговое состояние.
Межкарточный обмен: декомпозиция через delta-rule и prefix-scan
При использовании правила delta-rule простое суммирование состояний невозможно, так как итоговая трансформация зависит от входящих данных предыдущего сегмента. Задачу разделили на две независимые части: расчет локального состояния от токенов текущего фрагмента и построение матрицы перехода, определяющей изменение произвольного входящего сигнала. Каждый графический процессор считает эти параметры для своего сегмента, после чего видеокарты выполняют единую операцию all-gather и объединяют данные через процедуру prefix-scan. Объем межкарточного трафика остается постоянным независимо от роста контекста.
Избирательное сохранение информации между слоями сети
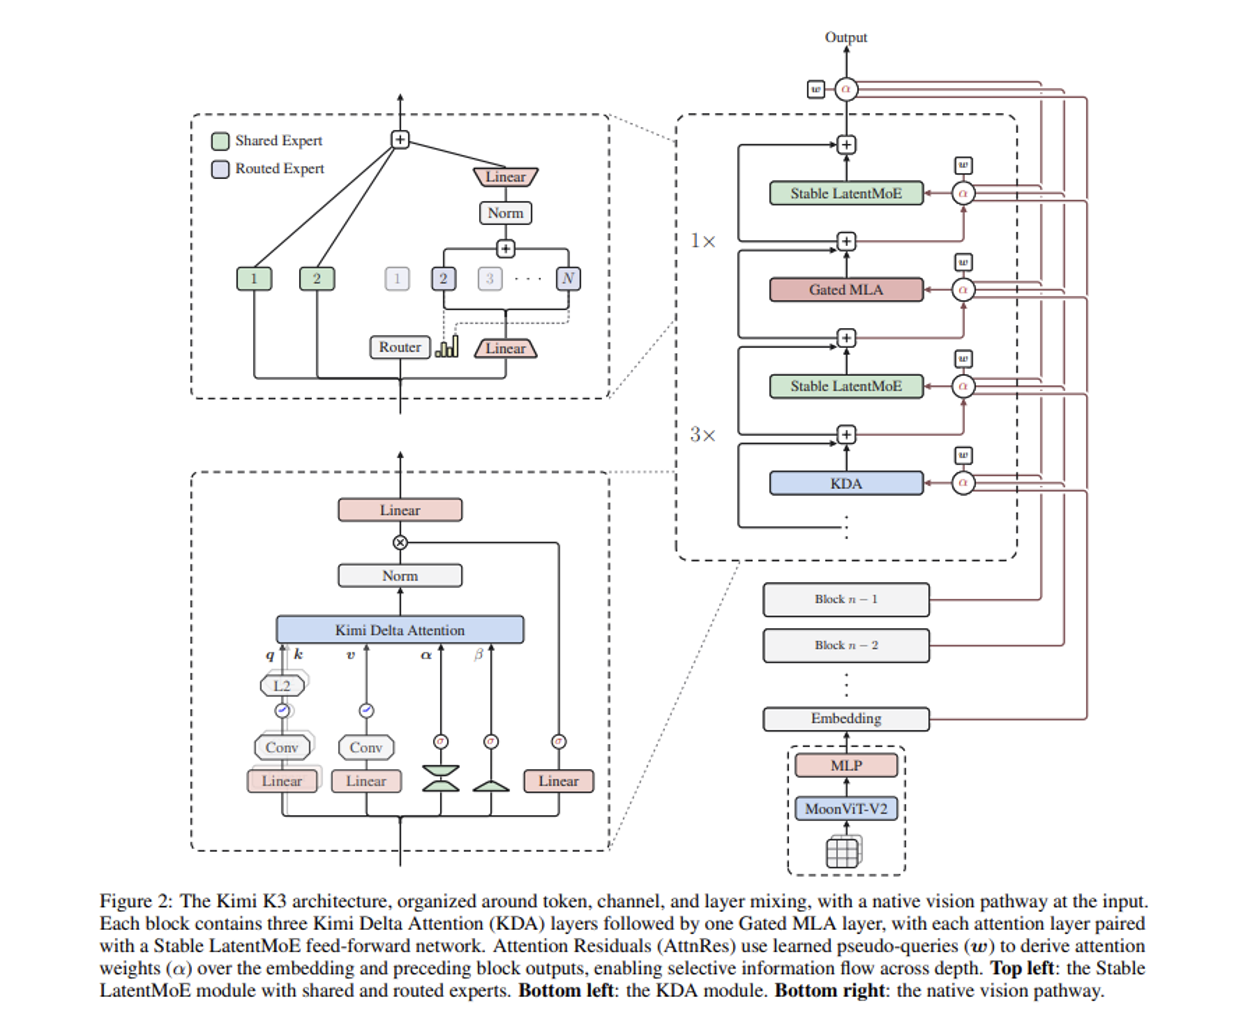
В глубоких нейросетях последовательная передача данных от слоя к слою приводит к размытию ключевых признаков, так как вся история сжимается в единый вектор. Архитектура Kimi K3 реализует избирательный доступ к прошлым слоям за счет механизма обучаемых псевдозапросов.
Каждый уровень сети содержит внутренний параметр, формулирующий запрос на тип необходимых данных. Модель сопоставляет этот запрос с выходами всех предшествующих слоев и строит взвешенную сумму, извлекая только профильную информацию. Чтобы избежать неконтролируемого расхода памяти на хранение промежуточных вычислений, слои сгруппировали в восемь блоков по 12 слоев в каждом. Внутри блока применяется стандартное сложение, а псевдозапросы обращаются только к агрегированным результатам блоков, снижая затраты видеопамяти в разы.
Масштабирование смеси экспертов: 896 специализированных модулей
Применение архитектуры Mixture of Experts (MoE) позволяет увеличивать общий объем параметров без пропорционального роста вычислительных затрат на каждый токен. Однако выборка из сотен экспертов создает угрозу перегрузки связей и дисбаланса, когда единичные модули забирают весь трафик, а остальные простаивают.
Сжатие представления в латентное пространство и стабильность SiTU-GLU
Перед передачей токенов экспертам Kimi K3 проецирует их в сжатое латентное пространство вдвое меньшей размерности. В архитектуре выделено два постоянных (shared) эксперта, работающих с несжатыми данными для всех токенов без исключения, и 896 маршрутизируемых (routed) экспертов, взаимодействующих со сжатыми векторами. Для каждого токена активируются только 16 маршрутизируемых блоков (соотношение 1 к 56).
Последовательность из четырех матричных умножений внутри блока могла спровоцировать резкий рост активаций и переполнение при вычислениях низкой точности. Чтобы исключить эту нестабильность, стандартную функцию SwiGLU заменили на собственную разработку SiTU-GLU, ограничивающую ветви вычислений сверху и гарантирующую защиту от взрыва градиентов.
Квантильная балансировка нагрузки через гистограммы
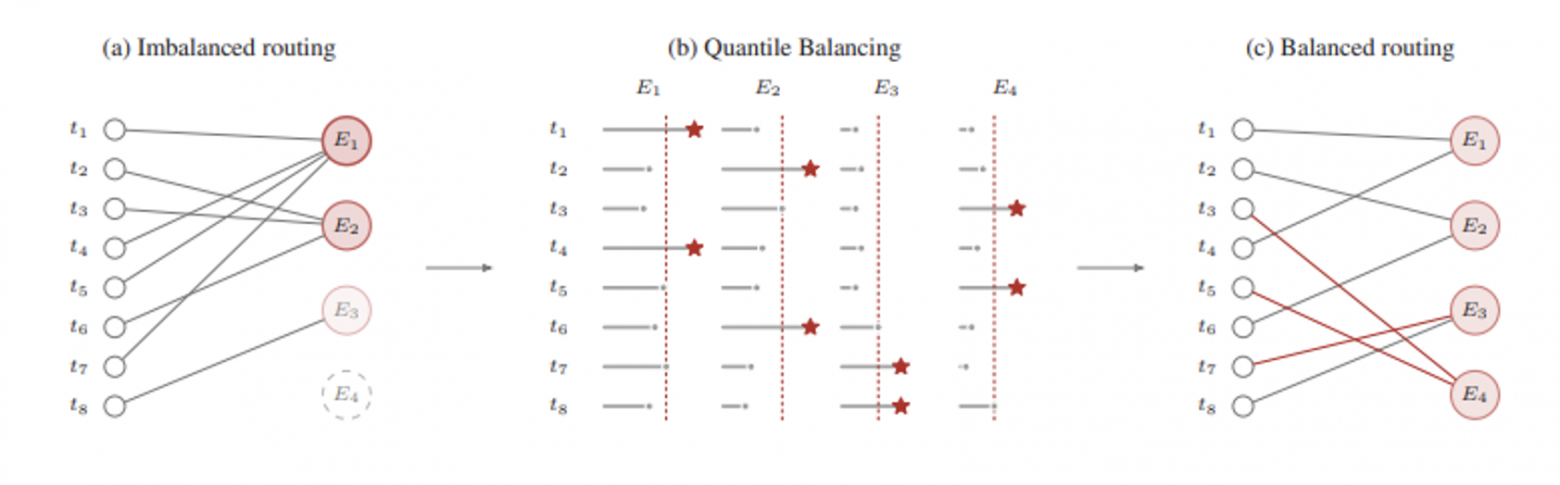
Традиционные алгоритмы маршрутизации отбирают экспертов по принципу наивысшей оценки для конкретной задачи, что вызывает перекос нагрузки. В Kimi K3 маршрутизатор распределяет данные на основе квантилей: для каждого эксперта устанавливается персональный порог вхождения, гарантирующий получение фиксированной доли токенов. Для отказа от ресурсоемкой точной сортировки оценок система строит распределенную гистограмму по интервалам, объединяет ее между ускорителями и вычисляет граничные пороги с минимальными задержками.
Размещение без дробления и открытая библиотека MoonEP
Инженеры сформировали правило: каждый эксперт полностью размещается в памяти одной конкретной видеокарты и не разделяется между устройствами. Наличие гарантированных квот позволяет передавать токен непосредственно в целевой адрес памяти без создания промежуточных копий. Постоянный размер пакетов устраняет необходимость постоянной межпроцессорной синхронизации размеров тензоров. Эта инфраструктура выделена в отдельную библиотеку с открытым исходным кодом MoonEP.
Особенности процесса обучения и отказ от позиционного кодирования
Подготовка модели проводилась на четырех доменах: интернет-страницы, программный код, математика и общенаучные данные. Мультимодальные пары «изображение-текст» внедрялись с первого этапа, формируя нативное визуальное восприятие. Для повышения отдачи от каждого FLOP математические тексты перефразировались с разными промптами, а пары «код-графика» генерировались автоматически (включая чертежи и SVG).
Окно контекста наращивалось поэтапно: с 8 до 64 тысяч токенов на стадии предварительного обучения, затем с 256 тысяч до одного миллиона на этапе финальной стабилизации. При этом в слоях с механизмом Gated MLA полностью отказались от позиционного кодирования (концепция NoPE). Порядок следования элементов фиксируется непосредственно логикой обновления состояний в блоках KDA, что дает модели возможность работать с миллионными последовательностями без дополнительной настройки интерполяции позиций.
Девять специализированных версий и дистилляция в единую модель
Перед обучением с подкреплением (RL) модель проходила стадию SFT на структурированных синтетических траекториях с XML-подобной разметкой. Обучение весов экспертов сразу велось в низкой точности формата MXFP4 (промежуточные вычисления — в MXFP8), что исключило потерю качества при последующем переносе модели в рабочую среду.
На этапе RL модель разделили на девять профильных вариантов: комбинация трех доменов (общий, агентский профиль, кодовый агент) и трех уровней вычислительных затрат на размышление (максимальный, высокий, базовый). За выход за пределы выделенного лимита токенов на рассуждения модель получала штрафной сигнал вознаграждения. Позднее все девять специализированных модификаций объединили в единую полноразмерную систему посредством метода Multi-Teacher On-Policy Distillation с пошаговым обучением на уровне токенов, а вывод ускорили с помощью спекулятивного декодирования черновой моделью.
Изолированная агентская среда и песочницы Firecracker
Для безопасного обучения агентов автономному выполнению задач и тестированию на кибербезопасность стандартные контейнеры Docker оказались непригодны из-за сбоев общего ядра ОС при агрессивных действиях модели. Разработчики создали инфраструктуру AgentENV на базе легковесных виртуальных машин Firecracker с полностью изолированными ядрами.
Песочница создает снимок состояния за 133 миллисекунды и восстанавливает работу за 49 миллисекунд. Во время генерации ответа среда замораживается, не расходуя ресурсы хоста. В рамках обучения и тестирования системы было развернуто свыше 51 миллиона изолированных сред на базе 1,5 миллиона системных образов.
Гибридная структура внимания: баланс KDA и KV-кэша
Полностью отказаться от классического внимания создателям не удалось. Полноценная архитектура Kimi K3 построена на повторяющихся блоках, где на каждые три слоя линейного внимания KDA приходится один блок стандартного внимания Gated MLA. Это соотношение 3:1 сокращает физический объем KV-кэша примерно в четыре раза по сравнению со стандартным трансформером, высвобождая память для удержания рекордного контекста без потери точности связей между токенами.
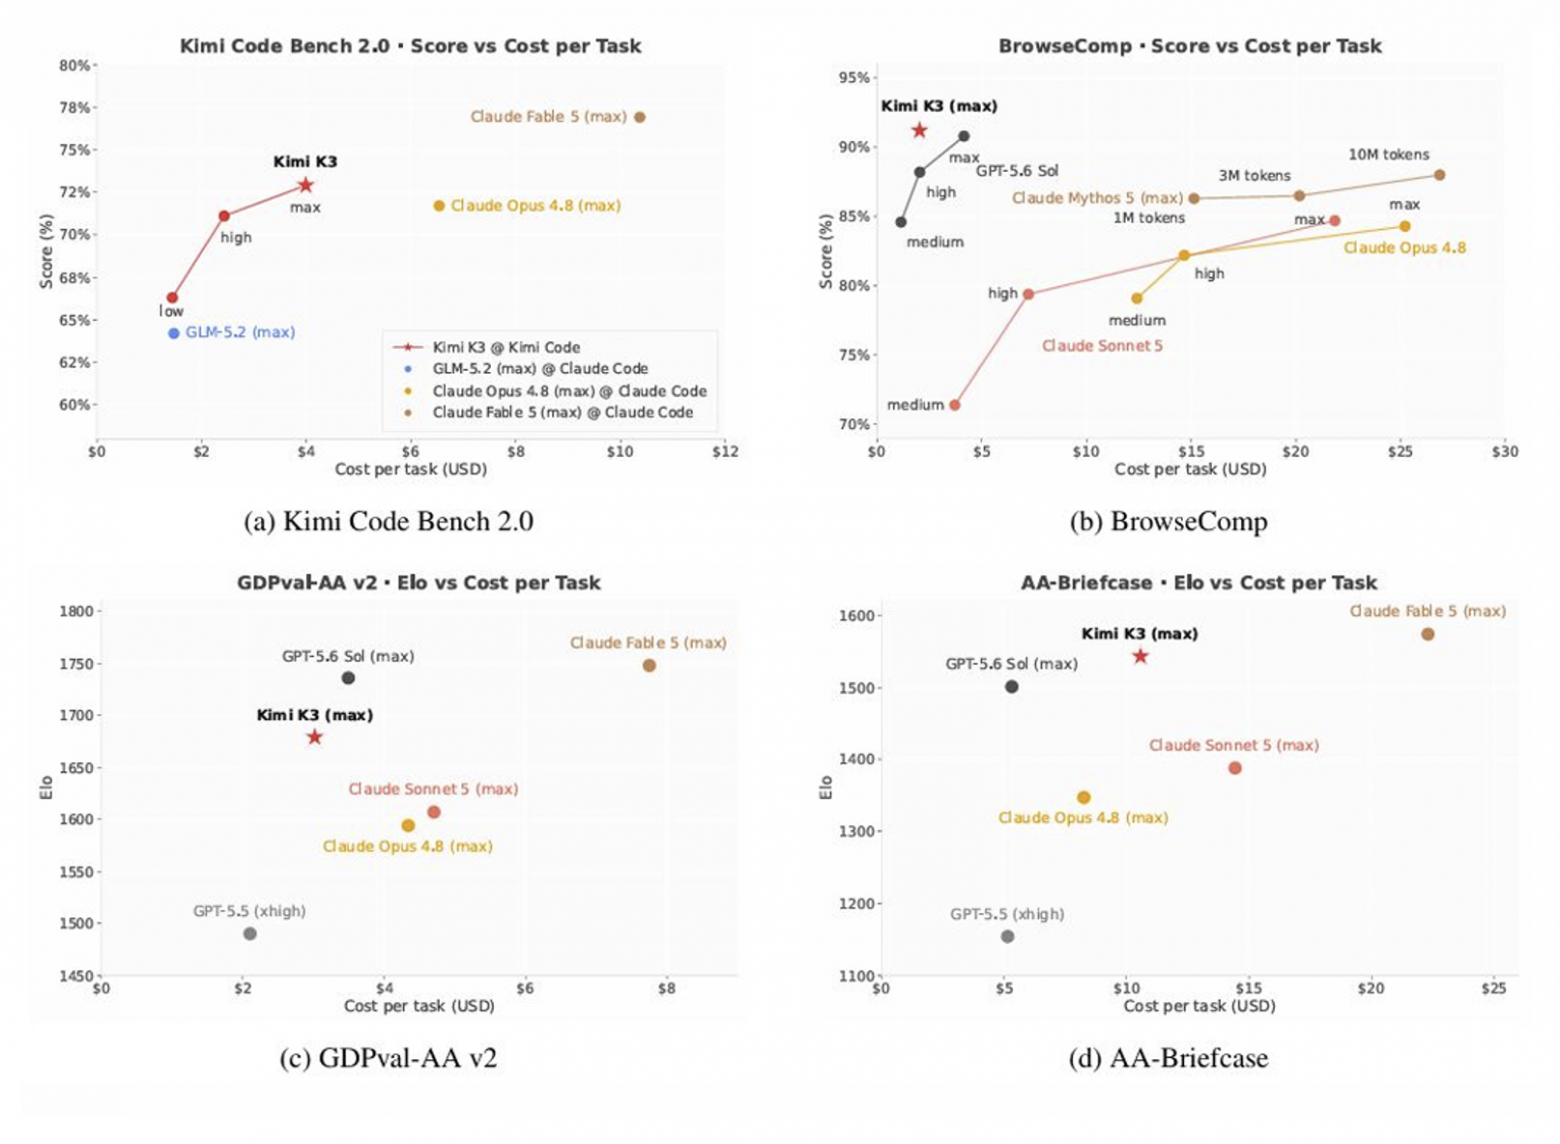
Анализ соотношения стоимости выполнения задачи к качеству (Elo) демонстрирует преимущества модели в агентских сценариях и разработке кода. Достигнутые показатели подтверждают эффективность гибридной архитектуры: при общем объеме в 2,8 триллиона параметров для обработки одного токена активируется лишь 104 миллиарда, что обеспечивает высокую скорость генерации при умеренных затратах серверных мощностей.