
Мой блог
Datalab представила OmniExtractBench для структурированного извлечения данных

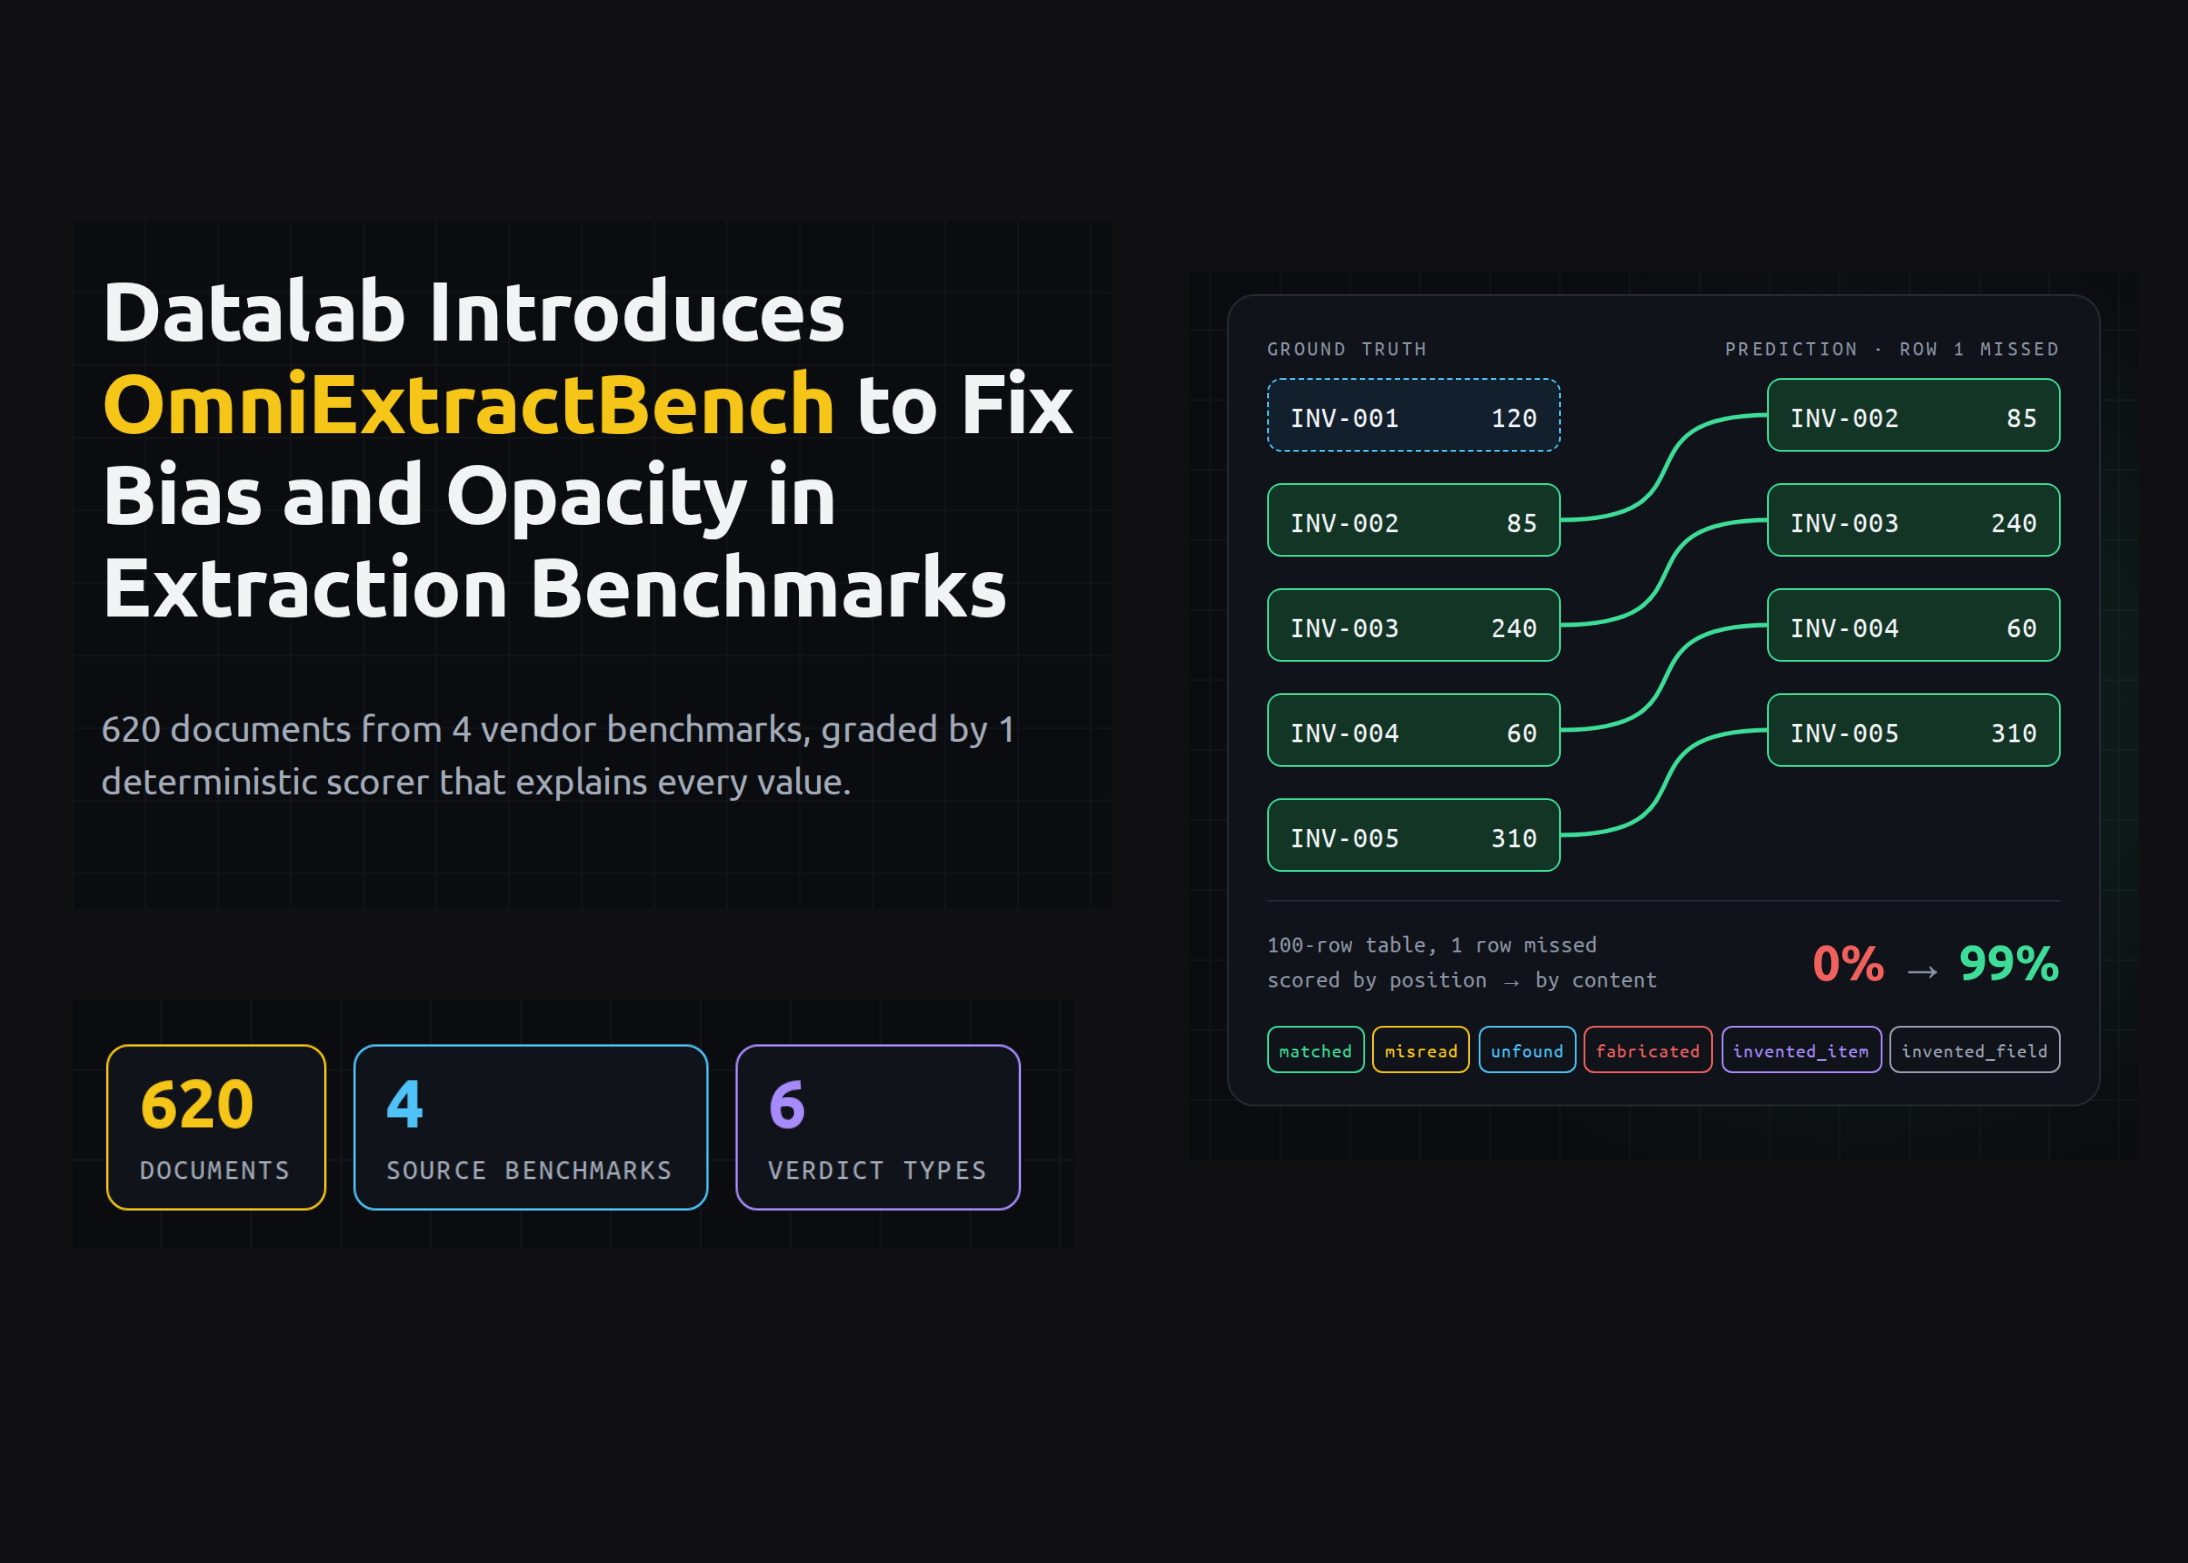
Подробности изложены в материале первоисточника. Компания Datalab выпустила открытый бенчмарк OmniExtractBench, предназначенный для объективной оценки систем извлечения структурированных данных из PDF-файлов в JSON-схемы. Релиз призван решить проблемы предвзятости, непрозрачности и несопоставимости коммерческих бенчмарков в сфере искусственного интеллекта и обработки документов.
Что представляет собой OmniExtractBench
Новый инструмент представляет собой открытую тестовую среду, где перед исследуемой системой ставится задача получить на вход PDF-документ и целевую JSON-схему, а на выходе сформировать корректный JSON-файл. Полученный результат детально проверяется значение за значением путем сопоставления с эталонным файлом (gold file). Исходный код утилиты опубликован на GitHub, а массив данных доступен на платформе Hugging Face.
Главная цель разработчиков заключалась в создании универсального критерия оценки. В процессе создания OmniExtractBench специалисты Datalab проанализировали текущие недостатки существующих бенчмарков, которые часто страдают от предвзятости в пользу создателей конкретных платформ, закрытости принципов работы оценочных скриптов и слабой детализации отчетов.
Четыре ключевые проблемы существующих бенчмарков
В ходе разработки нового инструмента команда выделила четыре системных недостатка, характерных для большинства прошлых решений в области извлечения данных из документов:
- Предвзятость: выборка документов и алгоритмы оценки часто создаются таким образом, чтобы благоприятствовать вендору, разработавшему конкретный тест.
- Непрозрачность инструментов тестирования: низкий итоговый балл модели может объясняться техническим сбоем в самом тестовом скрипте, а не реальной слабостью искусственного интеллекта.
- Неясность оценки: сторонним наблюдателям и разработчикам трудно понять, по каким конкретно причинам конкретный документ получил низкую оценку.
- Узкое разнообразие документов: некоторые тестовые пакеты содержат исключительно плотные таблицы, тогда как другие состоят только из чистых текстовых файлов без сканированных артефактов.
Источники и структура 620 документов
Общая база данных OmniExtractBench объединяет 620 документов, собранных из четырех различных источников. Самую крупную категорию составляют нормативные отчеты и формы — 88 документов. При этом 128 файлов состоят всего из одной страницы, в то время как на 33 документа объемом свыше 100 страниц приходится около 40% от общего числа всех страниц в бенчмарке.
Распределение по исходным пакетам
В итоговый пул вошли следующие наборы данных: ExtractBench от LlamaIndex (329 документов, включая формы, финансовые отчеты и презентации), собственный синтетический пакет Datalab (202 документа с плоскими скалярными схемами), LongExtractBench от micro1 по заказу Reducto (45 документов с очень крупными таблицами) и LongArray-Extract от Extend (42 документа с таблицами, содержащими повторяющиеся скаляры).
Принцип работы детерминированного оценщика
Единый детерминированный оценщик обрабатывает все документы и предоставляет подробный отчет по каждому принятому решению. Программа преобразует предсказание и эталонный JSON в набор путей к отдельным значениям (адресов), после чего нормализует данные. Например, строковые форматы дат вроде «03/31/2024» успешно сопоставляются с международным стандартом «2024-03-31».
Сравнение таблиц и алгоритм Венгра
Наиболее сложной задачей при оценке являются таблицы, где пропуск одной строки при обычном позиционном сравнении смещает все последующие позиции и обнуляет точность. Чтобы избежать подобных искажений, в OmniExtractBench применяется алгоритм Венгра для сопоставления строк на основе их содержимого. Тесты показывают, что при пропущенной первой строке табличного массива позиционный метод дает нулевой результат, тогда как контентное сопоставление сохраняет точность на уровне 99%.
Типы вердиктов и правила обработки пустых значений
Для каждого проверенного значения скрипт выносит один из шести возможных вердиктов: matched (значения совпали), misread (значения расходятся), unfound (в эталоне значение есть, в предсказании отсутствует), fabricated (схема допускает поле, в эталоне пусто, модель его заполнила), invented_item (часть предложенной строки не имеет пары) и invented_field (обращение к полю, не заявленному в схеме).
Правило нулевых полей
Важным аспектом метрики выступает борьба со скрытыми манипуляциями. Пустые строки, значения None и пробелы интерпретируются как пропуски, поэтому такие адреса исключаются из расчетов, в то время как строки вроде «NA» или «-» считаются полноценными ответами. Это предотвращает распространенный трюк, когда разработчики искусственно раздувают схему необязательными пустыми полями для получения незаслуженных баллов.
Результаты тестирования различных конфигураций
Компания Datalab протестировала на полной базе из 620 документов 10 различных конфигураций систем. Точный режим собственной разработки Datalab занял первое место с результатом 93.85% точности. Сбалансированный режим Datalab (93.48%) и решение Reducto deep_extract v2 (93.47%) продемонстрировали практически идентичные показатели.
Анализ точности и полноты
Изучение показателей precision и recall позволяет выявить характерные ошибки разных моделей:
- Склонность к пропущенным значениям: модели вроде GPT 5.6-sol показывают высокую точность (95.11%), но меньшую полноту (84.99%), теряя около 11.88% на ненадежных или пропущенных данных.
- Склонность к выдумыванию значений: система LlamaExtract демонстрирует полноту на уровне 93.13%, но проседает по точности до 86.57% из-за склонности генерировать несуществующие поля.
- Отставание по обеим метрикам: такие решения, как Mistral OCR 4.1 и Azure Content Understanding, показывают наименьшие результаты по обоим параметрам, причем полнота у них снижается сильнее всего.
Как запустить бенчмарк самостоятельно
Пакет оценщика распространяется по лицензии Apache 2.0 и устанавливается из репозитория PyPI под именем omni-extract-bench (требуется версия Python 3.11 и библиотека SciPy). Для запуска проверки достаточно выполнить команду установки и использовать скрипт с указанием путей к файлу предсказания, эталону и схеме данных.
Для повторного тестирования вендоров предусмотрена установка дополнительного модуля с поддержкой бенчмарков, однако пользователям потребуется использовать собственные учетные данные и API-ключи соответствующих провайдеров. Разработчики также предлагают протестировать возможности движка на собственных документах через специальный веб-интерфейс.
