
Мой блог
DeepSeek-V4.1-Flash: архитектурный прорыв с контекстом 1M токенов, FP4 KV-кэшем и повторным использованием внимания

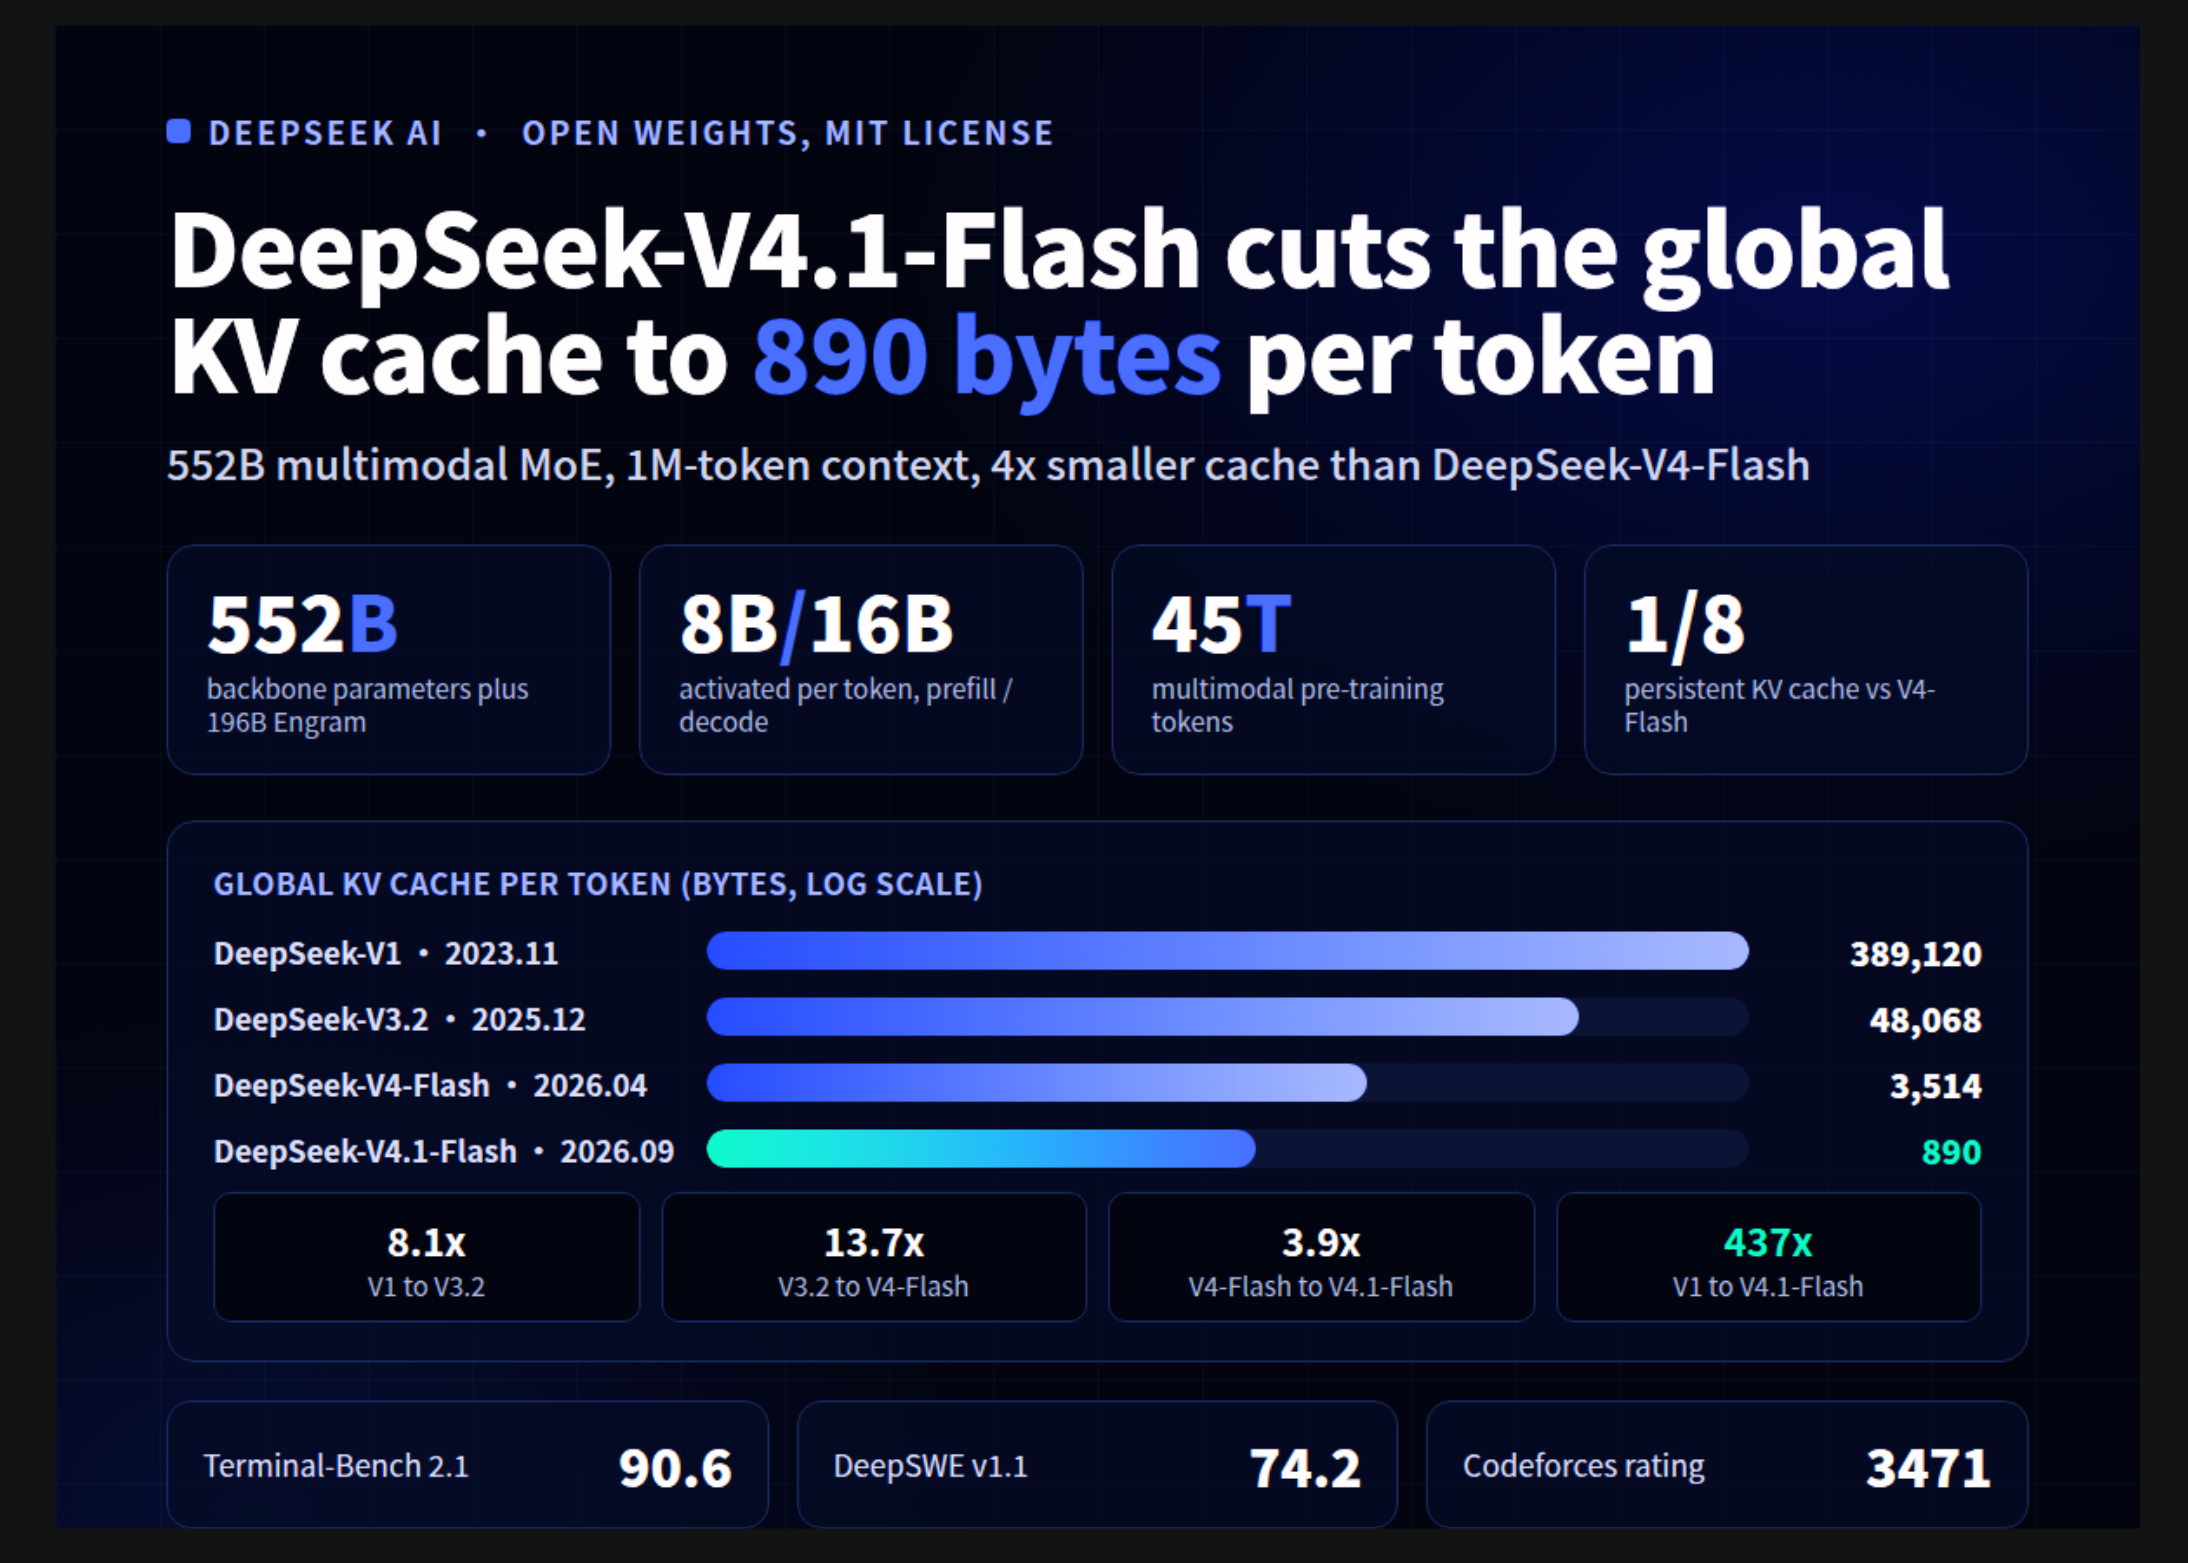
Развитие автономных ИИ-агентов, способных выполнять длительные цепочки задач, превратило инференс больших языковых моделей в крайне ресурсоёмкую нагрузку, ограниченную объёмом вводного контекста. Постоянная повторная обработка длинных промптов (prefill) и поддержка контекстных окон размером в миллион токенов создают колоссальное давление на видеопамять (HBM), пропускную способность шины и дисковые накопители из-за разрастания KV-кэша. В ответ на этот фундаментальный барьер индустрии команда DeepSeek AI представила новую модель — DeepSeek-V4.1-Flash.
Новинка представляет собой мультимодальную модель с архитектурой Mixture-of-Experts (MoE), имеющую 552 миллиарда параметров в основном каркасе и дополнительный модуль Engram на 196 миллиардов параметров. Модель поддерживает контекстное окно объёмом в 1 миллион токенов. При этом на этапе prefill активируется всего 8 миллиардов параметров на токен, а на этапе декодирования — 16 миллиардов. Главным техническим достижением релиза стало сокращение размера глобального KV-кэша всего до 890 байт на токен — это примерно в 4 раза меньше по сравнению с DeepSeek-V4-Flash и почти в 437 раз меньше показателей первой версии DeepSeek-V1.
Модель полностью готова к практическому развертыванию: веса распространяются по открытой лицензии MIT с прямой поддержкой фреймворков vLLM, SGLang и библиотек Hugging Face Transformers. Разработчики также предусмотрели публичный API с тремя градациями мощности рассуждений: low, high и max.
Архитектура Causal Encoder-Decoder: сокращение этапа Prefill вдвое
40-слойный основной каркас DeepSeek-V4.1-Flash разделен на две равные части: 20-слойный причинный энкодер (causal encoder) и 20-слойный декодер. Вдохновившись архитектурой YOCO, инженеры лишили декодер необходимости вычислять собственный глобальный KV-кэш. Вместо этого с помощью проекционных весов для каждого слоя значения KV выводятся напрямую из финального скрытого состояния энкодера.
Благодаря такой схеме токены входного промпта обрабатываются исключительно энкодером, что позволяет уменьшить объём вычислений на этапе prefill почти в два раза. Механизм внимания со скользящим окном (Sliding Window Attention, SWA) с размером окна в 128 токенов продолжает работать на всех слоях. Для восстановления состояний SWA в декодере применяется процедура Decoder SWA Bounded Replay — система заново просчитывает лишь последние 128 токенов ввода, избегая полного прохода по всей длине контекста.
Механизм сжатия Compressed Sparse Attention 2 (CSA2)
Если в версии V4 применялась комбинация обычного CSA и сильно сжатого внимания, то DeepSeek-V4.1-Flash перешла на чистую архитектуру CSA2, оптимизирующую размер кэша вдоль оси слоев. Каждый слой CSA2 статически работает в одном из трех режимов:
- Full: самостоятельно вычисляет основной KV-кэш, проецирует из него ключи индексации (indexer K) и формирует свежий набор Top-512 индексов.
- Reindex: повторно использует основной KV и indexer K из последнего слоя Full, но пересчитывает их оценки с помощью собственного запроса индексации (indexer Q).
- Reuse: полностью задействует как основной KV, так и имеющиеся Top-K индексы, целиком пропуская работу индексатора.
При этом каждый слой сохраняет собственный запрос Q и локальный кэш SWA KV. В энкодере 18 слоев CSA2 сгруппированы по 6 слоев (1 Full и 5 Reuse) с коэффициентом сжатия 2. В декодере 20 слоев разделены на 5 групп по 4 слоя с коэффициентом сжатия 1: первая группа включает 1 Full и 3 Reuse, а оставшиеся четыре — 1 Reindex и 3 Reuse. Реализованный в декодере иерархический разреженный индексатор (Hierarchical Sparse Indexer) позволяет слою Full формировать кандидатов объёмом до 16 384 позиций (2 048 блоков по 8 токенов), поэтому последующие слои Reindex оценивают ограничено заданный пул, а не весь миллионный контекст.
Квантование KV-кэша до FP4, Bounded Replay и другие оптимизации
Основной KV-кэш модели квантован до формата E2M1 с масштабирующим коэффициентом E4M3 на каждые 16 каналов — по аналогии с NVFP4, но без глобального масштабирования. Эта оптимизация внедрена с помощью обучения с учётом квантования (QAT) на этапе пост-обучения, что сократило занимаемую память практически вдвое по сравнению с FP8-кэшем в V4.
На уровне инфраструктурного развертывания кэш SWA KV больше не сбрасывается на SSD. Он размещается в распределённом пуле оперативной памяти (DRAM), под который выделяется 10% памяти хоста с временем жизни (TTL) в несколько минут. Глобальный же KV-кэш сохраняет гарантированный срок жизни на дисках в течение 72 часов. Если происходят промахи кэша SWA в энкодере, механизм Encoder SWA Bounded Replay пересчитывает всего 128 токенов вместо умножения количества слоев на размер окна.
Среди других важных инженерных улучшений стоит выделить:
- Single-Pass mHC: сдвигает коэффициенты смешивания входов на один блок, позволяя оптимизированному ядру Mega-mHC сократить трафик памяти активаций вдвое.
- Модуль условной памяти Engram, интегрированный на 1-м и 14-м слоях.
- Спекулятивное декодирование DSpark, обученное после этапа предобучения при замороженном основном каркасе.
- Поголовую оптимизацию head-wise Muon.
Благодаря комплексу этих решений вычислительные затраты (FLOPs) на генерацию одного токена при увеличении контекста с 4 000 до 1 000 000 токенов возрастают всего на 25%.
Обучение модели и результаты на бенчмарках
Предварительное обучение DeepSeek-V4.1-Flash проводилось на массиве из 45 триллионов мультимодальных токенов при соотношении текстовых и мультимедийных данных 7:1. Разреженное внимание обучалось с нуля на последовательностях длинной 64K без предварительного разогрева на плотных архитектурах. Расширение контекста до 1 миллиона токенов производилось на отметке в 34 триллиона токенов.
Базовая версия модели сравнялась с DeepSeek-V4-Pro-Base в тестах на общие знания и написание кода, используя при этом лишь треть от общего числа параметров и четверть от количества активных параметров. В процессе пост-обучения упор был сделан на масштабный синтез проверяемых агентских задач, обучение с подкреплением (RL) на различных средах (Claude Code, Codex, OpenCode, Pi, mini-SWE, DeepSeek Harness) и он-полиси дистилляцию от более чем 40 моделей-учителей.
В тестах с максимальным уровнем рассуждений (max effort) DeepSeek-V4.1-Flash продемонстрировала впечатляющие результаты в сравнении с конкурентами:
| Бенчмарк | DS-V4.1-Flash | DS-V4-Flash | Opus-5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 90.6 | 82.7 | 89.1 | 88.8 |
| DeepSWE v1.1 | 74.2 | 54.4 | 74.0 | 73.0 |
| Terminal-Bench 4.0 | 31.2 | 7.0 | 51.8 | 39.9 |
| Automation-Bench | 54.8 | 37.7 | 50.3 | 45.8 |
| GPQA Diamond | 90.9 | 89.9 | 93.4 | 94.1 |
| Codeforces (рейтинг) | 3471 | 3289 | — | — |
Главные выводы о DeepSeek-V4.1-Flash
Релиз DeepSeek-V4.1-Flash задает новый стандарт эффективной работы с длинным контекстом в инфраструктуре ИИ-агентов. Ключевые итоги архитектурных изменений:
- Занимаемый объём глобального KV-кэша упал до 890 байт на токен.
- Схема Causal Encoder-Decoder задействует только 20 слоев энкодера на этапе prefill (8B активных параметров против 16B при декодировании).
- Архитектура CSA2 переиспользует ключи и индексы внимания между слоями в режимах Full, Reindex и Reuse.
- Квантование FP4 в сочетании с механизмом SWA Bounded Replay снизило требования к постоянному хранилищу кэша в 8 раз по сравнению с V4-Flash.
- Открытая модель под лицензией MIT превосходит топовые проприетарные решения Opus-5 и GPT-5.6 Sol в специализированных агентских тестах Terminal-Bench 2.1 и DeepSWE v1.1.
Источник: www.marktechpost.com
