
Мой блог
Google DeepMind выпустила EmbeddingGemma 2: мультимодальная модель для векторизации

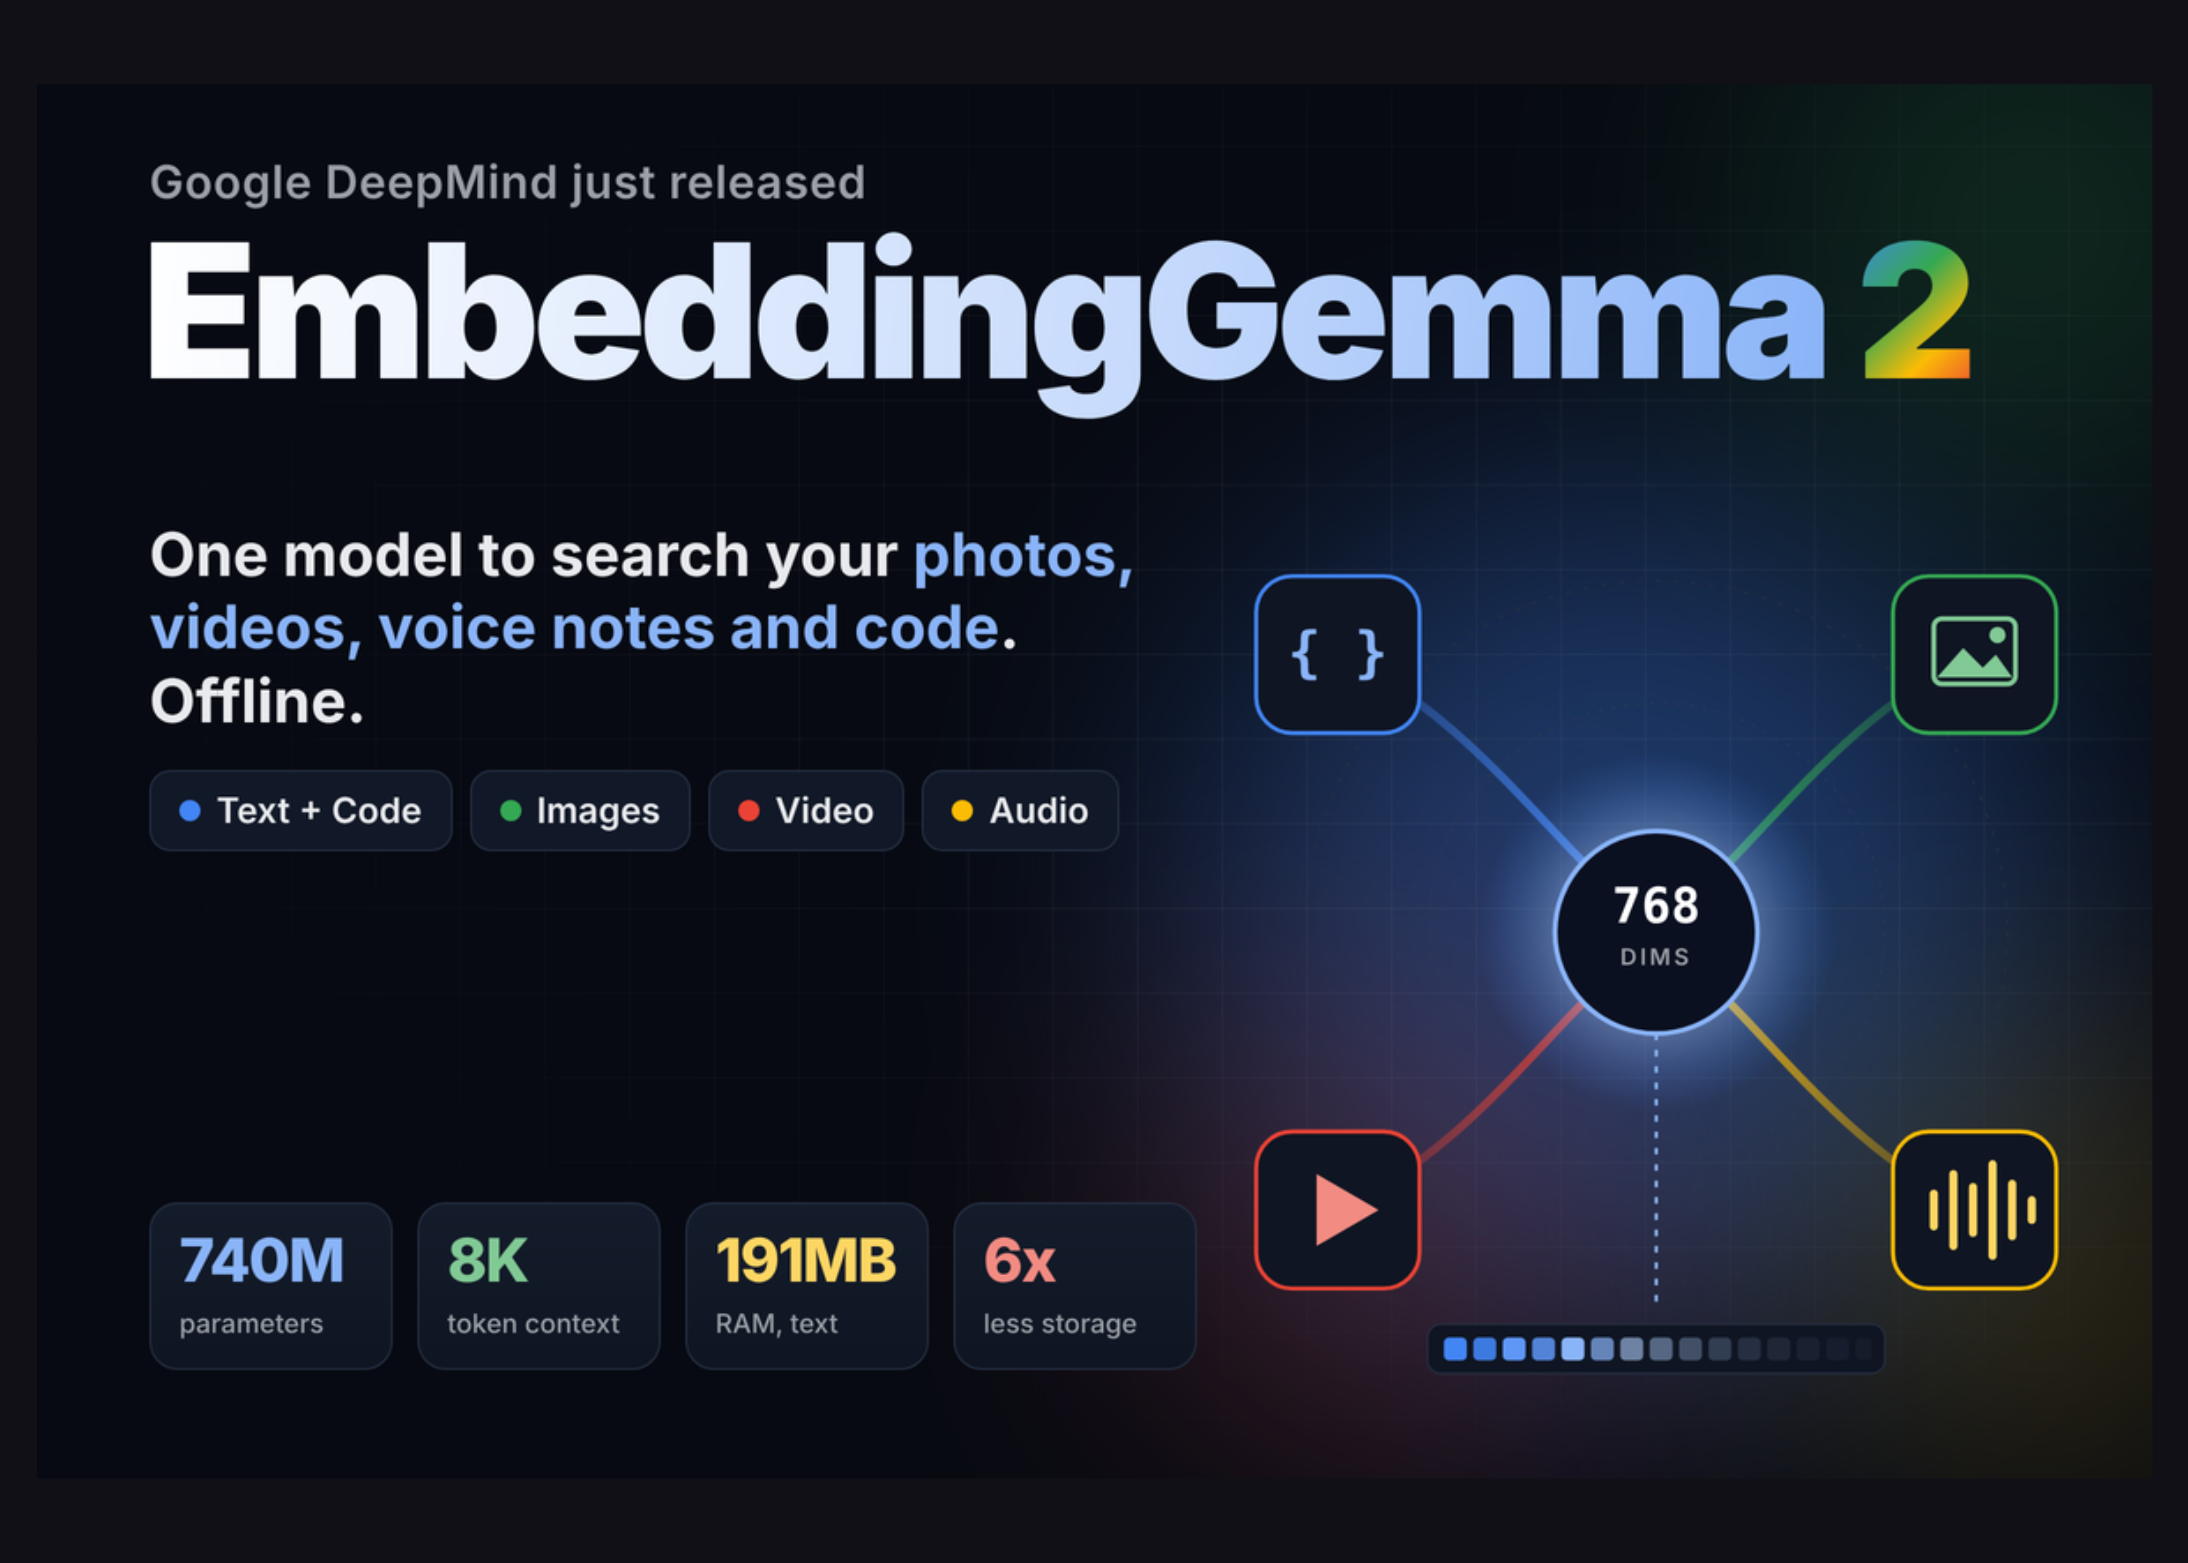
Компания Google DeepMind представила модель EmbeddingGemma 2, открытую мультимодальную систему для создания векторных представлений, объединяющую текст, программный код, изображения, видеофайлы и аудиозаписи в едином пространстве размерностью 768. Релиз построен на передовой архитектуре Gemma 4, имеет в своем арсенале 740 миллионов параметров, расширенное контекстное окно на 8 тысяч токенов и распространяется под свободной лицензией Apache 2.0. Новинка ориентирована на локальный поиск на устройствах, задачи классификации и безопасные RAG-пайплайны.
Как отмечает Google DeepMind в официальной документации, веса модели уже доступны на платформах Hugging Face и Kaggle, а также полностью поддерживаются в сборках Ollama, llama.cpp GGUF и LiteRT для немедленного развертывания.
Что делает модель эмбеддингов
Любая модель эмбеддингов преобразует исходный контент в числовой вектор, который точно отражает смысловое наполнение данных. Похожие по значению элементы располагаются близко друг к другу в векторном пространстве, благодаря чему их чрезвычайно легко искать, сопоставлять и фильтровать. В архитектуре RAG такие векторы позволяют языковым моделям эффективно извлекать актуальные внешние сведения, изначально не заложенные в их базовые тренировочные датасеты. Генерация подобных векторов прямо на локальном оборудовании пользователя гарантирует полную конфиденциальность данных, минимизирует задержки при обработке запросов и обеспечивает стабильную работу в офлайн-режиме без необходимости постоянного обращения к облачным серверам.
Единое векторное пространство для любых модальностей
Модель EmbeddingGemma 2 создана на базе фундаментальных принципов архитектуры Gemma 4, что позволяет ей объединять различные типы данных. Текстовый запрос может легко найти релевантную фотографию в базе, а простая голосовая заметка способна отыскать нужный фрагмент видеоряда. Комбинированные входящие данные, такие как страница товара с описанием, изображениями и демонстрационным роликом, упаковываются системой в один общий вектор.
Архитектура решения выполнена модульной и состоит из трех ключевых компонентов:
- Бэкэнд для обработки текста и кода размером 270 миллионов параметров (включая 130 млн трансформаторной части и 140 млн модуля эмбеддингов).
- Опциональный визуальный кодировщик объемом 170 миллионов параметров.
- Опциональный аудиокодировщик емкостью 300 миллионов параметров.
Разработчики могут загружать только те части, которые необходимы для текущей задачи: компактные 270M для работы исключительно с текстом, 440M для текстово-визуальных сценариев, 570M для обработки текста и звука или полные 740M для максимальной мультимодальности. Все эти варианты конфигураций используют единое общее векторное пространство. Это значит, что поисковый запрос, сгенерированный облегченной текстовой версией, успешно найдет документы, проиндексированные полным составом модели.
Размер поддерживаемого контекстного окна составляет 8192 токена, что ровно в четыре раза превышает показатели первой версии. В этот объем помещается примерно 29 графических изображений, 58 отдельных кадров видеоряда или около 5,5 минут непрерывного аудиосигнала.
Результаты бенчмарков
Исследовательская группа Google заявляет о лидирующих позициях модели среди мультимодальных эмбеддеров объемом менее одного миллиарда параметров в таких тестах, как MTEB Code и MAEB. Точные результаты замеров на полной точности при 768 измерениях демонстрируют значительный прирост производительности по сравнению с предшественником.
В частности, качество поиска фрагментов кода выросло сразу на 9,92 пункта, что составляет около 14% улучшения. При этом показатели мультиязычного текстового поиска остаются стабильно высокими. Более крупная модель Qwen3-VL-Embedding-2B демонстрирует 73.2 балла в собственном прогоне MMEB-V2, однако она требует примерно в 2,7 раза больше параметров и полностью лишена встроенной поддержки аудио.

Создано для смартфонов и ноутбуков
С учетом процедур квантования на смартфоне Pixel 11 Pro объем активной оперативной памяти для текстовой конфигурации составляет около 191 МБ, тогда как полная мультимодальная версия требует порядка 567 МБ. Специализированное обучение с учетом квантования сжимает веса до форматов INT4 и INT8. Инженеры команды Google AI Edge зафиксировали скорость обработки одного изображения на уровне 37,3 миллисекунды на графическом процессоре ноутбука MacBook M5 Pro при выделении бюджета в 70 токенов на зрение.
Метод обучения Matryoshka Representation Learning (MRL) дает возможность разработчикам усекать размерность векторов до 512, 256 или 128 элементов. Переход с 768 на 128 измерений сокращает требования к хранилищу данных до шести раз. При использовании 256 измерений мультиязычный результат MTEB снижается незначительно (с 61,36 до 60,41 балла), тогда как на 128 измерениях показатели падают сильнее, поэтому разработчики рекомендуют столь сильное сжатие главным образом для чисто текстовых задач.
Сравнение EmbeddingGemma 2 с ближайшими конкурентами
На рынке открытых и закрытых решений EmbeddingGemma 2 уверенно конкурирует с такими системами, как первая версия модели, Qwen3-VL-Embedding-2B, экспериментальная LCO-Embedding-Omni-3B и облачный сервис Gemini Embedding 2. Новинка выгодно отличается гибкой модульностью, открытой лицензией Apache 2.0 для большинства весов, поддержкой четырех основных модальностей ввода данных и оптимизацией под запуск на потребительском «железе» без необходимости обращения к удаленным серверам.
Как запустить модель
Инструмент совместим с актуальными версиями библиотек sentence-transformers v6.1.0+, Transformers, vLLM, SGLang, MLX, llama.cpp, Ollama, LM Studio, LiteRT и MediaPipe. Хранение векторов обеспечивается базой Qdrant, а за тонкую настройку отвечает фреймворк Unsloth. Поддержка аппаратного ускорения NPU через ML Kit для Android-устройств появится уже в ближайшие недели.
Для запуска через Ollama достаточно выполнить команду терминала ollama pull embeddinggemma-2. Доступные теги варьируются от версии на 270m (занимающей 378 МБ) до модификации на 740m весом 1,3 ГБ. Готовые демонстрационные примеры опубликованы в галерее Google AI Edge.
Основные выводы
Главным достоинством релиза стал универсальный открытый инструмент размером 740M, способный обрабатывать текст, код, графику, видео и звук в едином пространстве. Модульная структура кодировщиков позволяет масштабировать системные требования под конкретные сценарии, а высокая скорость работы и скромное потребление памяти открывают путь для полноценного внедрения продвинутого ИИ в мобильные гаджеты и ноутбуки.
Часто задаваемые вопросы
Ниже приведены ответы на самые частые вопросы о модели.
Можно ли использовать EmbeddingGemma 2 в коммерческих проектах?
Да, модель распространяется под открытой и гибкой лицензией Apache 2.0, разрешающей промышленное применение.
Сколько оперативной памяти требуется для работы модели?
На смартфоне Pixel 11 Pro с применением квантования текстовая версия расходует около 191 МБ активной RAM, а полноценный мультимодальный вариант занимает примерно 567 МБ.
