
Мой блог
Установка локальных ИИ-моделей в один клик: Nous Research обновила Hermes Desktop

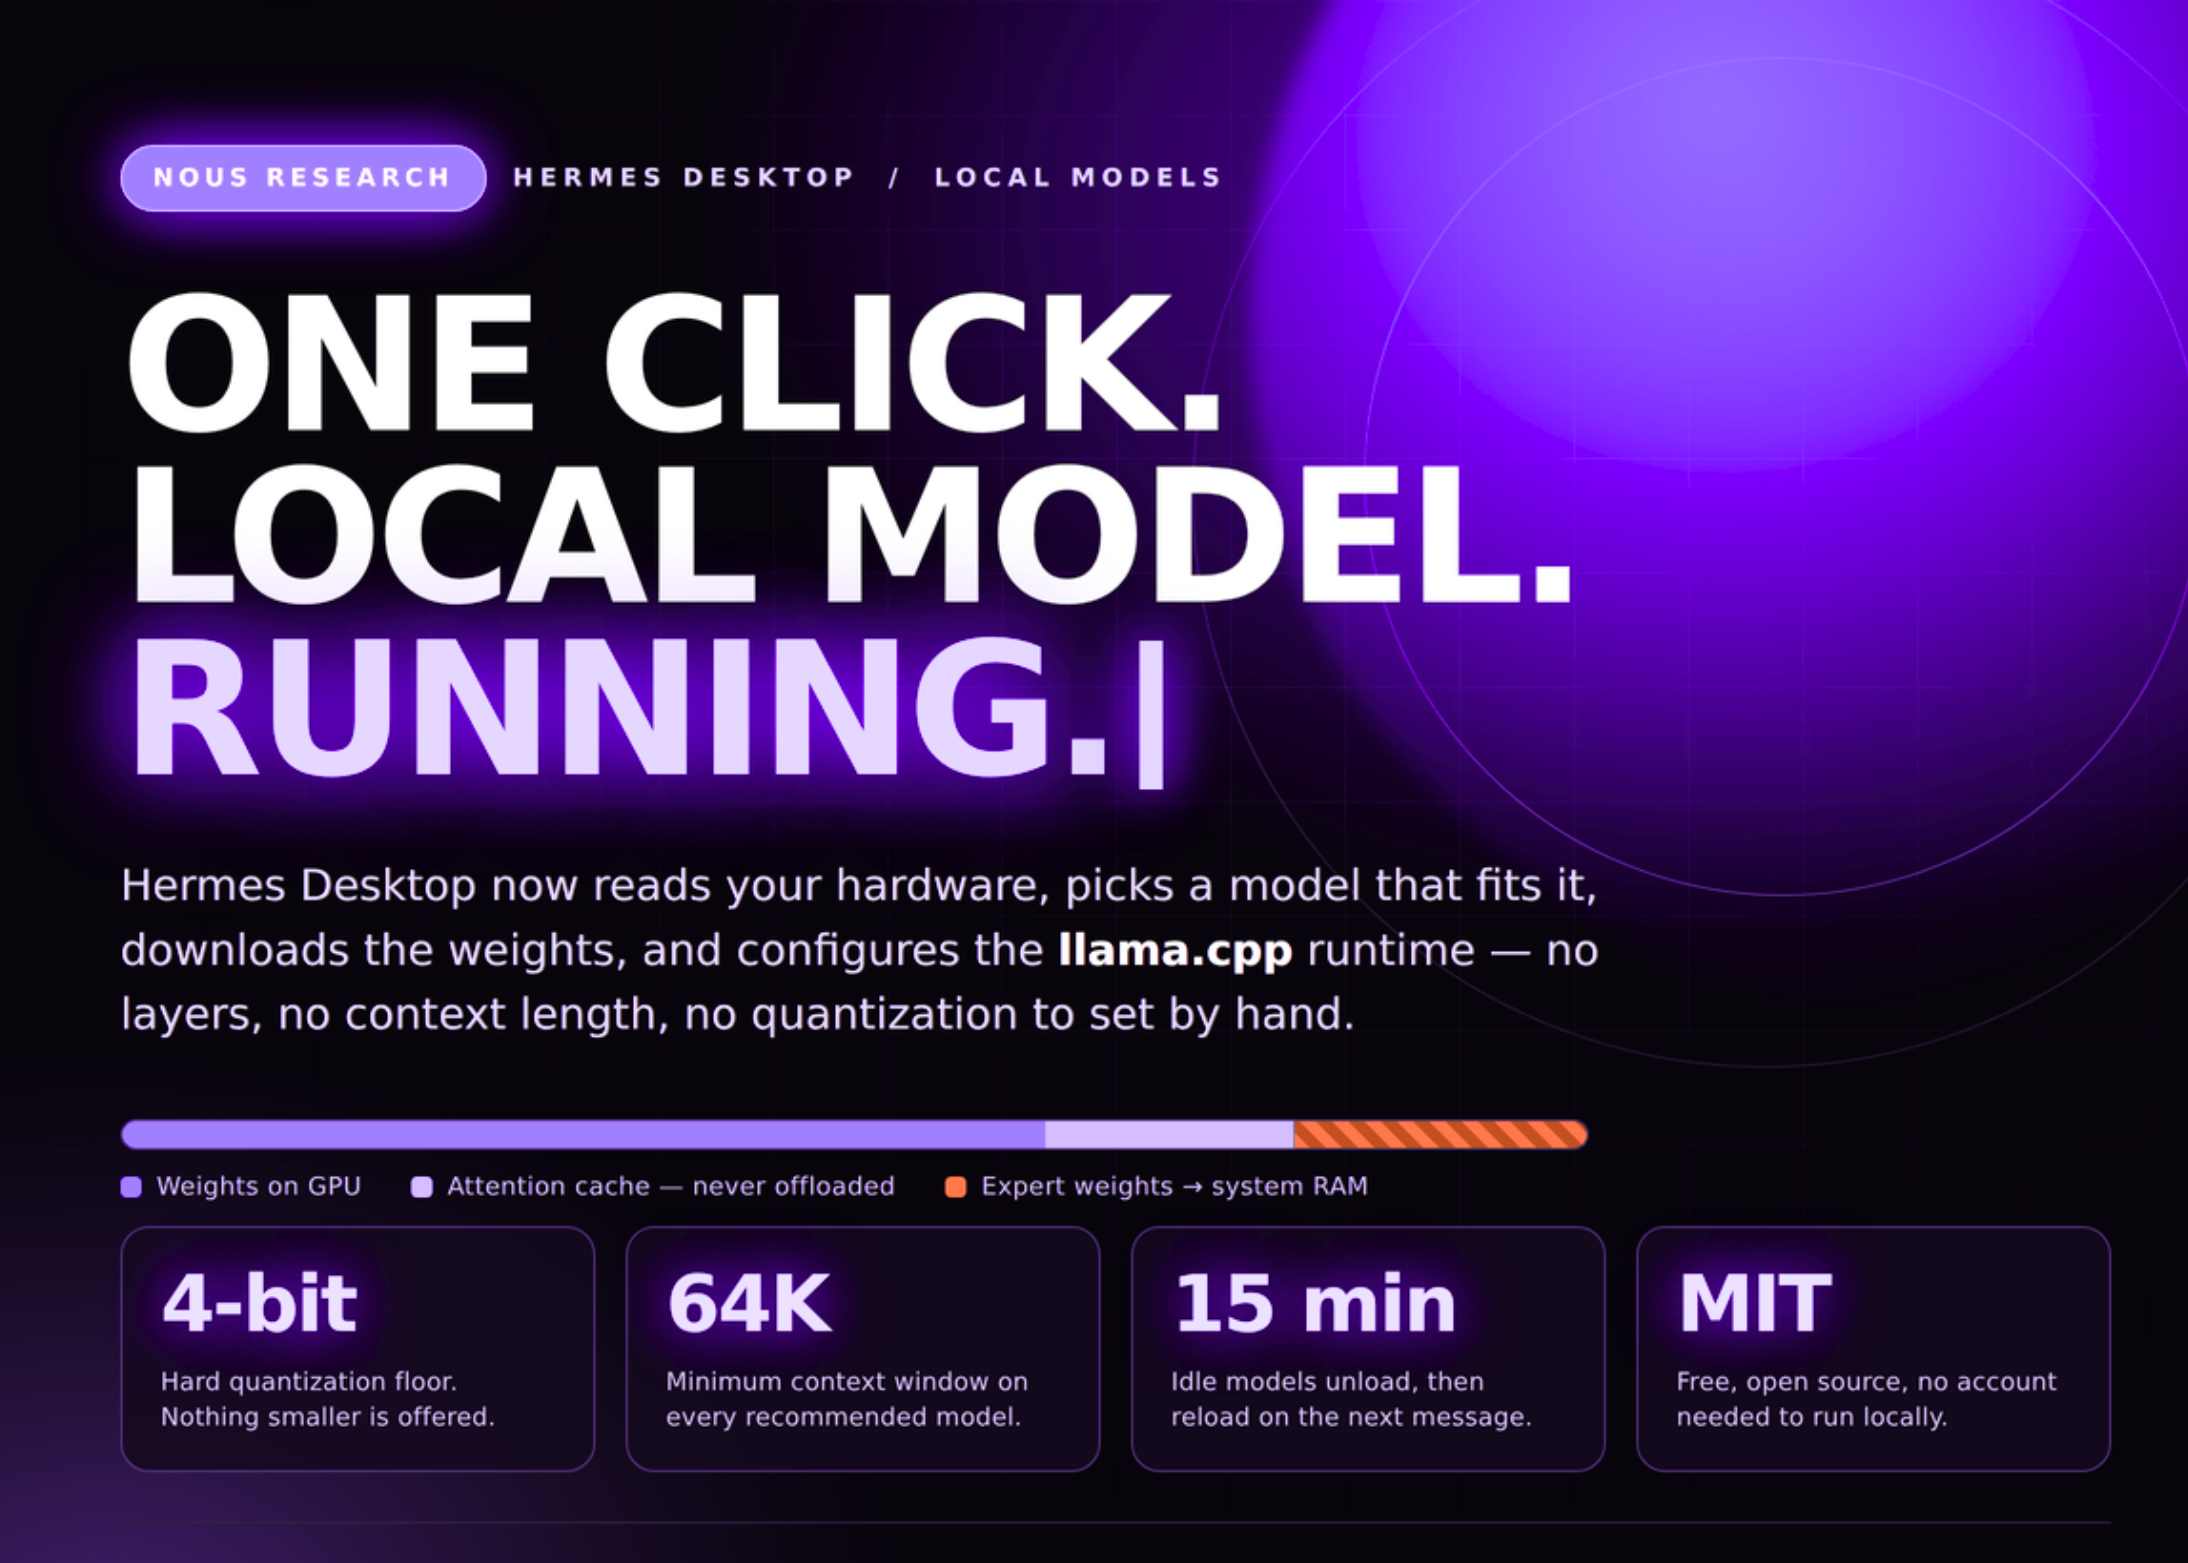
Главная сложность при запуске нейросетей с открытым исходным кодом на собственном компьютере никогда не заключалась в самих моделях. Основной проблемой всегда оставалась рутинная подготовка: анализ объема видеопамяти (VRAM), подбор правильного уровня квантования, настройка длины контекста и распределения слоев между графическим процессором и ОЗУ. Частая ситуация — когда после всех настроек модель отказывалась запускаться из-за нехватки пары гигабайт видеопамяти. Команда Nous Research полностью устранила этот технический барьер, добавив в приложение Hermes Desktop автоматическую установку локальных моделей в один клик.
Новый мастер первичной настройки автоматически сканирует параметры вашего оборудования, выбирает оптимальную модель, скачивает необходимые веса и конфигурирует средовое окружение (runtime). Приложение Hermes Desktop распространяется бесплатно под лицензией MIT и создано на базе открытого проекта Hermes Agent. Оно работает на платформах macOS 12+, Windows 10/11 и любых дистрибутивах Linux, при этом для использования локальных нейросетей не требуется создавать учетную запись или проходить авторизацию.
Что именно появилось в обновлении Hermes Desktop
Анонс разработчиков содержателен и конкретен: Hermes Desktop получил полноценный встроенный автоконфигуратор локальных моделей. Окно первичной настройки запускается автоматически при первом старте приложения. Впоследствии его можно в любой момент открыть через меню Settings → Providers → Local Models («Настройки» → «Провайдеры» → «Локальные модели»).
Всю работу с движком инференса Hermes берет на себя. Согласно технической документации раздела Local Models, клиент автоматически загружает официально собранный бинарный файл llama.cpp, адаптированный под конкретное железо пользователя. Объем исполняемого файла составляет всего несколько сотен мегабайт, а система сама проверяет его целостность и поддерживают актуальность версий.
Поддерживаются следующие графические и вычислительные бэкенды:
- CUDA — для дискретных видеокарт NVIDIA;
- Metal — для чипов Apple Silicon на устройствах Mac;
- Vulkan — универсальный графический API;
- HIP — для ускорителей AMD;
- CPU — для работы исключительно на ресурсах центрального процессора.
Фиксированный релизный тег сохраняется в блоке local_runtime конфигурационного файла config.yaml. Графический интерфейс программы записывает данные автоматически, однако пользователи headless-режимов (без GUI) могут редактировать эти параметры вручную.
Как Hermes сопоставляет модели с аппаратным обеспечением
Перед загрузкой любой модели из общего каталога Hermes оценивает ресурсы вашего компьютера. Каждая позиция в списке получает цветовой маркер совместимости по памяти:
- Зелёный статус: модель целиком помещается в видеопамять (VRAM) графического ускорителя, обеспечивая максимальную скорость работы.
- Янтарный (жёлтый) статус: часть данных будет перенесена в системную оперативную память (RAM), что снизит скорость генерации, но сохранит работоспособность.
- Красный статус: модель слишком велика для текущей конфигурации компьютера и не может быть запущена.
В строке каждой модели указываются начальный и максимальный размер окна контекста, а также итоговый объем скачиваемого файла для выбранной модификации.
Выбор уровня квантования (сжатия) происходит по единому алгоритму: Hermes подбирает наиболее качественную сборку, способную полностью разместиться в VRAM. Для систем с меньшим объемом памяти подбирается более сжатая версия этой же модели. При этом установлено жесткое ограничение — квантование не может быть ниже 4 бит (4-bit). В Nous Research считают, что более агрессивное сжатие приводит к недопустимой потере точности и интеллекта нейросети. Если система не тянет 4-битную сборку без сильного выгружения в ОЗУ, модель отмечается как несовместимая. Тем не менее такие модели остаются видимыми в списке с указанием причины, чтобы пользователь понимал, какой объем VRAM потребуется при будущем апгрейде.
Правила работы с памятью и оптимизация контекста
Качество локального вывода напрямую зависит от грамотной распределительной политики памяти. В Hermes Desktop пользователи избавлены от необходимости вручную выставлять технические тумблеры и параметры.
Размер контекстного окна масштабируется динамически: диалог стартует с базового объема, полностью влезающего в GPU, и расширяется до максимума по мере роста истории общения. Для всех рекомендуемых моделей гарантируется окно контекста не менее 64K токенов.
Интересно реализован алгоритм выгрузки избыточных данных (offload order) при нехватке VRAM:
- Если модель превышает лимит видеопамяти, Hermes выгружает «лишнее» в оперативную память в строгой последовательности, минимизирующей падение скорости.
- В первую очередь переносятся веса экспертов (в архитектурах Mixture of Experts / MoE).
- Кэш внимания (attention cache / KV-cache) никогда не перемещается в RAM и всегда остается в быстрой видеопамяти.
Такой подход жервует пиковой пропускной способностью токенов ради сохранения стабильного контекста. Автоматическое сжатие (суммаризация) диалога включается только тогда, когда исчерпан абсолютный максимум контекста модели. Если приложение простаивает без запросов более 15 минут, модель автоматически выгружается из памяти и моментально загружается снова при отправке нового сообщения.
Главные выводы
- Автоматическая настройка в один клик определяет параметры ПК, скачивает подходящую модель и оптимизированный движок.
- Управление движком
llama.cppполностью автоматизировано — больше не нужно вручную подбирать кванты и распределять слои по GPU. - Прозрачная цветовая индикация (зелёный/жёлтый/красный) заранее предупреждает о требованиях к VRAM и RAM.
- Минимальный порог квантования зафиксирован на уровне 4-bit для сохранения высокой точности ответов.
- Умный алгоритм оффлоада в RAM гарантирует контекст от 64K токенов без потери кэша внимания.
Источник: www.marktechpost.com
