
Мой блог
Liquid AI представила LFM2.5-VL-3B-DSpark: ускорение генерации для мультимодальных моделей

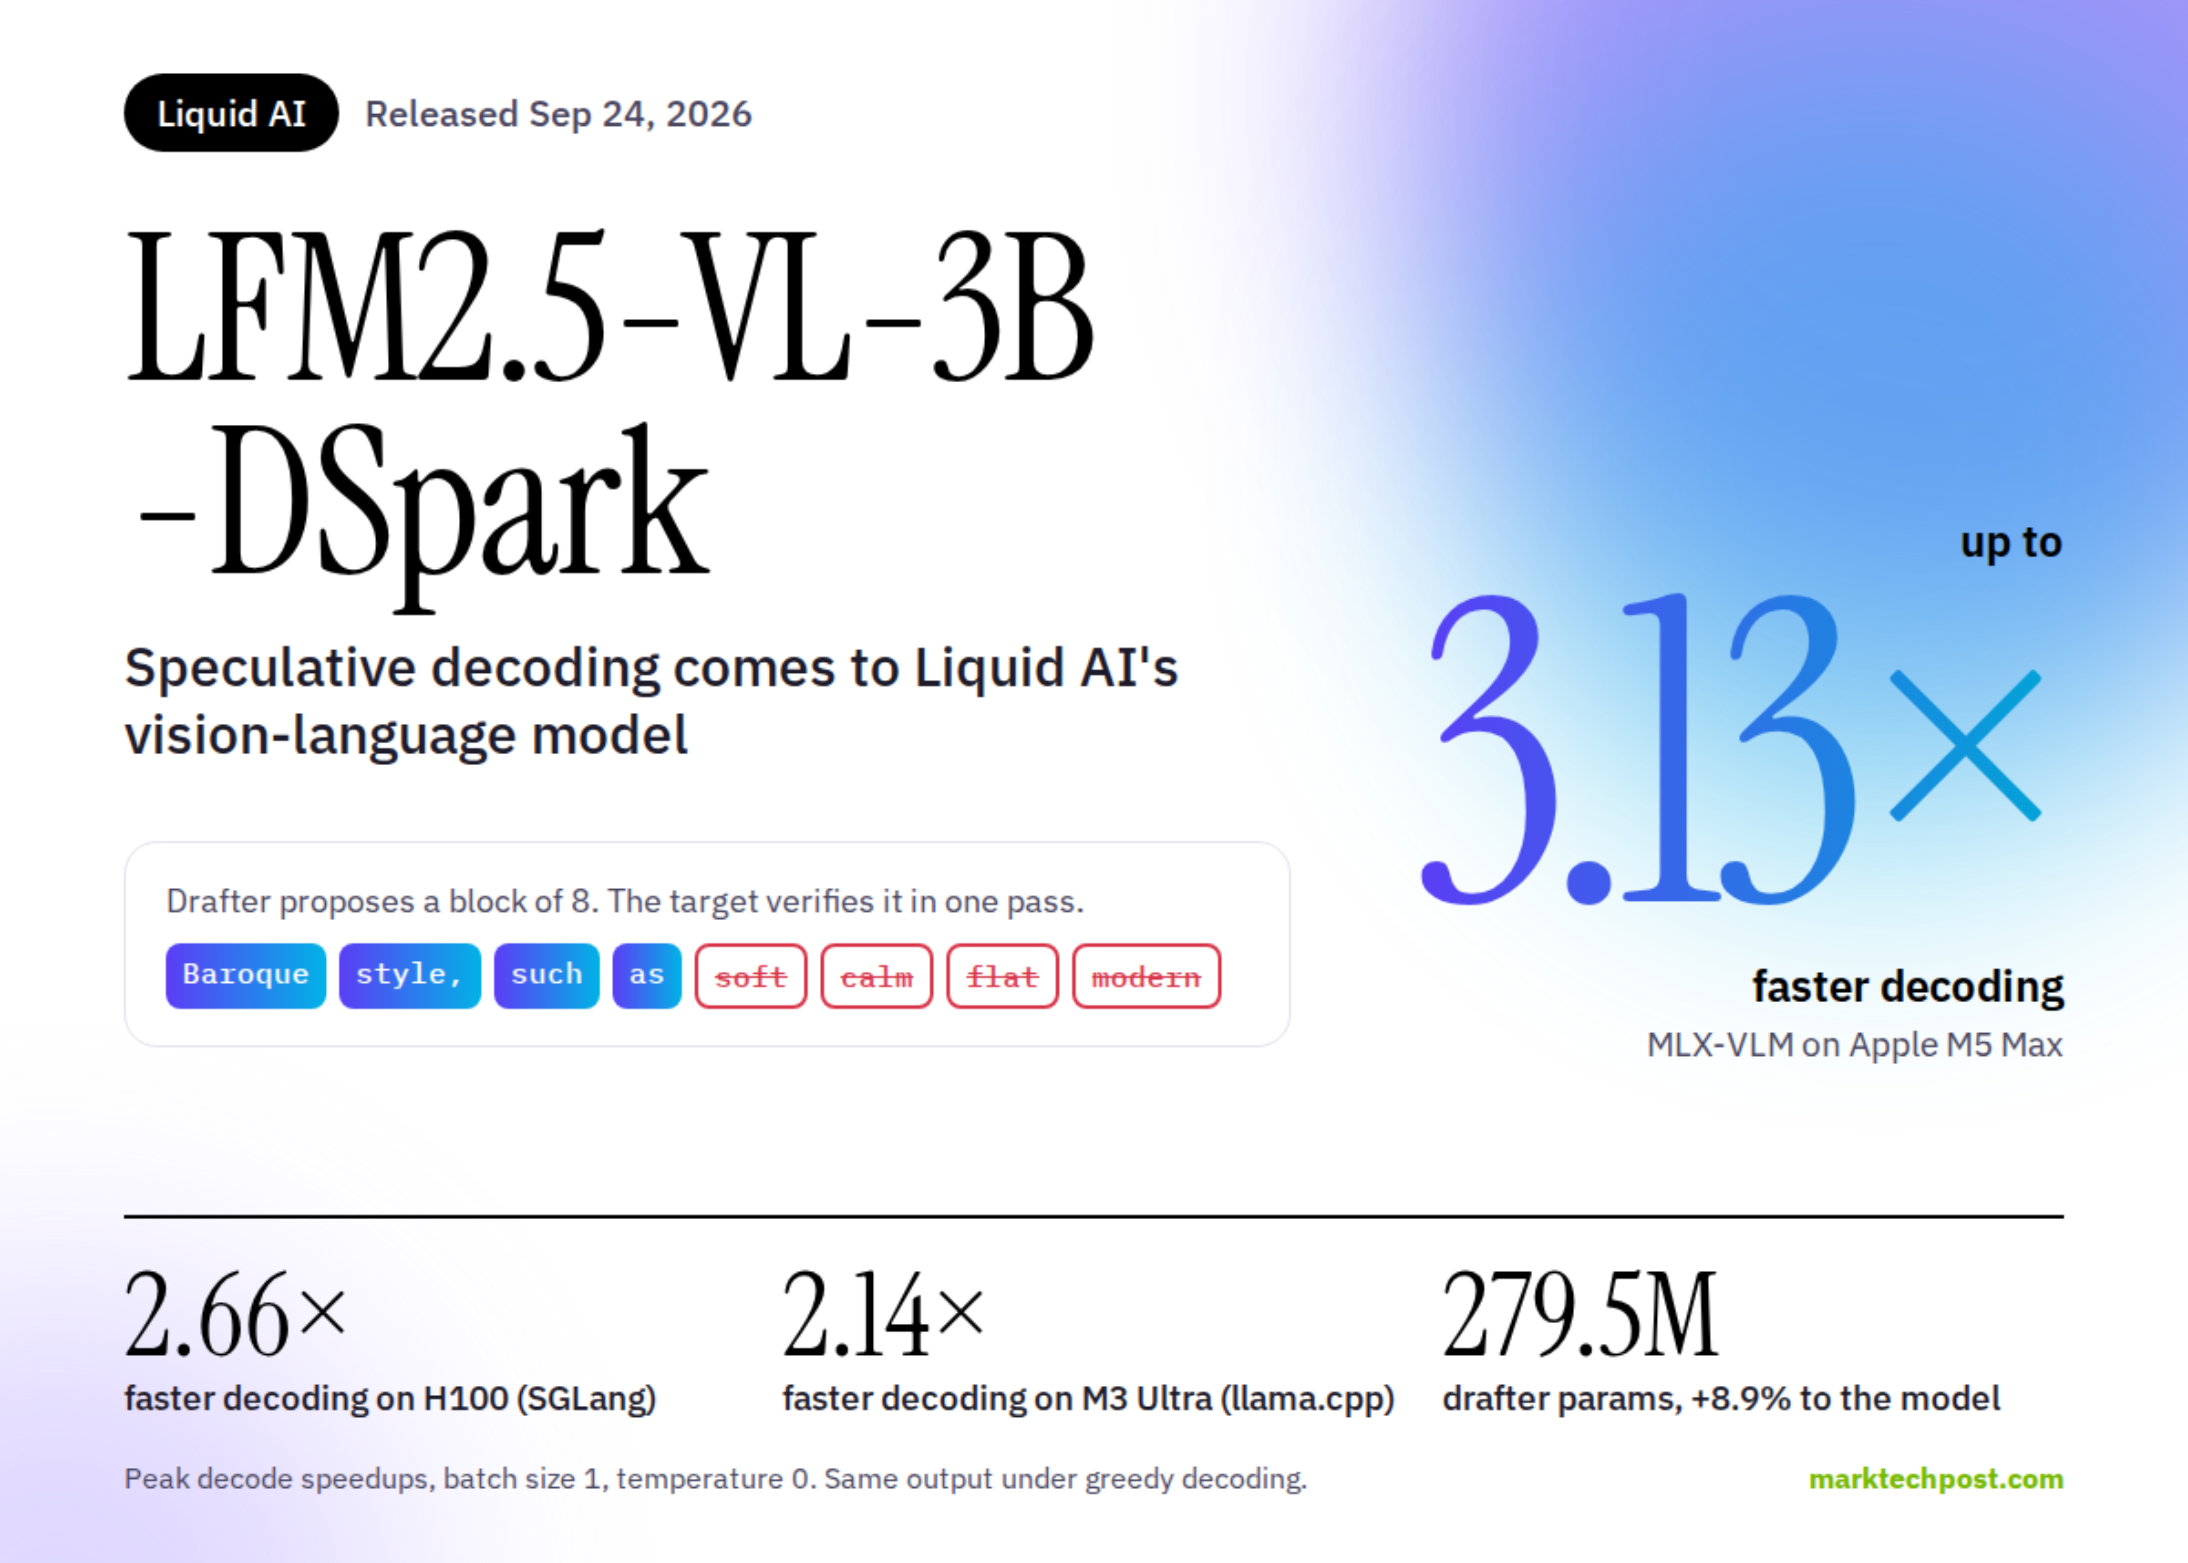
Я регулярно слежу за релизами в сфере искусственного интеллекта и тестирую передовые инструменты обработки данных. Недавно компания Liquid AI анонсировала экспериментальный проект LFM2.5-VL-3B-DSpark — специальную модель-драфтер для ускоренного спекулятивного декодирования в своей мультимодальной языковой модели LFM2.5-VL-3B. Этот модуль добавляет около 280 миллионов параметров и позволяет кратно повысить скорость генерации токенов без какого-либо ущерба для итогового результата.
Согласно отчету разработчиков, прирост скорости декодирования достигает 3.13x на оборудовании Apple silicon и до 2.66x на графических ускорителях NVIDIA H100. Веса уже опубликованы на платформе Hugging Face в форматах Safetensors и GGUF, а софтверная поддержка встроена в SGLang, MLX-VLM и llama.cpp с первого дня. Релиз имеет статус экспериментального и распространяется по лицензии LFM Open License v1.0, разрешающей бесплатное коммерческое использование компаниям с годовой выручкой менее 10 миллионов долларов.
Как спекулятивное декодирование меняет работу VLM
Стандартная архитектура языковых моделей выдает строго по одному токену за каждый проход вперед. Спекулятивное декодирование решает эту проблему за счет вспомогательной компактной модели-драфтера, которая самостоятельно прогнозирует сразу несколько токенов наперед. Затем крупная целевая модель проверяет весь этот блок за один единственный проход и сохраняет те элементы, с которыми согласна.
Архитектура DSpark базируется на концепциях из текстовых моделей Liquid AI, подробно описанных в профильной документации. Драфтер считывает скрытые состояния базовой модели с нескольких слоев и предсказывает следующие k токенов. Главный инженерный нюанс заключается в том, что модальность входных данных для drafter не имеет значения: к моменту попадания в скрытые слои текстовые фрагменты и графические патчи превращаются в обычные тензоры. Благодаря этому команда смогла задействовать абсолютно тот же алгоритм инференса для мультимодальной нейросети.
Архитектура драфтера и особенности обучения
Модель-драфтер представляет собой упрощенную структуру, построенную исключительно на механизмах внимания. Серия экспериментов и тестов показала оптимальность конфигурации из 4 слоев с длиной блока равной 9. При практическом запуске я рекомендую использовать размер блока 8 или 9 в зависимости от используемого «железа», причем для систем на базе Apple silicon стандартным значением выступает 8.
Эмбеддинги и голова языковой модели (LM head) жестко привязаны к целевой модели, поэтому сам драфтер не дублирует их в своей структуре. По расчетам Liquid AI, это увеличивает общее количество развернутых параметров всего на 8.9%. Процесс обучения включал этап супервизированной тонкой настройки на массиве данных, охватывающем стандартные задачи компьютерного зрения и работы с текстом в течение 10 эпох. Все тестовые испытания и тренировки проводились исключительно на вычислительном оборудовании от AMD.
Результаты бенчмарков и производительность
Оценка эффективности выполнялась с помощью бенчмарка MMSpec по шести ключевым категориям задач: общему визуальному вопросно-ответному анализу (General VQA), работе с текстом на изображениях (Text VQA), генерации подписей к фото, анализу графиков и диаграмм, сложным логическим рассуждениям, а также многошаговым диалогам. Все запуски производились с размером батча 1, нулевой температурой сэмплирования и 16-битными весами для визуального энкодера и основного бэкенда. Данные собирались на фирменной инфраструктуре тестирования устройств Pipette.
Показатели максимального ускорения декодирования и комплексного end-to-end прироста часто фиксируются на разных сценариях. Так, на чипе M5 Max пиковое ускорение декодирования в 3.13x было получено на задаче описания изображений COCO, тогда как общий прирост производительности системы на 2.62x зафиксирован в тесте MMMU-Pro. Процент принятых токенов оказался сопоставимым на обоих стеках Apple, что указывает на зависимость этого параметра от рабочей нагрузки и самого драфтера, а не от особенностей рантайма. При работе с более высоким уровнем параллелизма (concurrency) модель DSpark сохраняла преимущество по пропускной способности на одиночной карте H100 в среде SGLang, хотя этот разрыв постепенно сокращается при росте нагрузки.
Качество генерации и влияние температуры
В режиме жадного декодирования (greedy decoding) целевая модель верифицирует каждый предложенный токен, поэтому генерируемый текст в точности совпадает с результатами работы базовой модели. При использовании ненулевых значений температуры с согласованным сэмплированием спекулятивное декодирование полностью сохраняет исходное распределение вероятностей целевой модели, что математически доказано в профильных исследованиях.
Тем не менее, температура напрямую влияет на скорость работы. Повышение температуры приводит к тому, что вероятности распределяются между более широким кругом потенциальных кандидатов, из-за чего драфтер и основная модель начинают расходиться в прогнозах гораздо чаще. Как показали тесты разработчиков, подобные условия закономерно снижают количество принятых токенов и общую производительность.
Почему прирост End-to-End на мобильных и краевых устройствах меньше
Важно понимать, что спекулятивное декодирование оптимизирует исключительно фазу генерации текста. Процессы кодирования изображений и предварительного заполнения контекста (prefill) выполняются с прежней скоростью. Мультимодальная модель обязана сначала обработать картинку, а затем пропустить через себя сотни визуальных токенов одновременно с пользовательским промптом.
На компактных и пограничных (edge) устройствах, обладающих меньшей вычислительной мощностью по сравнению с серверными датацентрами, стадия префилла занимает значительную долю общей задержки. Инженеры объясняют это ограничением через закон Амдаля: суммарное ускорение системы всегда ограничивается той ее частью, которая осталась без оптимизации. Именно этим объясняются ситуации, когда на M5 Max трехкратное ускорение процесса декодирования в задачах TextVQA трансформируется в скромный 1.56-кратный прирост всей системы в целом.
Как запустить новую модель на практике
Для интеграции в экосистему SGLang потребуется версия не ниже v0.5.19. Запуск базовой модели LiquidAI/LFM2.5-VL-3B выполняется с дополнительными флагами --speculative-algorithm DSPARK, а параметр --speculative-draft-model-path указывает путь к файлу драфтера. Пользователям техники Apple на кремниевых чипах понадобится фреймворк MLX-VLM версии v0.7.2 или новее, где подключение осуществляется через аргумент --draft-model. Стоит учитывать, что текущая реализация DSpark в MLX-VLM поддерживает исключительно жадное сэмплирование, поэтому параметр температуры необходимо принудительно установить на ноль. Для работы в llama.cpp нужно скомбинировать GGUF-версию драфтера с целевой моделью LFM2.5-VL-3B-GGUF.
Все необходимые доработки кода уже опубликованы в виде открытых pull requests для репозиториев llama.cpp, SGLang и MLX-VLM. При этом официальная поддержка ускорения для предварительно квантованных моделей пока не входит в рамки данного первоначального релиза и появится позже.
