
Тэг
спекулятивное декодирование
01.
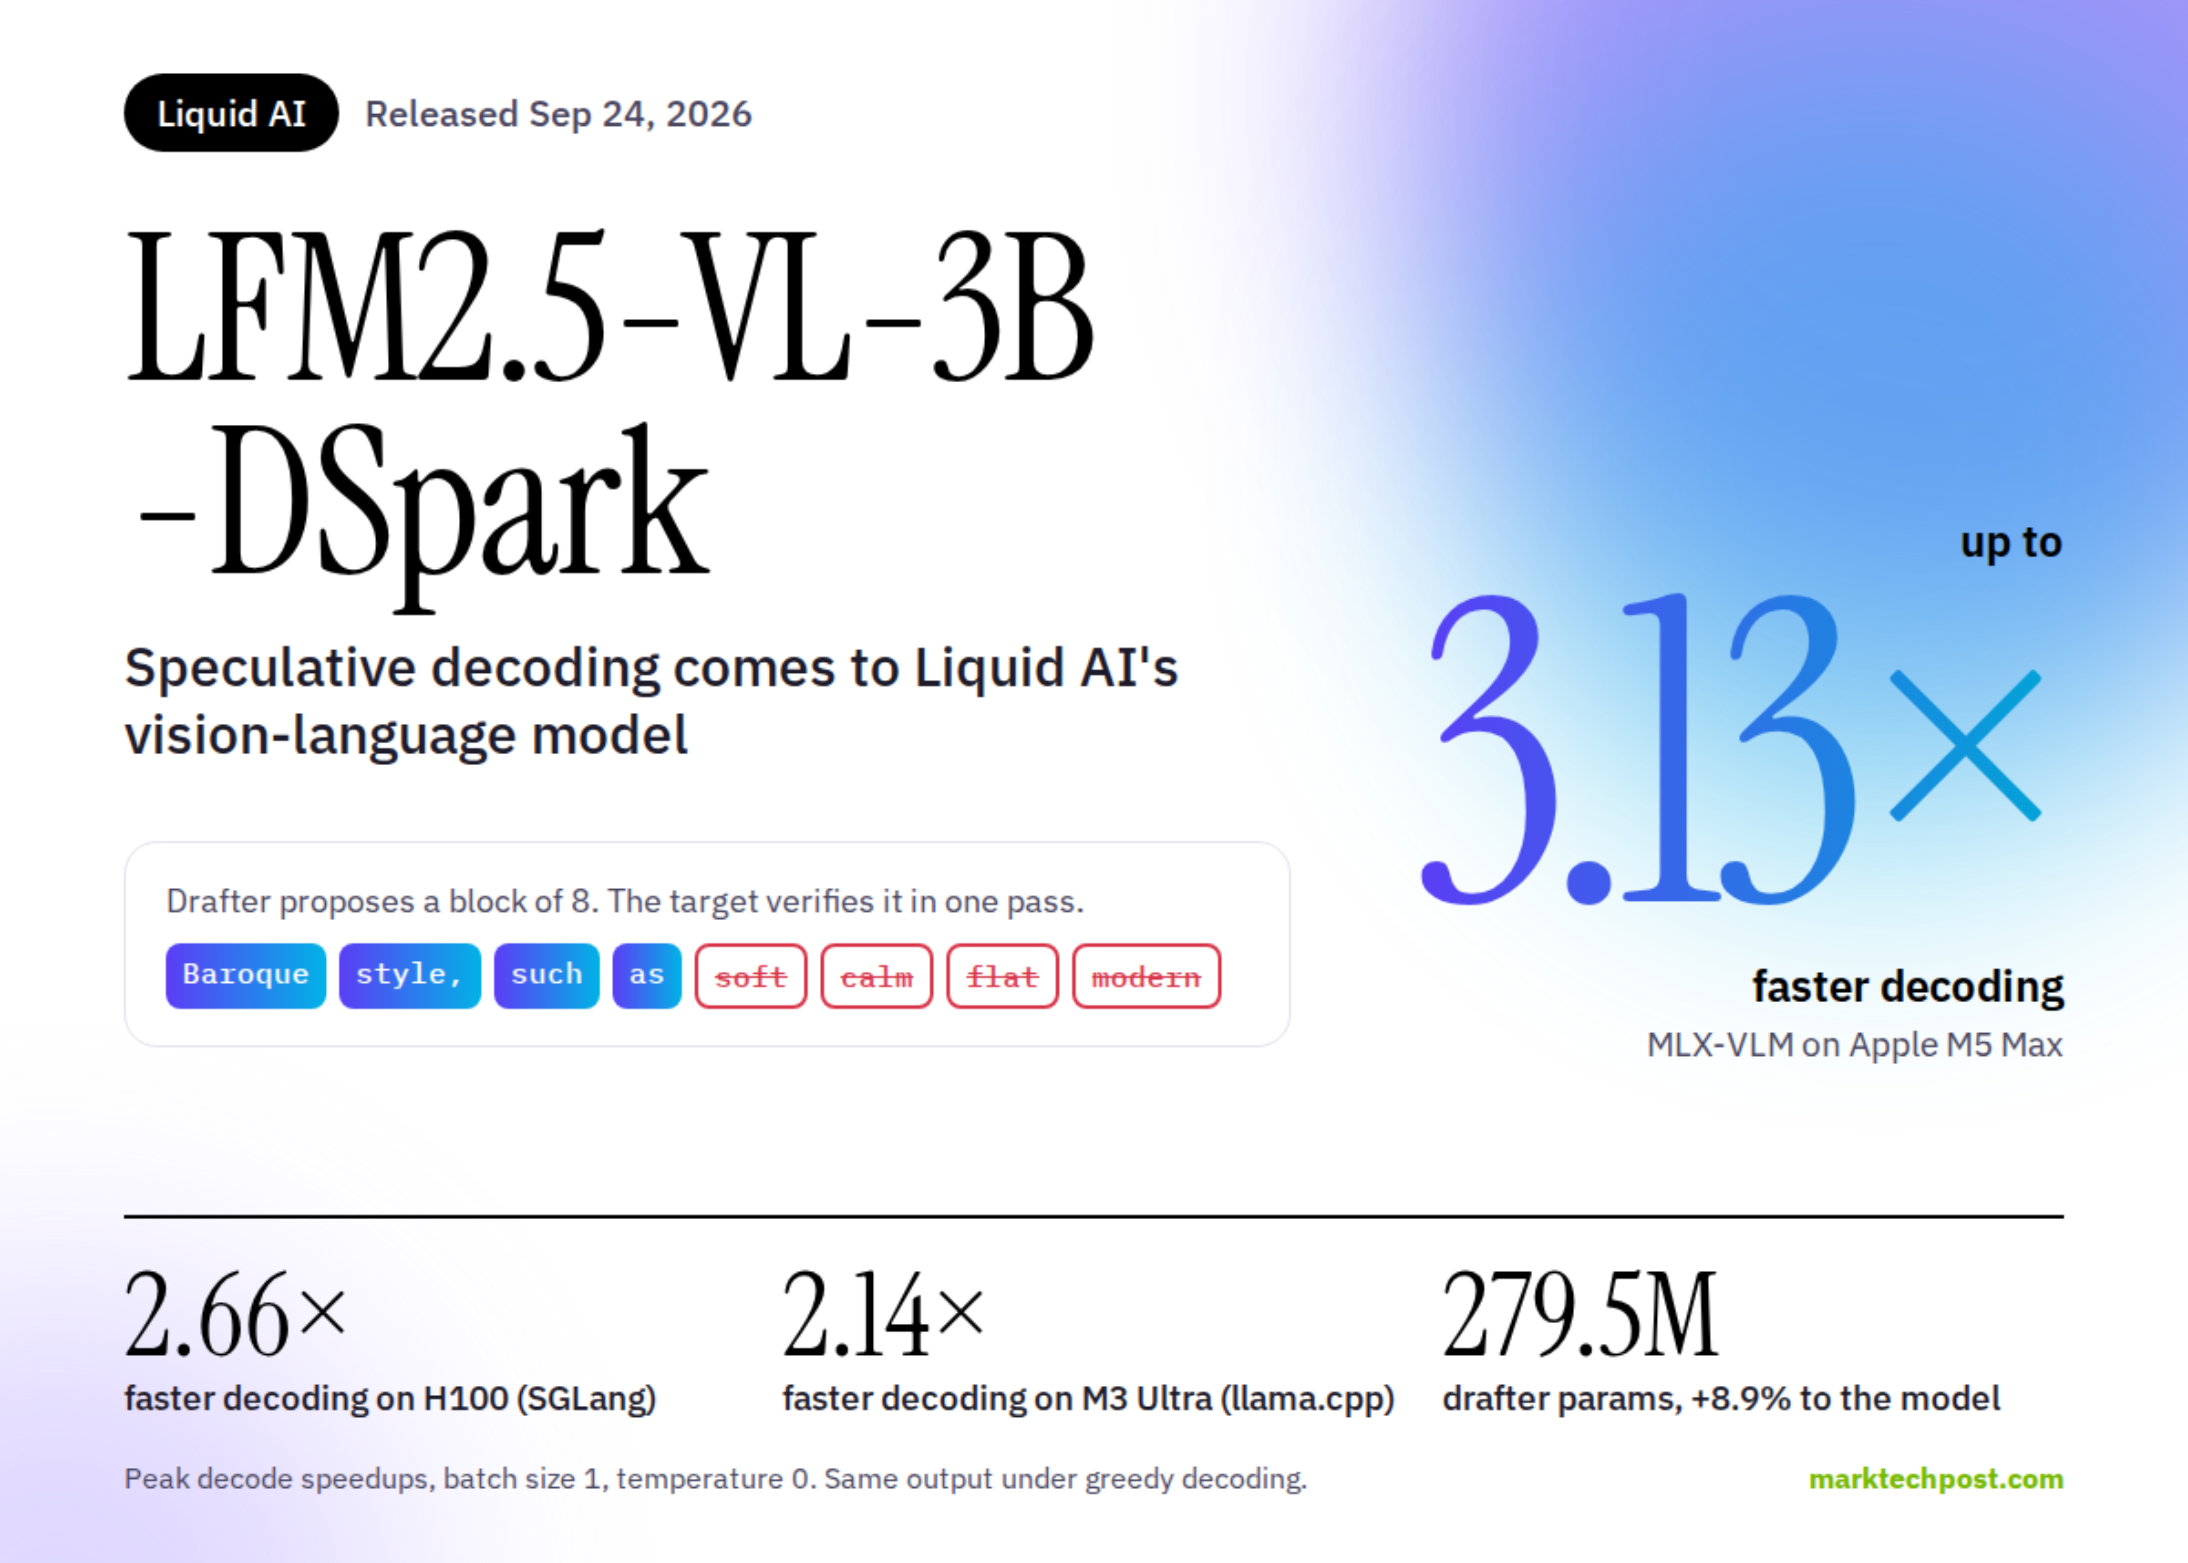
Liquid AI представила LFM2.5-VL-3B-DSpark: ускорение генерации для мультимодальных моделей
Liquid AI выпустила экспериментальный модуль LFM2.5-VL-3B-DSpark для ускорения мультимодальных моделей на базе спекулятивного декодирования.
Читать далее
02.
Ускорение визуально-языковых моделей с помощью LFM2.5-VL-DSpark
Обзор новой модели LFM2.5-VL-DSpark от Liquid AI: ускорение визуально-языковых моделей с помощью спекулятивного декодирования, архитектура и инструкции по запуску.
Читать далее
03.
Тестируем DFlash от Nvidia: почему вместо обещанных 15x мы получаем 2,3x и когда технология бесполезна
Провел детальное тестирование технологии DFlash от Nvidia на видеокарте RTX 6000 PRO. Разбираем, почему вместо обещанного 15-кратного ускорения LLM получается 2,3x при одиночном запросе и просадка при батчинге.
Читать далее
04.
Ускорение инференса LFM2.5: технология DSpark повышает скорость генерации до 3,2 раз
2026-08-31 Нейросети и AI
Интеграция алгоритма спекулятивного декодирования DSpark в модели LFM2.5 от Liquid AI позволила увеличить скорость генерации текста до 3,2 раз как на серверных GPU, так и на локальных устройствах Apple Mac.
Читать далее

01.
