
Мой блог
Масштабная миграция игровой инфраструктуры: опыт перехода четырех миллионов пользователей

Масштабный перенос многомиллионной аудитории на новую программную платформу требует тщательного планирования и учета множества инфраструктурных факторов. Проведение подобных процедур сопряжено с серьезными техническими вызовами, необходимостью оптимизации баз данных и устранением непредвиденных сбоев.
Подготовка к крупным технологическим переездам включает в себя изменение стека технологий, оценку пропускной способности и грамотное распределение серверных ресурсов.
Что переезжало и зачем
Исходная архитектура мобильного продукта представляла собой монолитное решение на PHP с большим количеством фоновых задач и тяжелым фронтендом на движке Unity. Для хранения информации использовались MySQL, Redis и object storage, а маршрутизацию трафика обеспечивал классический nginx. Все эти компоненты функционировали на физических серверах.
Необходимость обновления инфраструктуры была обусловлена несколькими факторами. Среди них выделялись продуктовые требования, включая устаревший дизайн и необходимость перехода на современные технологии вроде Flutter для фронтенда и Go для микросервисной архитектуры бэкенда. Набор баз данных также претерпел изменения: вместо прежних решений начали использовать Postgres, Valkey, Redpanda, Cassandra, OpenSearch и хранилища объектов. Stateless-сервисы были размещены в managed Kubernetes на платформе DigitalOcean, а stateful-компоненты запущены на виртуальных машинах. Для российских игроков часть инфраструктуры изначально разворачивалась в Yandex Cloud.
Подход первый: нагрузочные тесты, которые ничего не доказали
Первые оценки производительности строящейся версии начались примерно за год до основного запуска. Из-за невозможности полностью воссоздать исходный стенд разработчики использовали сценарии для Grafana k6, проверяя показатели latency и пропускной способности на единицу ресурсов. При небольшом количестве запросов ответы укладывались в стандартные рамки, однако более высокая нагрузка быстро исчерпывала выделенные мощности.
Попытки сопоставить нагрузку старой и новой версий через прямую экстраполяцию не принесли ясности из-за принципиальных отличий в архитектуре. Первый этап выявил важную закономерность: жесткие лимиты по процессорному времени в Kubernetes приводили к необоснованному росту задержек даже при наличии свободных ресурсов на ноде, поэтому от CPU-limits решили отказаться.
Подход второй: меняем фундамент на ходу
За несколько месяцев до завершающего этапа миграции разработчикам пришлось экстренно внедрять изменения. Отказ от open-source модели ScyllaDB потребовал переезда на Cassandra. Изменения затронули и сетевой уровень: вместо классического Ingress-контроллера была реализована миграция на Gateway API с использованием Envoy. Вместо Redis был выбран Valkey для лучшего параллелизма ввода-вывода.
Отдельной задачей стало конфигурирование автоматического масштабирования подов (HPA) и расчет ресурсов для микросервисов. На этом этапе инфраструктуру решили масштабировать с запасом надежности, чтобы избежать отказов в момент пиковых нагрузок.
Подход третий: агент с доступом ко всему
Для выявления потенциальных узких мест перед масштабным переездом был задействован AI-ассистент Claude Code, которому предоставили доступ к репозиториям кода, логам, метрикам и Kubernetes-кластерам. Агент сформировал приоритетный список рисков перед тестовой волной.
Волна на 200 тысяч
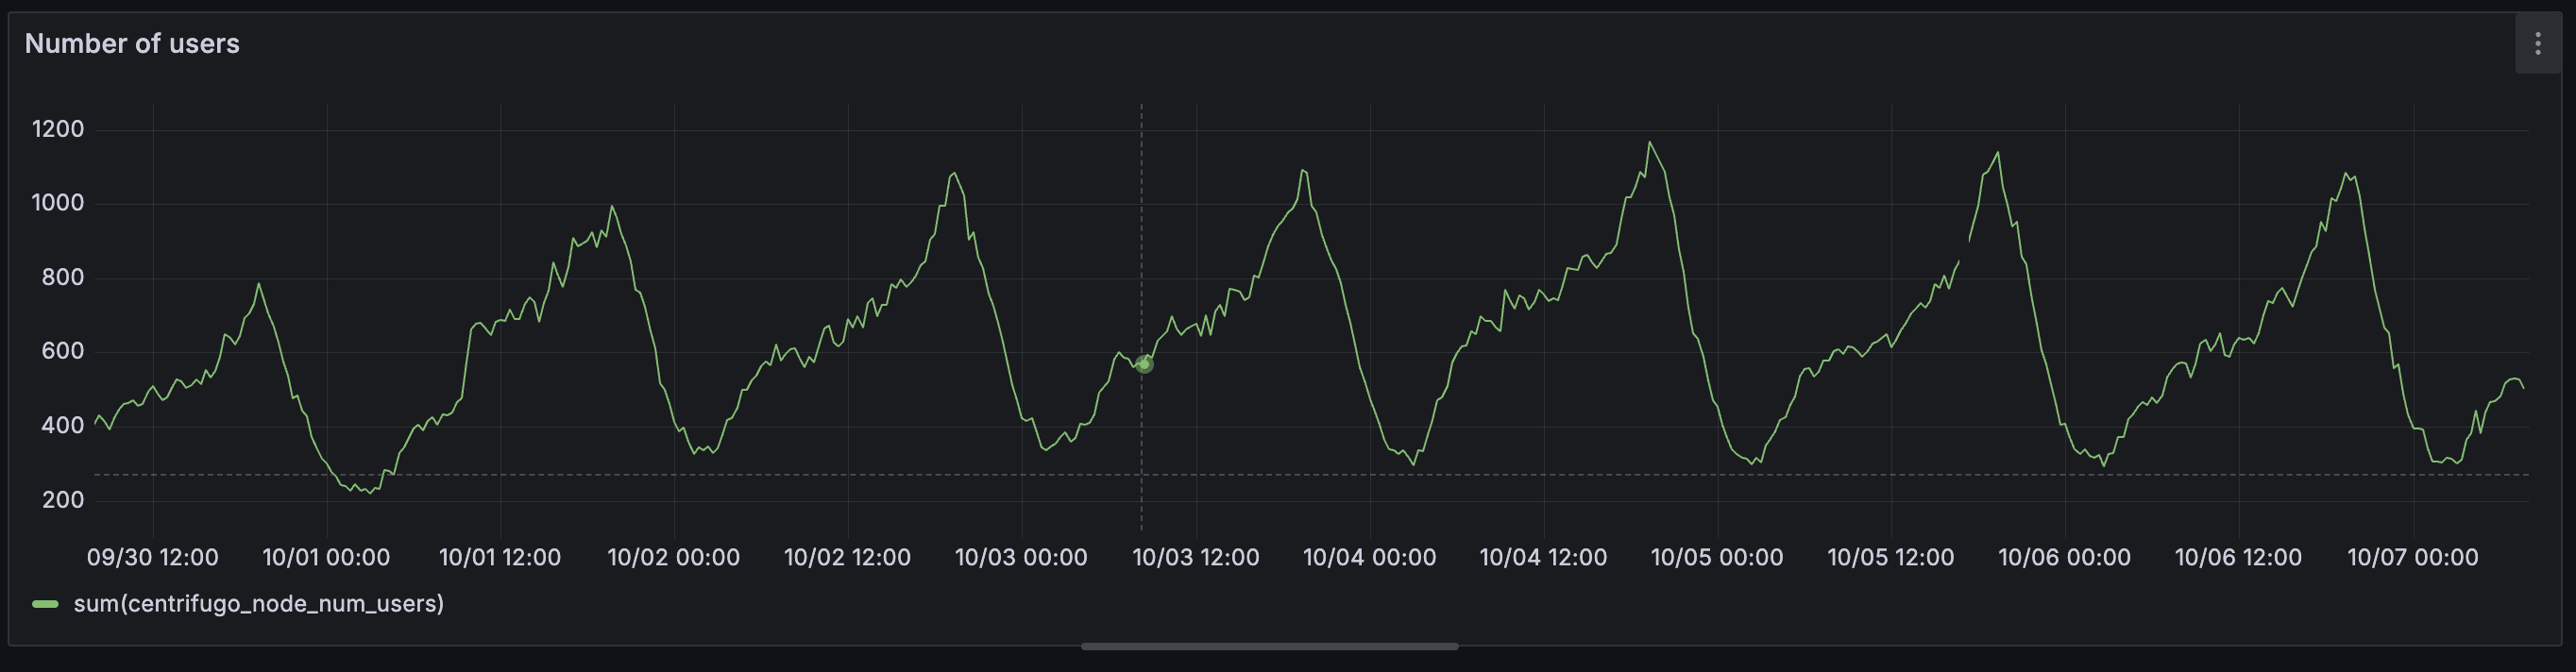
Для проверки готовности системы был выполнен тестовый перенос двухсот тысяч игроков. Это позволило оценить поведение балансировщиков и бэкендов в реальных условиях. Мониторинг ключевых показателей через Centrifugo помог отследить рост числа активных подключений в моменте.
Таблица на 599 строк, которую прочитали 310 миллионов раз
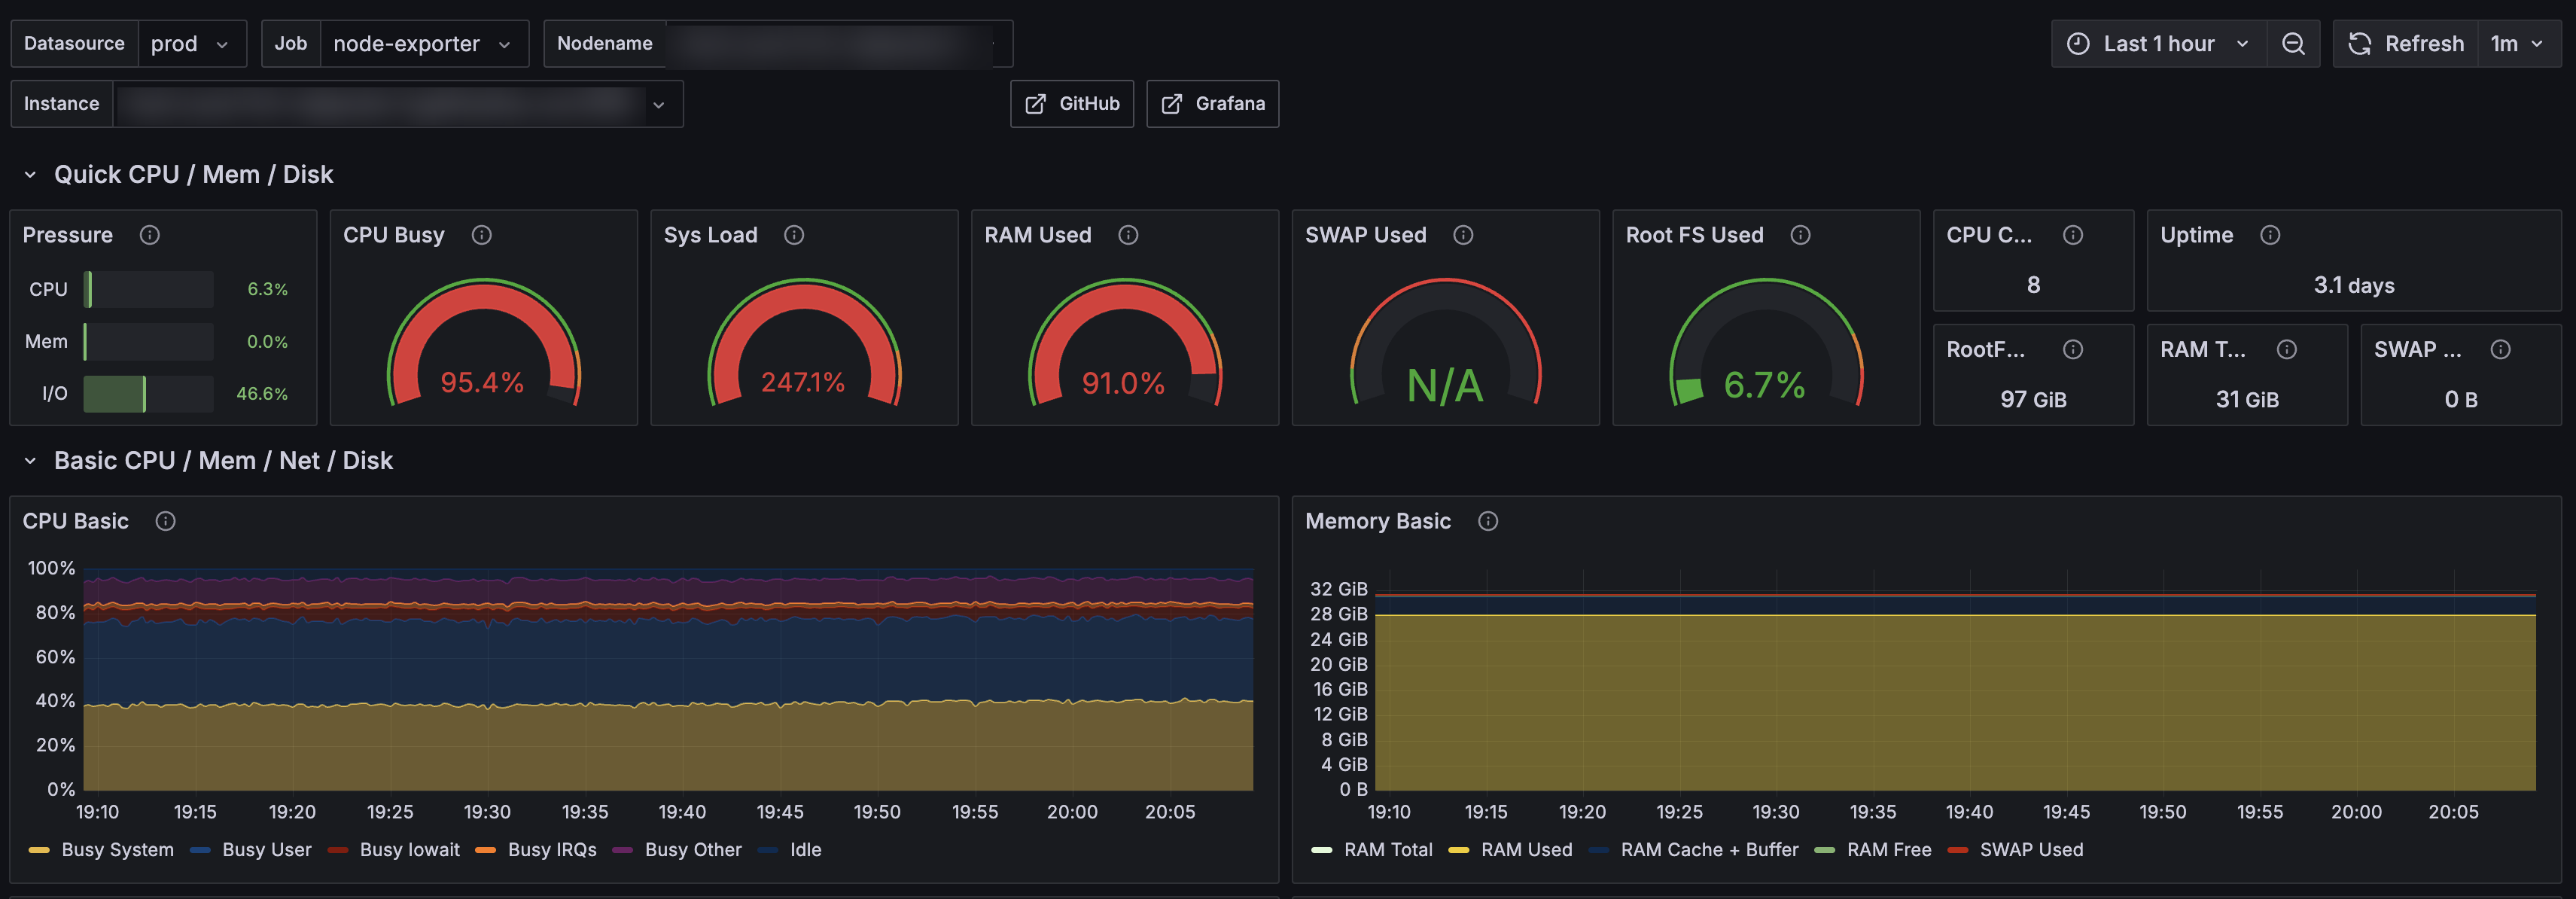
Анализ данных, проведенный с помощью искусственного интеллекта, выявил неоптимальный запрос в Postgres, который полностью сканировал небольшую таблицу при каждом вызове. В результате крошечная таблица с 599 строками была прочитана сотни миллионов рублей раз, создавая избыточную нагрузку на процессор.
Гистограммы, которые съедали Prometheus
Метрики производительности сервисов генерировали множество временных рядов, способных исчерпать лимиты памяти мониторинга. Для решения этой проблемы был настроен relabeling данных прямо при сборе, а также внедрены заранее рассчитанные правила агрегации.
Перекосы в хранилищах
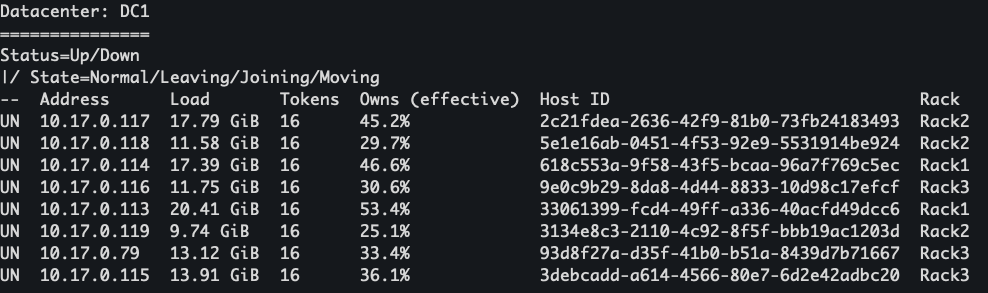
В распределенных хранилищах Redpanda и Cassandra обнаружилось неравномерное распределение данных между узлами. Перед основным этапом миграции специалисты провели необходимую ребалансировку кластеров.
Потолок масштабирования
Проверка выявила жесткое ограничение anti-affinity, при котором на одной ноде мог находиться лишь один под определенного сервиса. Под нагрузкой это привело бы к исчерпанию доступных узлов в пуле, поэтому правило было скорректировано.
Гипотезы против данных
Инструменты автоматического анализа помогли отсечь ошибочные предположения команды о системных сбоях, доказав, что часть проблем вызвана повторными запросами на стороне клиента или особенностями работы самого приложения.
Облако, которого больше нет
За сутки до запланированного переноса инфраструктура в российской зоне доступности Yandex Cloud оказалась недоступна из-за внешней сетевой атаки. Поскольку создать резервные мощности в других зонах не удалось, команда оперативно перенесла Kubernetes-кластер в альтернативное облачное окружение с помощью автоматизированных скриптов всего за несколько часов.
Последний поворот: старые клиенты
Перед самым стартом выяснилось, что часть пользователей со старыми версиями клиентов отправляет запросы на основной домен, требуя особой маршрутизации. Специалисты оперативно настроили правила перенаправления трафика через Envoy.
День миграции
Перенос данных выполнялся через логические вызовы API, поскольку структуры старой и новой версий существенно различались. Процесс потребовал временного отключения игры примерно на два часа, в течение которых производилась блокировка сущностей, обновление клиентской части и переключение записей DNS.
Сколько запросов на самом деле делает новый клиент
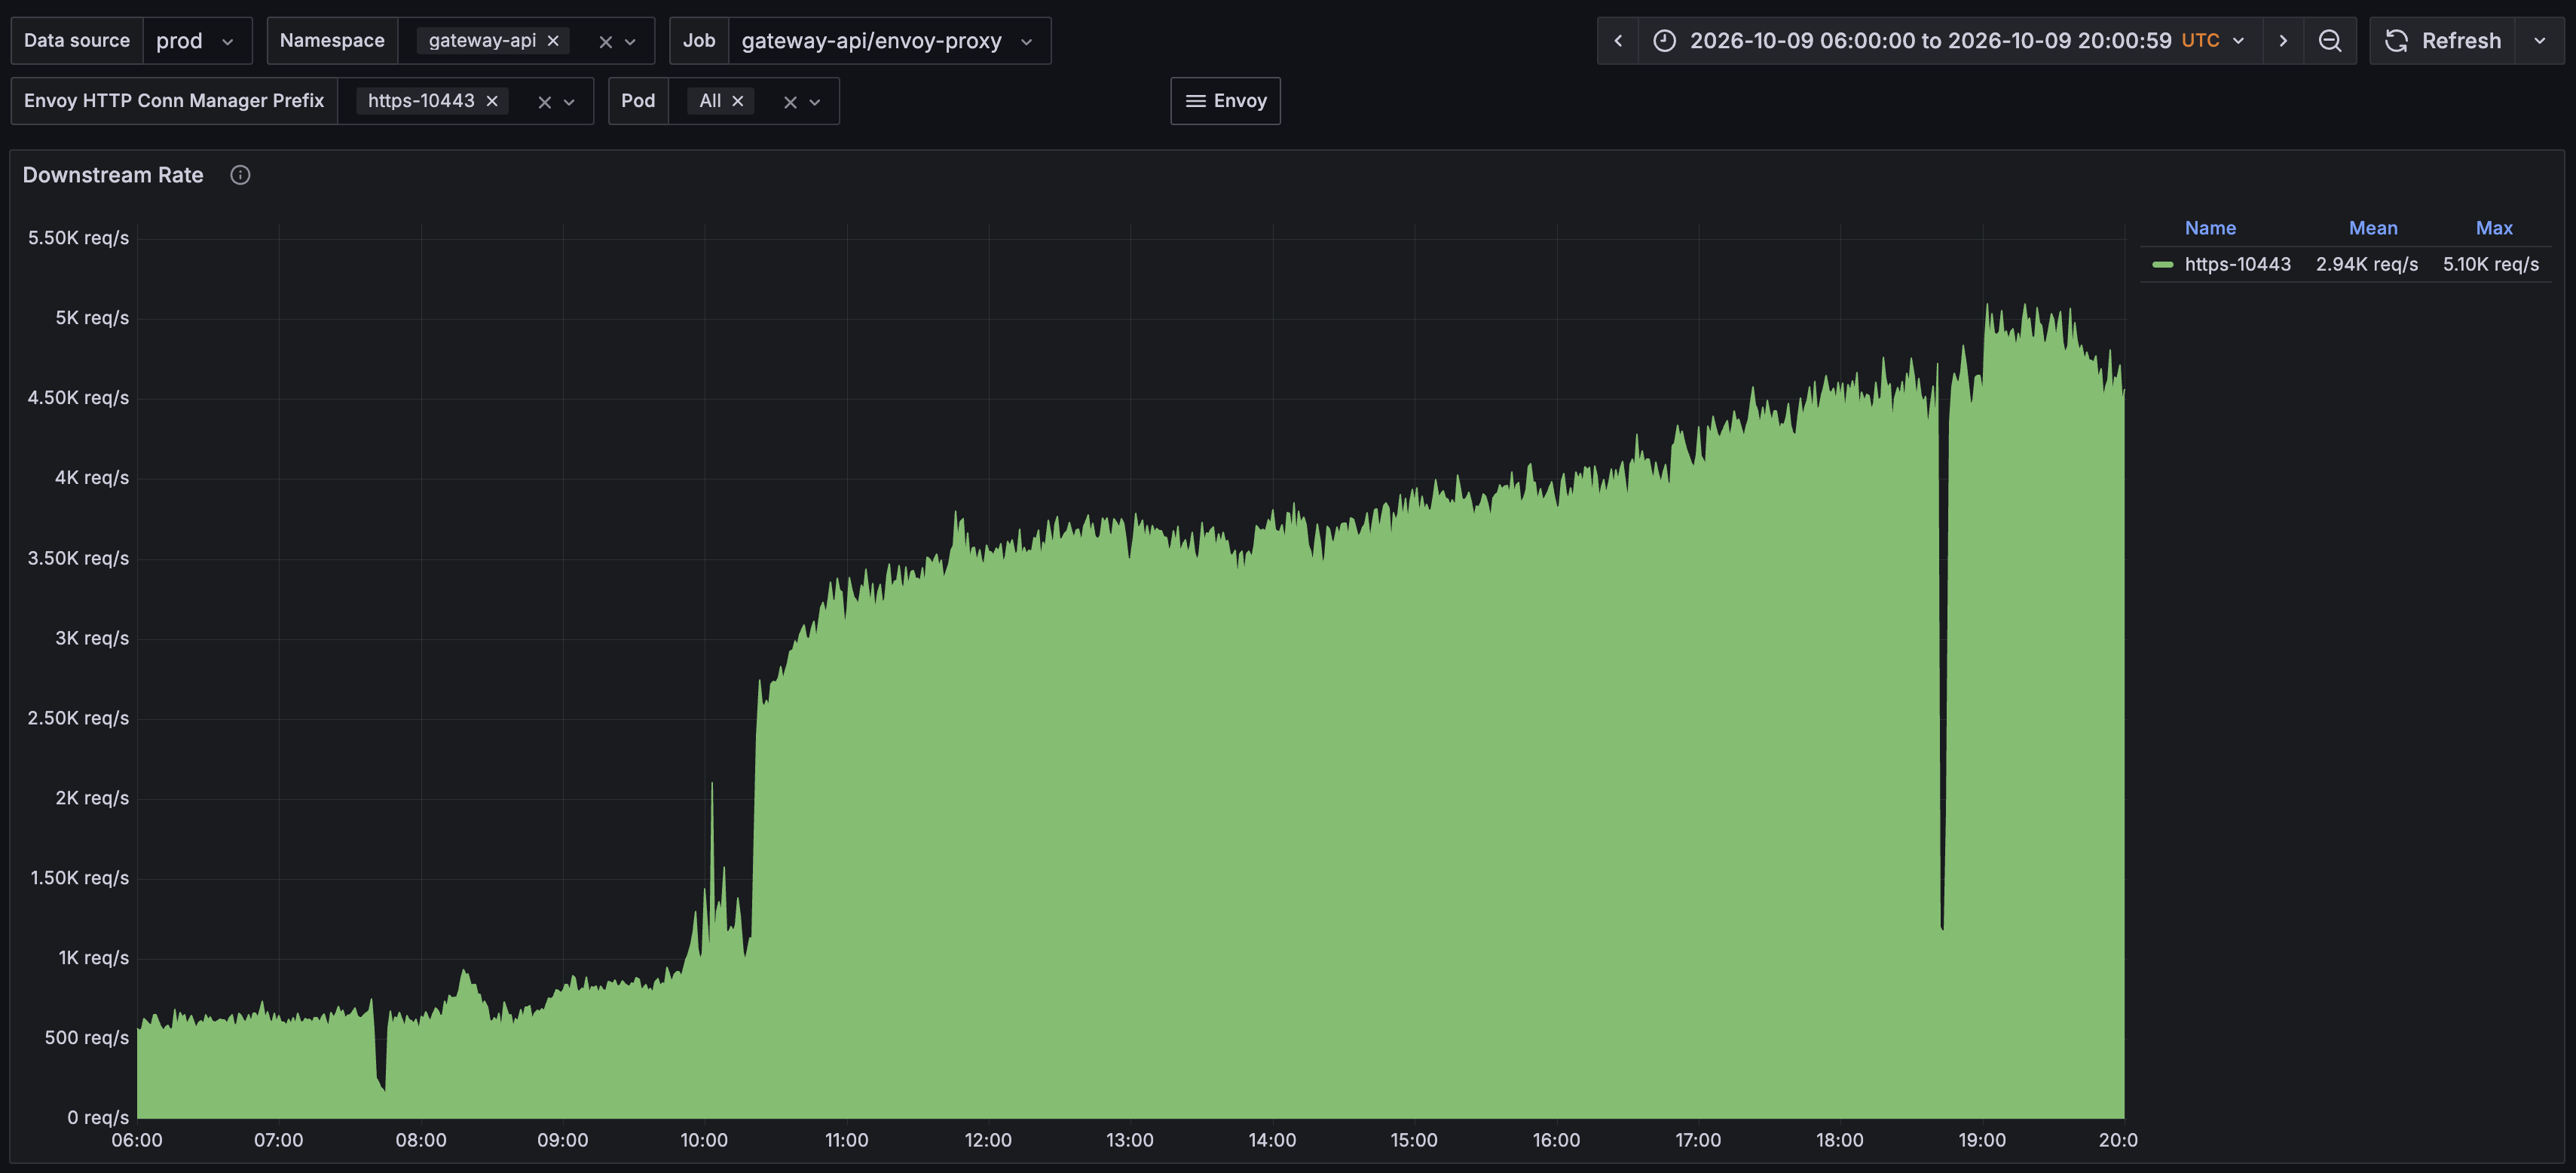
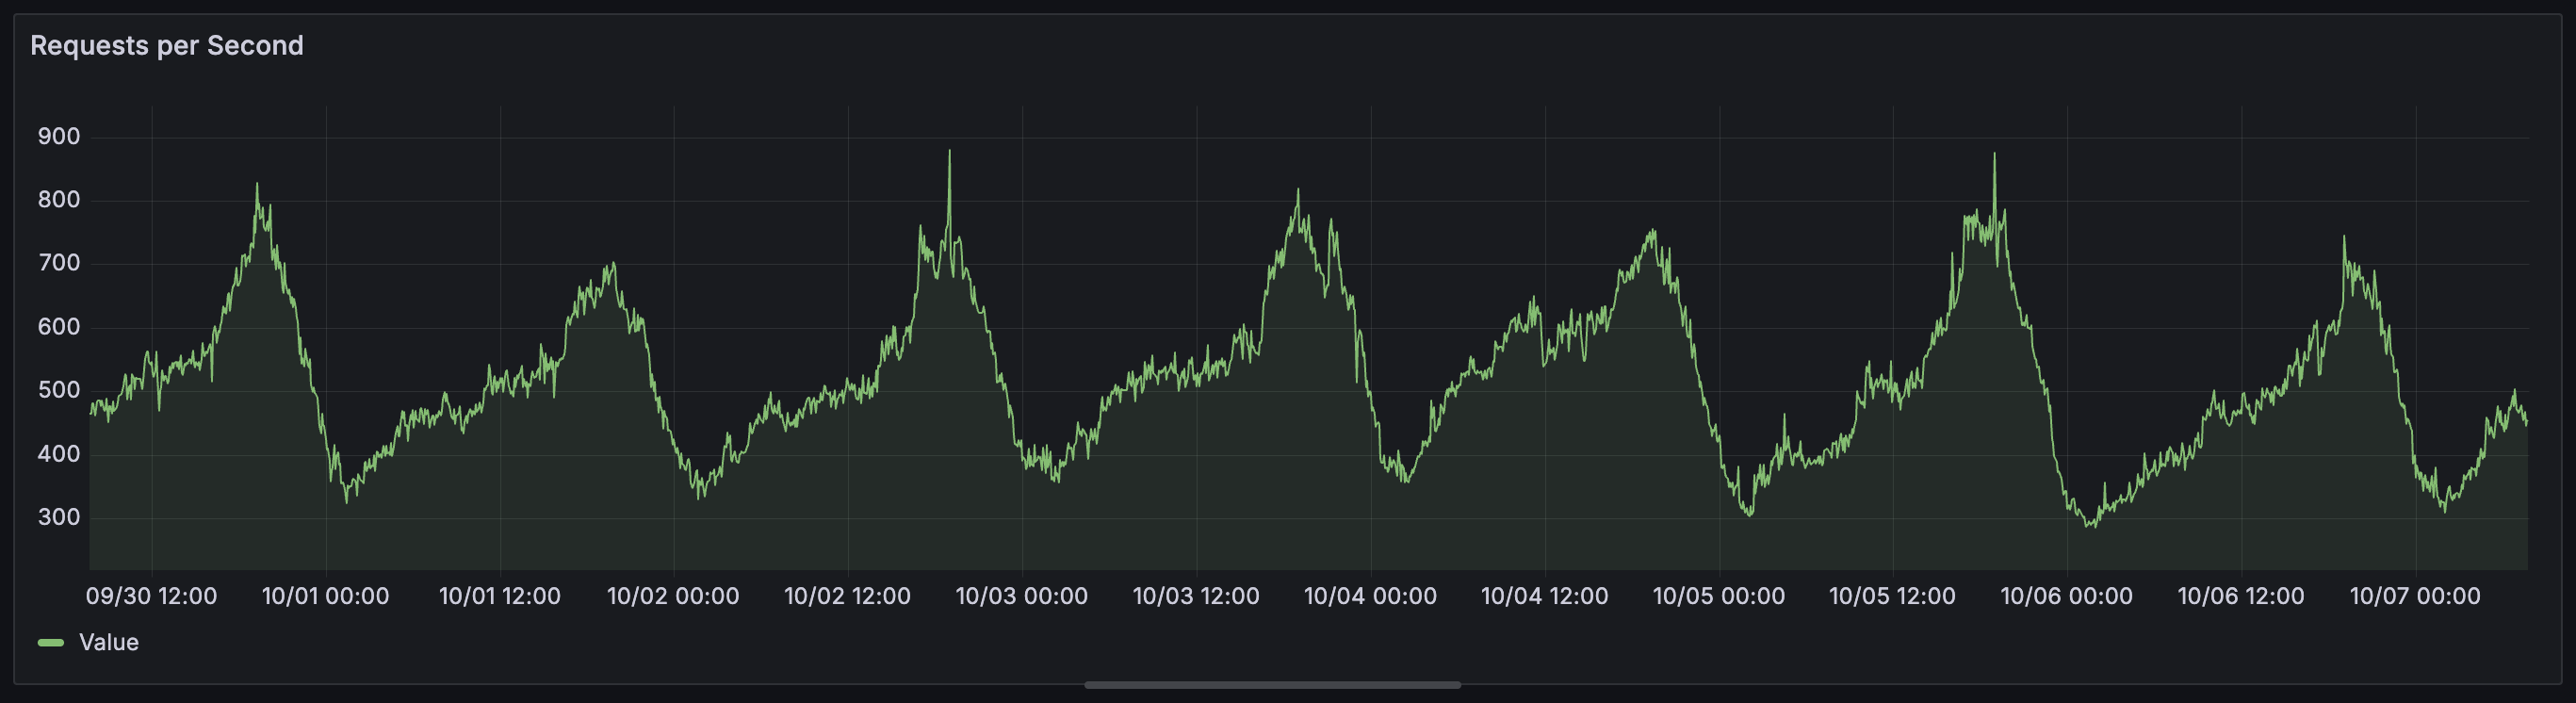
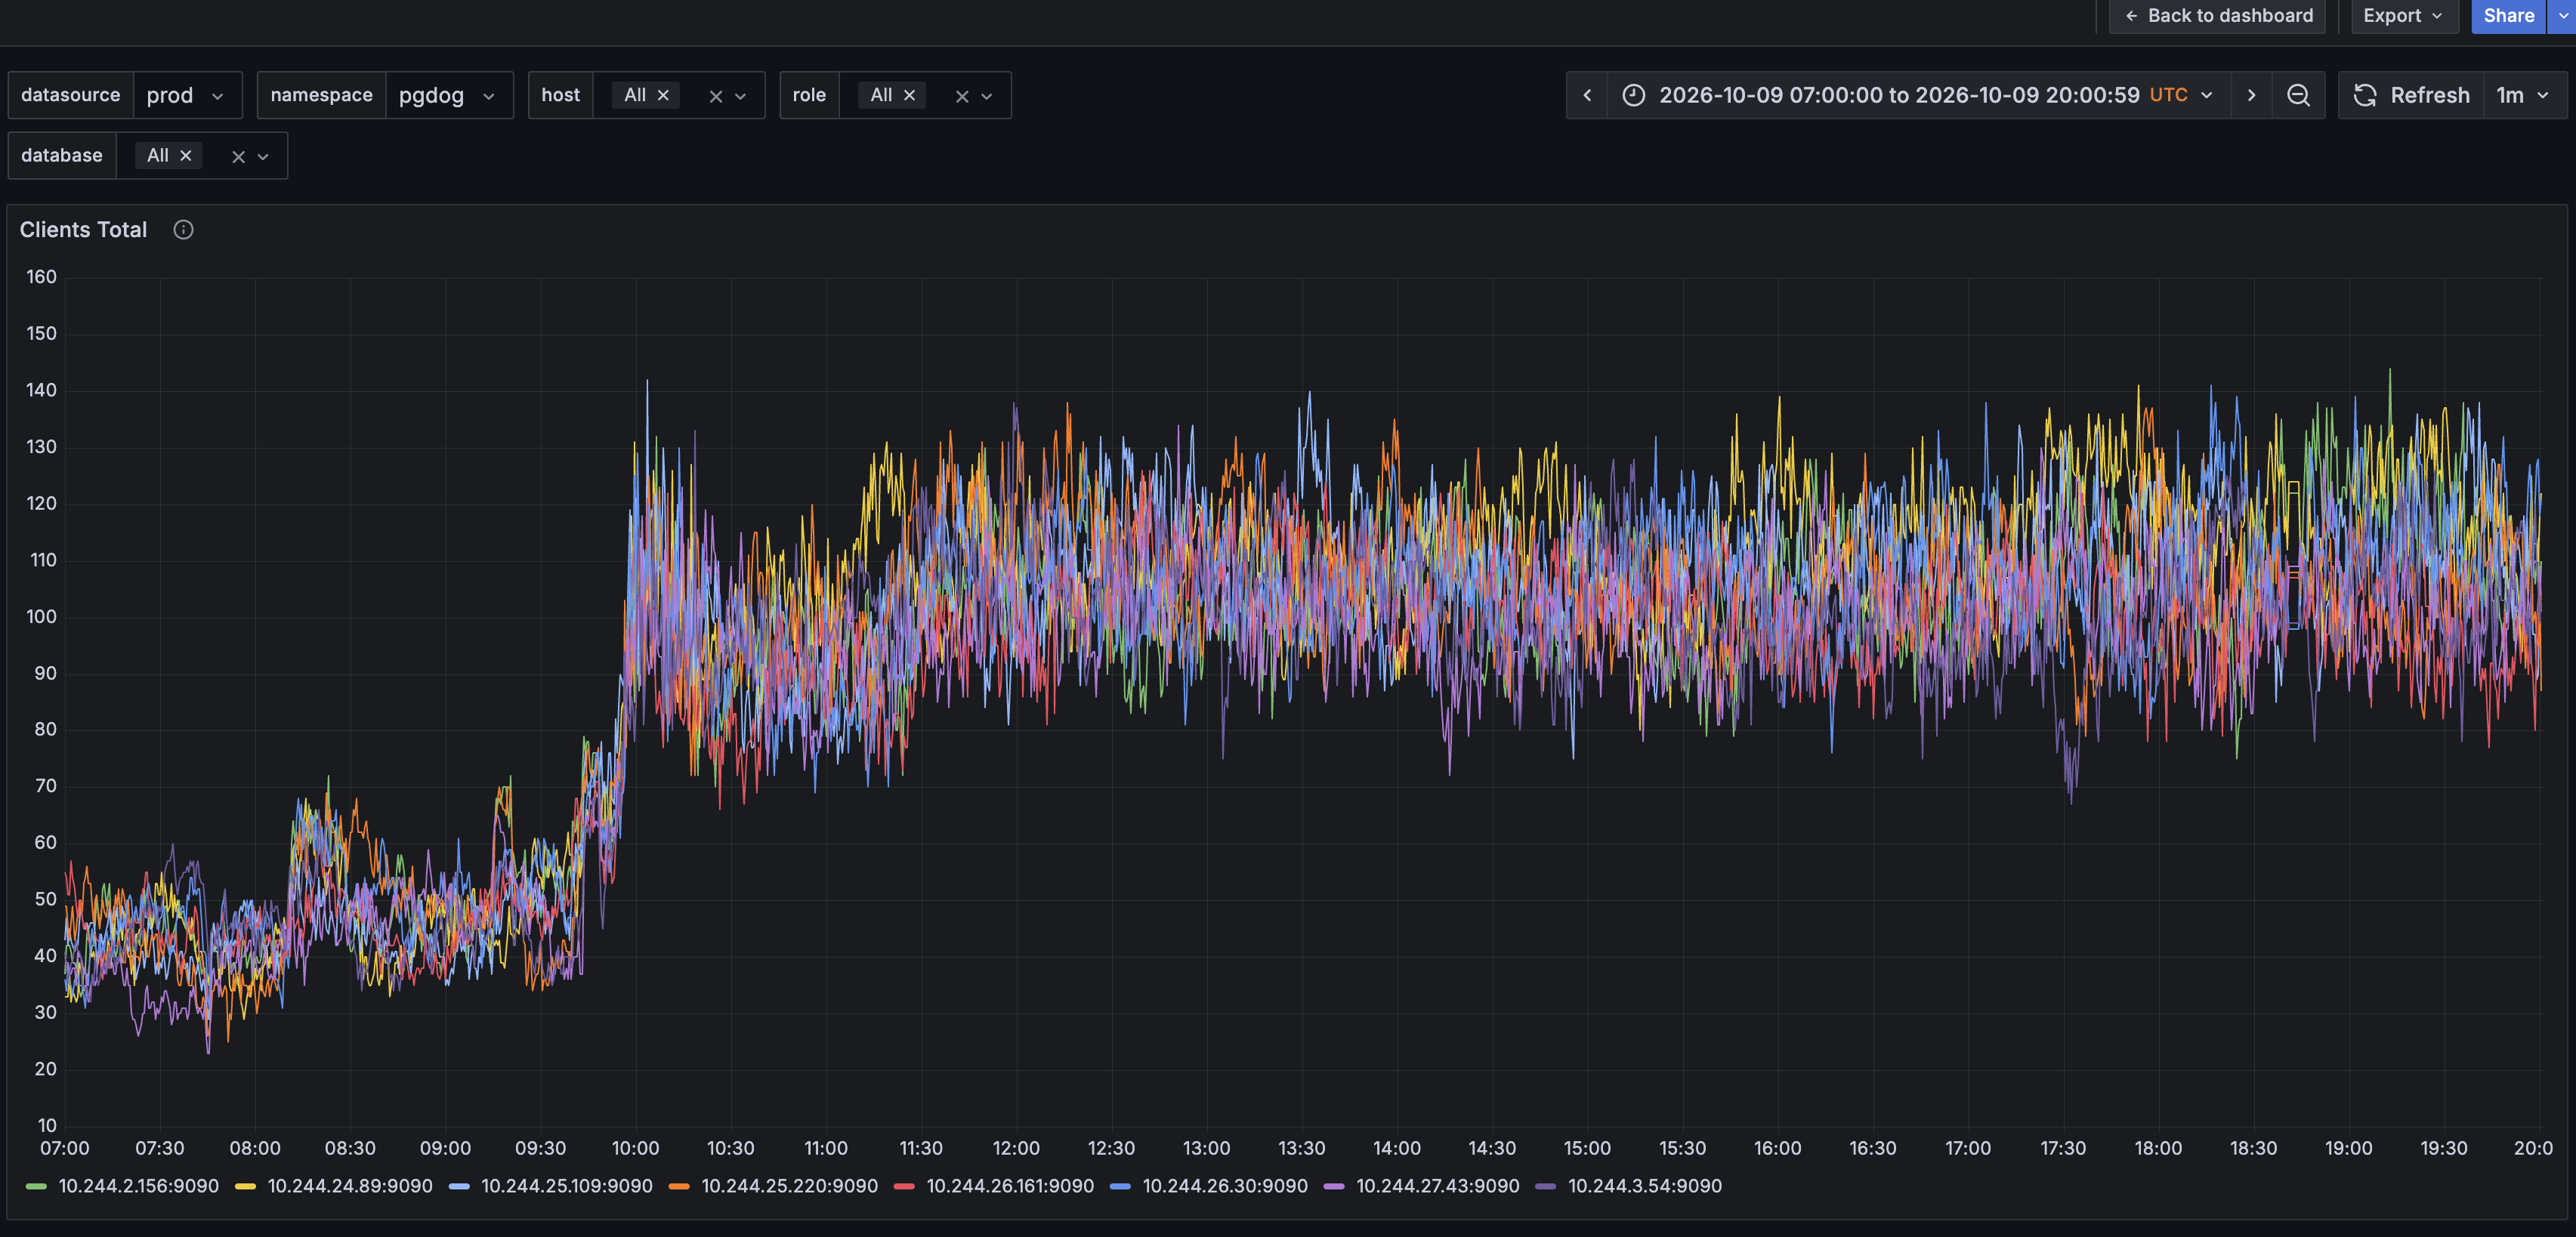
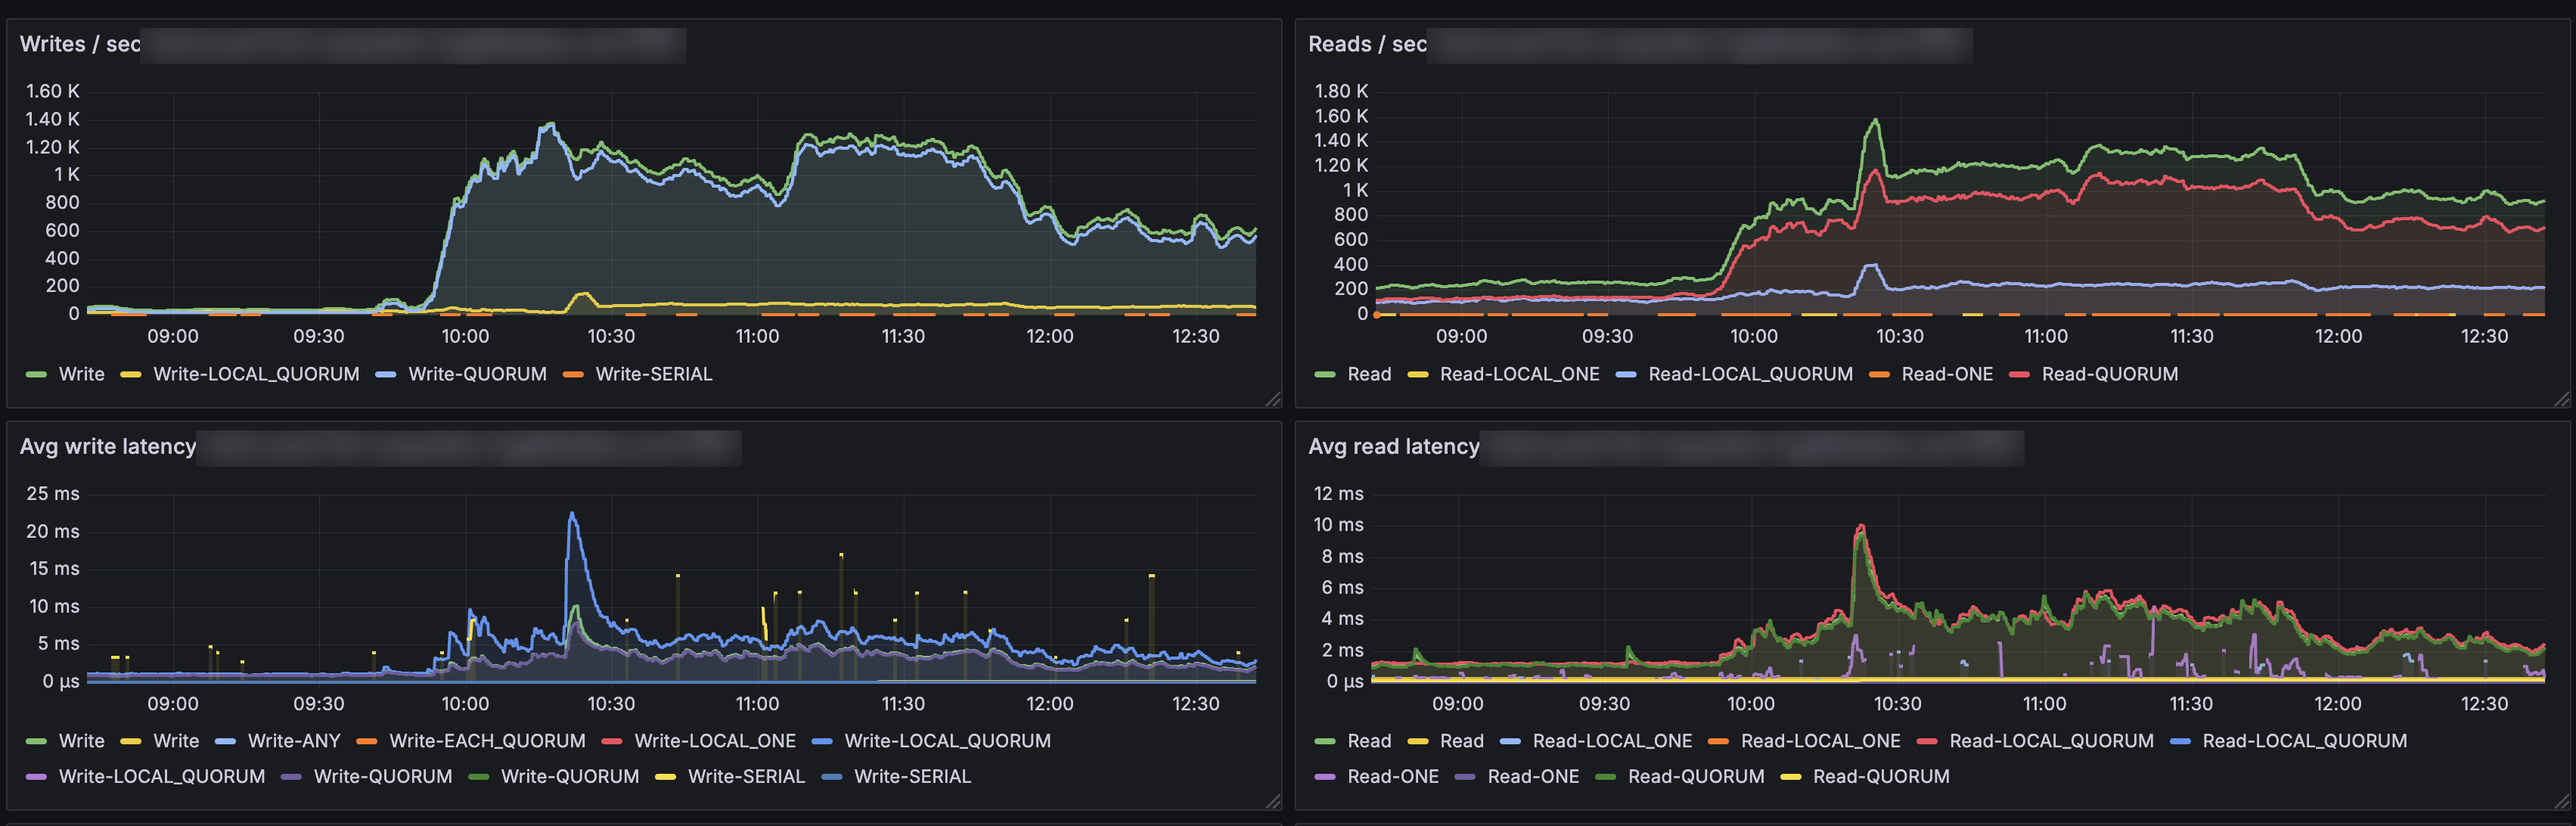
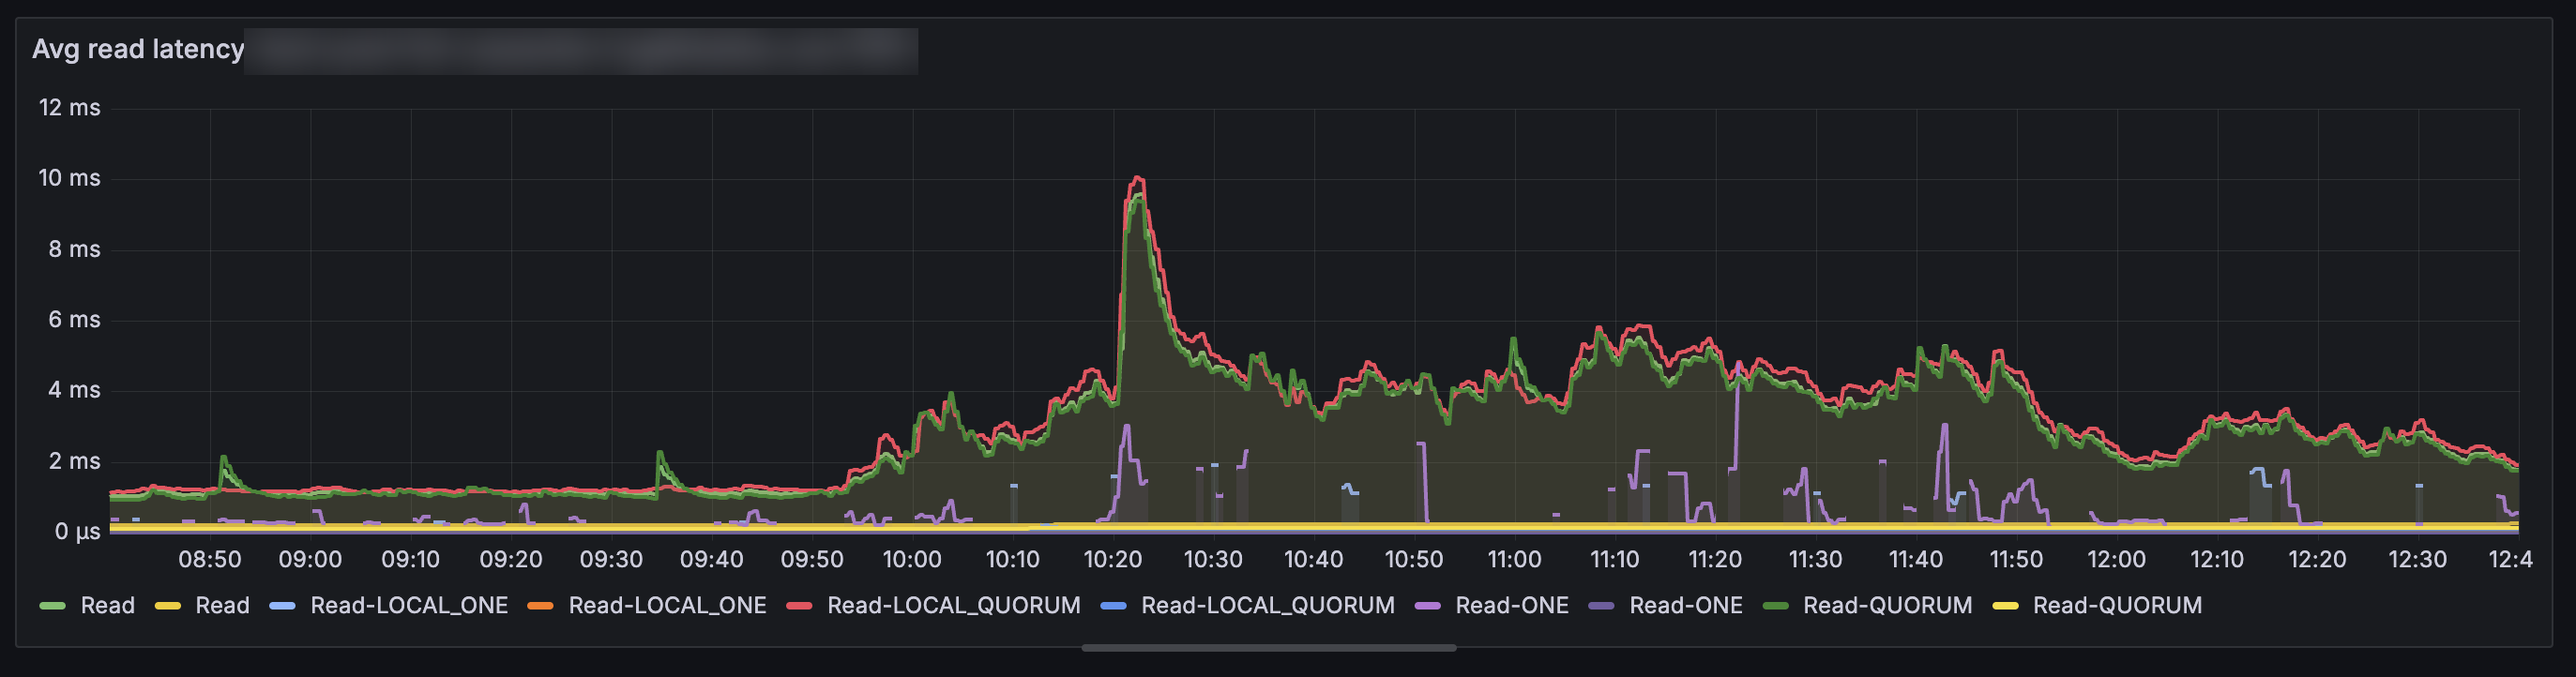
После запуска трафик на шлюзе Envoy резко возрос, превысив показатели старой версии в несколько раз. Новый клиент обращался к программному интерфейсу значительно чаще предшественника. Возросшая активность пользователей привела к увеличению нагрузки на пул соединений PgDog и росту задержек чтения в Cassandra, что потребовало оперативного расширения кластера.
Пропавшие переписки
После старта игроки столкнулись с тем, что не могли найти свежие личные сообщения. Причиной оказался порядок переноса диалогов, при котором новые чаты смещались вниз списка. Проблема была оперативно устранена.
Бакеты в очереди
Параллельное копирование файлов из внешнего облачного хранилища привело к исчерпанию лимитов запросов, из-за чего сервис начал отвечать с задержками. Скрипт миграции был вовремя скорректирован.
Что вылезло после: CoreDNS и ndots
Через несколько дней обнаружились задержки в работе внутреннего DNS-сервиса. Причиной оказалась стандартная настройка ndots в конфигурации контейнеров, из-за которой резолвер генерировал множество неудачных поисковых запросов. После изменения параметра объем паразитного трафика существенно сократился.
Масштабирование, которое опаздывает
Реактивное автоматическое масштабирование подов по метрикам срабатывало слишком медленно для резких скачков трафика в момент пиковых нагрузок, что потребовало пересмотра подходов к управлению емкостью кластера.
Запас, который стал лишним
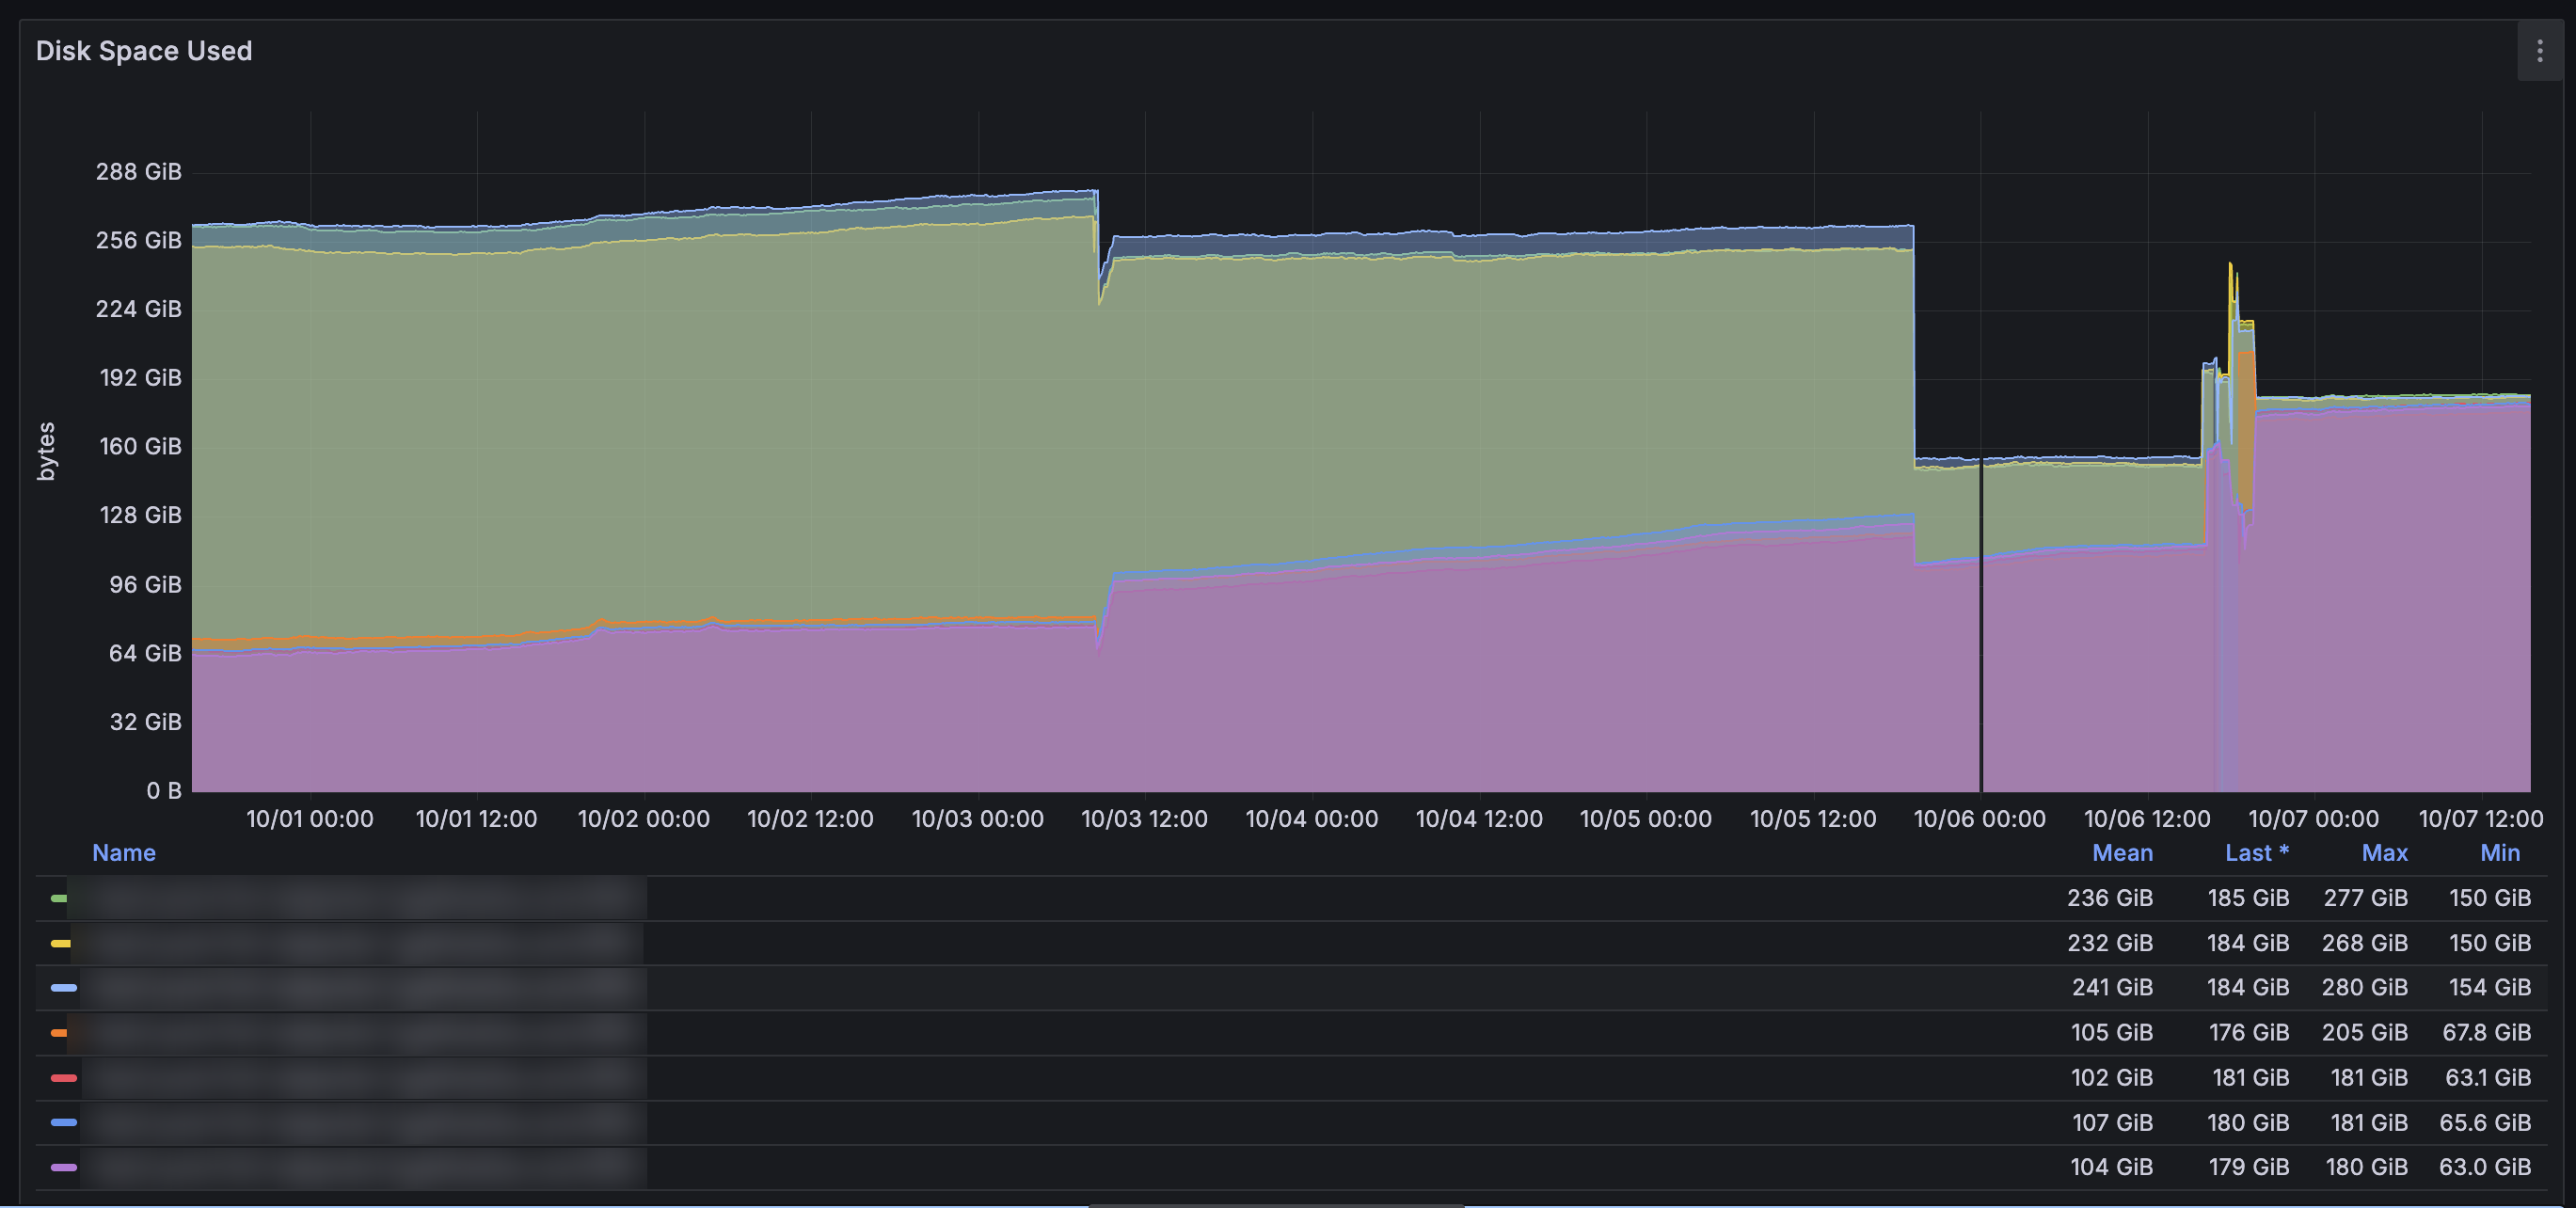
Созданный перед миграцией избыточный запас ресурсов потребовал последующей оптимизации. Специалисты перевели диски Redpanda на файловую систему XFS, сократили количество избыточных реплик и уменьшили размер неиспользуемых дисков.
Где мы просчитались, даже с агентом
Использование интеллектуальных ассистентов не исключает человеческих ошибок. Команда признала просчеты в анализе DNS-метрик, задержках автоматического масштабирования, нагрузке на систему мониторинга Prometheus, отложенном решении рисков облачной инфраструктуры и спешке при настройке маршрутизации для устаревших клиентов.
Итоги: стоило ли оно того
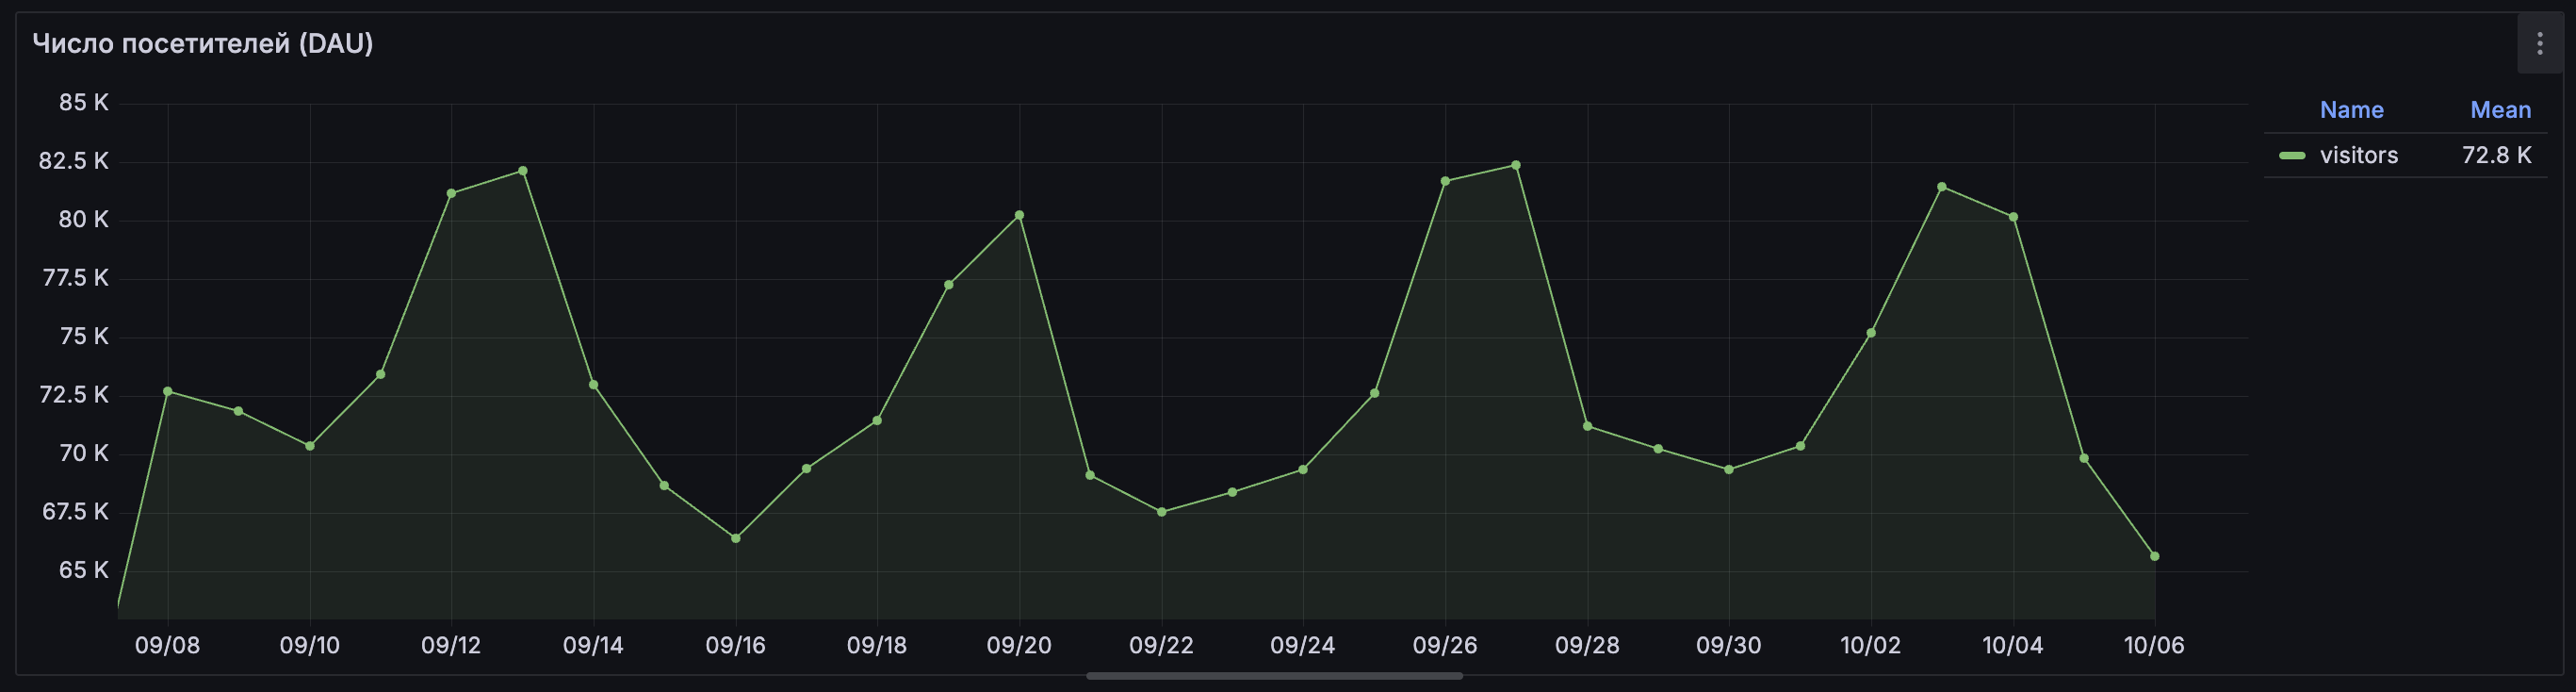
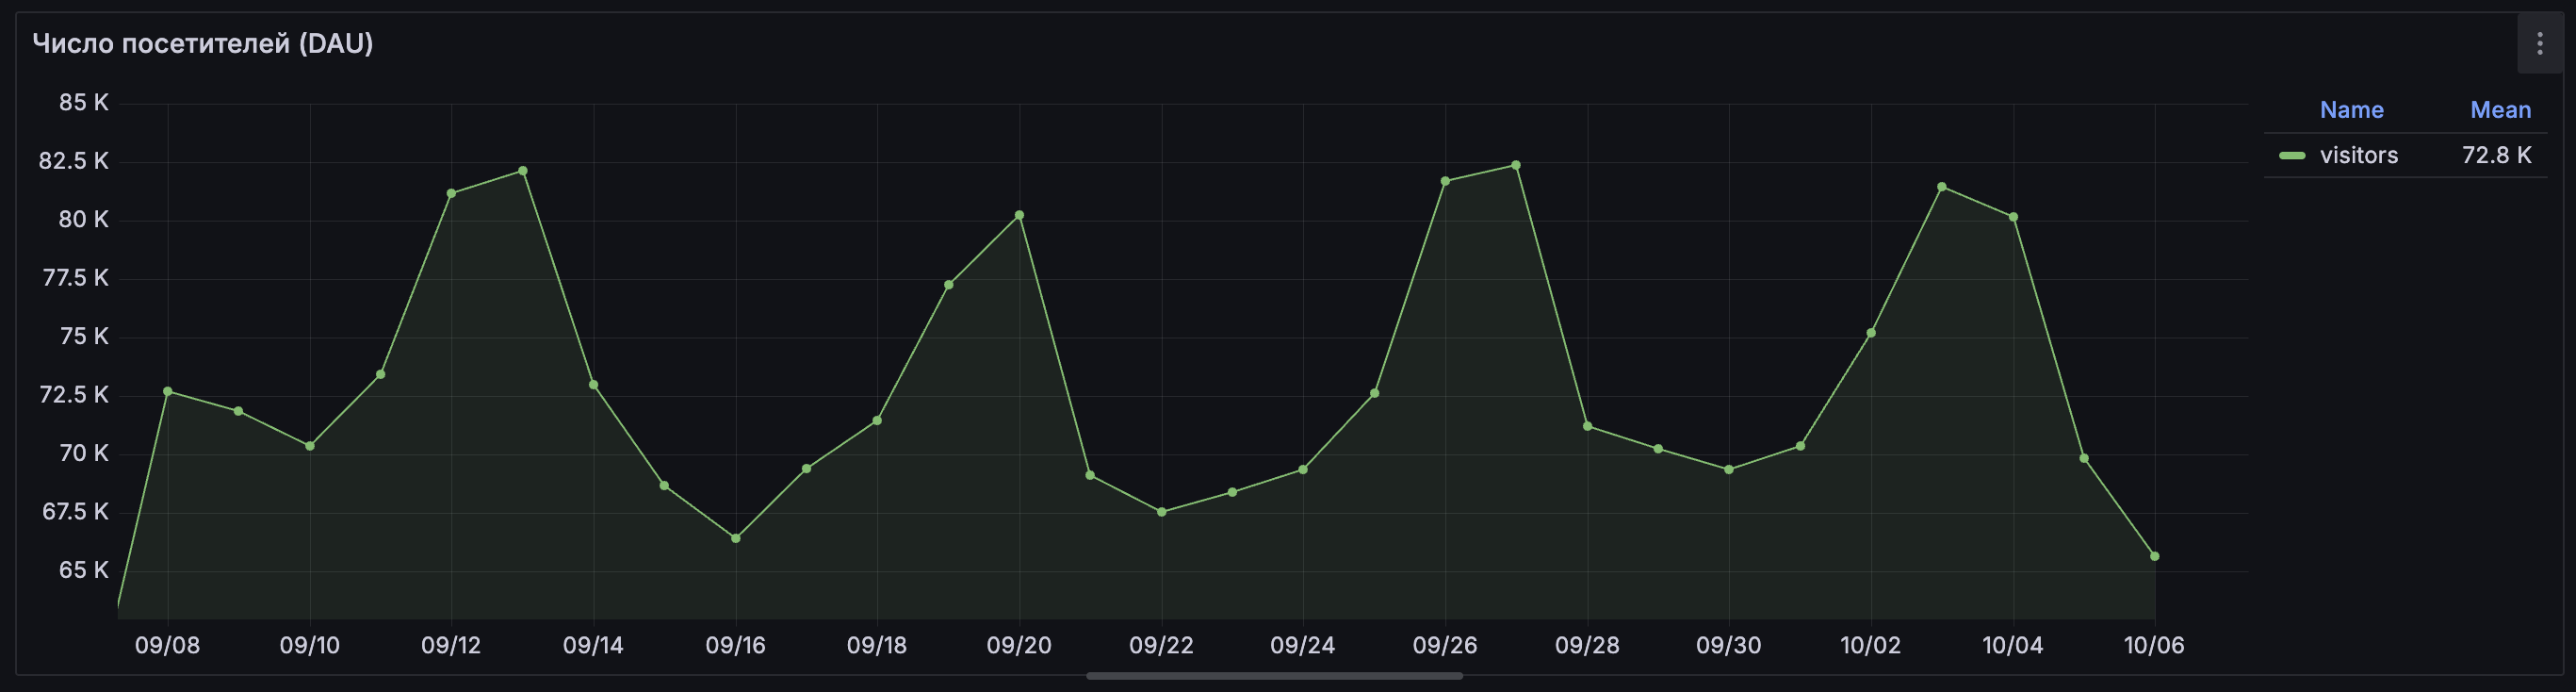
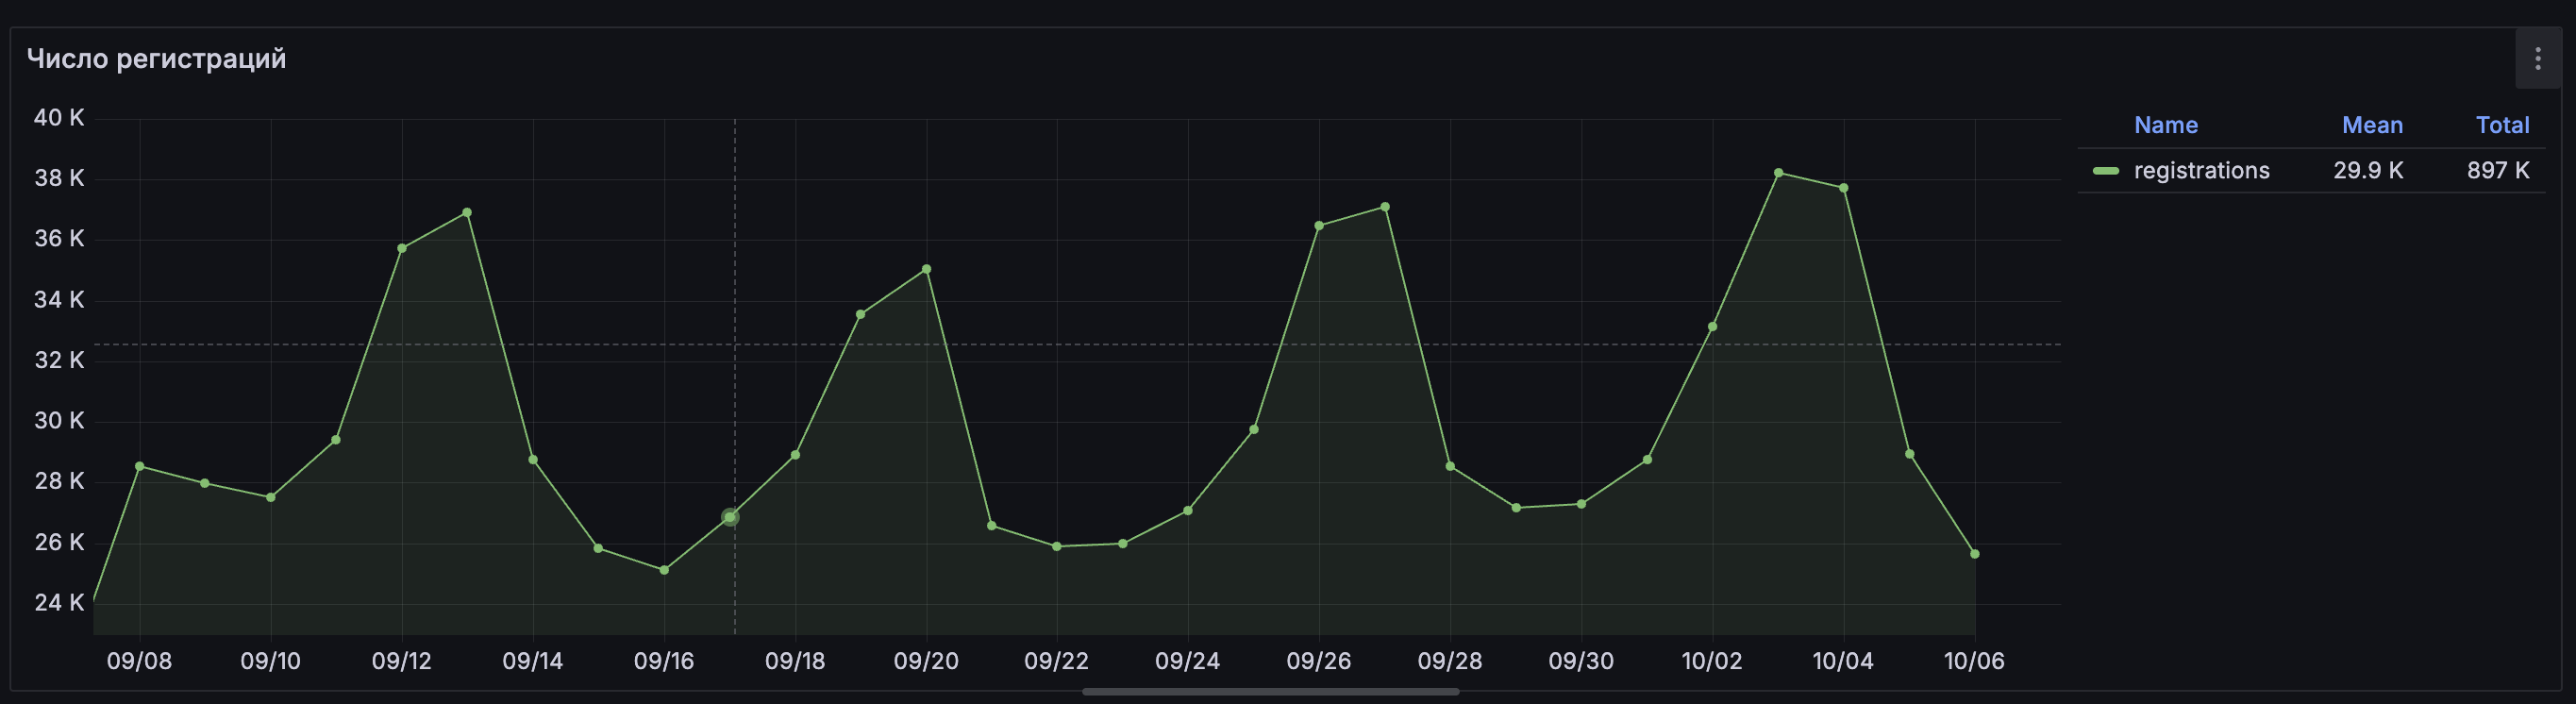
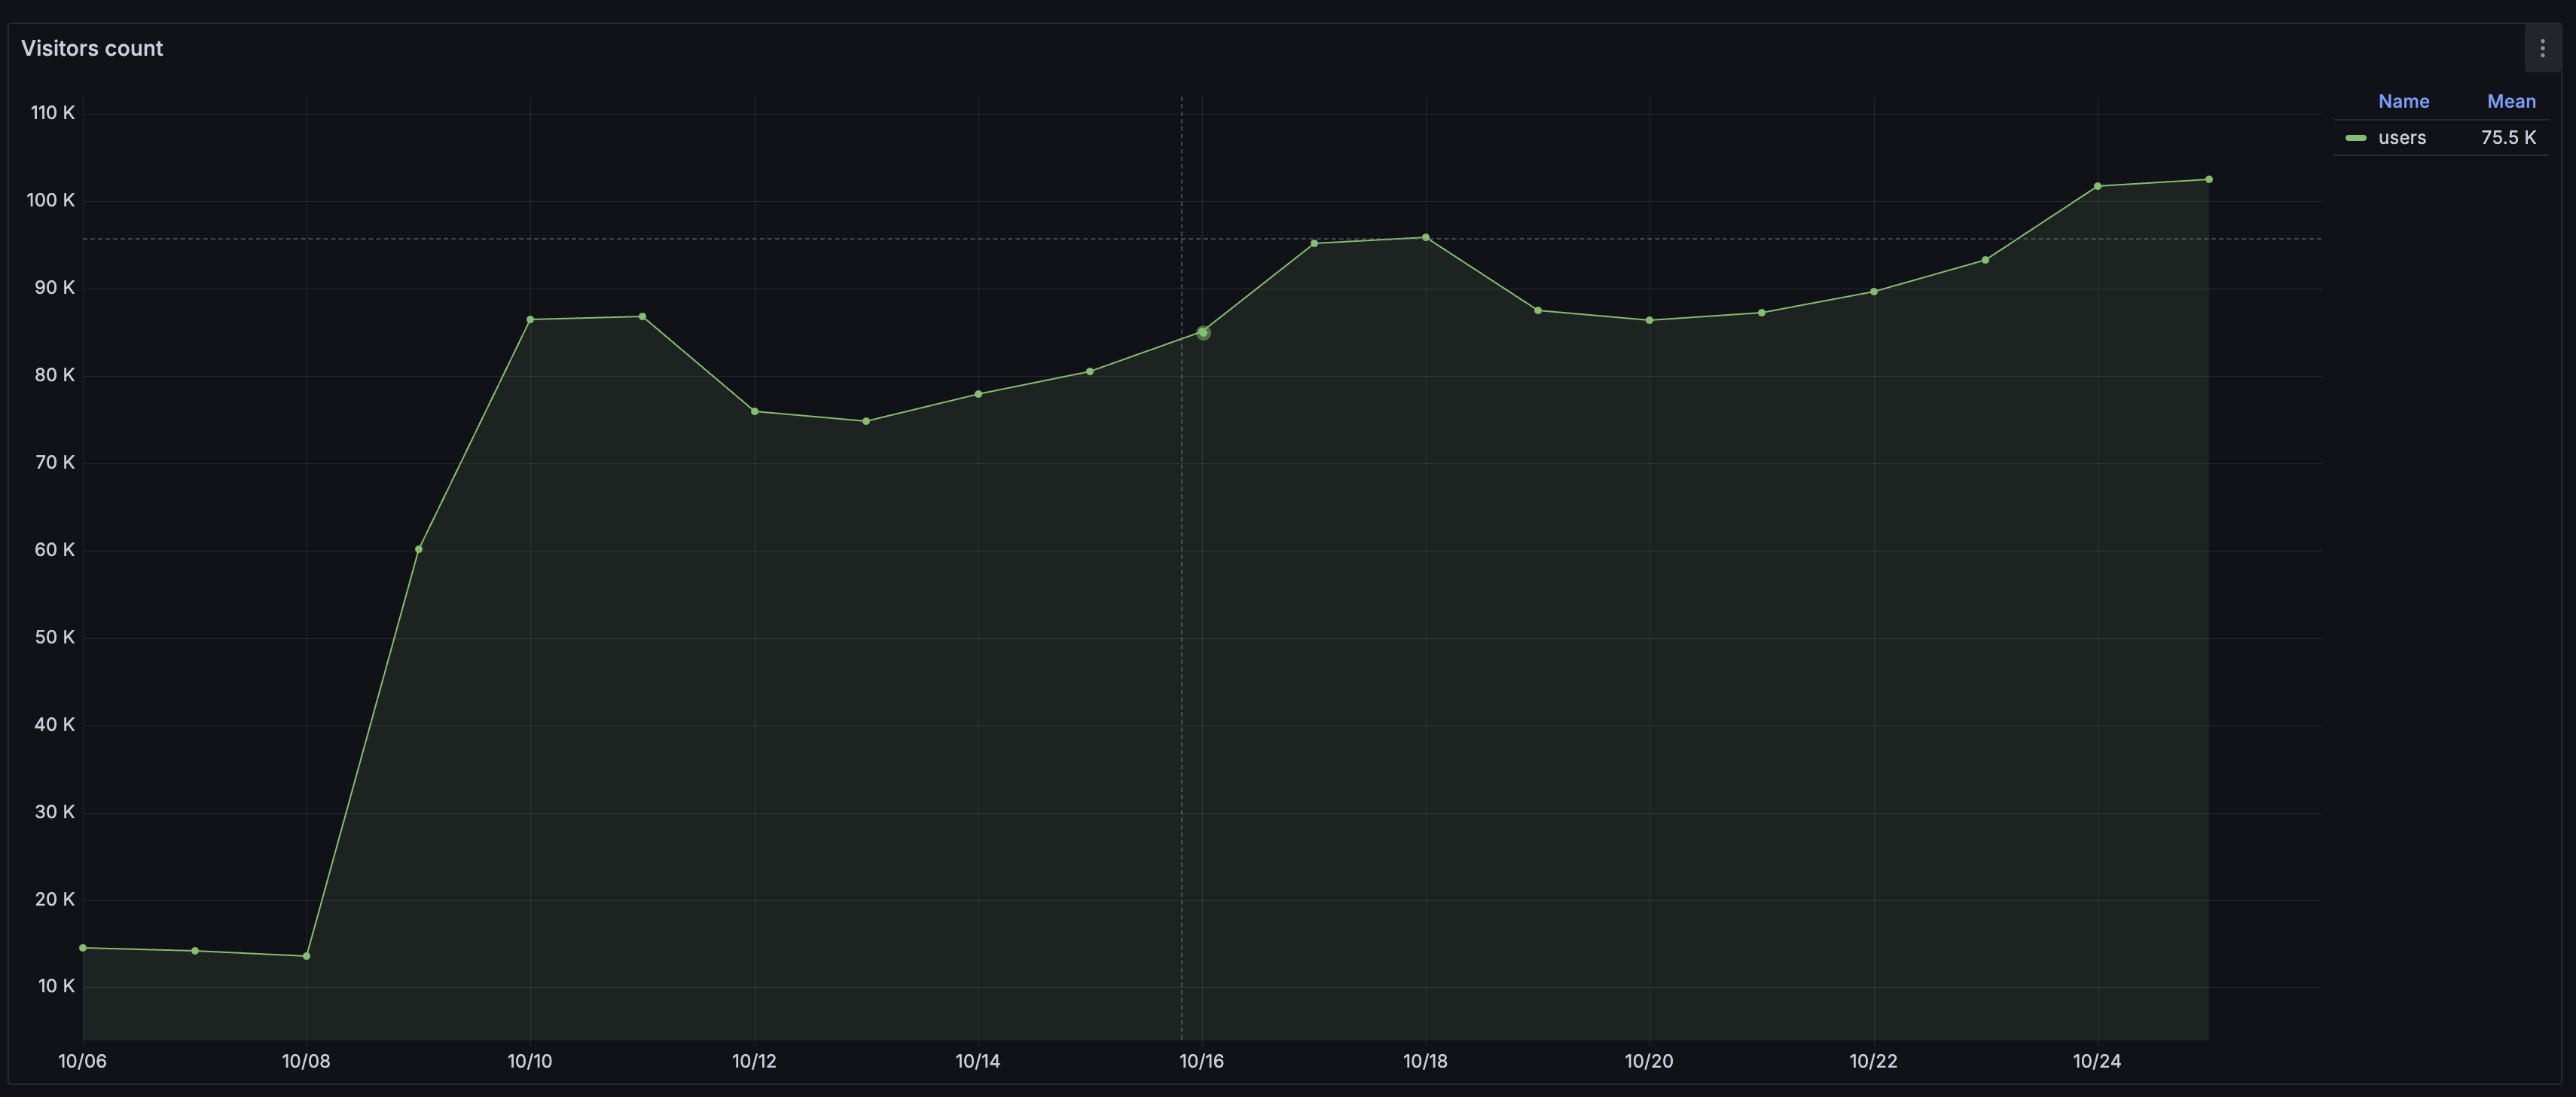
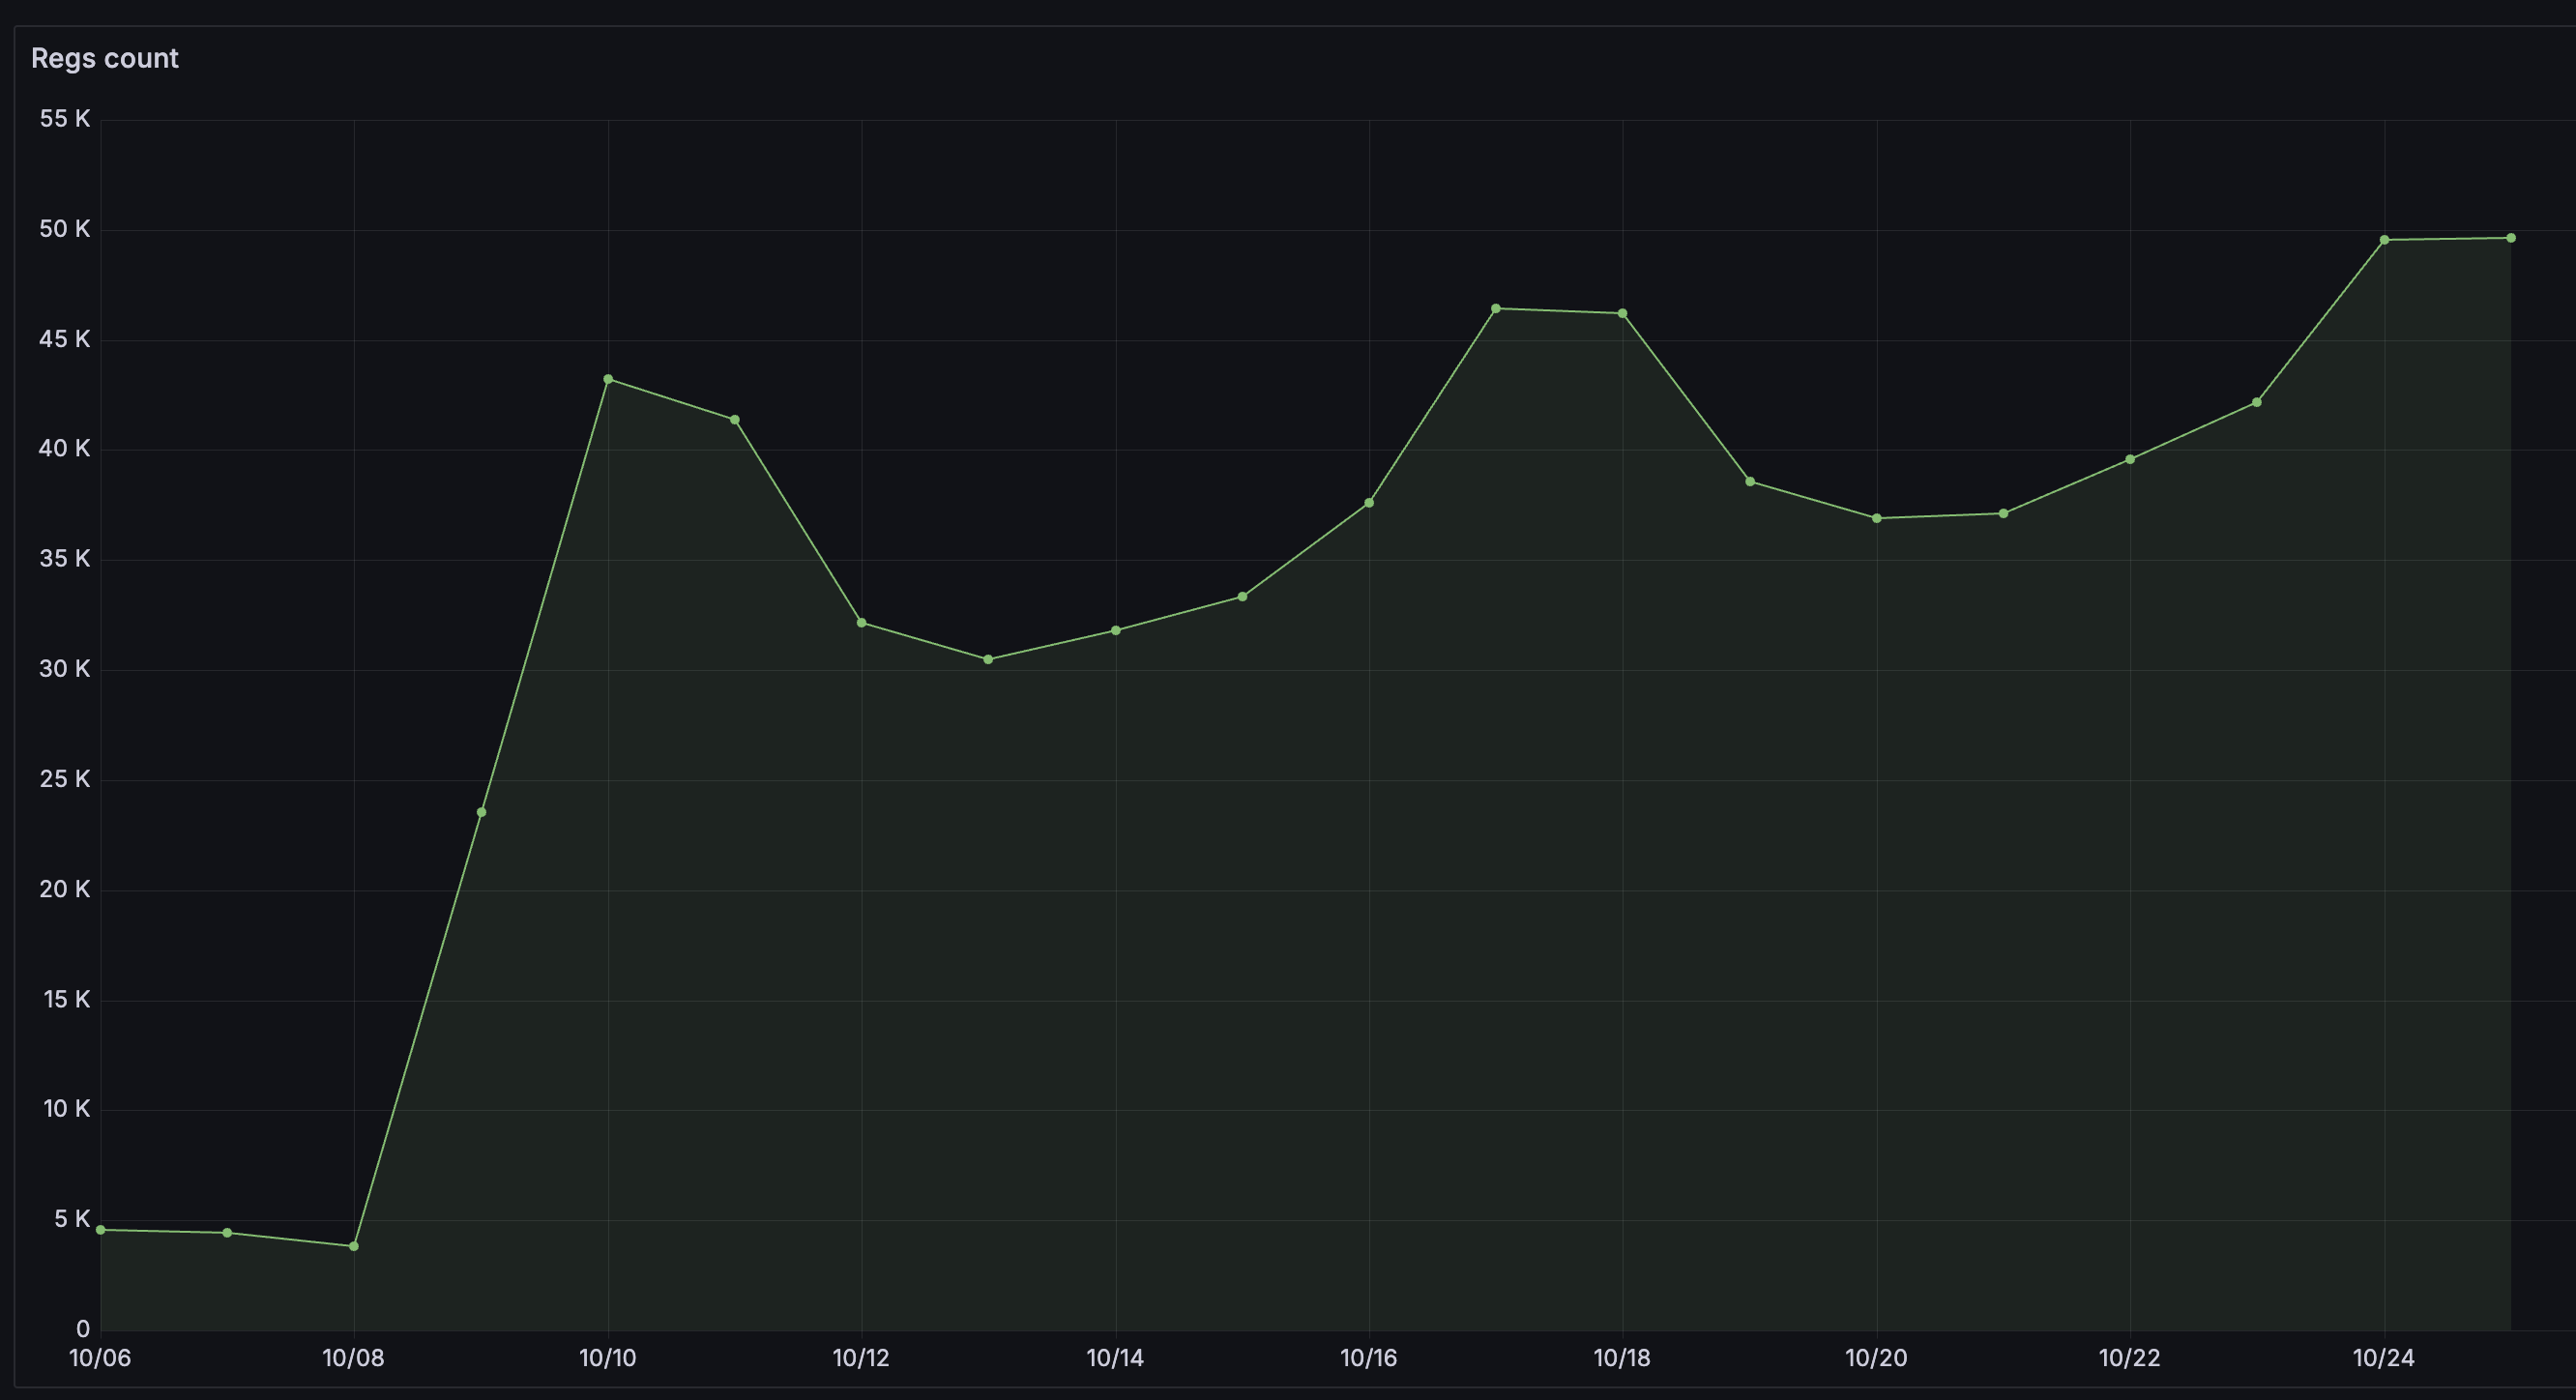
В первые дни после релиза пользователи отмечали изменения в интерфейсе, однако вскоре отзывы нормализовались. Показатели активной аудитории (DAU) не продемонстрировали падения, а количество ежедневных регистраций возросло. Финансовые показатели остались на сопоставимом уровне с перспективой улучшения в отдельных категориях.
Главным выводом проведенной работы стало понимание того, что стандартное нагрузочное тестирование не заменяет поэтапный перенос реальных пользователей волнами. Отказ от жестких лимитов процессора, оптимизация сетевых настроек и своевременное закрытие инфраструктурных рисков позволили успешно завершить масштабную миграцию игрового проекта.
