
Мой блог
NVIDIA выпустила Nemotron 3 Diarization: модель на 100 млн параметров для разделения спикеров

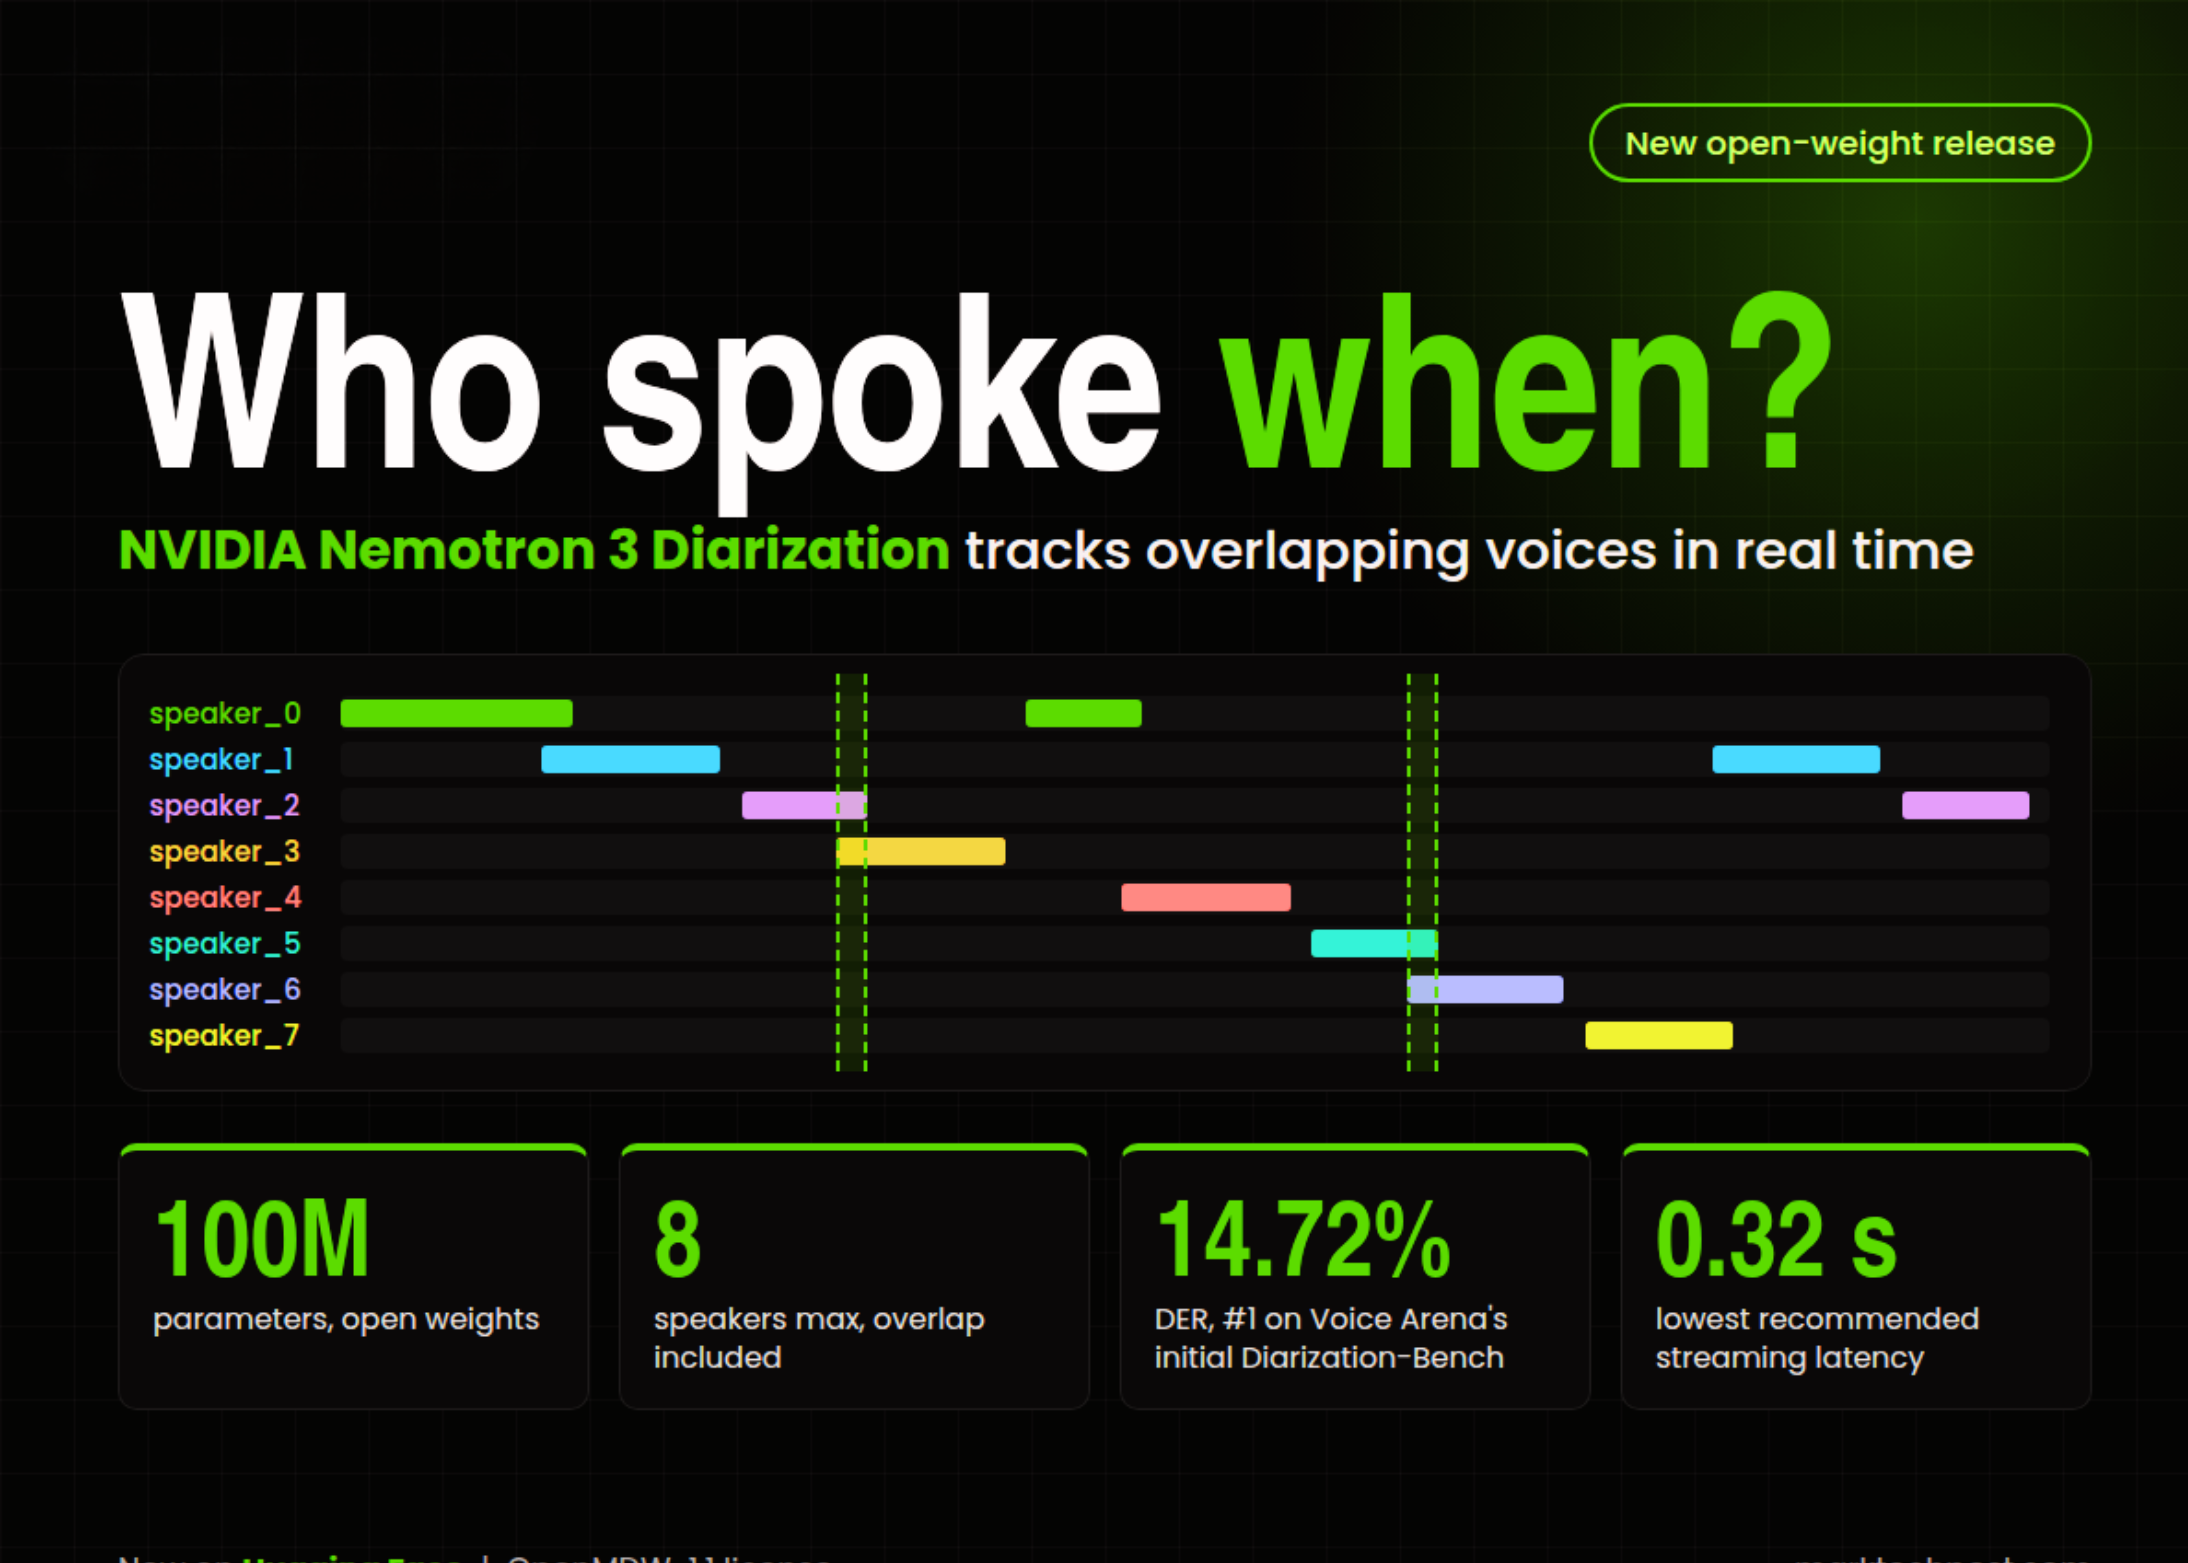
Компания NVIDIA официально представила модель Nemotron 3 Diarization с открытыми весами, предназначенную для эффективного определения реплик участников диалога. Данный инструмент с параметрами в 100 млн способен отслеживать до восьми разных спикеров в реальном времени, корректно распознавая ситуации с наложением голосов.
Новинка функционирует как в офлайн-режиме, так и в потоковом вещании, а ее веса распространяются под коммерчески доступной лицензией OpenMDW License 1.1. Я настроил и проверил технические параметры релиза, чтобы рассказать о ключевых особенностях архитектуры, бенчмарках и практическом применении в экосистеме NVIDIA NeMo.
Зачем нужна диаризация речи?
Автоматическое распознавание речи (ASR) прекрасно справляется с переводом звука в текст, однако оно не способно идентифицировать конкретного говорящего. Без точной атрибуции современным инструментам суммаризации сложно понять, кто именно дал обещание, взял на себя обязательство или высказал возражение во время деловой встречи.
Процесс диаризации выдает временные интервалы активности каждого участника беседы. Соединяя эти метки времени с результатами ASR, разработчики получают готовый транскрипт с привязкой к конкретным спикерам. Подобные пайплайны критически важны для приложений видеоконференций, аналитики телефонных звонков, подкастинговых платформ и памяти голосовых агентов.
Что изменилось по сравнению со Streaming Sortformer
Предыдущая контрольная точка Streaming Sortformer от NVIDIA под названием diar_streaming_sortformer_4spk-v2.1 поддерживала не более четырех спикеров. Новая модель Nemotron 3 Diarization увеличивает этот лимит ровно вдвое — до восьми человек.
Согласно официальным данным разработчиков, основная цель обновления заключается в эффективной обработке сложных многосторонних аудиозаписей, где участники часто перебивают друг друга и говорят одновременно.
Как устроена архитектура модели
Модель принимает на вход монофонический аудиопоток с частотой дискретизации 16 кГц в форматах .wav, .flac, .opus или .mp3. Входные данные преобразуются в мел-спектрограммы с шагом 10 мс. Затем эти признаки объединяются с коэффициентом 8, формируя кадры энкодера длительностью 80 мс.
За обработку полученных кадров отвечает 31-слойный трансформерный энкодер, использующий относительное позиционное кодирование (RoPE). Специальный сверточный слой Conv1D повышает разрешение предсказаний обратно до 10 мс. На выходе формируется тензор размерности [T, 8], содержащий вероятности речевой активности каждого из восьми спикеров.
Обработка наложений и механизм памяти
Подобная архитектура позволяет напрямую разрешать конфликты перекрытия голосов. Если в один момент времени говорят два человека, активируются соответствующие каналы внутри того же кадра.
Модель использует подход Sortformer, упорядочивая спикеров по времени их первого появления в записи. Первый голос занимает первый канал, следующий — второй и так далее. Это стабилизирует метки между потоковыми чанками без необходимости постоянного пересопоставления.
Для потоковой обработки применяются два технологических механизма. Кэш спикеров по порядку появления (AOSC) сохраняет информацию об участниках из предыдущих блоков, а FIFO-очередь отвечает за контекст недавних кадров. Идентификационные метки остаются анонимными, а их привязка к реальным именам возлагается на прикладные инструменты верхнего уровня.
Четыре рабочих режима задержки
Задержка входного буфера рассчитывается как сумма размера чанка и правого контекста, умноженная на 80 мс. Применение различных пресетов позволяет гибко балансировать между производительностью и скоростью отклика.
- Офлайн-режим (буфер 30.4 с): коэффициент RTFx достигает 15,113× при показателе DER 12.73%.
- Низкая задержка (1.04 с): RTFx составляет 865× при DER 13.18%.
- Очень низкая задержка (0.64 с): RTFx равен 579× с ошибкой 13.28%.
- Ультранизкая задержка (0.32 с): RTFx снижается до 292×, а DER составляет 13.55%.
Указанные значения задержки не учитывают накладные расходы на сетевые вызовы и работу ASR. Технически модель способна запускаться даже с буфером в 80 мс, но 0.32 с остается минимальной рекомендованной границей.
Результаты бенчмарков
В ходе первичного тестирования на платформе Voice Arena в рамках бенчмарка Diarization-Bench разработка заняла первое место среди 12 систем и 17 конфигураций. Исследование охватывало 139 англоязычных диалогов общей продолжительностью около 22 часов. Модель показала уровень ошибки DER на отметке 14.72% против 19.3% у ближайшего конкурента, что обеспечивает относительное улучшение примерно на 24%.
Сравнение с базовой четырехканальной версией при задержке 1.04 с продемонстрировало снижение ошибок во всех восьми тестовых сценариях. Относительное сокращение показателей варьировалось от 9.0% на датасете CALLHOME-Part2 до 65.2% на материалах NOTSOFAR1 MHM.
Данные для обучения
Тренировочный датасет включил в себя около 10 000 часов реальных записанных разговоров, дополненных 82 611 часами синтезированных многоголосых миксов. В процесс обучения вошли аудиоматериалы с лицензированием от компании David AI, охватывающие в общей сложности 21 язык.
Интеграция датасетов David AI позволила снизить совокупный показатель составной ошибки DER с 11.19% до 10.42%.
С чего начать работу
Для развертывания модели вам потребуется Python версии 3.12 или выше, а также установленный пакет NVIDIA NeMo Speech. Я рекомендую использовать следующие команды для базовой инициализации:
uv pip install 'nemo-toolkit[asr]'

from nemo.collections.asr.models import SortformerEncLabelModel
diar_model = SortformerEncLabelModel.from_pretrained("nvidia/Nemotron-3-Diarization")
diar_model.eval()
segments = diar_model.diarize(audio=["conversation.wav"], batch_size=1)
Итоговые сегменты выдаются в формате «начало конец id_спикера». Для получения полноценного текстового транскрипта я советую объединять модель с решением Parakeet TDT 0.6B v3, используя официальное руководство по интеграции ASR.
Основные выводы
Новая языковая разработка от NVIDIA открывает отличные возможности для создания качественных систем автоматической транскрипции. Модель на 100 млн параметров эффективно справляется с перекрывающимися голосами и поддерживает гибкие сценарии интеграции.
Среди ключевых ограничений стоит отметить риск пропусков или ошибок при наличии более чем восьми спикеров в одной записи. Сильные акустические шумы, реверберация и удаленное расположение микрофонов также могут увеличивать процент ошибок.
