
Мой блог
Alibaba представила модель Qwen-Audio-3.1-Realtime с поддержкой полнодуплексного диалога

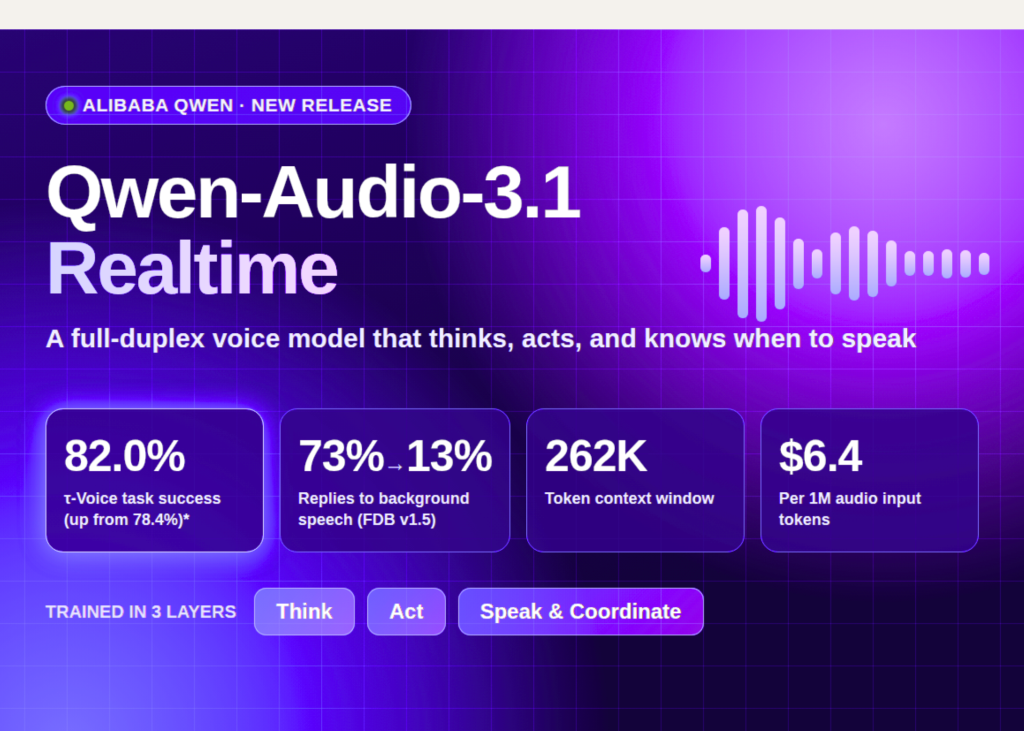
Команда разработчиков Alibaba Qwen выпустила крупное обновление — аудиостек Qwen-Audio-3.1, состоящий из пяти моделей для распознавания речи (ASR), синтеза (TTS) и взаимодействия в реальном времени. Флагманом линейки стала модель Qwen-Audio-3.1-Realtime, созданная специально для голосовых ассистентов, способных вызывать внешние инструменты и принимать самостоятельные решения в ходе диалога.
Одновременно с релизом разработчики снизили тарифы: стоимость работы модели в режиме реального времени уменьшилась примерно на 85%, расценки на синтез речи упали на 70%, а расценки на распознавание снизились на 95%. На текущий момент развертывание доступно через управляемый API на платформе QwenCloud по протоколу WebSocket, при этом открытые веса (open weights) компания не анонсировала.
Что доступно на платформе QwenCloud
Согласно документации на странице модели, в качестве входных и выходных данных поддерживаются как текст, так и аудио. Общий размер контекстного окна составляет впечатляющие 262 тысячи токенов, включая до 245 тысяч токенов на входе и до 16 тысяч на выходе. Стандартные лимиты платформы установлены на уровне 60 запросов и 100 тысяч токенов в минуту. Ценообразование за один миллион токенов аудиовхода составляет 6,4 доллара, текстовый вход обходится в 0,8 доллара, а генерация текста и аудио оценивается в 24 доллара за миллион токенов (при этом налог на исходящий текст не начисляется). Среди ключевых функций выделяются вызов функций (function calling), веб-поиск, структурированные ответы, кэширование контекста и тонкая настройка.
Помимо флагмана, экосистема включает сопутствующую модель Qwen-Audio-3.1-ASR-Flash-Filetrans, ориентированную на офлайн-транскрипцию длинных аудиозаписей. Этот инструмент поддерживает работу со словарями ключевых слов, разделение спикеров, расстановку знаков препинания, а также распознавание множества языков и китайских диалектов. Его стоимость составляет 0,15 доллара за входные токены и 0,47 доллара за выходные на миллион единиц.
Архитектура: две модели за одним голосом
В основе системы лежат две взаимосвязанные модели, использующие единый аудиокодер и архитектуру языковой модели. Первая — это полнодуплексная модель принятия решений, которая прогнозирует, следует ли продолжать слушать собеседника, начать говорить, сделать паузу или возобновить речь. Вторая модель представляет собой систему распознавания речи, которая записывает содержание ответа в текстовом виде. После этого контекстно-зависимый голосовой рендерер преобразует текст в потоковое аудио, учитывая историю беседы, голосовые подсказки и акустическую обстановку.
Процесс обучения всей системы разделен на три последовательных уровня: «Мышление» (Think), «Действие» (Act), а также «Речь и Координация» (Speak and Coordinate).
Уровень «Мышление»: методика M²-OPD
На первом этапе применяется метод Core-Cocktail SFT для повторной привязки аудиомодели к базовой текстовой большой языковой модели с использованием массированных наборов данных объемом в миллионы часов. Затем задействуется многомодальная оптимизация по предпочтениям на политике (Multimodality OPD). Текстовый учитель и замороженный аудиоэталон оценивают каждый токен собственной траектории студента. Такой подход представляет собой дистилляцию на актуальной политике, а не простое копирование заранее заготовленных ответов. На завершающем этапе эксперты по эмпатии, прагматическим намерениям и акустическим сценам обучаются с помощью алгоритма GRPO, после чего методика Multi-Teacher OPD объединяет их в единую готовую к развертыванию модель.
Уровень «Действие»: исполняемые среды
Каждый учебный домен объединяет пул инструментов, базу данных в формате JSON с сохранением состояния и бизнес-политику на естественном языке. Домены инициализируются на основе определений открытых инструментов и MCP-серверов. Каждая задача определяет один из трех возможных исходов: запись данных, обоснованный отказ или запрос неподдерживаемого действия. Процесс оценки проверяет конечное состояние, разрешенные операции записи и поведенческие утверждения, причем успешное прохождение проверок состояния имеет приоритет над плавностью ответа.
Алгоритм GRPO получает вознаграждения на уровне диалога, контрольных точек и отдельных реплик. Обучение поиску нацелено на минимизацию избыточных запросов с помощью специального штрафного коэффициента. В результате этих мер среднее количество поисковых запросов на одну задачу сократилось с 4,37 до 1,05, хотя показатель срабатывания триггера (Trigger F1) немного снизился с 60,87% до 58,61%.
Уровень «Речь и Координация»
Этот компонент отвечает за выбор момента времени, необходимости и манеры речевого ответа. Согласно тестам Full-Duplex-Bench v1.5, количество ложных ответов на реплики, обращенные к другим людям, снизилось с 0,13 до 0,03. В версии v3.0 частота использования слов-паразитов сократилась с 0,7590 до 0,2960. Тем не менее, здесь существуют определенные компромиссы: после прерываний частота нежелательного возобновления речи выросла с 0,035 до 0,130, а задержка остановки при прерывании составила 1,116 секунды против 0,383 секунды у конкурирующего решения GPT-Realtime-2.
Интерактивный анализ и сравнение с аналогами
Практическое изучение модели включает в себя циклы обработки «Мышление — Действие — Речь», оценку дуплексных решений, анализ тренировочных эпизодов и расчет поисковых наград. По данным бенчмарков, в сравнении с версией 3.0 показатель Audio MultiChallenge вырос с 47,12 до 52.21, средний балл по 14 языкам в тесте BBA увеличился с 81,7% до 88.1%, а уровень ошибок в распознавании FLEURS WER снизился с 9,01 до 3.98.
Сравнение ценовых и функциональных характеристик с конкурирующими платформами показывает значительное ценовое преимущество решения от Alibaba. Например, если аудиовход у Qwen-Audio-3.1-Realtime-Plus стоит 6,4 доллара за миллион токенов, то у решений OpenAI этот показатель достигает 32 долларов. При этом контекстное окно в 262 тысячи токенов превосходит многие аналоги на рынке, делая модель крайне привлекательным инструментом для разработчиков интерактивных голосовых приложений.
