
Мой блог
SGD и Adam в машинном обучении: как работают оптимизаторы

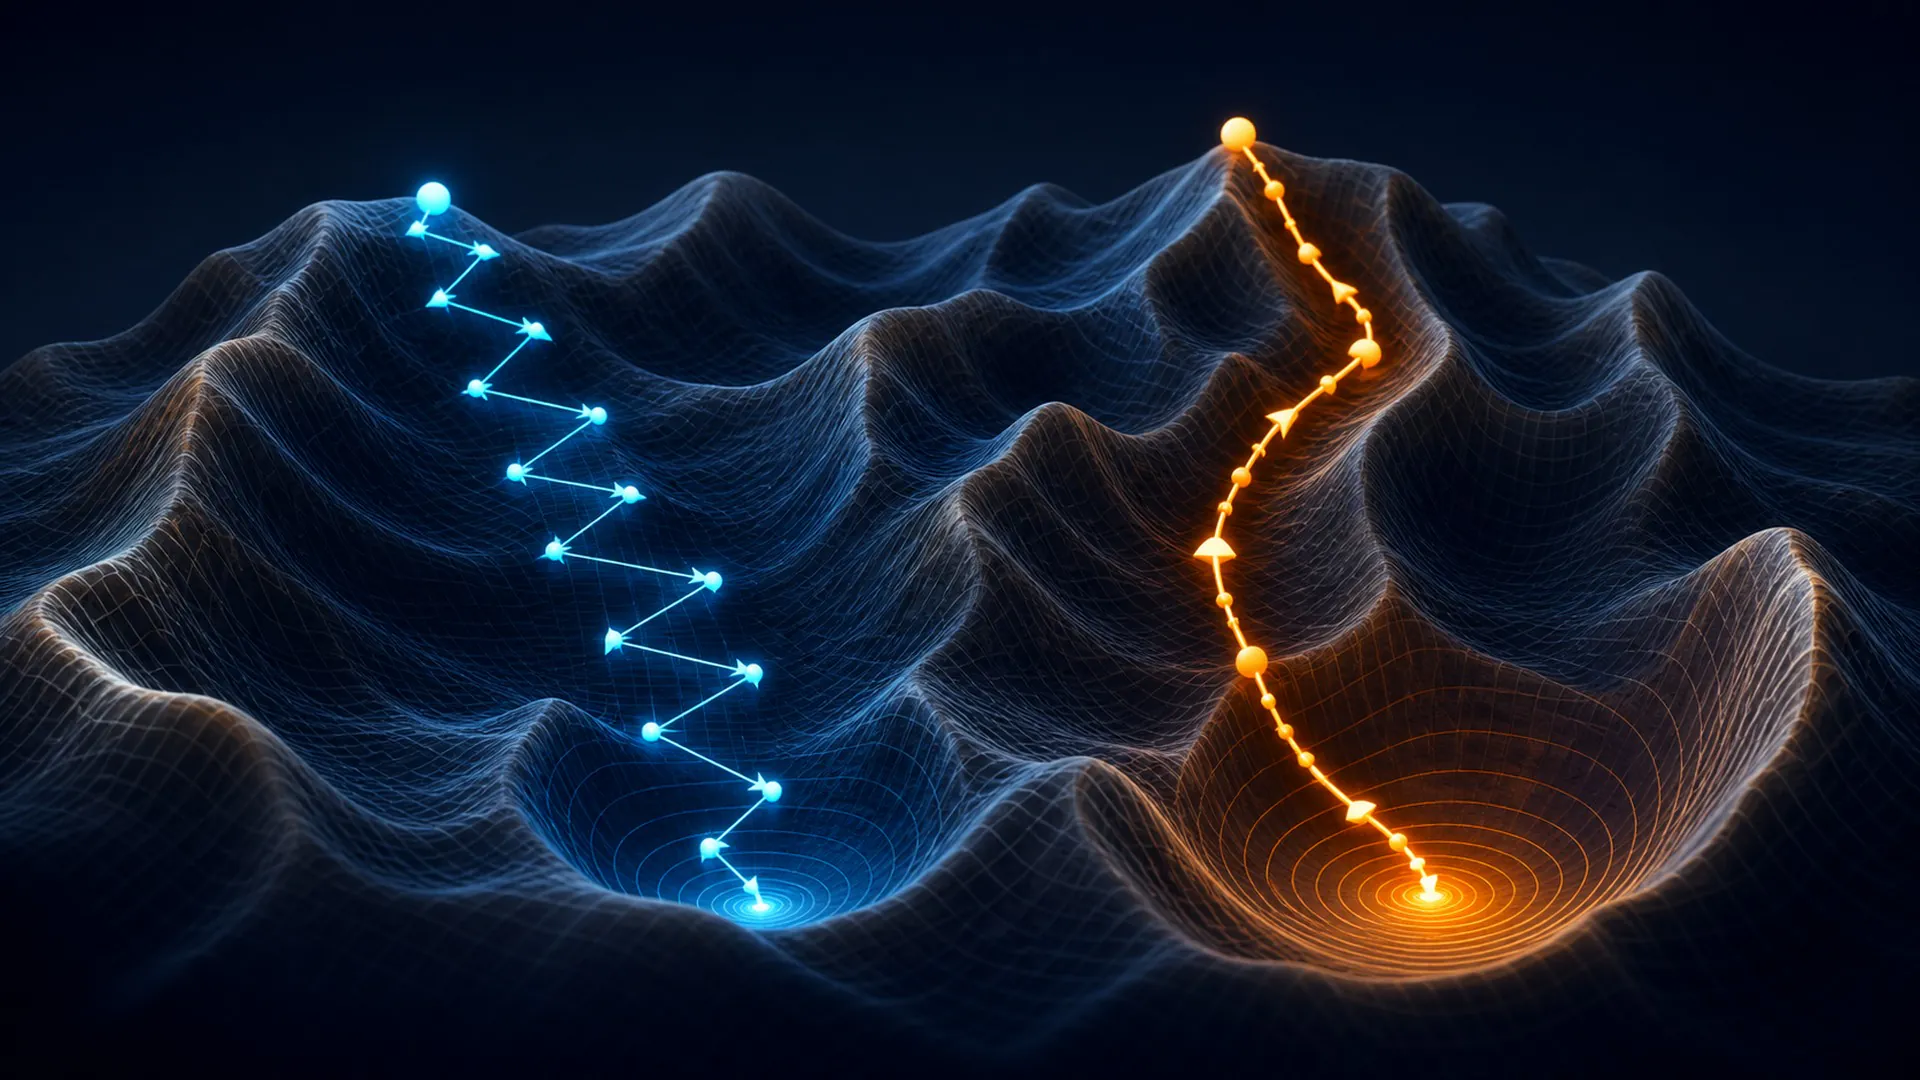
Стохастический градиентный спуск (SGD) и алгоритм Adam представляют собой базовые методы оптимизации, которые обновляют параметры моделей на основе оцененных градиентов, используя при этом принципиально разные правила для момента и индивидуальных шагов параметров. В материале Unite.AI подробно разбираются механизмы их работы, компромиссы, схемы оценки и практические методы контроля на реальных задачах.
Понимание того, как функционируют эти оптимизаторы, критически важно для создания надежных систем искусственного интеллекта. Я подготовил подробный разбор архитектурных особенностей SGD и Adam, их операционной карты и потенциальных уязвимостей.
Определение, границы и назначение SGD и Adam
Алгоритмы SGD и Adam заслуживают точного объяснения, поскольку их названия определяют конкретные информационные потоки, выбор методов обучения и границы управления. Рассмотрение их как синонимов «продвинутого ИИ» делает любые инженерные выводы непроверяемыми. Корректное определение включает три практических компонента: наличие идентифицируемого входа, характерную трансформацию и измеримый результат, который соотносится с поставленной целью.
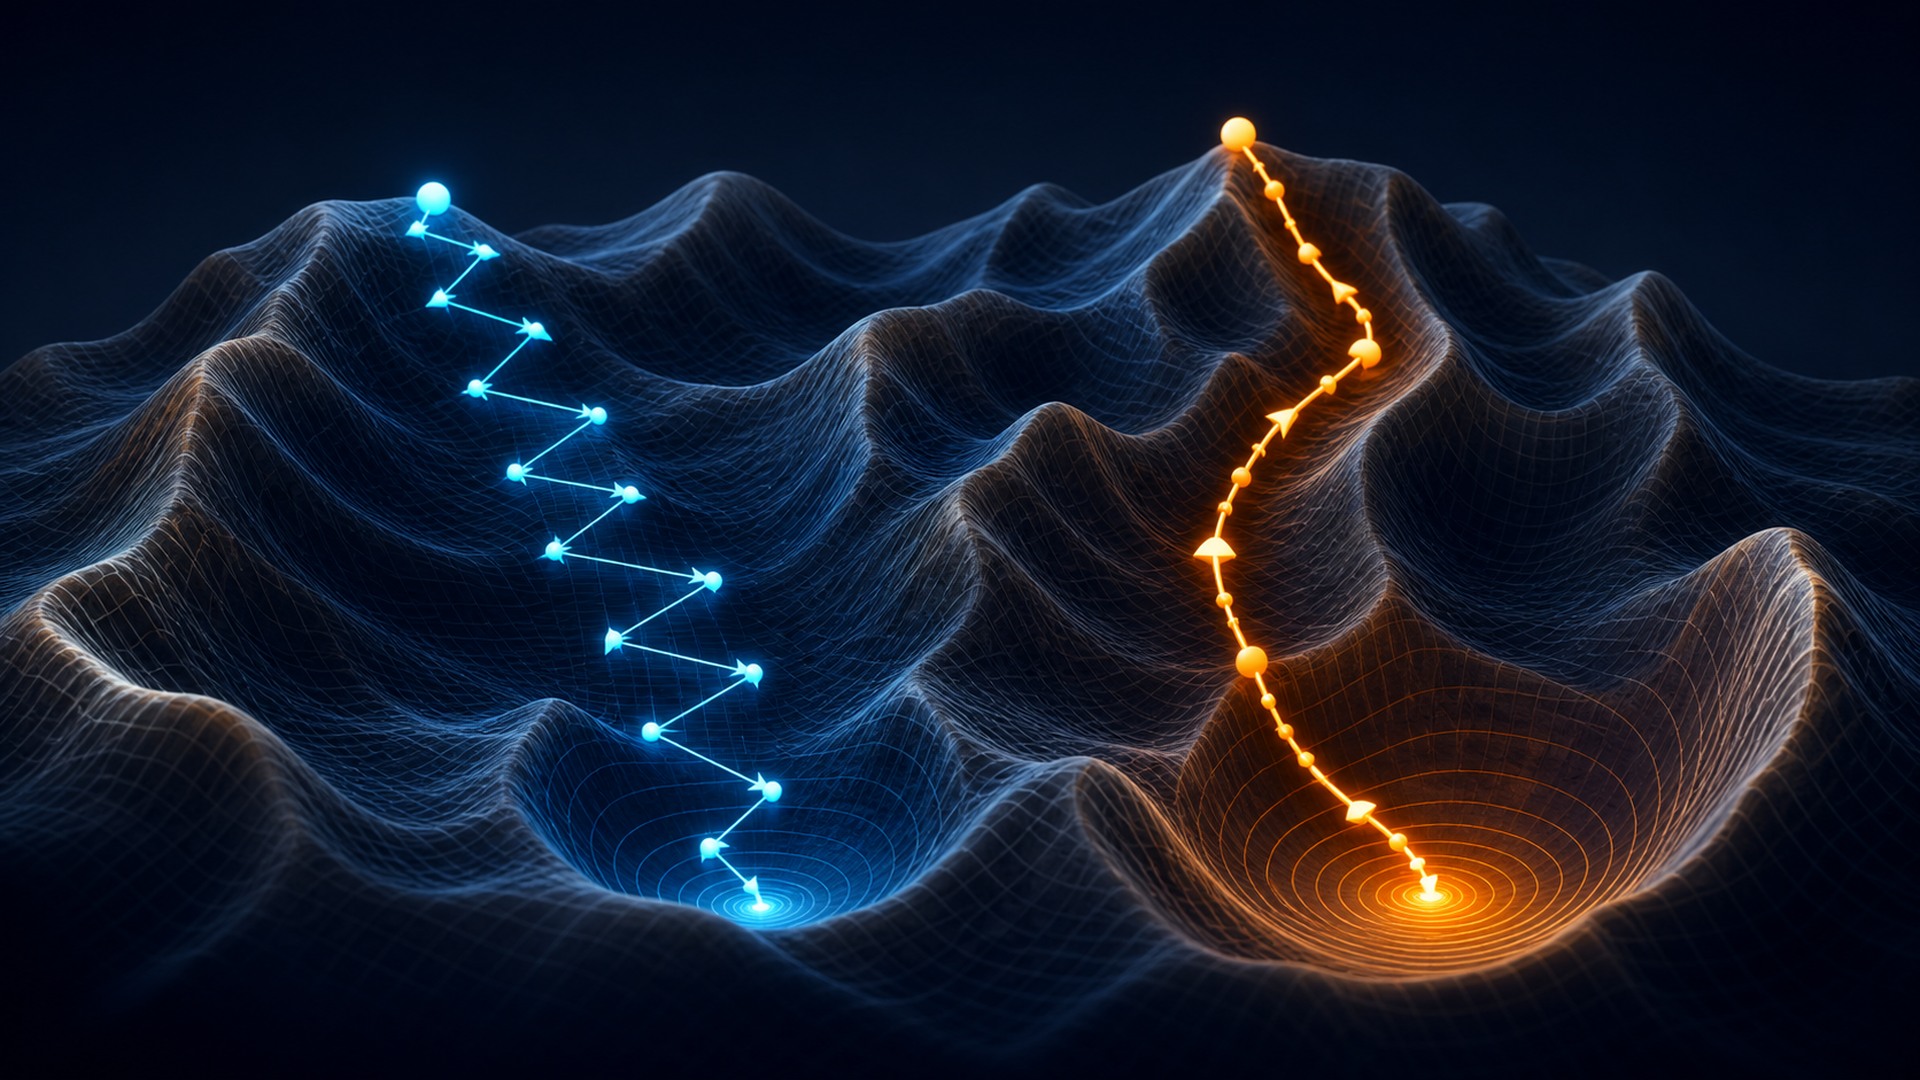
Статистическое обучение переводит конечные выборки в утверждения о будущих данных. Разделение выборок, оптимизация, регуляризация и мониторинг формируют единую проблему генерализации, а не изолированные учебные концепции. В контексте SGD и Adam системный подход показывает, что общая производительность зависит от окружения, интерфейсов и оборудования.
Главным заблуждением является путаница этих алгоритмов с методами поиска, которые оценивают модели целиком без использования градиентов. Хотя такие методы внешне схожи, они меняют причинно-следственную историю: для них требуются совершенно другие ресурсы и механизмы контроля.
Пятиэтапная операционная карта SGD и Adam
Процесс преобразования входных данных в итоговый результат в SGD и Adam можно представить в виде пяти последовательных операций. Данная схема служит компактной картой причинно-следственных связей, позволяя отслеживать изменение информации на каждом шаге.
1. Выборка мини-батча и вычисление функции потерь
На данном этапе система формирует мини-батч и рассчитывает потери. Важно понимать, какую именно информацию потребляет алгоритм и какое состояние он изменяет. Проверка должна подтверждать валидность этого шага и отличать его от безоградиентных методов поиска.
Регистрация неопределенности, использованных ресурсов и альтернатив на этом этапе позволяет вовремя заметить чувствительность алгоритмов к масштабу и расписанию шагов до того, как ошибки достигнут финального продукта.
2. Обратное распространение градиентов
На втором этапе происходит обратное распространение градиентов. Этот процесс требует фиксации входных данных и промежуточных состояний, чтобы обеспечить возможность последующего накопления моментов.
Качественное прохождение этого этапа гарантирует, что модель корректно оценивает направление и силу корректировки весов.
3. Накопление моментов или оценка моментов
Здесь алгоритмы демонстрируют ключевые отличия: классический SGD опирается на накопление импульса (momentum), тогда как Adam вычисляет скользящие средние как первых, так и вторых моментов градиента.
Такая трансформация позволяет Adam быстрее сходиться на сложных ландшафтах функций потерь, хотя требует дополнительной памяти под вспомогательные параметры.
4. Применение обновления параметров
На данном этапе оптимизатор непосредственно изменяет веса модели. Это важнейшая граница верификации, на которой проверяются ограничения стабильности обучения.
Фиксация параметров обновления помогает предотвратить деградацию модели и контролировать выполнение запланированного расписания скорости обучения.
5. Корректировка расписания скорости обучения и повторение
Завершающий этап включает настройку скорости обучения (learning rate schedule) и принятие решения о переходе к следующей итерации либо о завершении обучения.
Анализ карты в прямом направлении помогает понять логику продакшена, а в обратном — диагностировать причины сбоев, медленной сходимости или нестабильности.
Практический пример применения SGD и Adam
В качестве реального сценария можно рассмотреть обучение модели компьютерного зрения, где на начальных этапах для стабильности применяется AdamW, а затем используется SGD с тщательно настроенным расписанием шагов.
Подобный пример ценен тем, что привязывает алгоритмы к наблюдаемым входам и промежуточным состояниям. Изменение хотя бы одного базового предположения — например, ограничение вычислительных ресурсов или добавление противоречивых сигналов — позволяет проверить устойчивость метода.
SGD и Adam в сравнении с простыми альтернативами
Часто оптимизаторы ошибочно сводят к простым методам поиска без градиентов, стирая границу, определяющую саму суть алгоритмов. Это приводит к некорректному сравнению программных продуктов и неверной интерпретации экспериментов.
При оценке всегда следует учитывать единицу анализа: научная работа может изолировать алгоритм оптимизации, тогда как реальный сервис добавляет к нему кэширование, маршрутизацию, мониторинг и пользовательские интерфейсы.
Значение оптимизаторов в современных ИИ-системах
Сегодня алгоритмы оптимизации играют критическую роль, поскольку модели работают с большими контекстами, мультимодальными данными и глубоко интегрированы в бизнес-процессы.
Успех оценивается не по единичному впечатляющему результату, а по стабильности улучшений в репрезентативных условиях. Правильный выбор процедур помогает переносить достижения на новые аппаратные платформы и наборы данных.
Преимущества использования SGD и Adam
Главный аргумент в пользу этих оптимизаторов заключается в их способности напрямую решать поставленные задачи оптимизации. В зависимости от реализации это выражается в улучшении генерализации, снижении задержки или повышении точности.
Измерять пользу нужно через конкретные метрики решений: снижение частоты ошибок на сложных примерах, скорость восстановления после сбоев и соблюдение лимитов вычислительных затрат.
Характерные режимы сбоев
Основное ограничение заключается в том, что Adam способен сходиться очень быстро, тогда как SGD демонстрирует иные свойства генерализации, и оба метода крайне чувствительны к масштабу и графику обучения.
Системы контроля должны срабатывать до того, как сбой приведет к необратимым последствиям. Для этого определяются ранние признаки деградации и настраиваются автоматические сценарии восстановления.
План оценки эффективности оптимизаторов
Оценка начинается с четкого определения бизнес-задачи и последствий неверного результата. Использование нетронутого тестового набора данных и поэтапное развертывание в изолированной среде позволяют выявить скрытые проблемы.
Кроме того, необходимо фиксировать все компоненты пайплайна: исходные данные, версии токенайзеров, конфигурации и аппаратные допущения для обеспечения полной воспроизводимости результатов.
Вопросы перед внедрением
Перед тем как интегрировать конкретный оптимизатор в рабочий процесс, инженерная команда должна ответить на ключевые вопросы о целях оптимизации, используемых базисах, операционных издержках и потенциальных рисках масштабирования.
Первоисточники для изучения темы
Авторитетными отправными точками для глубокого погружения в тему служат руководство по выбору моделей scikit-learn, сборник рекомендаций Google Rules of Machine Learning и структура управления рисками NIST AI RMF, которые стоит изучать совместно с документацией к используемому аппаратному обеспечению.
Заключение
SGD и Adam представляют собой четко определенные математические механизмы внутри более крупных социотехнических систем. Их ценность проистекает из улучшения конкретных результатов в явных условиях, превращая алгоритмы в надежный инструмент инженерии и управления.
