
Мой блог
Кросс-валидация в машинном обучении: полное руководство по надежной оценке моделей ИИ

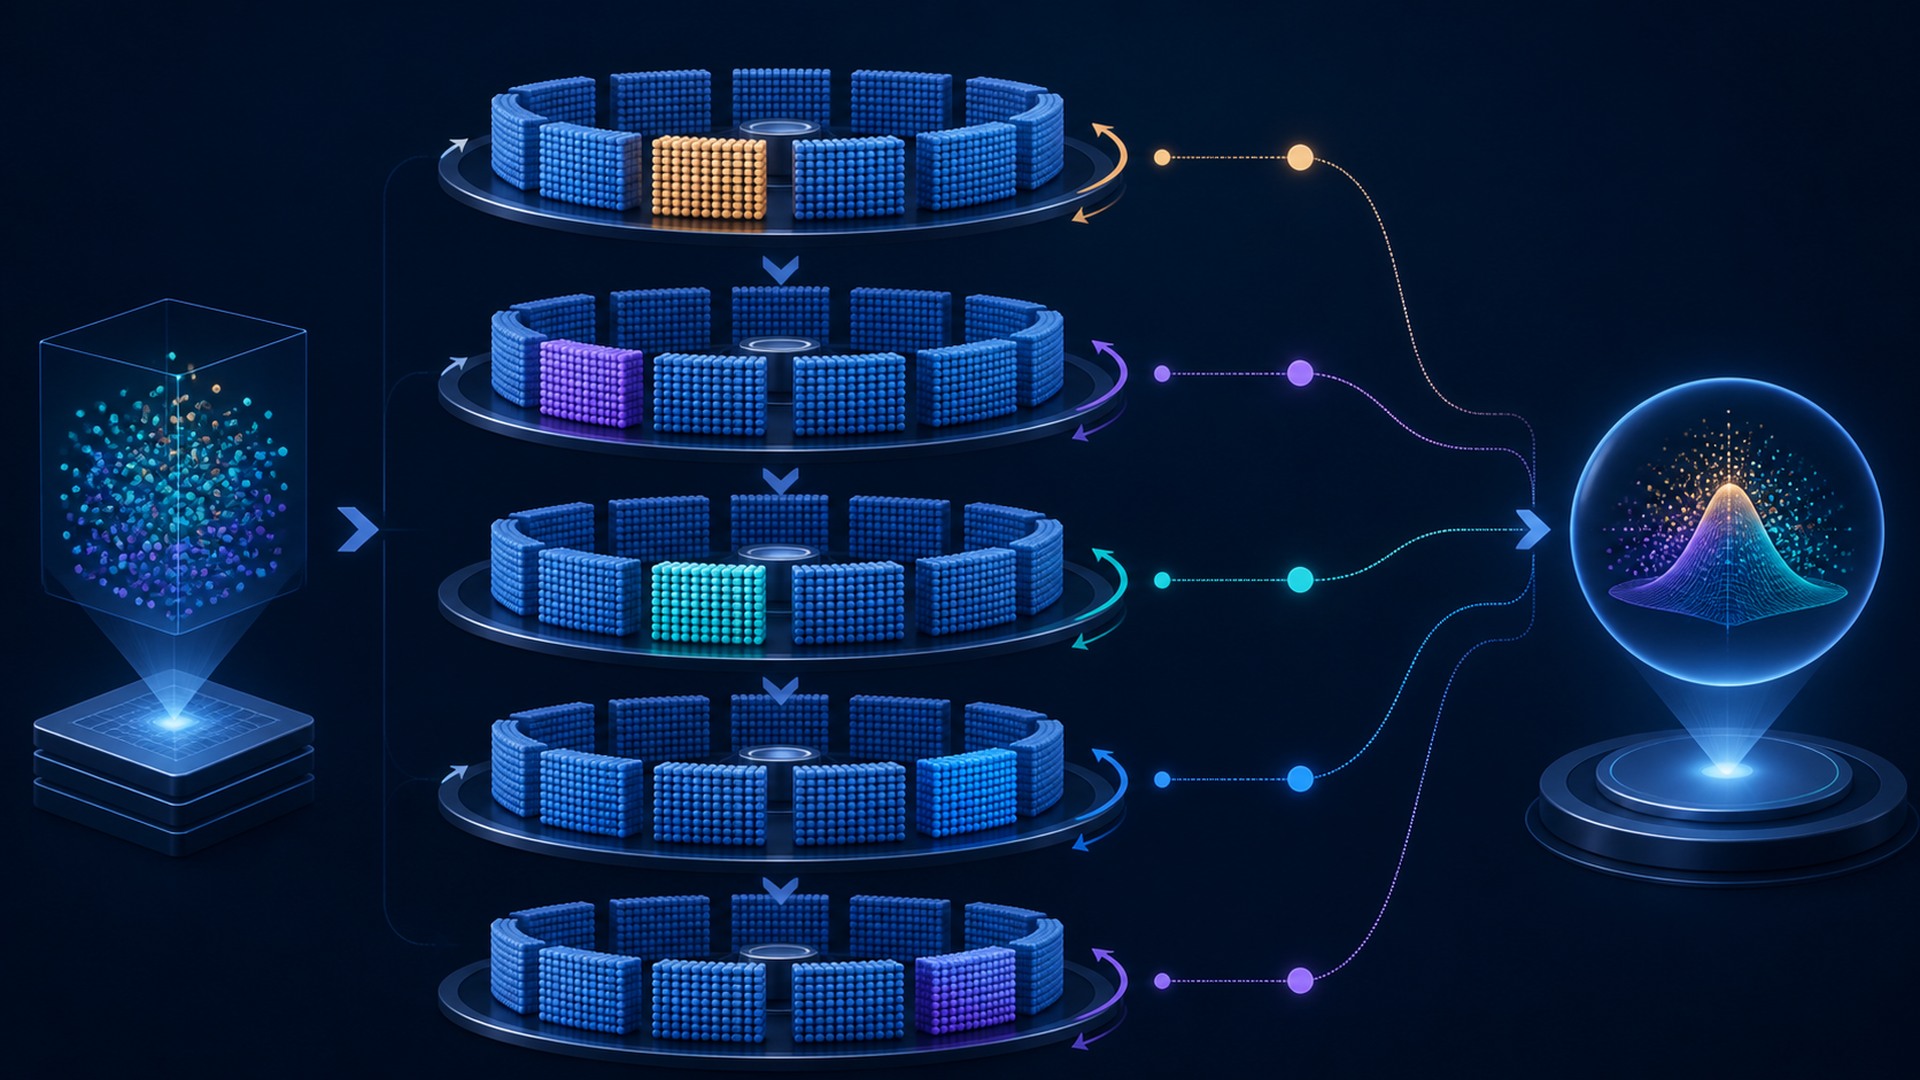
Когда стандартное разовое разделение датасета на обучающую и тестовую выборки дает нестабильные или противоречивые результаты, инженеры используют кросс-валидацию (перекрестную проверку). Этот метод систематически ротирует контрольные блоки данных, позволяя объективно оценить как итоговую точность модели, так и разброс её качественных показателей. В этом руководстве я подробно разберу внутреннюю механику кросс-валидации, ключевые компромиссы, поэтапную схему внедрения и методы контроля, необходимые в реальной практике разработки ИИ.
Кросс-валидация: определение, границы и главная цель
В своей основе кросс-валидация — это процедура многократной оценки модели на последовательно сменяющих друг друга контрольных сегментах (фолдах). Строгое техническое определение метода включает три обязательных элемента: четко идентифицируемый входной набор данных, специфическое преобразование или логику принятия решений, а также измеримый результат, сопоставимый с поставленной задачей. Если хотя бы один из этих компонентов отсутствует, термин превращается лишь в декларацию намерений, а не в работающий инженерный механизм.
Статистическое обучение переводит ограниченные выборки данных в утверждения о будущем behaviour модели на новых входящих потоках. Из-за этого разделение датасета, оптимизация гиперпараметров, регуляризация, подбор метрик и последующий мониторинг представляют собой единую комплексную задачу обеспечения обобщающей способности. Качество работы системы в продакшене определяется не только архитектурой самой нейросети, но и окружающим контекстом: интерфейсами, аппаратной базой, правами доступа и спецификой пользователей.
Самое распространенное и опасное подменяющее решение (shortcut) — это тестирование множества различных вариантов моделей непосредственно на итоговой тестовой выборке. Хотя внешне этот подход может напоминать перекрестную проверку, причинно-следственная связь в нем кардинально нарушается: возникнет утечка данных, изменятся затраты ресурсов и потребуются совершенно иные механизмы защиты от подгонки результатов.
Пятиэтапная операционная карта кросс-валидации
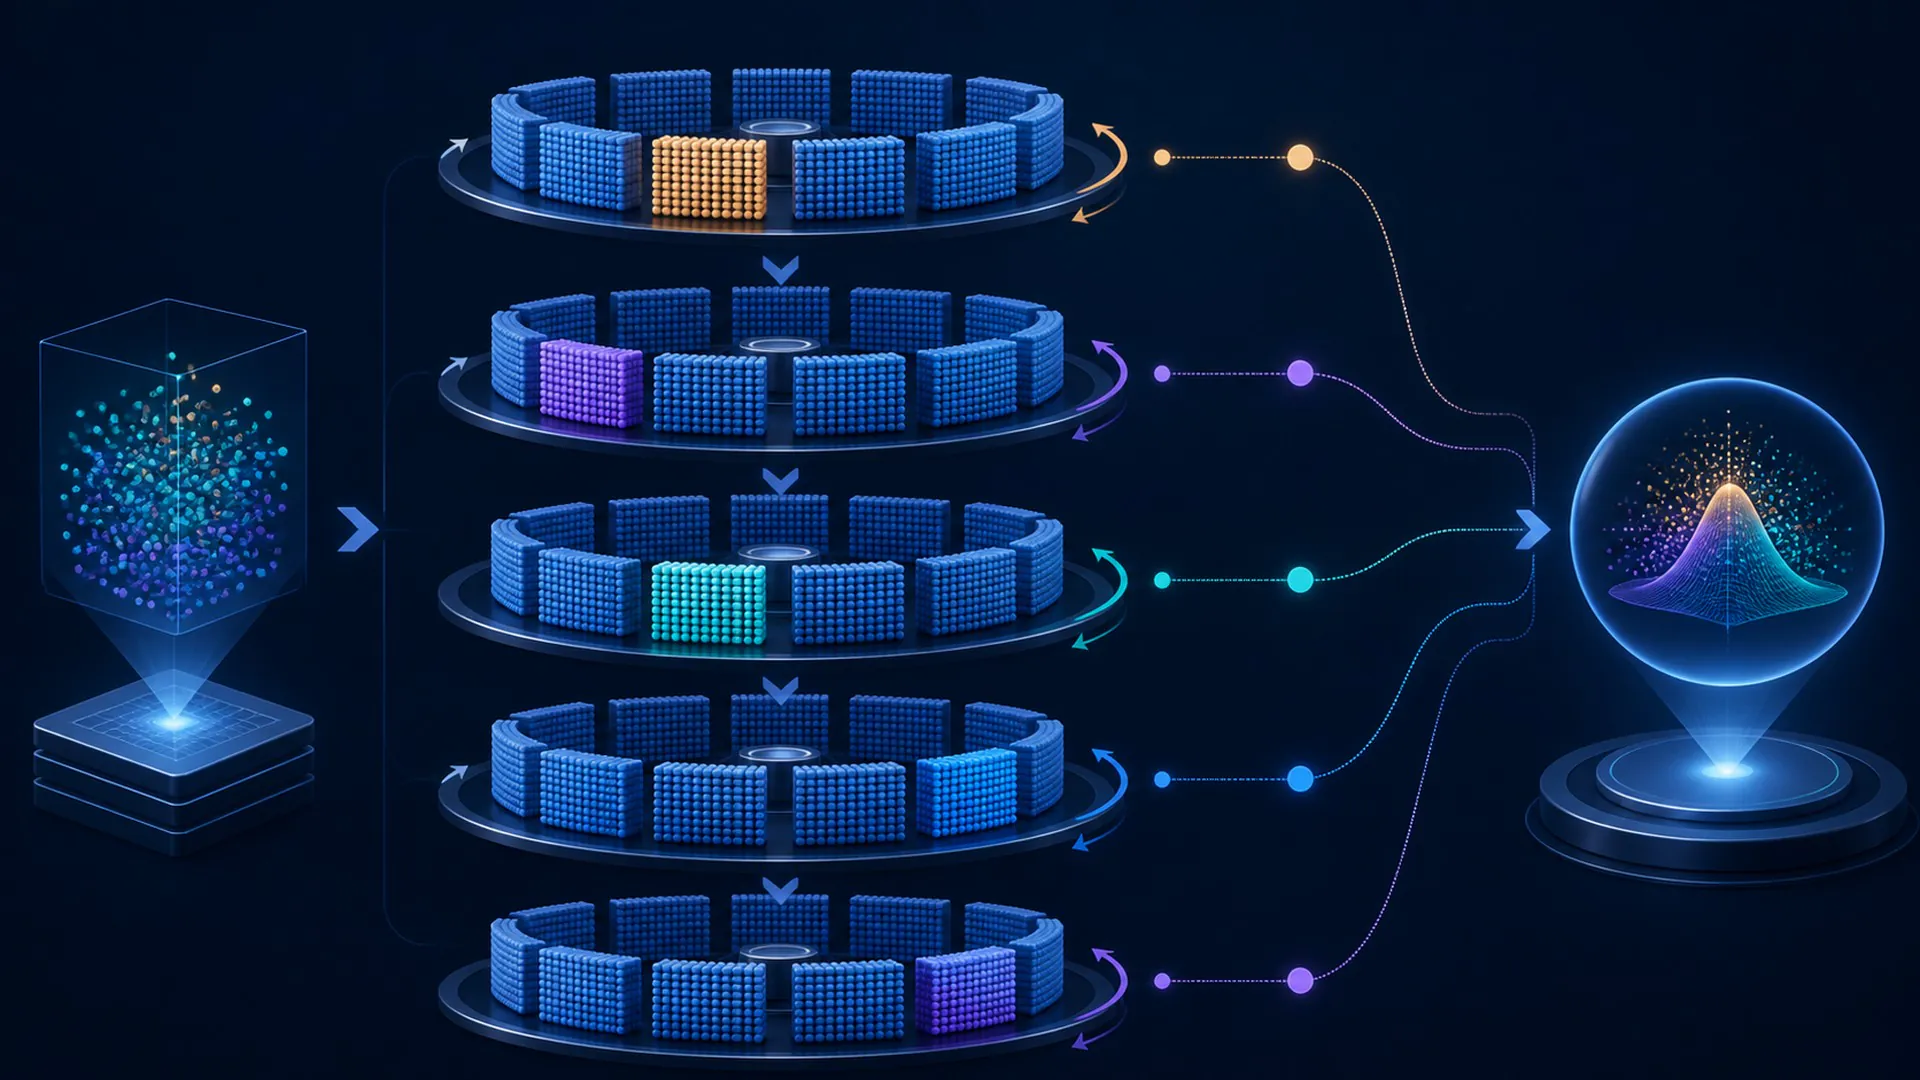
Процесс перекрестной проверки можно представить в виде понятной пятиэтапной схемы. Это не означает, что любое программное обеспечение обязано состоять из пяти изолированных модулей — некоторые системы объединяют шаги или выполняют их в цикле. Однако такая карта помогает четко определить границы ответственности, входные и выходные данные для каждого этапа.
1. Разбиение данных на подходящие фолды: входы и допущения
На начальном этапе система разделяет исходный массив данных на контрольные части (фолды). Практическая ценность этого шага заключается в понимании того, какие именно данные потребляет алгоритм, какое состояние он меняет и чем подтверждается корректность разбиения. На этом рубеже важно зафиксировать исходные ограничения: если датасет содержит временные ряды, пространственную привязку или групповые структуры, стандартный случайный выбор элементов приведет к искажениям, которые необходимо выявить до начала затратных вычислений.
2. Обучение на всех фолдах, кроме одного: представление и решения
После подготовки структуры данных модель обучается на объединении всех сформированных блоков, за исключением одного, оставленного для контроля. На этой стадии фиксируются затраты ресурсов, отклоненные альтернативные конфигурации и контрольные ограничения. Важно убедиться, что процедура обучения изолирована от отложенного блока и не использует его признаки даже косвенно.
3. Оценка на оставленном фолде: ключевое преобразование
Модель тестируется на том самом фолде, который не участвовал в процедуре подгонки весов. Это специфическое преобразование позволяет получить честную метрику качества для конкретного итерационного шага. Данные о точности, ошибках и нестандартных срабатываниях записываются в лог проверки.
4. Циклическая ротация до проверки всех фолдов: ограничения и границы
Процесс последовательно повторяется: роль контрольного сегмента переходит к следующему фолду, а предыдущий возвращается в обучающее множество. Ротация продолжается до тех пор, пока каждый без исключения блок не побывает в роли валидационной выборки. Это гарантирует, что каждый пример из исходного набора данных был использован для оценки ровно один раз.
5. Агрегация результатов и разброса: выходы, обратная связь и остановка
На заключительном этапе индивидуальные оценки со всех итераций объединяются. Инженеры рассчитывают не только среднее значение целевой метрики, но и ее стандартное отклонение (дисперсию). Это позволяет судить об устойчивости модели. Анализ карты «вперед» помогает правильно выстроить пайплайн, а анализ «назад» (от ошибочного результата к первым шагам) дает возможность вовремя найти фундаментальные ошибки в подготовке данных.
Практический пример применения кросс-валидации
Рассмотрим пример из области анализа медицинских данных. В датасете присутствуют неоднократные записи анализов одних и тех же пациентов. Если применить обычное случайное разбиение, карточки одного и того же человека попадут и в обучающий, и в валидационный блоки. Модель просто «запомнит» индивидуальные особенности пациента, что создаст иллюзию высокой точности.
Правильный подход здесь — использование групповой кросс-валидации (GroupKFold), где группирующим фактором выступает идентификатор пациента. Все записи конкретного человека остаются строго внутри одного фолда. Если изменить условия эксперимента — сократить доступные вычислительные мощности, добавить шумы или изменить профиль пользователей, — корректно построенная процедура кросс-валидации сразу покажет просадку метрик, уберегая от ошибочного релиза.
Кросс-валидация против популярной имитации
Как я уже отмечал, главный «заменитель» полноценной кросс-валидации — подгонка под итоговый тестовый набор. Сведение глубокой валидации к простому прогону десятка архитектур через тестовый датасет уничтожает методологическую грань и приводит к фатальным ошибкам.
| Критерий | Полноценная кросс-валидация | Упрощенный метод (shortcut) |
|---|---|---|
| Определение | Последовательная ротация отложенных фолдов для оценки среднего качества и разброса. | Многократное тестирование разных моделей на едином фиксированном тестовом сете. |
| Суть ошибки | Отсутствует (при корректном учете связей в данных). | Перенос информации из теста в процесс выбора модели (утечка данных). |
| Главный риск | Неверная интерпретация при наличии временных или групповых зависимостей. | Крайняя неадекватность оценок при выходе модели в реальный продакшен. |
При сравнительном анализе важно учитывать полный стек решения. Научная статья может рассматривать чистый алгоритм, но готовый сервисный продукт включает компоненты извлечения данных (RAG), маршрутизацию запросов, кэширование, правила безопасности и пользовательский интерфейс. Кросс-валидация должна оценивать ту часть системы, которая отвечает за итоговое качество решений.
Почему кросс-валидация критически важна для современных ИИ-систем
Сегодня нейросети получают доступ к огромным контекстным окнам, мультимодальным входам, сторонним инструментам через API и автономным агентским функциям. В таких условиях техническая деталь из области теории машинного обучения напрямую превращается в фактор бизнес-риска, влияющий на задержки (latency), финансовые затраты, безопасное исполнение и юридическую ответственность.
Главный показатель эффективности кросс-валидации — не разовый рекордный результат на удачном сплите, а стабильное улучшение целевой метрики при воспроизводимых условиях по сравнению с простым базовым решением (baseline). Вместо того чтобы сводить все результаты к единому среднему числу, профессиональный подход требует анализировать медианы, хвосты распределения задержек, категориальные ошибки и показатели на отдельных чувствительных подгруппах данных.
Преимущества, которые дает правильная кросс-валидация
Грамотно организованная кросс-валидация решающим образом устраняет узкие места в разработке ИИ. В зависимости от конфигурации системы она обеспечивает следующие практические выгоды:
- Надежное обобщение: защита от скрытого переобучения и гарантированная работоспособность на новых входящих потоках.
- Прозрачность оценок: точное понимание того, насколько результаты модели могут варьироваться от запуска к запуску.
- Оптимизация ресурсов: предотвращение затрат на масштабирование заведомо нестабильных архитектур.
- Безопасность решений: четкое установление границ, в пределах которых модели можно доверить автоматические действия.
При этом важно выражать выгоду в конкретных измеримых бизнес-метриках: проценте ошибок на сложных краевых случаях (edge cases), времени восстановления при некорректном контексте или снижении доли запросов, требующих ручной проверки человеком.
Ключевой сценарий сбоя, определяющий границы кросс-валидации
Главное ограничение кросс-валидации состоит в том, что обычный случайный (Random K-Fold) разбор полностью невалиден при наличии временных рядов, пространственной корреляции или явных групповых связей. Учет этого ограничения должен закладываться на этапе сбора данных и проектирования архитектуры, а не превращаться в формальную отписку после завершения проекта.
Чтобы минимизировать риски, рекомендую придерживаться следующего порядка контроля:
- Изолировать неприкосновенный контрольный датасет.
- Обучить базовую модель.
- Проверить принятые решения с учетом временной или групповой структуры.
- Оценить показатели на ключевых срезах данных.
- Организовать постоянный мониторинг дрифта (сдвига) данных после деплоя.
Любой защитный механизм имеет смысл только тогда, когда он срабатывает до наступления необратимых или дорогостоящих последствий. В случае обнаружения проблем система должна иметь четкий сценарий отката: понижение приоритета модели, переход на более простую алгоритмическую басовую линию или передача управления оператору.
План оценки и валидации при внедрении кросс-валидации
Процесс валидации должен начинаться с четкого описания решения, которое планируется принять на основе собранных доказательств. Сформулируйте целевую аудиторию, цену ошибки, доступную во время исполнения информацию и простейшую альтернативу. Это убережет команду от ситуации, когда бенчмарк становится самоцелью.
Используйте изолированный тестовый набор для контролируемых лабораторных сравнений, после чего проверяйте систему в поетапно усложняемой рабочей среде. Офлайн-тесты дают сопоставимость моделей, а канареечные релизы (canary deployment) или теневой режим (shadow mode) демонстрируют реальное поведение пользователей, обратные связи и нагрузку.
Обязательно версионируйте все артефакты, используемые в процессе: исходные данные, скрипты предобработки, токенизаторы, веса моделей, конфигурационные файлы, промпты, индексы векторных баз данных и тестовые среды. Без абсолютной прослеживаемости (lineage) невозможно определить, вызвано ли изменение точности настройкой алгоритма или незамеченным сдвигом в инфраструктуре.
Вопросы, которые необходимо задать перед внедрением
- Цель: Какое конкретное узкое место в системе должна устранить кросс-валидация?
- Механизм: На каком из пяти этапов происходит главное целевое преобразование?
- Базовый уровень: Как результат соотносится с простейшими альтернативами или оценкой на фиксированном сплите?
- Данные: Были ли протестированы сложные, антагонистические (adversarial) и специфические подвыборки?
- Затраты: Каковы накладные расходы по времени, памяти и вычислительной энергии при масштабировании?
- Риски: Как команда проверяет отсутствие скрытых временных или пространственных утечек?
- Восстановление: Запрограммирован ли откат системы при выходе показателей за допустимые границы?
Первоисточники для глубокого изучения
Для глубокого освоения методологии и практических стандартов оценки моделей рекомендую обратиться к авторитетным отраслевым источникам:
- Руководство по выбору моделей scikit-learn (scikit-learn Model Selection Guide);
- Правила машинного обучения от Google (Google Rules of ML);
- Фреймворк управления рисками ИИ от NIST (NIST AI Risk Management Framework).
Эти материалы дают качественный теоретический фундамент, однако финальную пригодность конкретной схемы валидации всегда определяет только эксперимент на ваших собственных данных и оборудовании.
Главные выводы о кросс-валидации
Кросс-валидация — это не просто красивый термин из профильной литературы, а строго описанный инженерный инструмент в рамках общей системы разработки ИИ. Его практическая ценность заключается в реальном повышении надежности и предсказуемости моделей при строго определенных условиях.
Главное правило успешного применения метода: четко формулировать цель, сравнивать результаты с сильным и простым бейзлайном, заранее тестировать наиболее опасные сценарии отказа и сохранять полную историю экспериментов для непрерывного мониторинга. С таким подходом перекрестная проверка становится надежным фундаментом для создания качественного и безопасного искусственного интеллекта.
Источник: www.unite.ai
