
Мой блог
Prior Labs выпустила TabPFN-3.5: модель для табличных данных, обогнавшая решение-победитель Kaggle

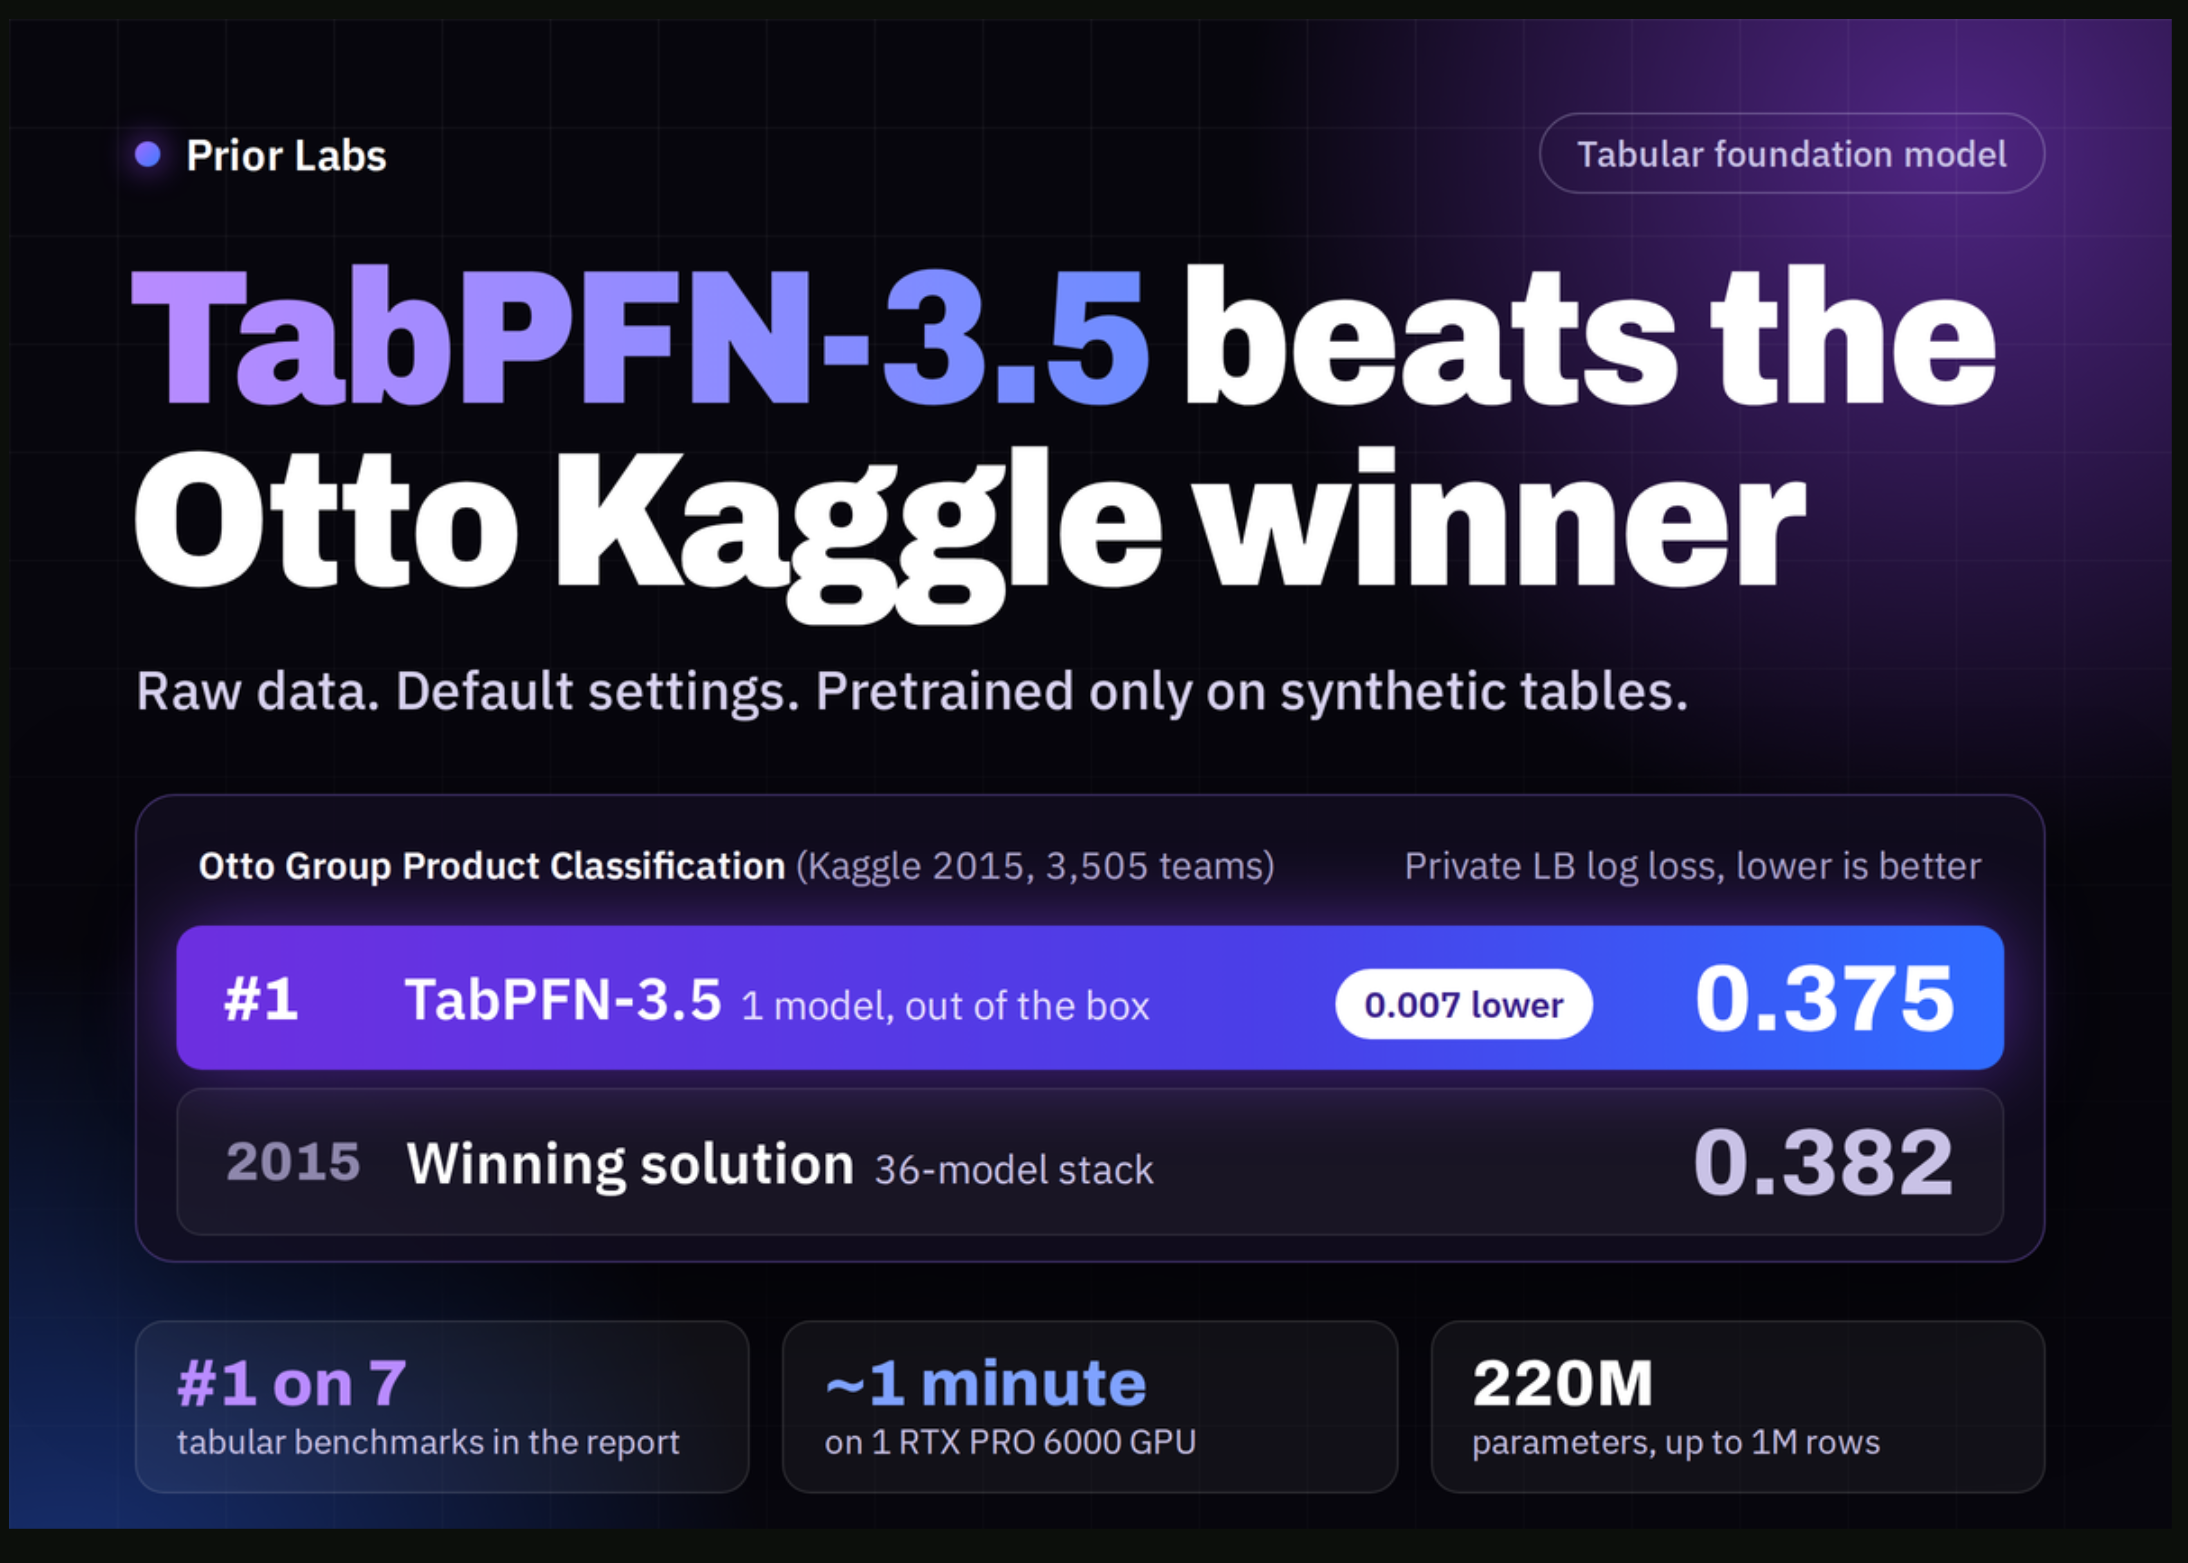
Компания Prior Labs представила TabPFN-3.5 — обновленную версию нейросетевой базовой модели (foundation model), предназначенной для обработки табличных данных. В отличие от традиционных градиентных бустингов или специализированных архитектур ML, TabPFN-3.5 выполняет прогнозирование за один прямой проход (forward pass). Ей не требуется дообучение под конкретный датасет или затратный поиск гиперпараметров. По заявлению разработчиков, модель заняла первое место сразу в семи независимых бенчмарках табличного машинного обучения. Кроме того, команда продемонстрировала рекордный результат на классическом датасете известного соревнования Kaggle.
С точки зрения развертывания и лицензирования модель поставляется с открытыми весами, доступными для исследовательской работы, оценки производительности и участия в соревнованиях Kaggle. Однако для коммерческого использования в продакшене потребуется получение API-ключа Prior Labs либо оформление специальной коммерческой лицензии.
Рекорд в соревновании Otto на Kaggle
Чтобы наглядно показать возможности модели, разработчики протестировали TabPFN-3.5 на материалах знаменитого состязания Otto Group Product Classification Challenge, прошедшего на платформе Kaggle в 2015 году. В том турнире участвовало 3505 команд, боровшихся за призовой фонд в 10 000 долларов. Участникам требовалось классифицировать товары по 9 категориям на основе 93 обезличенных числовых признаков. В качестве ключевой метрики качества выступала многоклассовая логистическая функция потерь (log loss), где меньшее значение указывает на лучший результат.
Победителями 2015 года стали известнейшие грандмастеры Kaggle Жильберто Титерич (Gilberto Titericz) и Станислав Семенов. Их решение представляло собой сложнейший многоуровневый ансамбль (стекинг) из 36 отдельных моделей с глубоким ручным инжинирингом признаков. Результат победителей составил 0,382 log loss.
Соразработчик фреймворка AutoGluon и исследователь Prior Labs Ник Эриксон (Nick Erickson) признался, что превзойти этот показатель было его многолетней целью. В статье 2020 года AutoGluon занимал лишь 23-е место. К 2023 году версия AutoGluon 1.0 поднялась до 14-й строчки, а версия 1.6 в августе 2026 года достигла 9-го места. По словам Эриксона, каждый шаг к вершине давался всё сложнее: если переход с 50-го места на 10-е сократил log loss с 0,41 до 0,40, то дальнейшее снижение с 10-го места до победного 0,382 потребовало разрыва в 0,018 — почти вдвое большего усилия.
Новая модель TabPFN-3.5 показала на приватном лидерборде Otto результат 0,375 log loss. Как я выяснил, для достижения этого показателя модели передали полностью необработанные сырые данные (raw data) с базовыми настройками по умолчанию. Расчет занял всего около одной минуты на одной видеокарте NVIDIA RTX PRO 6000 GPU. При этом модель предварительно обучалась исключительно на синтетически сгенерированных данных и никогда ранее не «видела» ни датасет Otto, ни другие таблицы Kaggle. Команда уже выложила воспроизводимый ноутбук для проверки результата.
Результаты в независимых бенчмарках
По данным технического отчета Prior Labs, TabPFN-3.5 захватила первое место в семи ключевых табличных бенчмарках: TabArena, BeyondArena, STRABLE, MulTaBench, RelArena-α, TALENT и ScoringBench. Важно отметить, что лидерские позиции распределились между несколькими модификациями архитектуры. Так, версия TabPFN-3.5-Thinking удерживает первенство в TabArena, BeyondArena, STRABLE и MulTaBench, а внутренняя сборка TabPFN-Rel одержала победу в RelArena-α.
В бенчмарке TabArena, объединяющем 51 живой датасет, модификация Thinking набрала 1910 пунктов по рейтингу Elo. Базовая версия показала 1866 пунктов, опередив модель TabFM+ (1823 Elo). Специалисты Prior Labs подчеркивают, что базовая версия TabPFN-3.5 превосходит AutoGluon 1.6 extreme на 130 пунктов Elo, затрачивая при этом в пять раз меньше времени.
Бенчмарк BeyondArena включает 142 набора данных со сложными признаками: сгруппированными, временными, с высокой размерностью, наличием текста и множеством категорий. Здесь TabPFN-3.5 обошла предыдущего лидера примерно на 150 пунктов Elo. Тем не менее разработчики честно отмечают: на отдельных подвыборках со строгой временной структурой или сгруппированными данными тщательно настроенные ансамбли многослойных перцептронов (MLP) все еще сохраняют преимущество.
Что изменилось в архитектуре модели
Чтобы добиться существенного роста качества и расширить возможности работы с большими таблицами, авторы переработали внутреннее устройство трансформера:
- Масштаб архитектуры: размерность скрытых представлений в контекстном трансформере выросла с 512 до 1024. Общее число параметров модели увеличилось до 220 миллионов (для сравнения, у TabPFN-3 в задаче классификации было 53 млн параметров).
- Единый чекпоинт: теперь один универсальный мультитаск-чекпоинт отвечает сразу и за классификацию, и за регрессию.
- Новое кодирование ячеек (cell encoding): значения таблиц проходят через обучаемые признаки Фурье и ранги эмпирической функции распределения (ECDF). Использование ECDF-рангов делает кодирование устойчивым к монотонным преобразованиям данных (например, логарифмированию).
- Упрощенная предобработка: разработчики полностью отказались от предварительного квантильного преобразования, робастного масштабирования и SVD-признаков.
- Рабочий объем: модель поддерживает таблицы объемом до 1 000 000 строк. Рекомендуемое число признаков составляет до 6 000, а максимально поддерживаемое — до 20 000.
- Настройка синтетического приора: алгоритмы генерации синтетических данных при обучении стали делать упор на таблицы с высокой категориальной размерностью, широкими структурами и сгруппированными столбцами.
Что касается производительности, объем кэша ключей и значений (KV-cache) остался практически на уровне TabPFN-3, несмотря на четырехкратное увеличение числа параметров. Скорость инференса для одиночных строк с использованием кэша осталась такой же высокой. Однако при обработке больших обучающих выборок базовая модель может работать до двух раз медленнее предыдущей версии.
Состав семейства TabPFN-3.5
Разработчики сформировали линейку из нескольких специализированных моделей:
- TabPFN-3.5 — базовая модель с открытыми весами на 220 млн параметров, использующая по умолчанию 8 эстиматоров.
- TabPFN-3.5-Fast (альфа-версия) — облегченная модель с открытыми весами на 84 млн параметров, работающая до 6 раз быстрее базовой.
- TabPFN-3.5-Plus — проприетарная версия, доступная через API и для enterprise-клиентов. Добавляет нативную поддержку текстовых полей и FP8-внимание.
- TabPFN-3.5-Thinking — модификация, расходующая дополнительное время на этапе инференса (test-time compute) без использования сторонних LLM или поиска по базе. Работает до 12 раз быстрее аналогичной версии предыдущего поколения TabPFN-3-Thinking.
Главные выводы
Релиз TabPFN-3.5 наглядно демонстрирует, что концепция базовых моделей (foundation models) применима не только к тексту и видео, но и к табличным данным. Возможность получить результат уровня Kaggle-грандмастеров за одну минуту без настройки гипепараметров существенно меняет подходы к быстрому прототипированию и анализу данных. Внимательно слежу за развитием этой технологии и рекомендую опробовать открытые весы в своих исследовательских проектах.
Источник: www.marktechpost.com
