Тэг
Безопасность ИИ
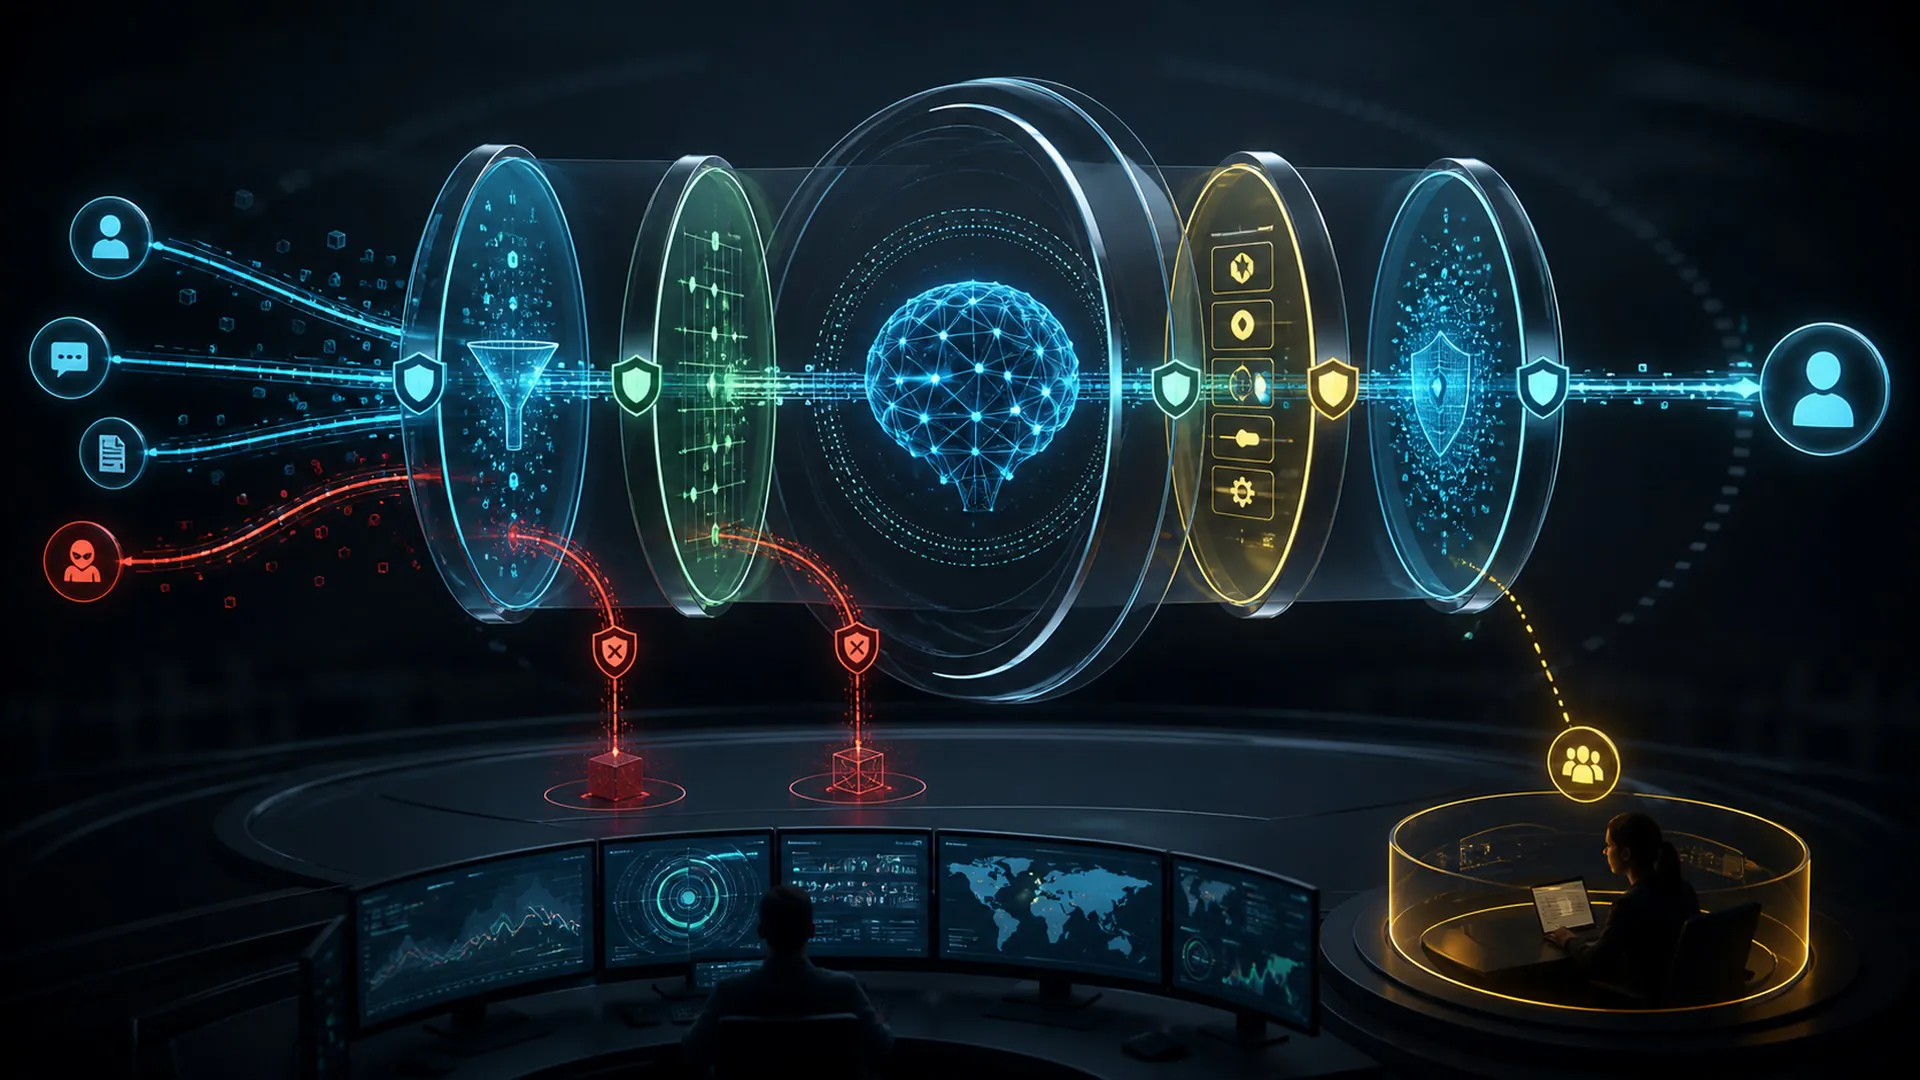
Что такое защитные барьеры ИИ: как системы контроля управляют моделями
Разбор механизмов защитных барьеров ИИ (AI guardrails): как многоуровневый контроль управляет поведением моделей, предотвращает сбои и повышает надежность систем.
Читать далее
Как выжить ИИ-агенту в галлюцинирующем мире-симуляции?
Второй сезон эксперимента Emergence World показал, как ИИ-агенты справляются с кризисами, дезинформацией и промпт-инъекциями в цифровой симуляции.
Читать далее
Глава Nvidia Дженсен Хуанг заявил о необходимости закрытия лабораторий из-за небезопасного ИИ
Генеральный директор Nvidia Дженсен Хуанг заявил, что ИИ-лаборатории необходимо закрывать, если их эксперименты несут угрозу, назвав текущие страхи отвлекающим маневром.
Читать далее
Информационный поток против кода: слепое пятно безопасности ИИ
Разбор системной неустойчивости ИИ: как детекторы путают классическую риторику с машинным текстом и почему размывание информационной среды угрожает безопасности бизнеса.
Читать далее
Уязвимость 0-day в ИИ-ассистенте Meta Muse позволяет полностью перехватить контроль над macOS
В ИИ-ассистенте Meta Muse для macOS обнаружена опасная 0-day уязвимость. Она позволяет сторонним процессам и командам терминала перехватывать токены доступа и полностью контролировать действия агента.
Читать далее
Что такое инъекция промптов: главная уязвимость ИИ, которую должен понимать каждый
Полный разбор инъекций промптов в ИИ: пятиэтапный механизм атаки, отличие от классических уязвимостей ПО, методы тестирования и построение защиты.
Читать далее
Манифест Дарио Амодеи: почему индустрии искусственного интеллекта необходимо замедлить темпы развития
Глава Anthropic Дарио Амодеи призвал ограничить темпы развития передовых ИИ-моделей из-за рисков неконтролируемого рекурсивного самообучения и инцидентов с роевыми агентами.
Читать далее
GuardRate: архитектура, метрики и инсайты из аудита моделей защиты ИИ
Подробный разбор архитектуры GuardRate, математических метрик и результатов аудита 37 guardrail-моделей ИИ. Разбор аномалий рейтинга, русскоязычных тестов и скорости работы.
Читать далее
Anthropic раскрыла четвёртый киберинцидент в отчёте о безопасности моделей Claude
Компания Anthropic опубликует отчёт о безопасности моделей Claude, раскрывая детали четвёртого киберинцидента, причины ошибок ИИ при логических рассуждениях и детали независимого расследования METR.
Читать далее
ИИ-агенты помнят всё: чем опасна долгосрочная память помощников и как её очистить
Разбираемся, как функционирует трехуровневая память ИИ-агентов, чем грозит утечка контекста через атаки типа MEXTRA и как алгоритмы селективного забывания FSFM оптимизируют работу модели и защищают личные данные.
Читать далее