Тэг
Нейросети
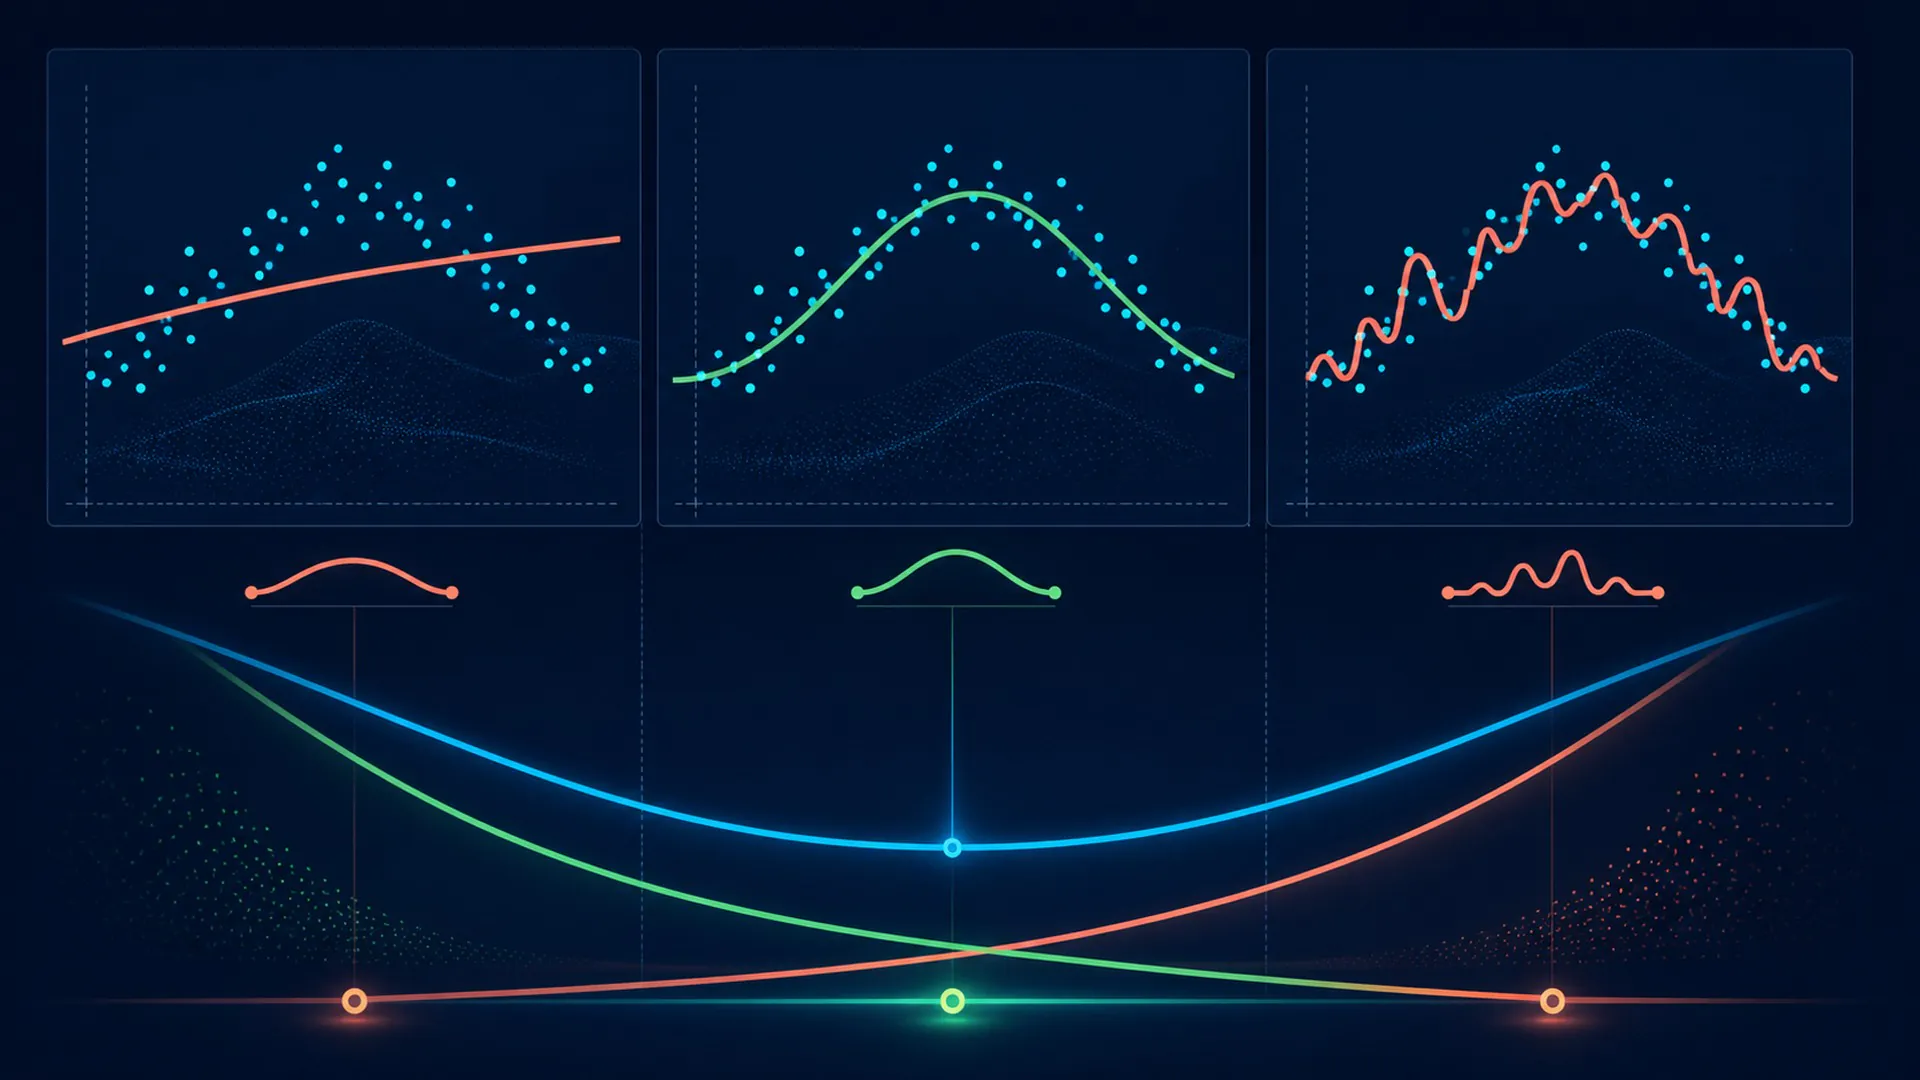
Что такое компромисс между смещением и дисперсией в машинном обучении
Разбор концепции баланса между смещением и дисперсией в машинном обучении: причины переобучения, этапы оценки моделей и практические методы контроля.
Читать далее
Как создать собственную русскоязычную модель решений на GPU за вечер
Практический опыт создания и дообучения русскоязычной модели решений на GPU: архитектура, метрики качества, преодоление типичных ошибок и сравнение с аналогами.
Читать далее
Saluki 27B: двухбитная модель превосходит оригинал Qwen в работе с инструментами
Обзор двухбитной нейросети Underdog Saluki 27B размером 7,89 ГБ, которая превосходит базовую модель Qwen в задачах вызова инструментов.
Читать далее
Зачем компании обучают крошечную LLM под одну узкую задачу
Разбор практики внедрения и дообучения компактных языковых моделей для решения узких корпоративных задач вместо дорогих флагманских решений.
Читать далее
Как устроена промышленная видеоаналитика на заводах СИБУРа
Как инженеры СИБУРа перестроили систему видеоаналитики для сотен камер на локальных серверах без остановки производства и видеокарт.
Читать далее
Автоматическая вычитка промптов Claude Code: как работает плагин Angry Switcher
Разбор плагина Angry Switcher для Claude Code, который фильтрует ненормативную лексику, исправляет опечатки и раскладку перед отправкой сообщений нейросети.
Читать далее
Создание ИИ-моделей своими руками: опыт работы с ИИ-агентом ML-intern
Как создавать и оптимизировать ИИ-модели без глубоких знаний кода с помощью ИИ-агента ML-intern. Практические примеры, затраты и пошаговый процесс.
Читать далее
Anthropic обновила политику использования нейросетей Claude
Anthropic опубликовала ежегодное обновление политики использования ИИ-систем на 2026 год, ужесточающее правила в отношении дезинформации, оружия и общения с моделями.
Читать далее
Тестирование консистентности ИИ-агентов и логика их решений
Анализ работы ИИ-агентов показывает, что автоматизация коммуникаций требует проверки не только тональности, но и логики принимаемых коммерческих решений.
Читать далее
FRIDA Decisions: быстрая открытая модель быстрого мышления для русского языка
Обзор открытой модели FRIDA Decisions для быстрого анализа текста, классификации и маршрутизации на русском языке без генерации токенов.
Читать далее