
Мой блог
Что такое компромисс между смещением и дисперсией в машинном обучении

Концепция баланса между смещением и дисперсией описывает внутреннее противоречие алгоритмов, которые оказываются либо слишком жесткими для выявления реальных закономерностей, либо излишне чувствительными к случайным особенностям обучающей выборки. Понимание того, как работает компромисс между смещением и дисперсией, позволяет инженерам точнее настраивать модели и контролировать качество прогнозов.
В сфере машинного обучения данный баланс заслуживает детального рассмотрения, поскольку его название отражает конкретные потоки данных, параметры обучения, механизмы выполнения и границы ответственности. Если воспринимать это явление как абстрактный синоним сложного искусственного интеллекта, делать проверяемые выводы становится невозможно. В данном материале рассматривается вся цепочка от исходных предположений до наблюдаемых результатов, а также разбираются наиболее частые путаницы с другими понятиями.
Определение, границы и назначение концепции
Данная проблема возникает на стыке статистического обучения, которое преобразует конечные наборы данных в утверждения о будущей информации. Процедуры разделения данных, оптимизации, регуляризации, измерения метрик и мониторинга представляют собой единую задачу достижения общей генерализации, а не изолированные приемы из учебников. Наличие окружения, инфраструктуры, интерфейсов, аппаратного обеспечения и человеческого фактора может определять производительность системы даже в тех случаях, когда базовая модель остается неизменной. Поэтому полезный анализ всегда отделяет изученное поведение алгоритма от работы продукта, принимающего решения о его применении.
Распространенной ошибкой является подмена этого понятия социальным или демографическим смыслом предвзятости в сфере ответственного искусственного интеллекта. Несмотря на внешнее сходство терминов, причинно-следственная связь здесь иная: для подтверждения успеха требуются другие доказательства, затраты распределяются иначе, а предотвращение рисков достигается другими методами. Таким образом, граница носит сугубо операционный характер.
Пятиэтапная операционная карта
Преобразование входных данных в итоговый результат в рассматриваемой схеме можно разбить на пять последовательных этапов. Представленная схема выступает в роли компактной причинно-карты, а не жесткого требования использовать строго пять программных компонентов. Некоторые архитектуры объединяют шаги, тогда как другие выполняют их циклически.
1. Подгонка модели с ограниченной или гибкой емкостью
На первом этапе система должна настроить модель с фиксированной или настраиваемой сложностью. Ключевой вопрос заключается не только в самом факте выполнения операции, но и в том, какие данные она использует, какое состояние изменяет и какие свидетельства подтверждают корректность этого изменения. Переход к следующему шагу опирается на заявленную цель и должен завершаться результатами, пригодными для оценки обучающей и тестовой погрешности.
2. Измерение ошибок на обучающей и отложенной выборках
На данном этапе происходит фиксация метрик качества как на тренировочных данных, так и на независимом наборе. Фиксация неопределенности, отброшенных альтернатив и использованных ресурсов помогает вовремя заметить потенциальные проблемы, когда низкая ошибка на обучении маскирует слабую способность к обобщению.
3. Диагностика систематического недообучения или нестабильности
Система должна выявить, страдает ли модель от недостаточной емкости или, напротив, проявляет избыточную чувствительность к шуму. Анализ позволяет перейти к целенаправленной корректировке признаков или параметров архитектуры.
4. Настройка признаков, данных, регуляризации или емкости
На этом шаге применяются ограничения и выполняются корректировки для устранения выявленных дефектов. Проверяется соответствие между задействованными ресурсами и достигнутыми промежуточными показателями.
5. Повторение цикла на репрезентативных выборках
Финальный этап закрепляет результат на разнообразных данных, формируя правила остановки, мониторинга или окончательного принятия решений. Прямой анализ карты позволяет понять логику продакшена, а обратный — помогает диагностировать причины сбоев, уходящих корнями в исходные предположения.
Практический пример проявления баланса
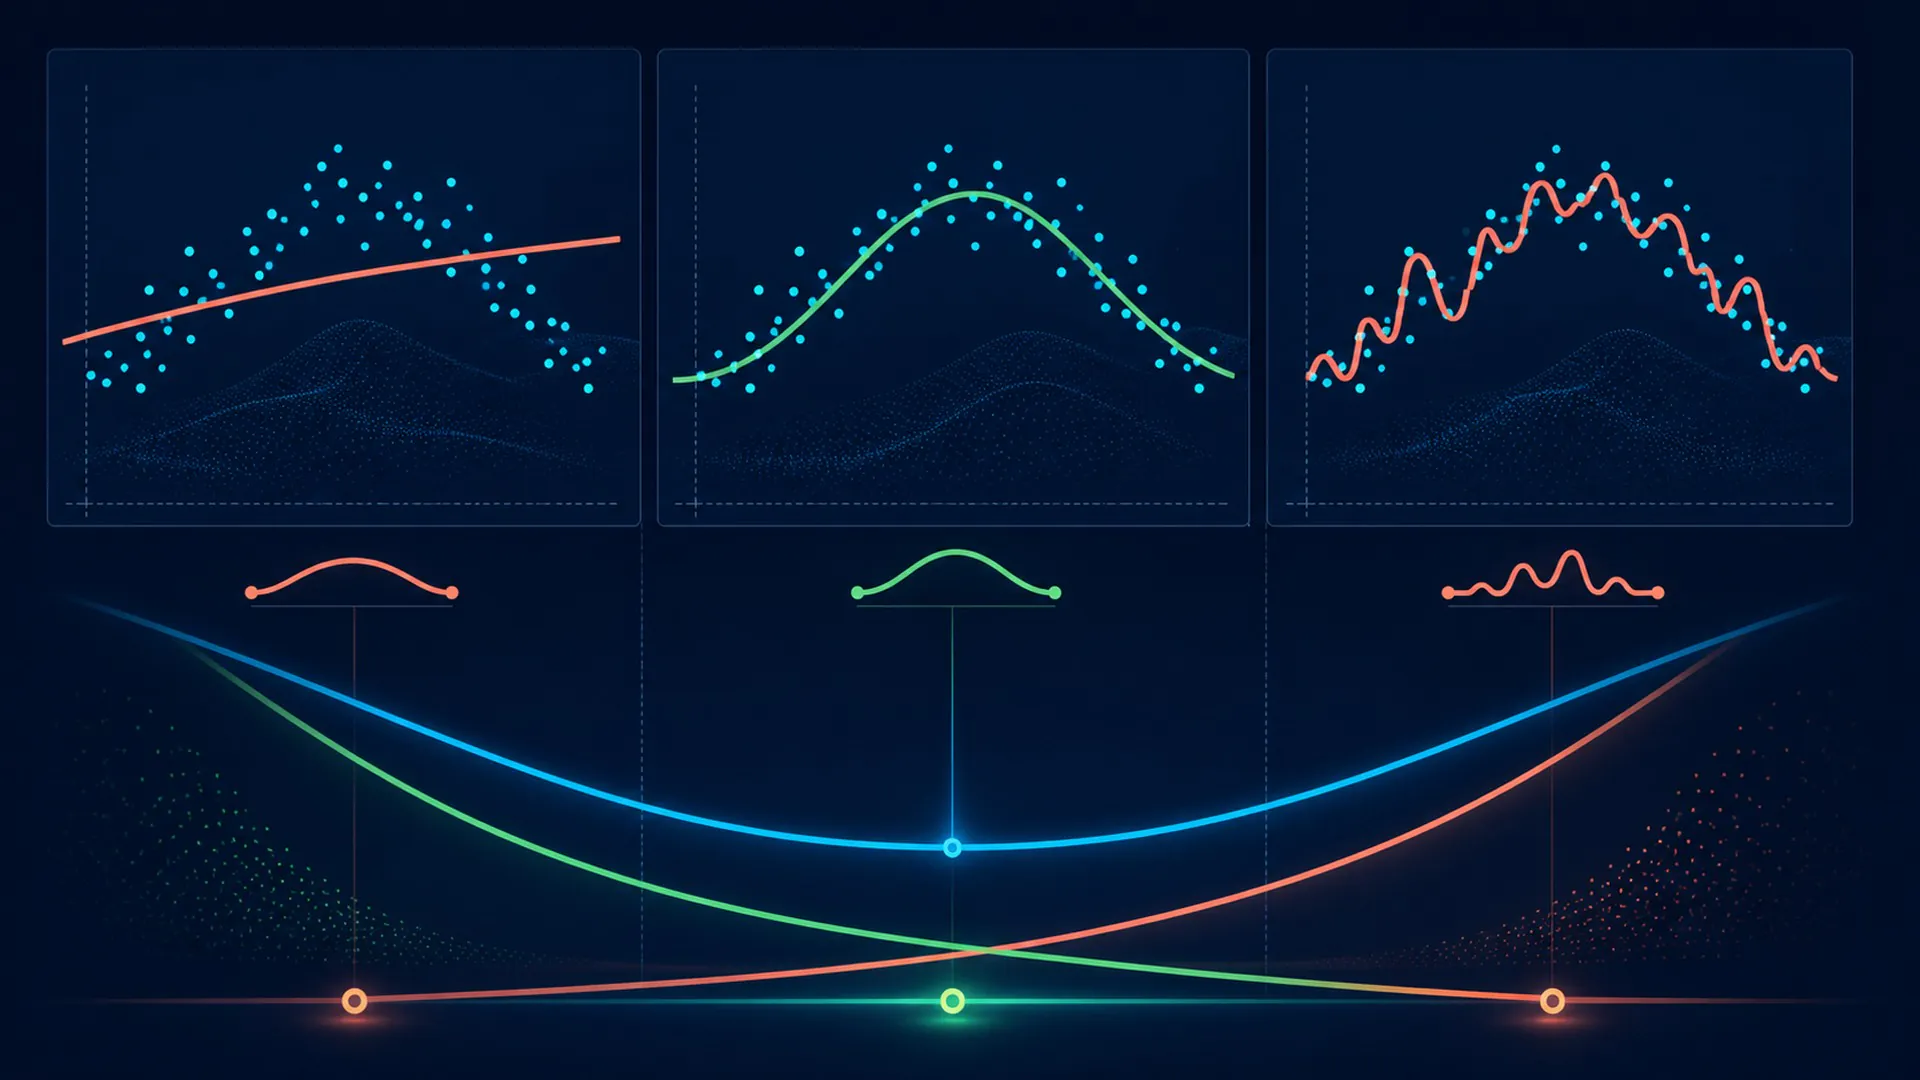
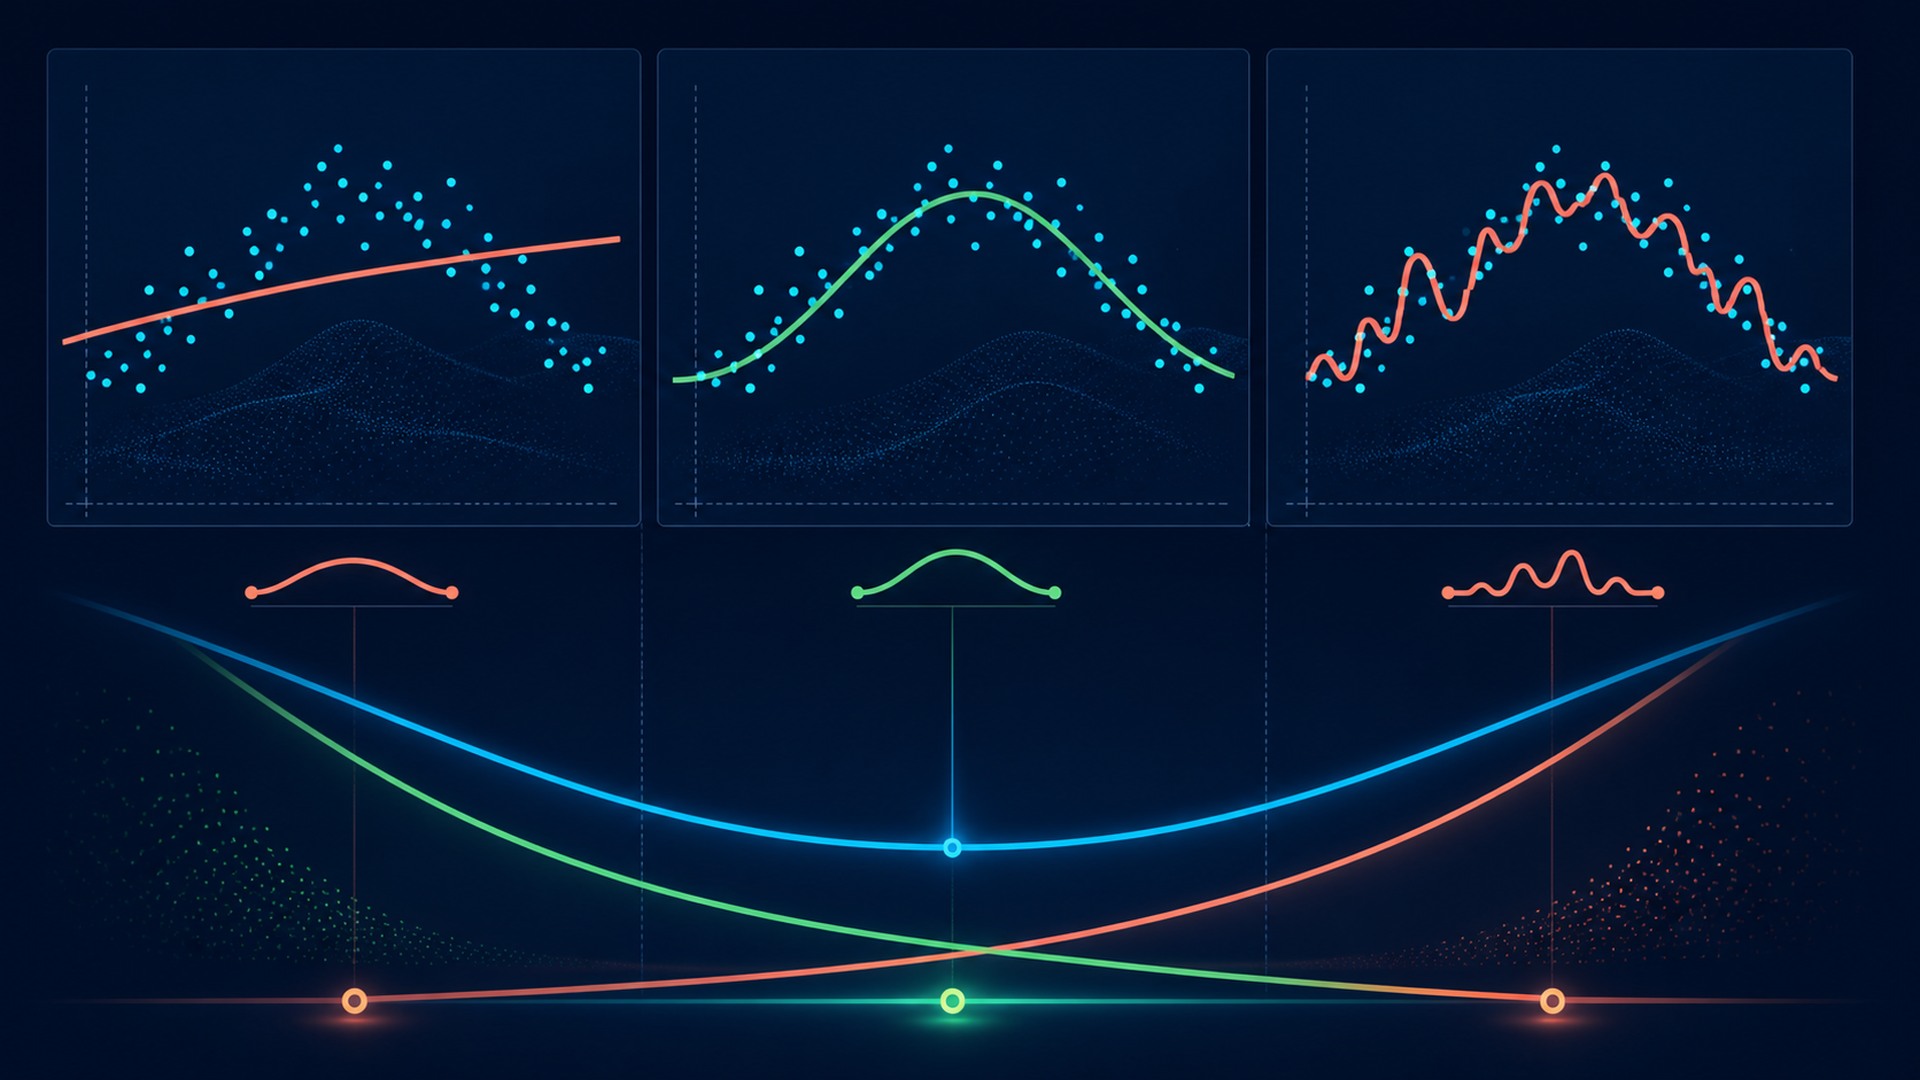
Простая прямая линия неизбежно демонстрирует недообучение на искривленной зависимости, тогда как чрезмерно извилистая кривая просто заучивает зашумленные точки. Золотая середина сложности позволяет добиться лучшего обобщения. Подобный пример удобен тем, что рассматриваемый компромисс привязан к наблюдаемым входам и выходам, а не к абстрактным умозаключениям. Строгое тестирование требует создания стандартных, сложных и заведомо вводящих в заблуждение сценариев.
Сравнение с наиболее частым заблуждением
Смещение часто путают с социальными аспектами предвзятости. Такое упрощение стирает границу понятия, заставляя покупателей сравнивать несопоставимые продукты, а исследователей — делать неверные выводы из экспериментов. Анализ должен учитывать единицу измерения: научная работа может изолировать отдельный алгоритм, в то время как готовый сервис добавляет к нему механизмы поиска, кэширования, маршрутизации, политики безопасности и пользовательские интерфейсы.
Значение баланса в современных системах ИИ
Актуальность темы обусловлена ростом контекстов, модальностей, вычислительных мощностей и интеграции ИИ в организационные процессы. В подобных условиях то, что раньше казалось деталью академических исследований, напрямую влияет на задержки, безопасность, стоимость инфраструктуры и юридическую ответственность. Релевантная оценка требует анализа распределений, категорий ошибок и ресурсов, а не сведения всех результатов к единому среднему значению.
Основные преимущества подхода
Грамотное управление рассматриваемым компромиссом позволяет напрямую устранять целевые узкие места. Преимущества могут выражаться в улучшенном обосновании решений, более точной репрезентации данных, снижении задержек или повышении безопасности на стыке предложений модели и реальных действий. Ожидаемые эффекты обязательно выражаются в метриках: уровне ошибок на сложных кейсах, стоимости обработки трафика или времени ручной проверки.
Ключевой фактор риска
Главная трудность заключается в том, что минимальная ошибка на обучающей выборке способна маскировать крайне хрупкую способность к обобщению. Данный риск должен учитываться на всех стадиях — от сбора данных и проектирования архитектуры до настройки прав доступа и релизных ограничений. Средства контроля эффективны только тогда, когда срабатывают до наступления дорогостоящих или необратимых последствий.
План оценки эффективности
Оценка начинается с фиксации решения, которое должны подтвердить собранные данные. Инженеры определяют целевую популяцию, последствия неверного результата и простейшую правдоподобную альтернативу. Для контролируемых сравнений применяется нетронутый тестовый набор, после чего модель проверяется в условиях поэтапного развертывания с использованием теневого режима или лимитов трафика. Воспроизводимость обеспечивается жестким версионированием исходных данных, препроцессинга, весов, конфигураций и аппаратных допущений.
Вопросы перед внедрением подхода
- Какое измеримое узкое место призвана устранить настраиваемая модель?
- Какой именно этап отвечает за ключевое преставление данных?
- С какой базовой альтернативой проводится сравнение?
- Какие сценарии — от стандартных до состязательных — были протестированы?
- Как система обнаруживает скрытое переобучение под обучающую выборку?
Заключение
Рассматриваемый баланс представляет собой четко определенный механизм внутри масштабной социотехнической системы. Его ценность заключается в улучшении конкретных показателей в явных условиях, а не в самом названии. Следование базовым инженерным принципам позволяет превратить теоретическую концепцию в надежный инструмент разработки и управления рисками.
