
Мой блог
Что такое MLOps: как команды строят, развертывают и мониторят системы машинного обучения

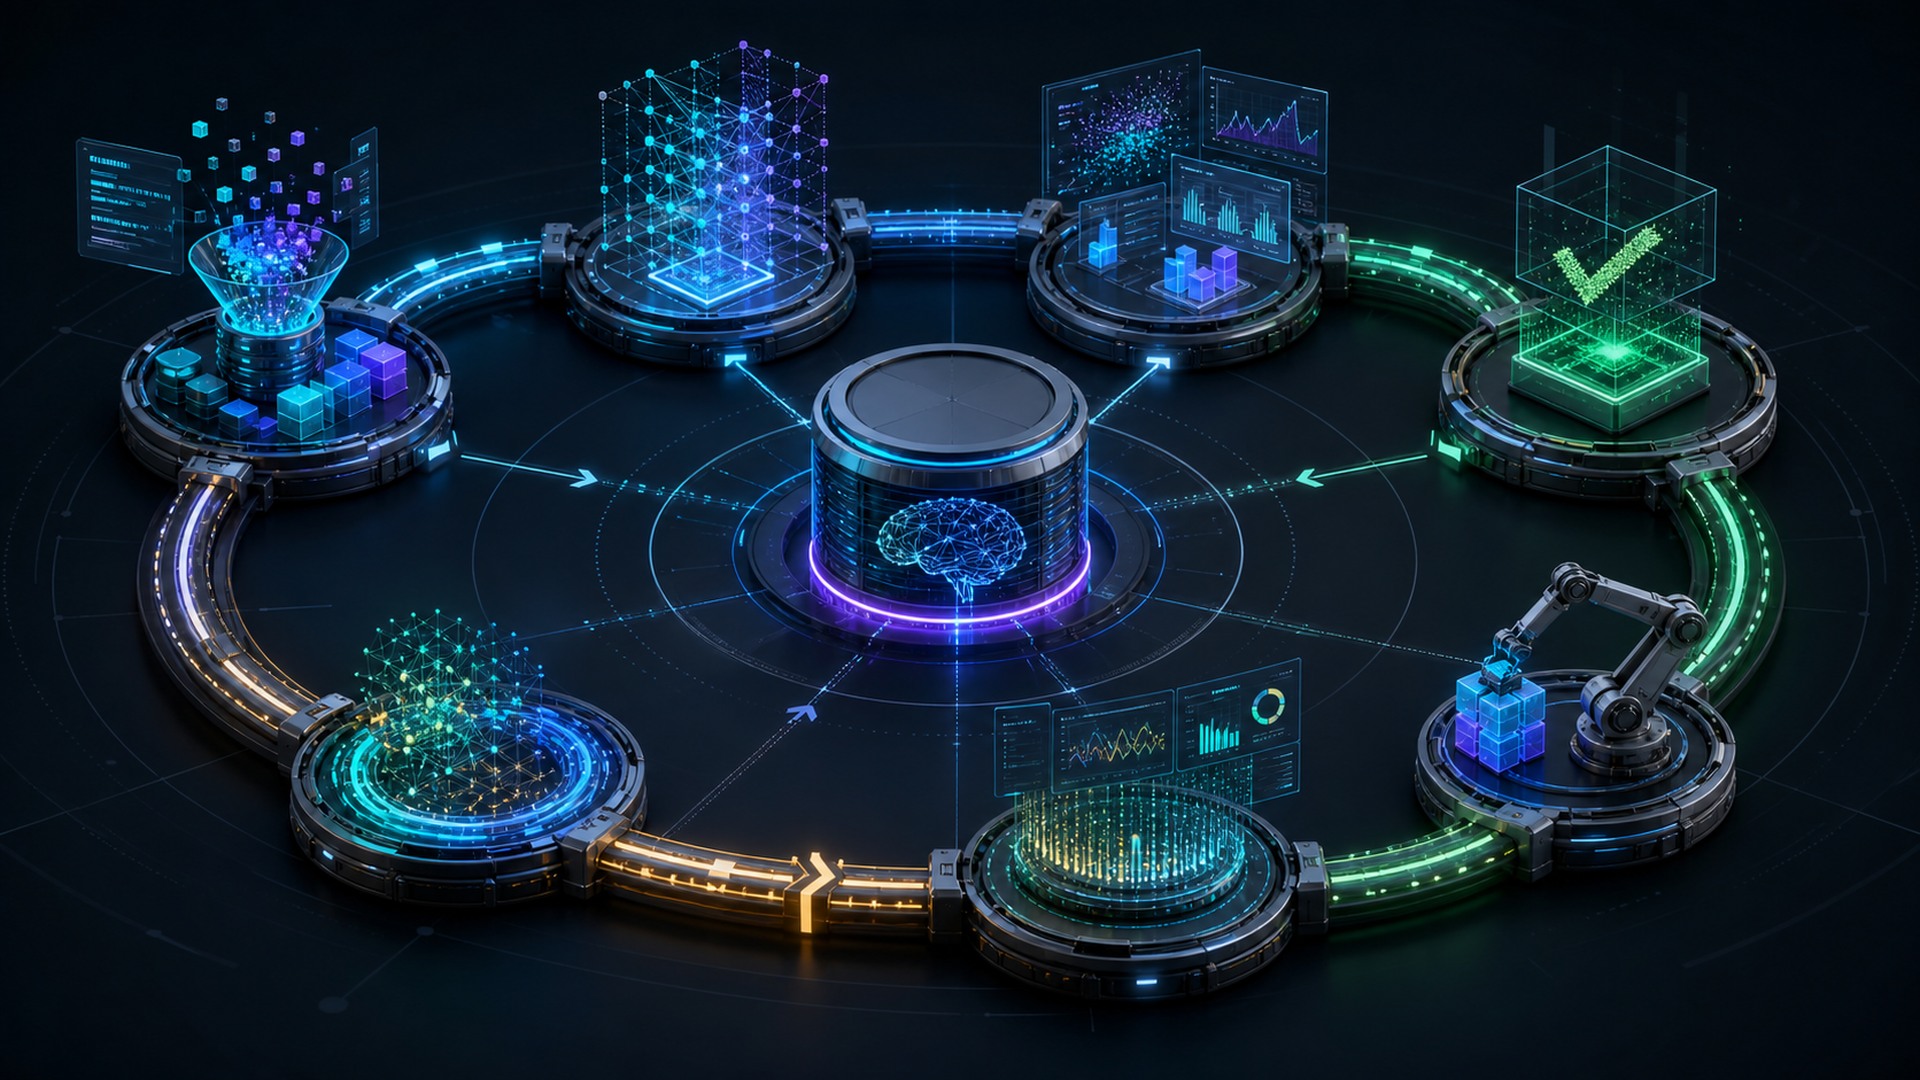
MLOps (Machine Learning Operations) — это инженерная и управленческая дисциплина, предназначенная для воспроизводимого создания, развертывания, наблюдения и обновления систем машинного обучения в промышленной эксплуатации (продакшене). Если воспринимать этот термин лишь как синоним «продвинутого ИИ», любые заявления о производительности и надежности системы становится невозможно проверить на практике. Как специалист, регулярно работающий с нейросетями и программной инфраструктурой, я рекомендую рассматривать MLOps через четко определенные информационные потоки, механизмы исполнения и границы ответственности.
В этом руководстве мы разберем MLOps от входных предпосылок и данных до конечного измеримого результата, рассмотрим 5-этапную операционную карту и проанализируем ошибки, к которым приводит упрощенное понимание этой дисциплины.
MLOps: Определение, границы и назначение
Дисциплина MLOps держится на трех практических обязательствах:
- Наличие идентифицируемого входа (данные, код, настройки, окружение);
- Характерное для MLOps преобразование или принятие решения (автоматизированный пайплайн, валидация, регистрация);
- Воспроизводимый результат, который оценивается относительно поставленной бизнес-цели.
Если хотя бы один из этих элементов отсутствует, использование термина MLOps обозначает скорее абстрактное намерение, чем реальный инженерный механизм. Статистическое обучение превращает ограниченные выборки данных в утверждения о будущих показателях. По этой причине разделение данных, оптимизация, регуляризация, сбор метрик и мониторинг представляют собой единую задачу обобщения, а не набор изолированных академических приемов.
С системной точки зрения итоговое качество ИИ-продукта часто определяется окружающими его данными, интерфейсами, аппаратной платформой, правами доступа и действиями людей, даже если сама алгоритмическая модель остается неизменной. На практике важно отделять выученное поведение модели от сервисного контура, который определяет, когда, где и с какими полномочиями это поведение задействуется.
Самое распространенное и ошибочное «сокращение пути» — это попытка применить стандартный DevOps исключительно к REST API, полностью игнорируя жизненный цикл данных и самой модели. Хотя у них есть общие внешние черты, причинно-следственная связь здесь принципиально иная: успешность системы подтверждается другими доказательствами, основные затраты уходят на другие ресурсы, а предотвращение сбоев требует совершенно иных контролей.
Пятиэтапная операционная карта MLOps
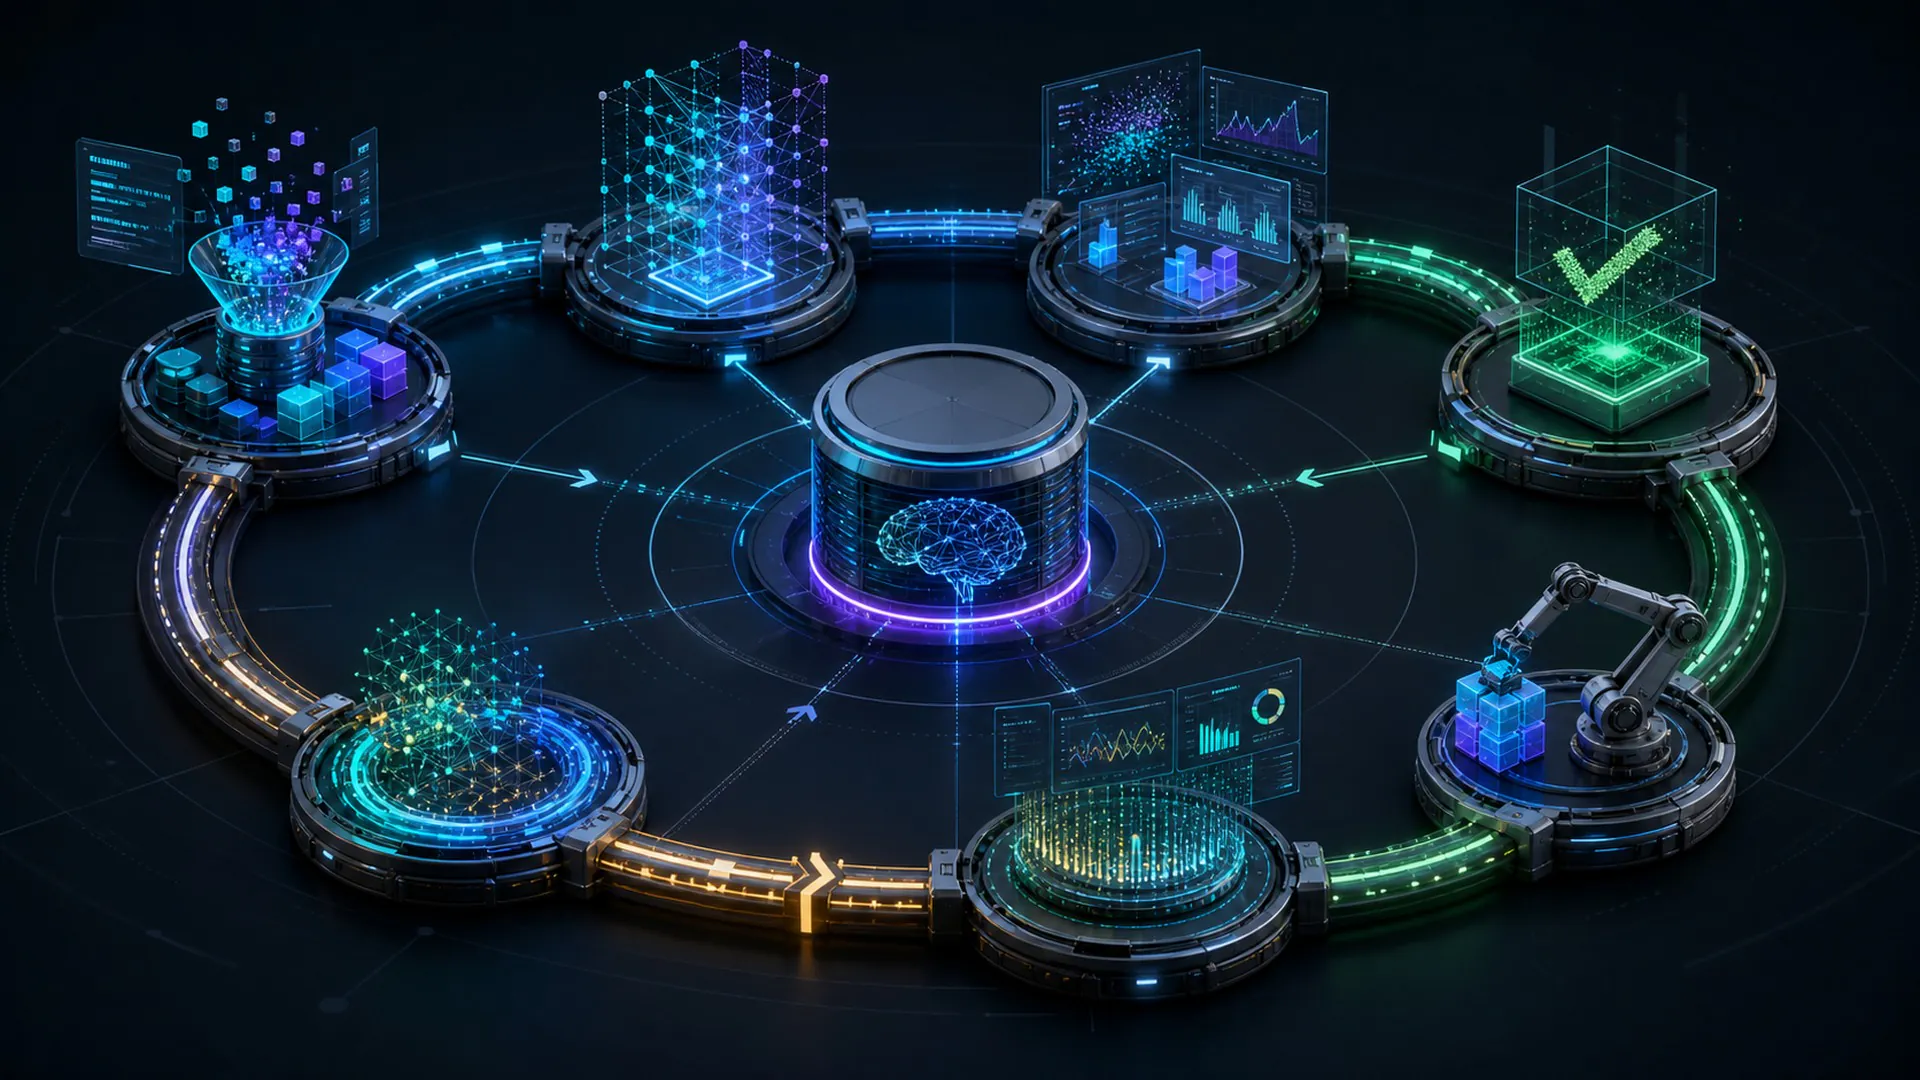
Процесс MLOps преобразует входные данные в результат через пять последовательных операций. Представленная схема служит компактной причинно-следственной картой: она не означает, что абсолютно каждая реализация обязана содержать строго пять изолированных программных модулей (некоторые системы объединяют этапы или циклически их повторяют). Однако эта карта заставляет фиксировать владельца, вход, выход и тест для любого изменения информации или полномочий.
1. Версионирование данных, кода, окружения и моделей: входы и предпосылки
На данном этапе система обязана строго версионировать исходные данные, программный код, рабочие окружения и получившиеся модели. Практический вопрос заключается не в том, происходит ли сохранение версий в принципе, а в том, какую именно информацию система потребляет, какое состояние меняет и какие доказательства подтверждают корректность изменений.
Переход на этот этап начинается с формулирования целевой задачи и должен завершаться результатом, готовым для передачи в автоматизированные конвейеры обучения. При этом необходимо фиксировать уровень неопределенности, отклоненные альтернативные решения, расход вычислительных ресурсов и любые формы контроля (программные или человеческие). Такой след позволяет вовремя обнаружить риски до того, как некачественная модель попадает в продакшен.
2. Автоматизация пайплайнов обучения и валидации: представление и решения
Здесь происходит автоматическая сборка и проверка моделей. Оценивается не только факт запуска скрипта, но и то, как трансформируются данные и насколько убедительно пройдены тесты производительности и безопасности.
Этап принимает версионированные артефакты с первого шага и должен выдавать результаты, пригодные для официальной регистрации. Подробная фиксация метрик и логирование ресурсов помогают убедиться, что автоматизация не ускорит отгрузку некорректных алгоритмов в рабочую среду.
3. Регистрация утвержденных артефактов и родословной (Lineage): ключевая трансформация
На этой стадии происходит фиксация одобренных моделей и их полной «родословной» (lineage) — связей между версиями данных, кода и итоговыми весами. Это ключевое отличие MLOps от классической разработки ПО.
Наличие реестра позволяет гарантировать аудит и воспроизводимость. Выходом этапа становится подготовленный к безопасной передаче артефакт, готовый к поэтапному развертыванию.
4. Развертывание со ступенчатым релизом и откатом: границы ограничений и проверки
Процесс вывода модели в продакшен обязан использовать механизмы поэтапного релиза (например, канареечные деплои или shadow mode) и автоматический откат (rollback) при обнаружении отклонений.
Этап забирает проверенные артефакты из реестра и передает их в контур обслуживания, формируя защитный барьер перед конечным пользователем или бизнес-системой.
5. Мониторинг сервиса, данных и поведения модели: выходы, обратная связь и правила остановки
После деплоя критически важно отслеживать не только стандартные системные метрики (задержка, CPU/GPU, ошибки API), но и дрифт (сдвиг) данных, а также изменение поведения самой модели.
Результаты мониторинга образуют петлю обратной связи: они либо подтверждают штатную работу, либо запускают правило остановки (stop rule), откат или процедуру переобучения.
Читать эту карту MLOps можно в двух направлениях: прямое прохождение (вперед) помогает спроектировать продакшен-систему, а обратный анализ (назад) используется для локализации аварий. Обратный разбор начинается с некорректного, медленного или дорогостоящего ответа модели и отслеживает, на каком из ранних этапов допущен сбой. Часто оказывается, что решающая ошибка возникла еще до того, как модель сгенерировала свой первый результат.
Практический пример применения MLOps
Рассмотрим систему прогнозирования спроса. В рамках MLOps-архитектуры она может автоматически переобучаться каждый месяц, проходить автоматические проверки качества данных и точности, развертываться в виде канареечного релиза (canary) на небольшую долю трафика и автоматически откатываться к предыдущей версии при обнаружении дрифта распределения целевых показателей.
Этот пример нагляден, так как позволяет связать MLOps с наблюдаемыми входами, промежуточными состояниями и четким результатом, а не с красивыми презентациями. Серьезное тестирование такой системы требует создания обычных, сложных и намеренно искаженных сценариев, сохранения базового ориентира (baseline) без использования MLOps и оценки как средней точности, так и тяжести редких критических ошибок.
Если изменить хотя бы одну предпосылку — например, убрать обязательный входной контроль данных, ограничить доступные вычислительные мощности или изменить поведение пользователей — надежная система MLOps должна либо корректно адаптироваться, либо отказаться от выдачи неуверенного прогноза. Механизм, демонстрирующий успех только в идеально созданных лабораторных условиях, нельзя считать готовым к эксплуатации.
MLOps и его главный срез: отличие от стандартного DevOps
Подмена понятия MLOps обычным DevOps-пайплайном для REST API без учета жизненного цикла данных и моделей — это главная методологическая ошибка. Такое упрощение уничтожает рамки концепции. В итоге команды сравнивают несравнимые продукты, исследователи преувеличивают успехи экспериментов, а инженеры начинают мониторить бессмысленные метрики.
- Полноценный MLOps: Покрывает трансформацию данных, обучение, реестр моделей и контроль за сдвигом распределения. Дает воспроизводимый и проверяемый результат.
- DevOps-сокращение (API only): Пропускает специфичные для ML границы контроля. В результате автоматизация лишь быстрее поставляет некачественные данные или испорченные модели пользователям.
Разделять их стоит и по единице анализа. Если в научной статье MLOps может сводиться к отдельной модели или алгоритму, то реальный сервис включает в себя модули извлечения информации (retrieval), маршрутизацию, кэширование, правила безопасности, авторизацию, пользовательские интерфейсы и комплексный мониторинг. Два инструмента могут иметь идентичные заголовки в документации, но решать совершенно разные задачи в этом стеке.
Почему MLOps критически важен в современных ИИ-системах
Сегодня ИИ-системам передают все больший контекст, мультимодальные входы, больше вычислительных ресурсов во время исполнения (runtime compute), расширенный доступ к внешним инструментам и интеграцию с ключевыми бизнес-процессами. В таких условиях технические детали, которые раньше казались мелочами из лабораторий, начинают напрямую влиять на задержку (latency), безопасность, доступность, затраты на инфраструктуру и юридическую ответственность.
Главная метрика эффективности MLOps — это не единичный впечатляющий результат на демонстрации, а устойчивое улучшение целевого показателя в репрезентативных условиях по сравнению с более простым базовым решением. При отчетах важно показывать распределения, категории ошибок, задержки в крайних процентилях (tail latency) и динамику по отдельным группам пользователей, а не усреднять все показатели в одну цифру.
Методология должна строиться на основе структуры данных и цены ошибки. Я рекомендую квантифицировать неопределенность, анализировать отдельные срезы данных, жестко фиксировать финальные тестовые выборки и убеждаться, что прирост точности на этапе обучения сохраняется после вывода системы в эфир.
Преимущества, которые дает MLOps
Основная причина внедрения MLOps — прямое устранение узких мест разработки и эксплуатации. В зависимости от задачи, выгода проявляется в различных аспектах:
- Более точная привязка ответов к фактам (grounding) и адекватное представление данных;
- Повышение обобщающей способности моделей;
- Снижение задержек отклика и уменьшение объема пересылаемой памяти;
- Прозрачная ответственность и четкие границы перед выполнением критических действий.
Цели MLOps должны выражаться в конкретных метриках и решениях. Формулировка «сделать модель умнее» не является критерием приемки. Практический целевой ориентир может звучать так: «снизить уровень ошибок на сложных кейсах до X%», «обеспечить восстановление работы при противоречивых данных», «удержать стоимость запроса на 95-м процентиле трафика» или «сократить время ручной проверки оператором».
Главный режим сбоя, определяющий MLOps
Центральное ограничение MLOps заключается в следующем: без жестких критериев приемки автоматизация начинает лишь быстрее доставлять плохие данные или неисправные модели в продакшен. Этот риск — не просто пункт в отчете после завершения проекта, а фактор, который должен определяющим образом влиять на сбор данных, архитектуру, права доступа и мониторинг с самого первого дня.
Контроль в MLOps эффективен только тогда, когда он срабатывает до наступления необратимых или costly-последствий. Необходимо определить ранние симптомы сбоя, задать пороговые значения, назначить ответственных и заранее протестировать сценарии восстановления. В зависимости от контекста, восстановление может означать:
- Отказ системы от выдачи ответа (abstain);
- Переключение на более простую классическую систему (fallback);
- Запрос дополнительных данных или эскалацию задачи на человека-оператора;
- Автоматический откат версии модели или полную остановку выполнения действия.
План оценки MLOps-системы
Процесс оценки MLOps следует начинать с формулировки решения, которое должны подтвердить данные. Четко опишите рабочую выборку пользователей, цену ошибки, информацию, доступную строго в момент принятия решения, и самую простую альтернативу (базовый уровень). Это предотвращает превращение бенчмарка в самоцель.
- Контрольные сравнения: Используйте изолированный тестовый набор данных, к которому не было доступа при обучении.
- Ступенчатое тестирование: Проверяйте MLOps в тестовом окружении — используйте shadow mode (теневой режим), канареечные релизы и лимиты запросов. Это показывает, как реальный трафик и обратная связь меняют поведение системы.
- Полный учет lineage: Версионируйте все компоненты: исходные данные, препроцессинг, токенизаторы, веса, конфиги, промпты, индексы базы знаний и код обслуживания. Без этого невозможно определить, чем вызван изменившийся результат.
- Принцип фальсифицируемости: Заранее сформулируйте, какой результат опровергнет гипотезу о пользе MLOps. Если ни один из исходов не способно отменить решение о внедрении, такая оценка является не инженерией, а маркетингом.
Вопросы, которые нужно задать перед внедрением MLOps
Перед принятием решения о развертывании MLOps-инфраструктуры ответьте на семь практических вопросов:
- Цель: Какое конкретное узкое место в процессах должна устранить MLOps?
- Механизм: На каком из 5 этапов карты происходит ключевое преобразование?
- Базовый уровень: Как решение сравнивается с более простыми альтернативами или обычным DevOps для API?
- Доказательства: Какие стандартные, сложные, стрессовые и узкоспециализированные сценарии были протестированы?
- Эксплуатация: Каковы реальные затраты на задержку, память, вычисления, энергию и ручную проверку при масштабировании?
- Риски: Как именно команда узнает, что автоматизация стала поставлять некорректные данные или модели?
- Восстановление: Способна ли система снизить полномочия, откатиться или передать управление человеку до нанесения ущерба?
Первоисточники для изучения MLOps
Для глубокого погружения в стандарты и инженерию MLOps я рекомендую обратиться к фундаментальным материалам:
- Руководство по выбору моделей scikit-learn (scikit-learn model selection guide);
- Правила машинного обучения от Google (Google Rules of ML);
- Управление рисками ИИ от NIST (NIST AI Risk Management Framework).
Изучать эти источники следует в сочетании с технической документацией на конкретные модели, используемое оборудование и требования законодательства вашего региона.
Главное, что стоит запомнить о MLOps
MLOps — это четко описанный инженерный и управленческий механизм в рамках крупной системы. Его реальная ценность заключается в улучшении конкретного бизнес-результата при явных условиях, а не в самом факте использования модного термина. Карты из пяти этапов делают информационные потоки прозрачными, сравнения помогают отсеять неработающие подходы, а точки контроля дают инженеру инструмент своевременного вмешательства.
Главное практическое правило MLOps: зафиксируйте цель, сравните решение с надежным базовым уровнем, протестируйте самые опасные сценарии отказов и сохраните все доказательства, необходимые для постоянного наблюдения за изменениями в продакшене.
Источник: www.unite.ai
