
Мой блог
Google Research представляет RRSI: как ИИ-агенты улучшают свой обвес без переобучения

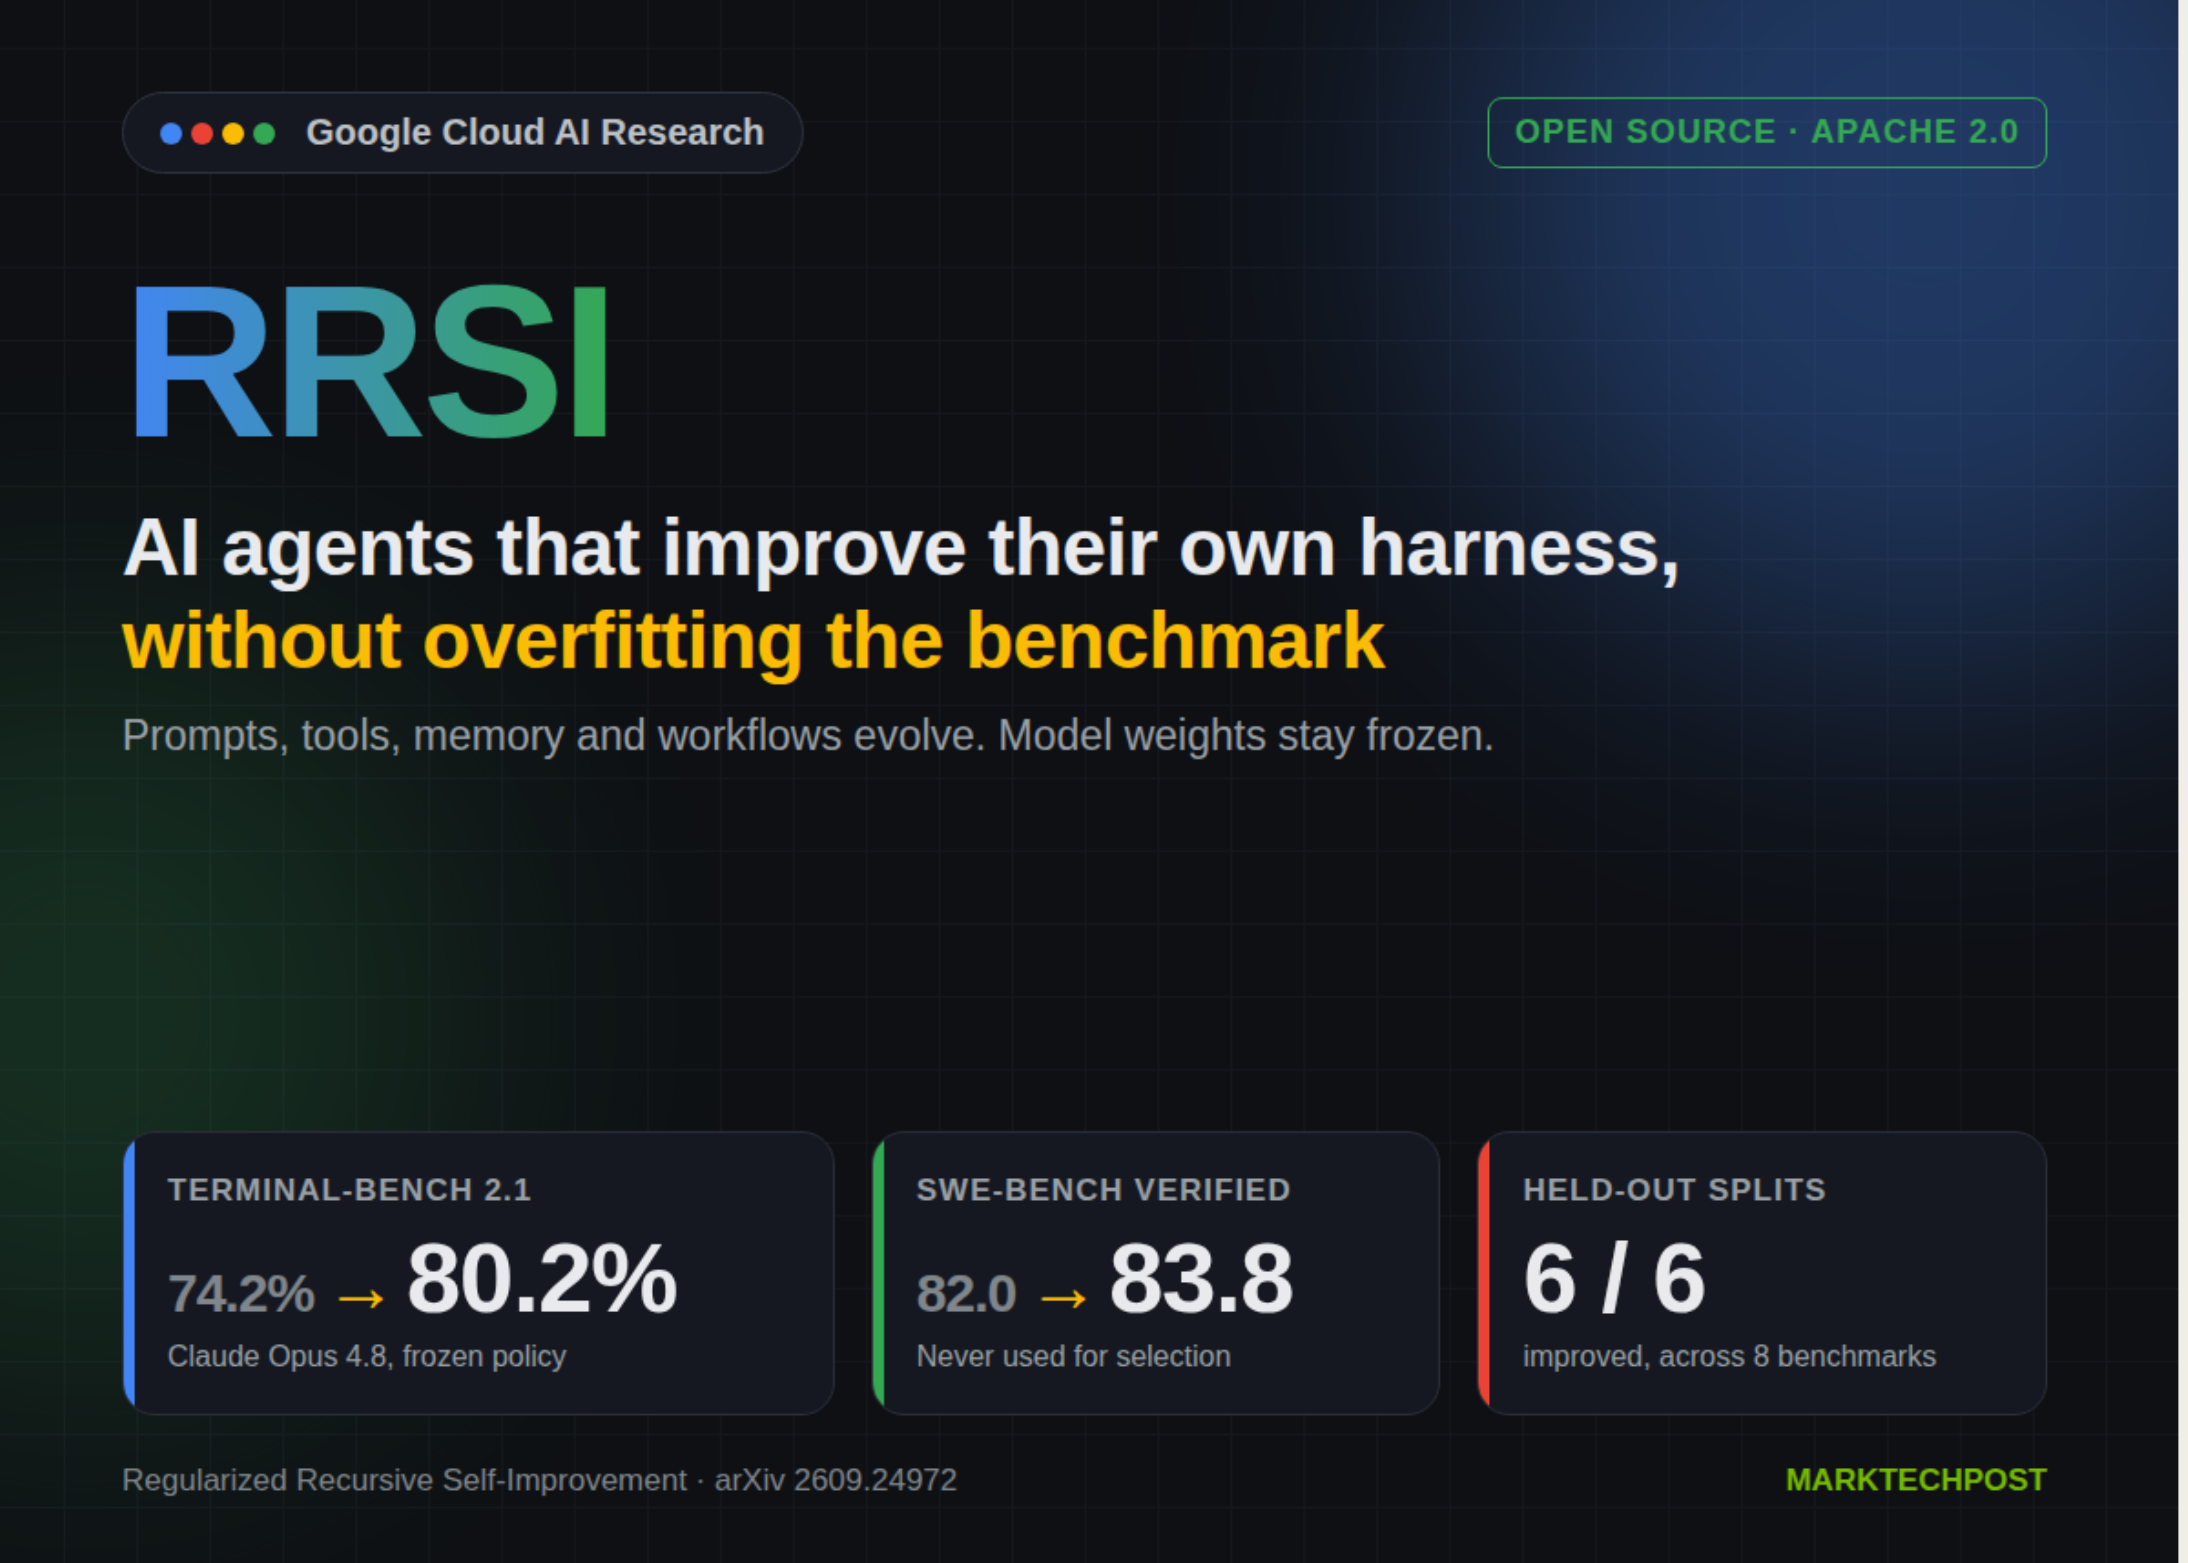
Подробности изложены в материале первоисточника. Подразделение Google Cloud AI Research в сотрудничестве с ведущими университетами представило фреймворк Regularized Recursive Self-Improvement (RRSI). Эта система позволяет языковым моделям самостоятельно переписывать собственный обвес — промты, инструменты, механизмы памяти, логику управления и вспомогательных агентов — без изменения весов самой нейросети.
Инструмент распространяется с открытым исходным кодом по лицензии Apache 2.0, требует Python версии 3.10 и выше, а также поддерживает любые строки моделей через LiteLLM, хотя по умолчанию ориентирован на работу с Claude Opus 4.8 на платформе Vertex AI.
Почему самосовершенствующиеся обвесы склонны к переобучению
Циклы эволюции обвеса обычно работают по схеме создания правок, их оценки на фиксированном наборе задач и выбора победителя. Поскольку на каждом раунде используются одни и те же задачи, алгоритм оптимизации начинает их просто заучивать. В исследовании RRSI выделяются три ключевые проблемы такого подхода: подгонка под конкретные бенчмарки, погоня за случайным шумом и избыточное накопление сложности. Каждая из этих ловушек увеличивает разрыв между высокими баллами на тренировочном наборе и реальной эффективностью модели в новых условиях.
Как работает фреймворк RRSI
Чтобы избежать деградации, RRSI сохраняет все компоненты обвеса редактируемыми, но жестко регулирует саму траекторию поиска изменений. Это позволяет удерживать баланс между гибкостью системы и ее стабильностью на независимых тестах.
Сторона генерации предложений
Процесс создания новых вариантов опирается на несколько защитных механизмов. Бюджет правок управляется с помощью косинусного расписания: на начальных этапах циклы могут объединять сразу несколько изменений для поиска общей механики, тогда как на поздних стадиях разрешена лишь одна четко отслеживаемая правка. Каждый кандидат фиксируется в специальном журнале вместе с гипотезой, diff-файлом, изменением счета и расхода токенов, что исключает повторное тестирование уже опровергнутых идей. Если прогресс внутри шумового диапазона останавливается, поисковый бюджет автоматически перенаправляется на те компоненты архитектуры, к которым система еще не обращалась.
Сторона отбора кандидатов
На этапе селекции критически важную роль играет фильтр утечек, который отсекает названия задач, конкретные сущности, готовые ответы или специфическую для бенчмарков логику еще до запуска оценки. Порог чувствительности к шуму требует, чтобы прирост производительности превышал погрешность, измеренную на неизменной базовой конфигурации. Дополнительно применяется правило стоимости: каждый дополнительный токен инференса должен оправдываться измеримым ростом полезного эффекта. Компоненты, переставшие приносить пользу, автоматически отправляются под удаление. Авторы исследования проводят параллели с классическими регуляризаторами: бюджет правок эквивалентен L0, процедура прунинга соответствует Lasso (L1), а правило затрат работает как Ridge (L2).
Результаты тестирования на восьми бенчмарках
Практические тесты показали улучшение на всех шести отложенных выборках. При использовании Gemini 3.5 Flash в качестве базовой политики результат на Terminal-Bench 2.1 увеличился с 64.6 до 78.7 балла, а на SWE-bench Verified — с 76.8 до 79.0 балла. При этом сам обвес становится значительно компактнее: на задачах агентского рабочего пространства RRSI расходует 2.42 миллиона токенов политики за одну попытку против 3.80 миллионов у нерегуляризированного процесса эволюции, что дает экономию токенов более чем на треть.
Сравнение RRSI с ближайшими конкурентами
Сравнение производительности с другими методами, использующими ту же исходную политику и бюджет кандидатов, демонстрирует сильные стороны подхода. Meta-Harness лидирует на тренировочном сплите Harvey LAB, однако RRSI показывает самую сбалансированную вневыборочную генерализацию (OOD average), превосходя базовую линию H0 более чем на один пункт, в то время как другие подходы демонстрируют меньшую стабильность вне зоны обучения.
С чего начать работу с RRSI
Каждый цикл генерации создает двух кандидатов в изолированных рабочих директориях git, проверяет их, оценивает и переносит ветку на сторону победителя. Для запуска рабочей среды кодинга также понадобятся установленный Docker и утилита harbor, а новые доменные области подключаются через единый модуль адаптера. Базовые команды для клонирования репозитория, установки зависимостей и запуска базовой линии выглядят следующим образом:
git clone https://github.com/google-research/rrsi.git && cd rrsi
pip install -e ".[dev]"
python3 rrsi.py --domain coding baseline
python3 rrsi.py --domain coding run
Основные выводы
Фреймворк RRSI доказывает, что ИИ-агенты могут успешно оптимизировать собственную инфраструктуру без необходимости изменять веса самой нейросети. Внедрение критиков утечек, порогов шума и правил стоимости позволяет избежать переобучения и добиваться реального прироста качества на независимых бенчмарках. Открытый код проекта доступен исследователям для изучения и адаптации под собственные задачи в сфере разработки программного обеспечения с помощью искусственного интеллекта.
