
Мой блог
Julia 1: компактная открытая нейросеть для принятия решений на CPU

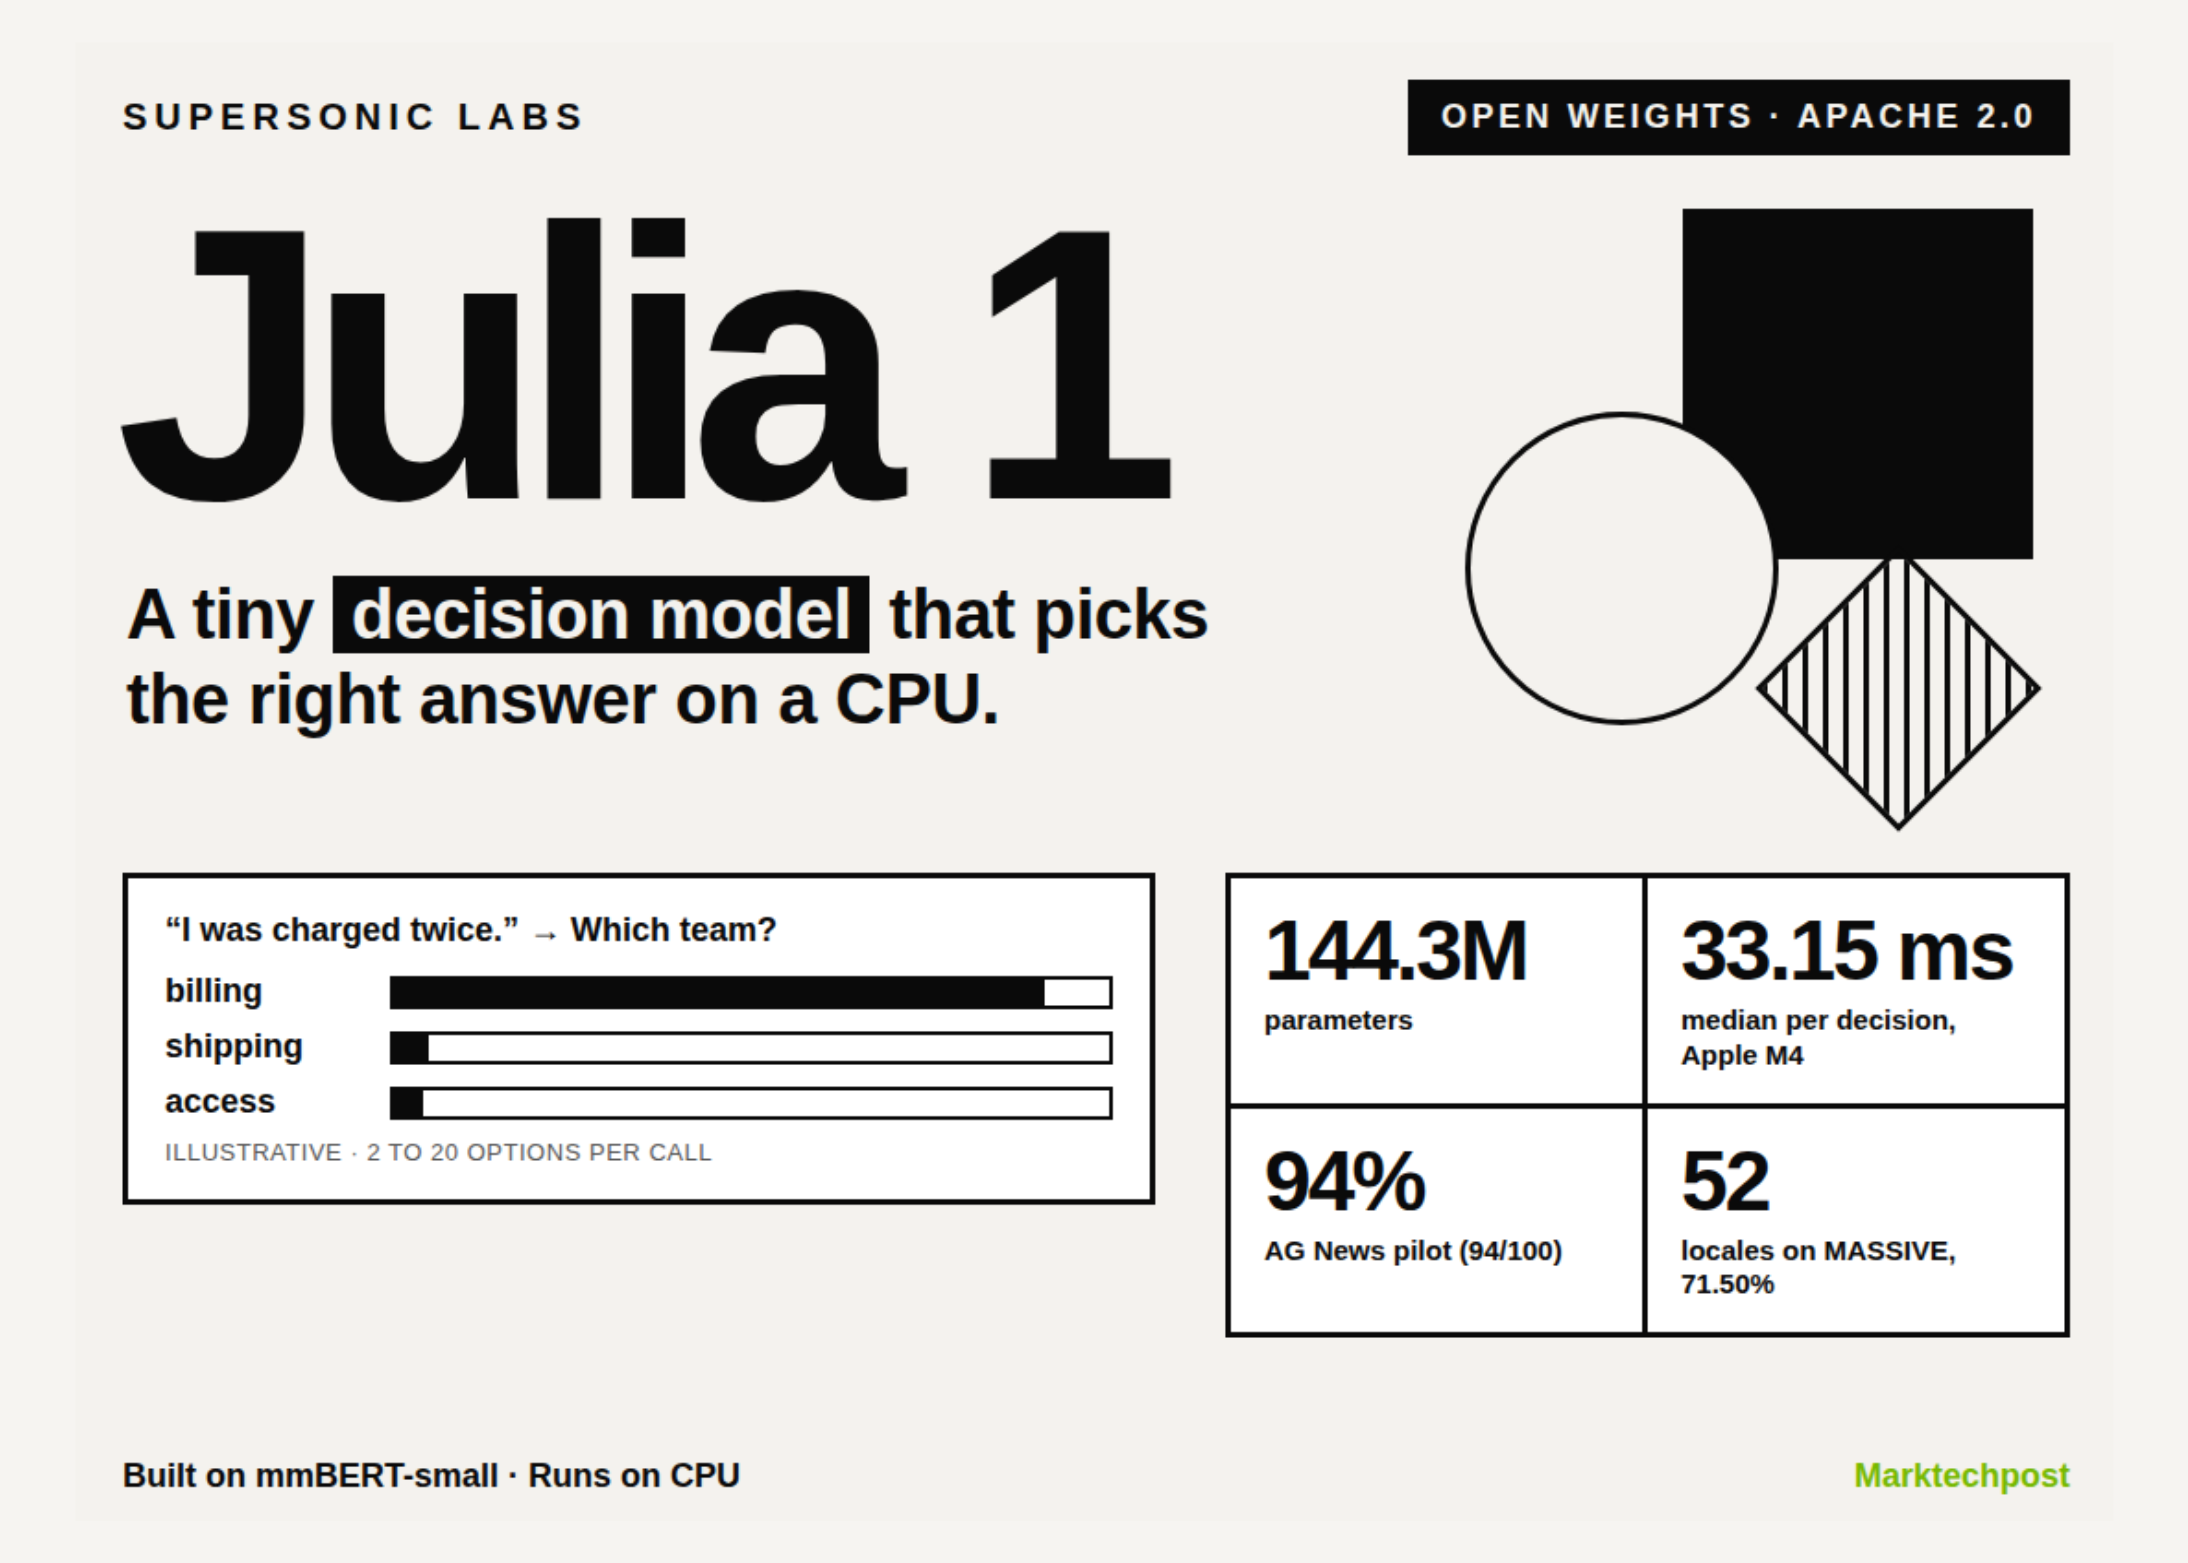
Бразильская исследовательская лаборатория Supersonic Labs представила Julia 1 — специализированную модель для классификации и логического выбора с параметрами 144.3M. Новинка работает на обычных центральных процессорах и не является текстовым чат-ботом.
Я подготовил подробный разбор архитектуры, возможностей и результатов тестирования этой интересной разработки, которая способна выполнять рутинные задачи маршрутизации и анализа быстрее громоздких языковых моделей.
представила Julia 1
Что делает модель Julia 1
В отличие от классических генеративных нейросетей, эта система решает конкретные аналитические задачи через единый программный интерфейс. Пользователь передает контекст, исходный вопрос и список возможных вариантов ответа числом от 2 до 20, после чего алгоритм выбирает наиболее подходящий вариант и возвращает вероятности для каждой опции в формате softmax.
Интерфейс поддерживает три основные категории задач:
- Выбор (choice) — определение одной метки из предложенного списка вариантов для классификации или роутинга.
- Оценка (score) — расчет ожидаемого индекса по упорядоченной шкале, например, для градации «низкий, средний, высокий».
- Бинарная проверка (yes/no) — вычисление вероятности истинности утверждения.
Все результаты возвращаются в исходном порядке следования вариантов. При этом модель не генерирует новый текст и корректно сохраняет служебные идентификаторы вызывающего кода.
Архитектура и бюджет на обучение
В основе разработки лежит многоязычный энкодер mmBERT-small от лаборатории JHU CLSP, содержащий 140 миллионов параметров и обученный на тысячах языков. Инженеры сохранили базовый энкодер и токенайзер, добавили специализированную голову для принятия решений и провели дообучение на профильных примерах. В официальных материалах подчеркивается, что это не очередной файнтюн модели Qwen.
Суммарные затраты облачных ресурсов на эксперименты и обучение составили всего около 540 бразильских реалов (примерно 104 доллара США). Веса модели в формате FP32 занимают 550.5 МБ. Поддерживаемая длина контекста достигает 8192 токенов, хотя в бенчмарках использовался лимит в 1024 токена. В настоящее время создатели уже ведут разработку второй версии с собственной базовой архитектурой.
Результаты бенчмарков и точность
Сравнительные тесты проводились на оборудовании H200 BF16 с жестким кодированием. В качестве отправной точки для сравнения применялись значения из официального протокола конкурирующего решения Jev от TypeSafe. Тестирование охватило несколько стандартных датасетов:
- Typed Decisions: 73.15% правильных ответов против 72.70% у базового аналога.
- AG News (4 категории): 94% успешных срабатываний против 91%.
- DAIR Emotion (6 категорий): 86% против 48% у референса.
- MASSIVE (18 сценариев): макроточность 71.50% по выборке из 52 локалей.
Единственным слабым местом оказался датасет Banking77, содержащий 72 метки: здесь модель показала лишь 64% против 87% у конкурента. Дополнительные процессорные тесты на следующий день полностью подтвердили стабильность основных показателей на локальном «железе».
Скорость работы на различных устройствах
Разработчики опубликовали замеры производительности на потребительском «железе». На процессоре Apple M4 обработка одного запроса занимала в медиане 33.15 миллисекунды. Планшет Samsung под управлением ONNX Runtime показал результат в 203 мс при пиковом потреблении памяти около 393 МБ.
На ноутбуке с процессором Intel Core i5 классификация текстов AG News заняла 107.83 мс. Более сложная задача с сортировкой 72 меток Banking77 потребовала уже более трех секунд, так как системе предварительно требуется сузить круг возможных вариантов. Представители компании заявляют о пятикратном превосходстве в скорости над аналогами на аналогичных процессорах, хотя эксперты рекомендуют относиться к таким цифрам сдержанно из-за разницы в условиях тестирования удаленных сервисов.
Ограничения и особенности применения
Важно понимать, что система производит отбор исключительно из предоставленных пользователем вариантов. Ее нельзя использовать для поиска отсутствующих фактов, сложных математических вычислений или многошаговой логики. Кроме того, модуль предварительной маршрутизации может ошибочно отсечь правильную метку на этапе сужения списка.
Создатели рекомендуют обязательно тестировать модель на собственных задачах и сохранять человека в контуре принятия критически важных решений. Веса находятся в открытом доступе на Hugging Face под лицензией Apache 2.0, а в будущем планируется запуск полноценного облачного API по цене 0.025 доллара за миллион токенов.
