
Мой блог
Meta FAIR представила RPM: как ранжировать ML-эксперименты до траты GPU-часов

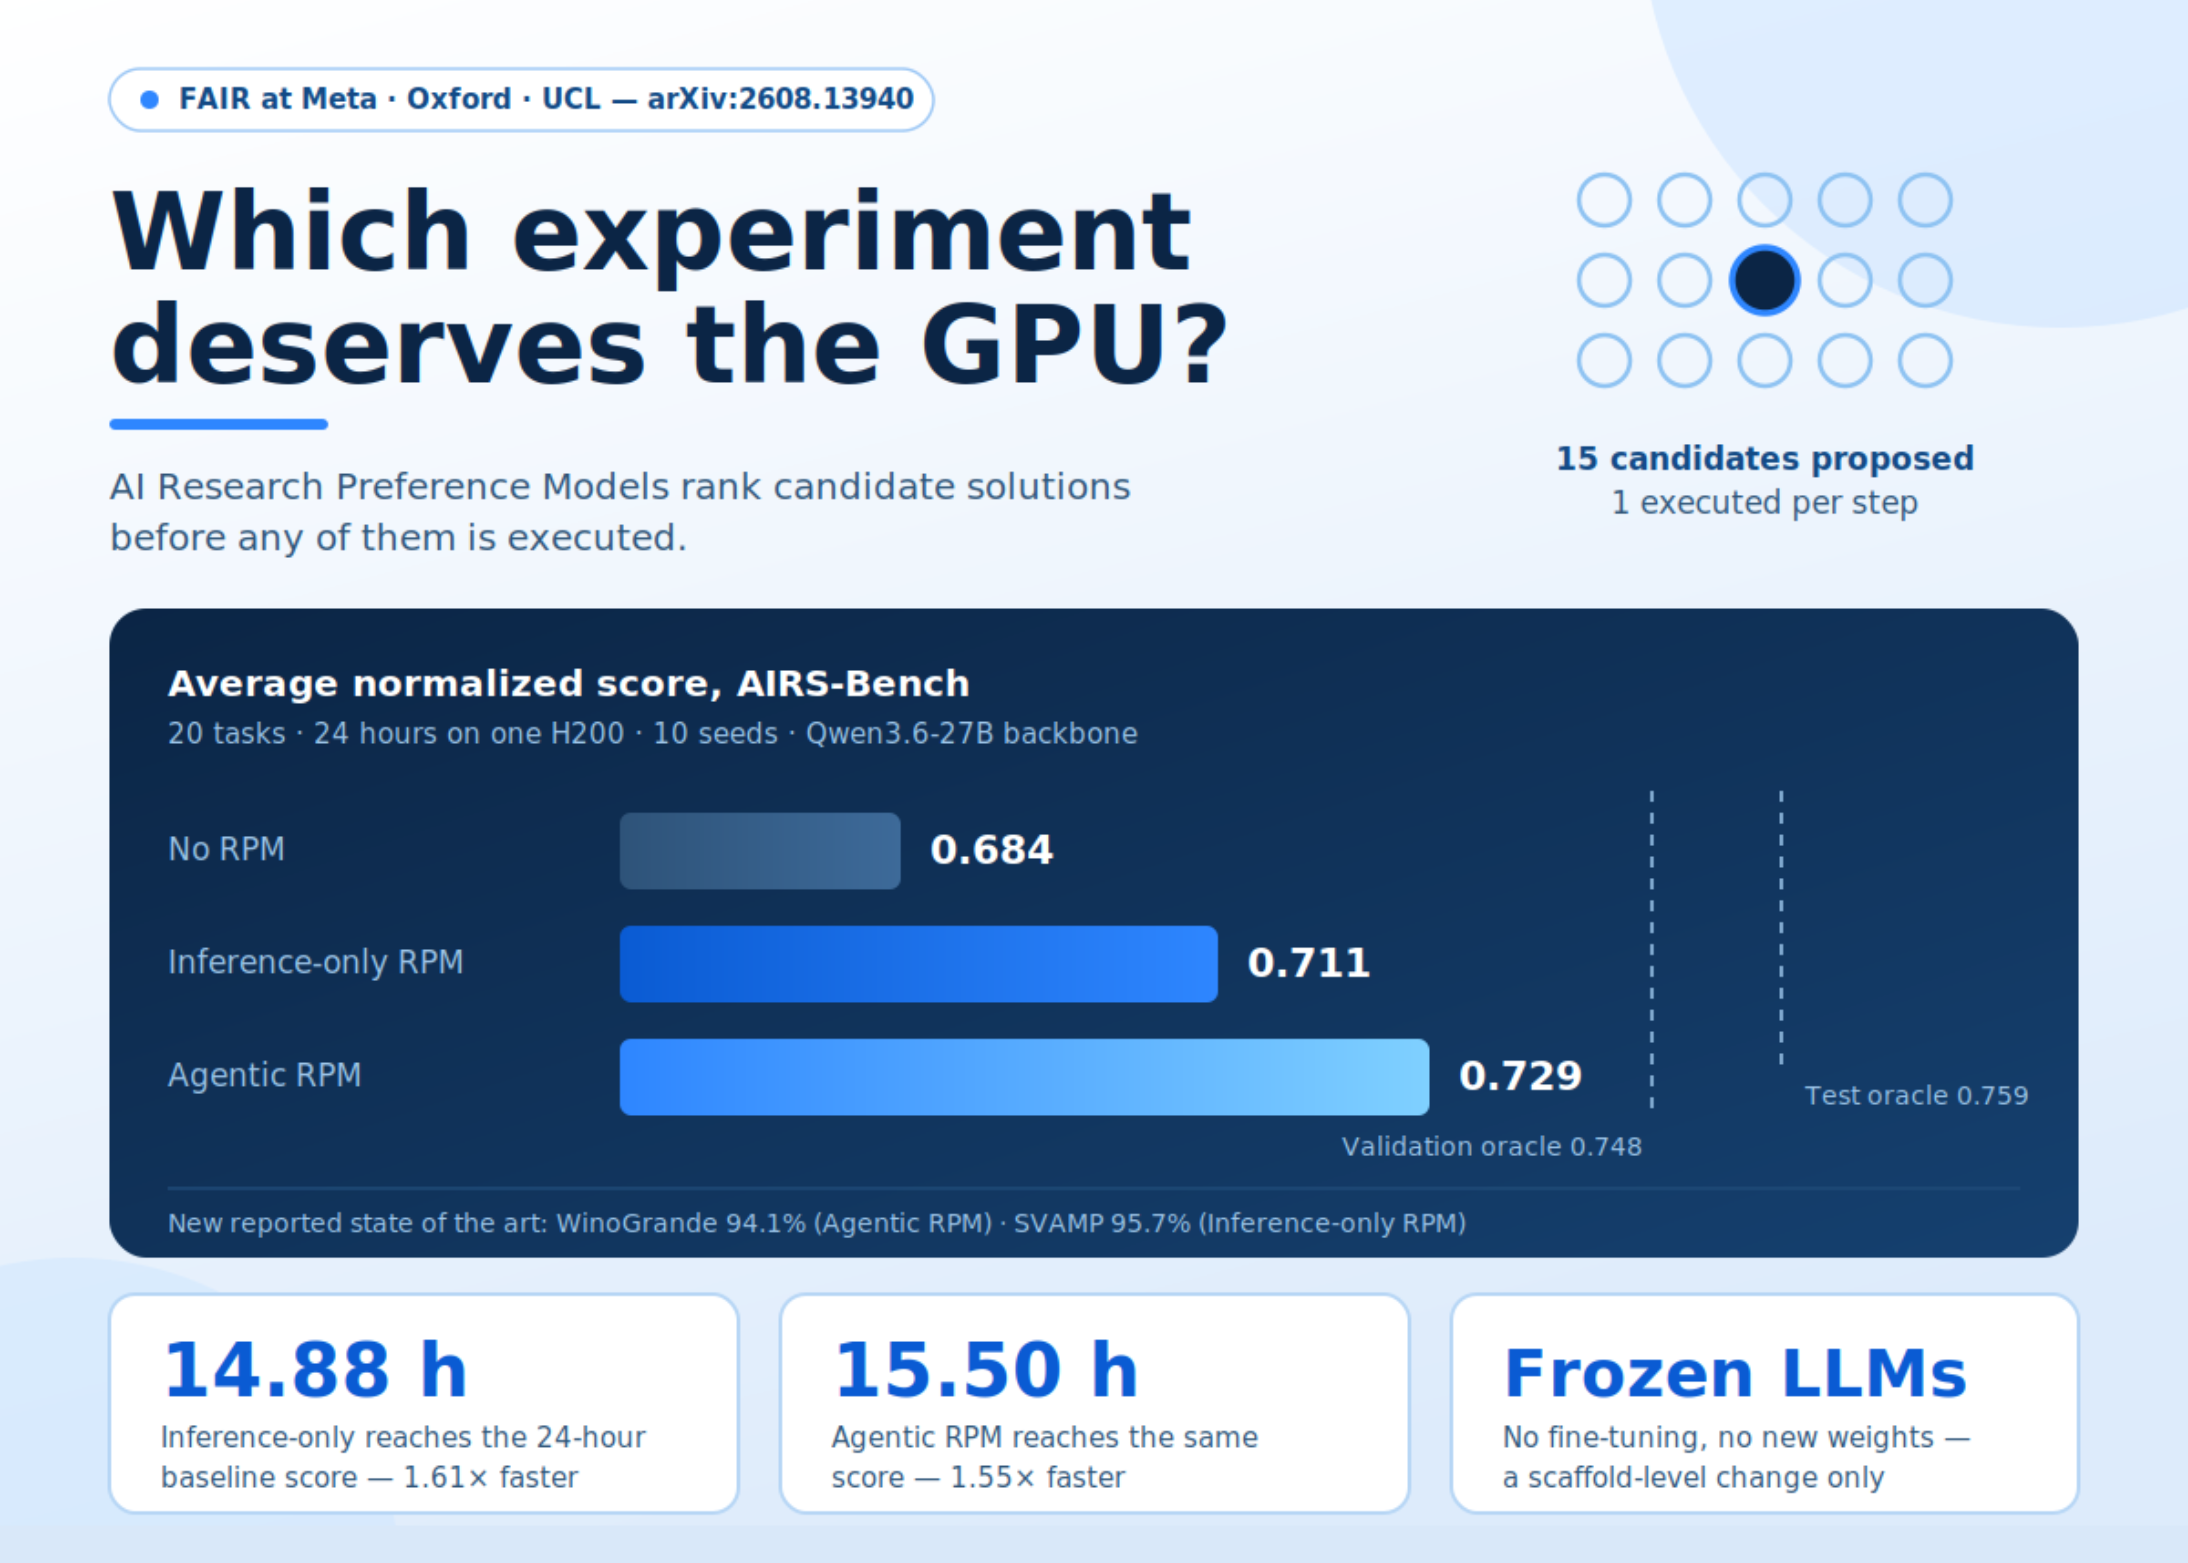
Автономные ИИ-агенты сегодня вполне способны самостоятельно выдвигать исследовательские гипотезы, писать программный код и фиксировать результаты экспериментов в машинном обучении. Однако в этой цепочке быстро всплывает главное узкое место: генерация идей стоит недорого, а вот их валидация обходится очень ценными ресурсами. Обучение даже одной тестовой модели может отнять от нескольких часов до нескольких дней работы мощных графических ускорителей. В итоге агент предлагает значительно больше гипотез, чем инженер или лаборатория может позволить себе запустить на практике. Именно выбор правильных кандидатов на исполнение становится определяющим фактором исследовательского прогресса.
Исследовательская группа из лаборатории FAIR компании Meta совместно с учеными из Оксфордского университета и Университетского колледжа Лондона (UCL) формализовала этот этап через концепцию исследовательских предпочтений и презентовала модели AI Research Preference Models (RPMs). Система RPM ранжирует еще не выполненные гипотезы и отбирает наиболее перспективную для запуска. Исследователи подчеркивают: модель не пытается прогнозировать точный итоговый балл, так как современные языковые нейросети пока работают крайне нестабильно при попытке предсказать конкретные метрики или точный результат выполнения кода.
Инструмент уже готов к практическому использованию. Модели RPM функционируют на основе замороженных предобученных LLM без проведения дополнительного дообучения (fine-tuning). Фреймворк AIRA-dojo и бенчмарк AIRS-Bench полностью выложены в открытый доступ, а базовой языковой моделью выступает открытая Qwen3.6-27B.
Где RPM располагается в цикле ИИ-агента
В основе управляющей платформы AIRA-dojo лежит эволюционный поиск по дереву (evolutionary tree search). Он включает жадный выбор родительских узлов и три базовых оператора: Черновик (Draft), Улучшение (Improve) и Отладка (Debug). По завершении цикла система выдает узел с наибольшей оценкой на валидационной выборке.
Модель RPM подключается строго на этапе создания дочерних узлов. Вместо стандартного подхода, когда агент создает один вариант и сразу отправляет его на исполнение, система применяет оператор 15 раз параллельно, получая 15 невыполненных гипотез-кандидатов. Затем RPM проводит между ними турнир на выбывание с парным сравнением (knockout tournament). На физические GPU отправляется исключительно победитель турнира. Каждое сравнение опирается на контекстные узлы, собранные алгоритмом поиска в ширину (BFS) по ранее пройденному дереву исследований с учетом полученных валидационных оценок.
Две архитектуры RPM: Inference-only и Agentic
Разработчики создали две конфигурации моделей отбора, предназначенные под разный вычислительный бюджет:
- Inference-only RPM (Оценка на уровне инференса): В этом режиме LLM выступает в роли экспертного судьи (LLM-as-a-judge), который анализирует планируемый эксперимент, исходный код и историю поиска. Промпт системы оптимизировался с помощью инструмента MIPROv2 из библиотеки DSPy. В результате сформировался регламент оценки, аналогичный подходу главного исследователя (Principal Investigator): модель закрывает глаза на легко исправимые синтаксические ошибки, поощряет потенциал к масштабированию и жестко штрафует за дублирование уже пройденных тупиковых ветвей. Офлайн-точность ранжирования составляет от 57.7% до 59.0%.
- Agentic RPM (Агентная оценка с песочницей): Здесь используется тот же алгоритм-судья, но с добавлением изолированной песочницы, полностью повторяющей рабочее окружение агента (включая один ускоритель Nvidia H200). Судье доступны инструменты python, bash и submit_solution. Модель прогоняет короткие пилотные тесты, после чего модуль обратной связи либо предлагает следующий микро-эксперимент, либо завершает процедуру отбора.
В агентном варианте исследователи применили два важных архитектурных решения. Во-первых, остаточный временной бюджет в промпте специально завышают (модели транслируют 2700 секунд вместо реальных 300 секунд), чтобы агент не останавливал работу раньше времени. Во-вторых, число пилотных запусков ограничено 30 попытками с жестким лимитом в 60 секунд на каждую. Поскольку пилотные тесты расходуют общее время исследования, агентный селектор включается только на шагах Draft и Improve, тогда как на шаге Debug система возвращается к случайному выбору.
Результаты тестирования на AIRS-Bench
Оценку эффективности проводили на бенчмарке AIRS-Bench, состоящем из 20 публичных задач по обработке текста и табличных данных. На каждую задачу выделялось 24 часа работы одного GPU Nvidia H200 на 10 случайных зернах (seeds). В качестве основы для операторов и для самой RPM применялась модель Qwen3.6-27B. Это позволило подтвердить, что итоговый прирост обеспечивается именно алгоритмом отбора, а не за счет более мощного базового движка.
| Метод отбора кандидатов | Средний нормированный балл |
|---|---|
| Без RPM (случайный выбор) | 0.684 |
| Inference-only RPM | 0.711 |
| Agentic RPM | 0.729 |
| Валидационный оракул (теоретический предел) | 0.748 |
| Тестовый оракул (абсолютный максимум) | 0.759 |
Вероятность получить улучшение по сравнению с базовым подходом No-RPM составила 0.5923 для Inference-only и 0.5913 для Agentic RPM (с нижней границей 95% доверительного интервала выше 0.50).
Однако самым ценным практическим результатом стала экономия времени и вычислений. Вариант Inference-only достигает итогового 24-часового показателя базового метода (0.684) всего за 14.88 часа (ускорение в 1.61 раза). Агентная версия Agentic RPM справляется с этой задачей за 15.50 часа (ускорение в 1.55 раза). Даже с учетом дополнительных временных затрат на локальный инференс модели-судьи (+0.66 часа на прогон), скорректированный результат за 23.34 часа достигает 0.708.
В ходе тестов исследователи также зафиксировали два новых рекордных результата (SOTA):
- WinoGrande: 94.1% с использованием Agentic RPM (прошлый рекорд для ИИ-агентов составлял 90.4% у AIRA₂).
- SVAMP: 95.7% с использованием Inference-only RPM (прошлый рекорд, установленный человеком, равнялся 94.2%).
Ключевые выводы
Внедрение Research Preference Models наглядно показывает: рациональное распределение GPU-ресурсов при автоматическом поиске гипотез дает гораздо больший эффект, чем простое наращивание мощности моделей. Фильтрация неудачных решений до их отправки на обучение сокращает затраты времени более чем на треть и позволяет автономным агентам быстрее выходить на рекордные показатели accuracy в сложных ML-задачах.
Источник: www.marktechpost.com
