
Мой блог
Perplexity представила Photon: движок поиска на Rust с задержкой 65 мс

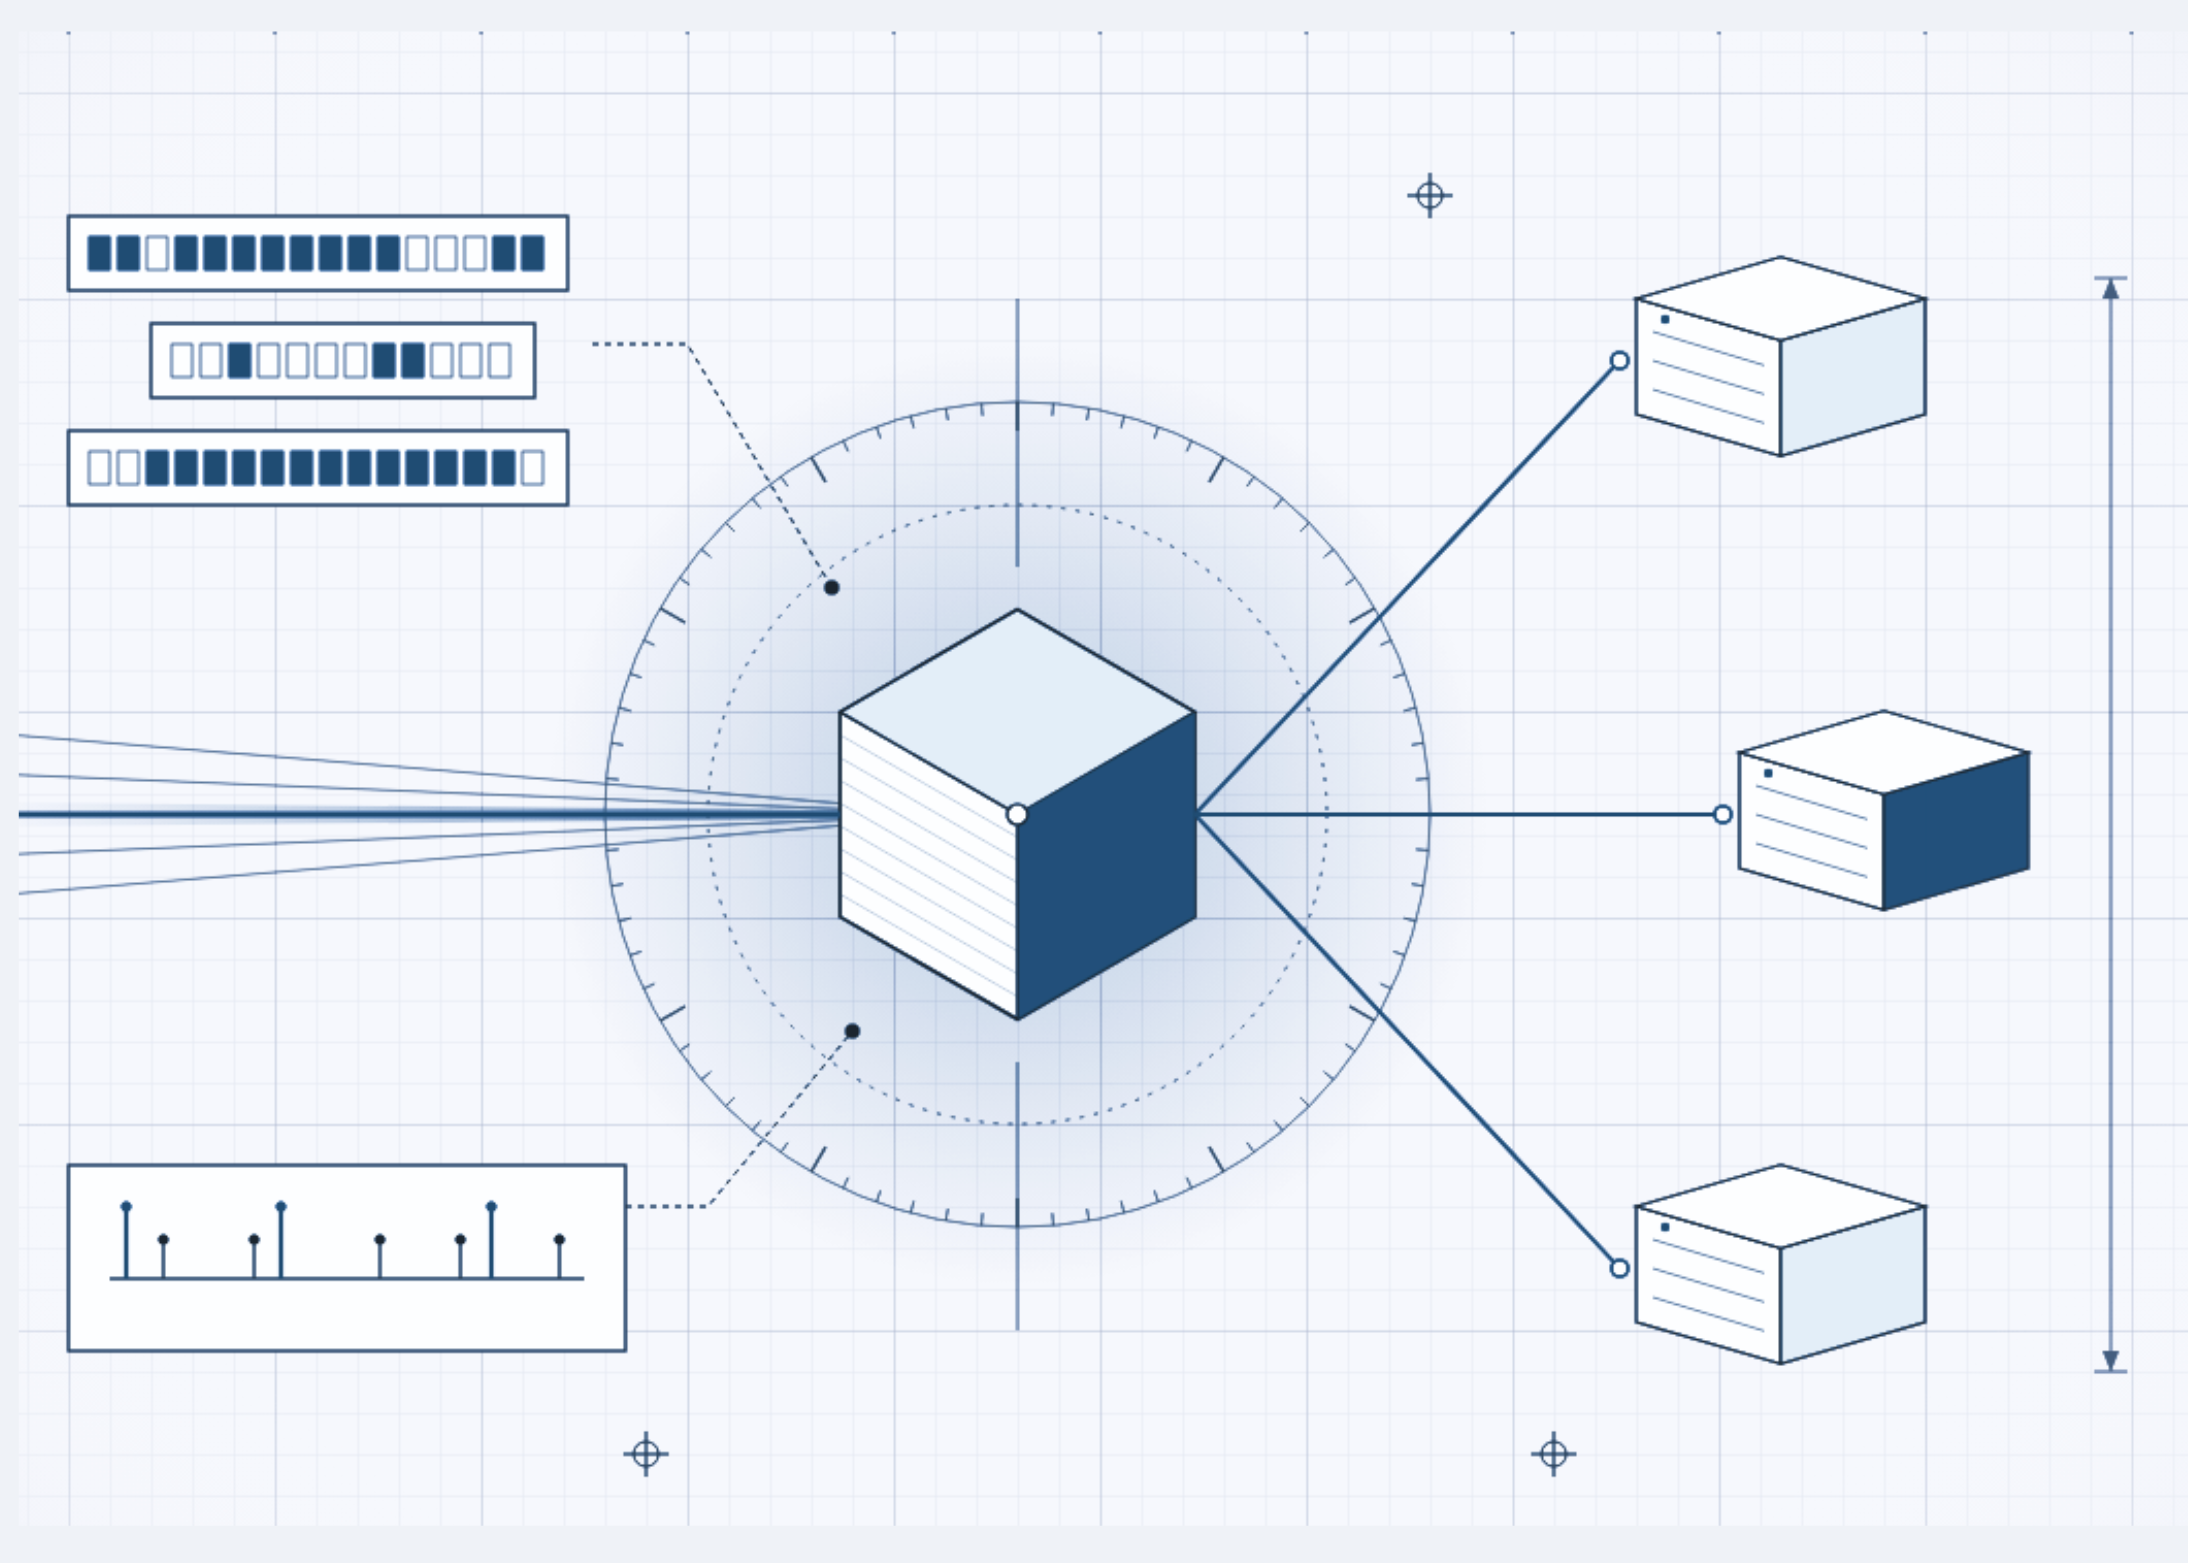
Компания Perplexity объявила о выпуске собственного поискового и ранжирующего движка Photon на Rust, который полностью заменил прежнее стороннее решение с открытым исходным кодом. Новый инструмент обрабатывает весь производственный трафик и лежит в основе режима Fast Search в поисковом API компании.
Поисковый стек теперь демонстрирует задержку на уровне 160 мс для p50 и 230 мс для p95, а показатель p99 снизился с прежних 800 мс до 65 мс. Разработчики позиционируют систему как специализированный инструмент для масштабируемых и ресурсоемких задач.
Почему Perplexity заменила старый движок
По мере расширения индекса предыдущая система уперлась в три серьезных аппаратных ограничения. Во-первых, задержка в хвосте распределения (p99) держалась в районе 800 мс, а объем данных превышал доступный объем оперативной памяти, из-за чего флаг mlock оказался бесполезен. Холодные чтения провоцировали критические сбои страниц памяти, существенно тормозя запросы.
Во-вторых, в моменты слияния дисковых индексов показатель p99 вырастал до 1,2 секунды на 10–15 минут. В-третьих, развертывание и синхронизация вспомогательного кластера занимали больше недели, что увеличивало долю частичных ответов. В итоге команда пришла к выводу, что создание движка с нуля обойдется дешевле и проще, чем поддержка старого форка.
Как устроен Photon
Архитектура распределяет запросы через балансировщик нагрузки на брокеры Photon, которые передают задачи группе шардов и отслеживают тайм-ауты. Каждый шард выполняет поиск, первичное и вторичное ранжирование, после чего брокер объединяет кандидатов и подтягивает ключевые поля документов. Такой подход позволил полностью переосмыслить обработку больших массивов данных.
Адаптивные списки публикаций и бюджетированный обход
Короткие списки размещаются инлайн в пределах одной страницы, а длинные делятся на блоки фиксированных диапазонов идентификаторов документов. Разреженные блоки используют отсортированные массивы смещений и быстрый поиск скачками, тогда как плотные задействуют битовые карты для мгновенной проверки вхождения по одному биту.
Алгоритм обхода делит списки на управляющие и проверочные. Дешевые проверки присутствия сначала ограничивают максимальный балл кандидата, а точные частотные термины считываются только тогда, когда кандидат преодолевает установленный порог.
Записи Docblob и пакетные асинхронные чтения
Каждый документ получает компактную запись частот, масок полей и позиций. Благодаря кодированию Elias-Fano для терминов, система декодирует только совпавшие элементы, требуя всего одно обращение для ранжирования кандидата.
Смещения известны заранее, поэтому дисковые чтения уходят пакетами через интерфейс io_uring. Кэш предварительно проверяет весь пакет, потоки обходятся без блокировок, а вытеснение реализовано через алгоритм CLOCK вместо общего списка LRU.
Раздельная сборка и обслуживание
Сборщики создают шардированные индексы на основе таблиц YTsaurus на специализированных узлах. Контроллер поочередно переключает группы обслуживания и предварительно прогревает кэш запросами из логов поиска, благодаря чему построение полного веб-индекса занимает всего несколько часов.
Результаты внедрения в производство
Технические показатели системы продемонстрировали кратный прирост эффективности. Задержка извлечения и ранжирования p99 сократилась с 800 мс до 65 мс исключительно для этапов работы самого движка.
При этом Photon расходует примерно на 20% меньше серверных машин, чем прежние узлы, и хранит примерно в 2,5 раза больше данных на один документ, что позволило улучшить качество ранжирования. Для закрепления сопоставимого объема данных через mlock потребовалось бы около 4,61 объема оперативной памяти.
Fast Search: скорость и стоимость для ИИ-агентов
Режим Fast Search объединяет Photon с облегченным ранжированием под агентские рабочие процессы. Тестирование на шести бенчмарках (включая WideSearch, BrowseComp, DSQA, FRAMES, SEAL-0 и SEAL-Hard) показало точность 64,3% при затратах 59,73 доллара на 3554 задачи.
Стандартный пресет набирал 64,0%, но стоил 187,60 доллара, то есть новинка оказалась дешевле примерно на 68%. Обратной стороной стало снижение релевантности (DCG) с 2.45 до 2.21 и уменьшение доступности ответов на 2,9 процентных пункта, поэтому для сложных запросов рекомендуется использовать стандартный пресет.
Интеграция через API
Для активации режима в POST-запросе к конечной точке /search передается параметр search_type: "fast" при стоимости 1 доллар за 1000 запросов. Использование SDK Python версий 0.43.4 и 0.43.5 требует передачи аргумента extra_body={"search_type": "fast"} в соответствии с документацией.
Fast Search и ближайшие конкуренты
Рыночные аналоги предлагают схожие по скорости решения, однако методологии тестирования у разных поставщиков отличаются. Решения вроде Exa Instant, Parallel Search Turbo и Tavily ultra-fast работают в аналогичных диапазонах задержек, но имеют собственные ценовые модели и ограничения по глубине выдачи или поддержке языков.
Главные итоги
Появление Photon закрепило переход инфраструктуры Perplexity на собственный технологический стек на базе Rust. Движок сократил задержку p99 до 65 мс и снизил стоимость агентских вычислений на 68% при сохранении высокой производительности.
