
Мой блог
Sarvam AI выпустила Saaras V4: распознавание речи для 22 языков Индии и глобального английского

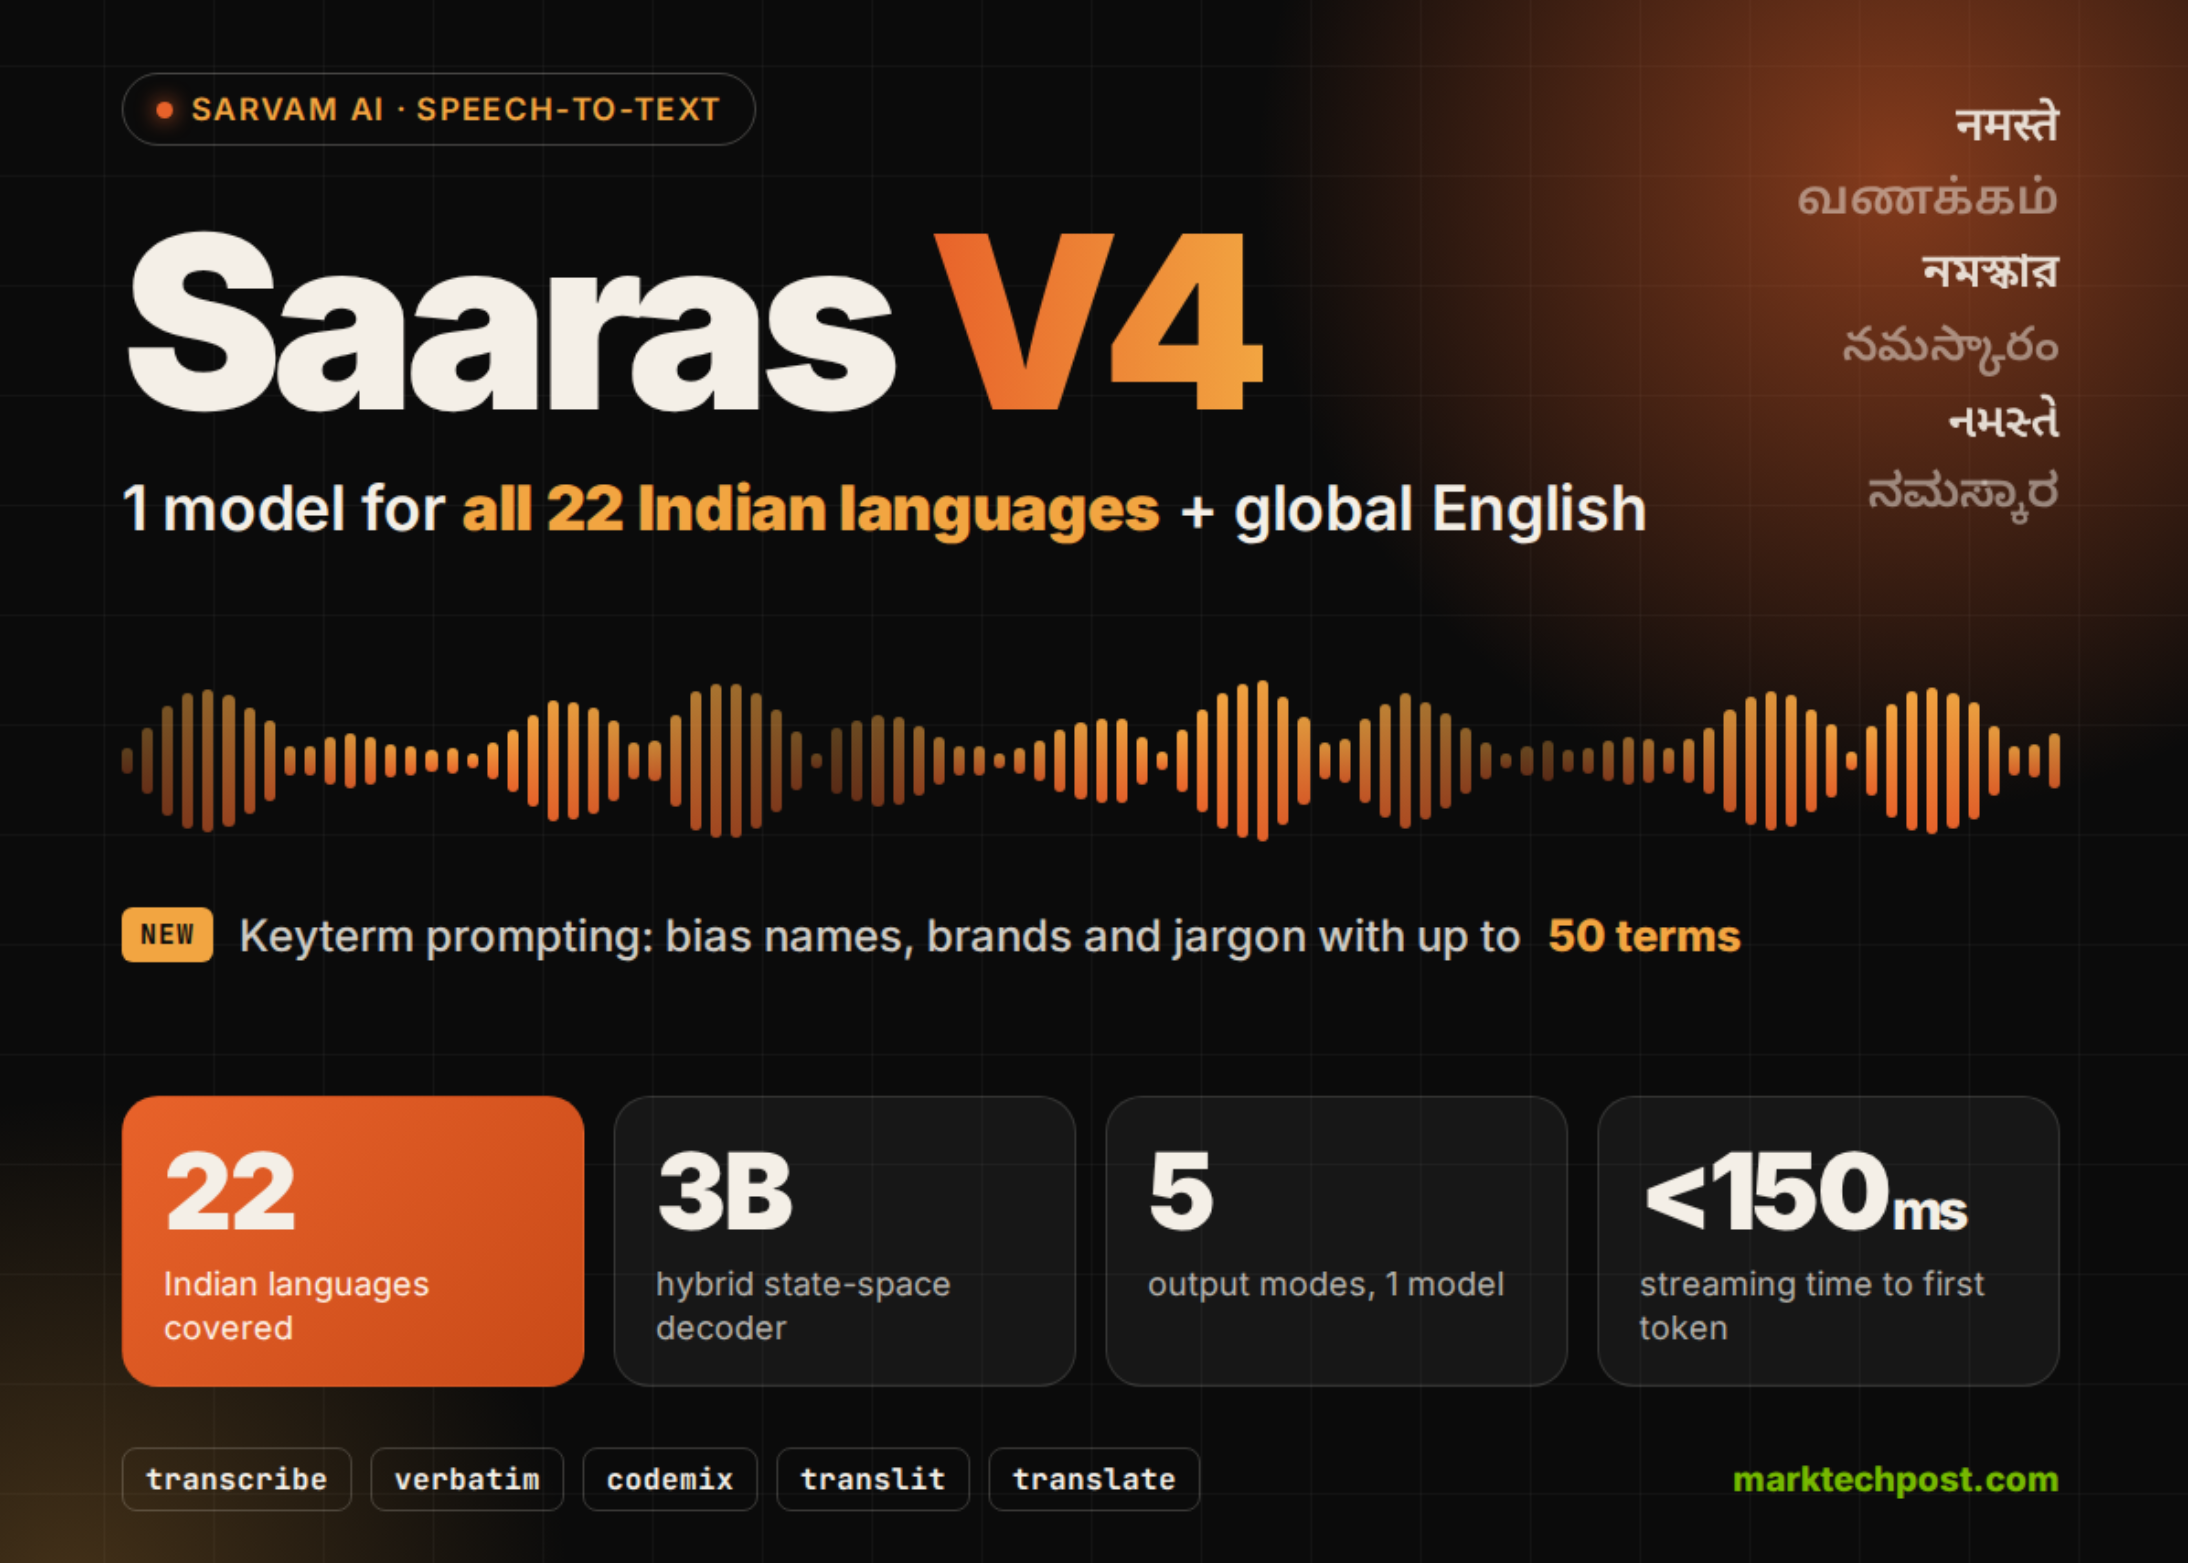
Компания Sarvam AI представила Saaras V4 — новую версию своей продвинутой системы распознавания речи. Модель охватывает все 22 официальных языка Индии, а также английский язык с учетом различных мировых акцентов, демонстрируя передовые показатели точности во всех заявленных категориях.
На текущий момент внедрить новинку можно через официальный облачный API Sarvam, используя идентификатор запроса model="saaras:v4". Веса модели пока не находятся в открытом доступе, а документация по самостоятельному развертыванию на Amazon SageMaker на данный момент описывает лишь предыдущую третью версию.
Архитектурные особенности Saaras V4
В основе архитектуры Saaras V4 лежит связка энкодера и декодера. Специальный аудиоэнкодер производит преобразование исходной звуковой волны в эмбеддинги, в которых содержатся детальные акустические и фонетические характеристики. Затем адаптер временного прореживания сокращает полученную последовательность и проецирует ее непосредственно в пространство эмбеддингов языковой модели. Подобное техническое решение позволяет без проблем обрабатывать длинные аудиозаписи, не выходя за рамки доступного контекстного бюджета декодера.
Роль декодера выполняет фирменная гибридная языковая модель с пространством состояний Sarvam-3B, насчитывающая 3 миллиарда параметров и созданная разработчиками с нуля. Она считывает выделенные аудиопризнаки в комбинации с текстовым промптом, после чего авторегрессивно генерирует итоговую транскрипцию, возвращая каждый новый токен в качестве входящего элемента для последующего шага.
Результаты бенчмарков и тестирования
Для оценки качества работы с английским языком разработчики задействовали семь различных датасетов. Шесть из них заимствованы из открытого бенчмарка Open ASR на платформе Hugging Face: это AMI, GigaSpeech, чистая и зашумленная версии LibriSpeech, SPGISpeech и VoxPopuli. Седьмым набором стал корпус Svarah с индийским акцентом от AI4Bharat. Расчет оценок производился по стандартному коду нормализации лидерборда, где Saaras V4 показала наименьшую среднюю частоту ошибок в распознавании слов (WER) среди всех протестированных аналогов.
В отношении индийских языков тестирование проводилось на платформе Vistaar для десяти языков с использованием метрик WER и LLM-WER, причем последняя включает дополнительную семантическую проверку. Она позволяет исключить несущественные опечатки и варианты форматирования, характерные для индийской письменности, отделяя их от реальных смысловых ошибок. На зашумленных записях из набора Kathbath Noisy показатель ошибок Saaras V4 оказался более чем в два раза ниже по сравнению с результатами Deepgram Nova-3 и GPT-4o Transcribe. В тестах на определение языка (Language ID) на верифицированных речевых фрагментах IndicVoices ошибка составила 2,9% для топ-10 языков Индии и 5,22% для полного списка из 22 языков.
Важно подчеркнуть, что все приведенные выше числовые показатели опубликованы самим разработчиком. Независимых результатов стороннего воспроизведения тестов на момент релиза представлено не было.
Пять режимов вывода из одной модели
Пользователи могут получить до пяти различных текстовых представлений одной и той же аудиозаписи, переключая параметр mode в запросе:
- transcribe (по умолчанию): нативный алфавит с нормализованными датами и числами;
- verbatim: дословная расшифровка каждого произнесенного слова с сохранением слов-паразитов и чисел в текстовом виде;
- codemix: нативная письменность с сохранением английских лексем на английском языке;
- translit: полная транслитерация речевого потока латинскими символами;
- translate: перевод содержимого на английский язык с нормализацией числительных.
Подобный подход позволяет выполнять все необходимые операции внутри самой нейросети, избегая громоздких этапов пост-обработки, которые часто приводят к накоплению ошибок.
Промптинг ключевых терминов
Новой функцией четвертой версии стала работа с ключевыми терминами (Keyterm Prompting), функционирующая исключительно в связке с моделью saaras:v4. Пользователь может передать JSON-список в параметре keyterms, включив туда до 50 терминов длиной до 64 символов каждый. Переданные ключевые слова смещают вероятность распознавания в нужную сторону, хотя и не гарантируют их обязательное появление в тексте. Например, при упоминании брендов вроде PhonePe рекомендуется использовать режим codemix, чтобы название гарантированно оставалось записанным латиницей.
В бенчмарке IndicContextEval модель Saaras V4 зафиксировала показатель в 16.03% WER при тестировании в условиях ключевого промптинга уровня L5. Создатели заявляют, что это лучший результат на данном испытании.
Потоковая передача, длинные аудио и тарифы
Модель поддерживает потоковую передачу через WebSocket с промежуточными результатами и временем до первого токена (TTFT) менее 150 миллисекунд. Синхронная транскрипция коротких клипов длительностью до 30 секунд доступна через REST API, а асинхронная пакетная обработка файлов объемом до двух часов на один файл поддерживает опциональную диаризацию спикеров. Для разработчиков подготовлены SDK для Python и Node.js, а также готовые интеграции с LiveKit Agents, Pipecat и Vercel AI SDK.
Стоимость использования сервиса составляет 30 рупий за час для потокового и пакетного режимов в реальном времени, а расширенная тарификация с функцией разделения спикеров обойдется в 45 рупий за час. Поскольку Saaras V3 оставалась базовой моделью по умолчанию, переход на новую четвертую версию требует изменения всего одной строки в коде благодаря идентичной структуре запросов.
Сравнение Saaras V4 с ближайшими конкурентами
Специалисты Sarvam сопоставили свое решение с тремя альтернативными платформами, опираясь на официальные данные и прайс-листы вендоров по состоянию на сентябрь 2026 года. В перечень вошли системы Deepgram Nova-3, ElevenLabs Scribe v2 и OpenAI GPT-4o Transcribe. Полноценная поддержка всех 22 официальных языков Индии реализована только в решении от Sarvam, в то время как конкуренты охватывают лишь часть региональных диалектов, предлагая при этом более широкое глобальное покрытие языков.
По возможностям ключевого промптинга Saaras V4 позволяет использовать до 50 терминов бесплатно в рамках базового запроса, тогда как у аналогов эта опция часто реализуется через платные дополнения. Скорость потоковой обработки по протоколу WebSocket у новинки находится на уровне менее 150 мс TTFT, что сопоставимо с лучшими рыночными показателями. При этом самостоятельное развертывание V4 пока недоступно, в отличие от решений конкурентов или предыдущей версии Saaras v3, развертываемой на SageMaker.
