Тэг
LLM

LLM-агент впервые синтезировал рентгеновское зеркало на реальной магнетронной установке
Практический эксперимент по управлению вакуумной магнетронной установкой с помощью автономного ИИ-агента. Рассказываю, как нейросеть синтезировала многослойное рентгеновское зеркало с точностью до половины ангстрема.
Читать далее
Разблокировка PCIe Gen2 x16 на NVIDIA CMP 90HX: от пайки конденсаторов до хака драйвера с помощью ИИ
Подробный гайд по аппаратной и программной модификации NVIDIA CMP 90HX: пайка конденсаторов для PCIe x16, разблокировка режима Gen2 через патч драйвера с ИИ-агентом и тесты скорости в LLM.
Читать далееНастройка Codex CLI через свой эндпоинт: разбор файла config.toml и 9 популярных ошибок
Подробное руководство по настройке конфигурационного файла config.toml для Codex CLI. Разбираем рабочий пример подключения собственного эндпоинта, девять распространенных сбоев и особенности расхода токенов.
Читать далееПолгода с ИИ в разработке софта: RAG, AI-ревью, автотесты, агенты и автоматизация счетов
Реальный опыт внедрения языковых моделей и нейросетевых инструментов в коммерческую разработку: от генерации планов проверок до автономной обработки документов и AI-агентов.
Читать далее
Agent-net представила Webagent: открытый Go-фреймворк для превращения сайтов в защищенных ИИ-агентов
Команда Agent-net представила открытый Go-фреймворк Webagent для развертывания бизнес-агентов с жесткой защитой на уровне кода и поддержкой MCP, Slack и WhatsApp.
Читать далееЧто скрывают внутренние модели OpenAI и как дистилляция помогает DeepSeek
Разбираем, как устроена дистилляция знаний в нейросетях, почему внутренние модели OpenAI выигрывают математические олимпиады и как DeepSeek учился на API Claude.
Читать далее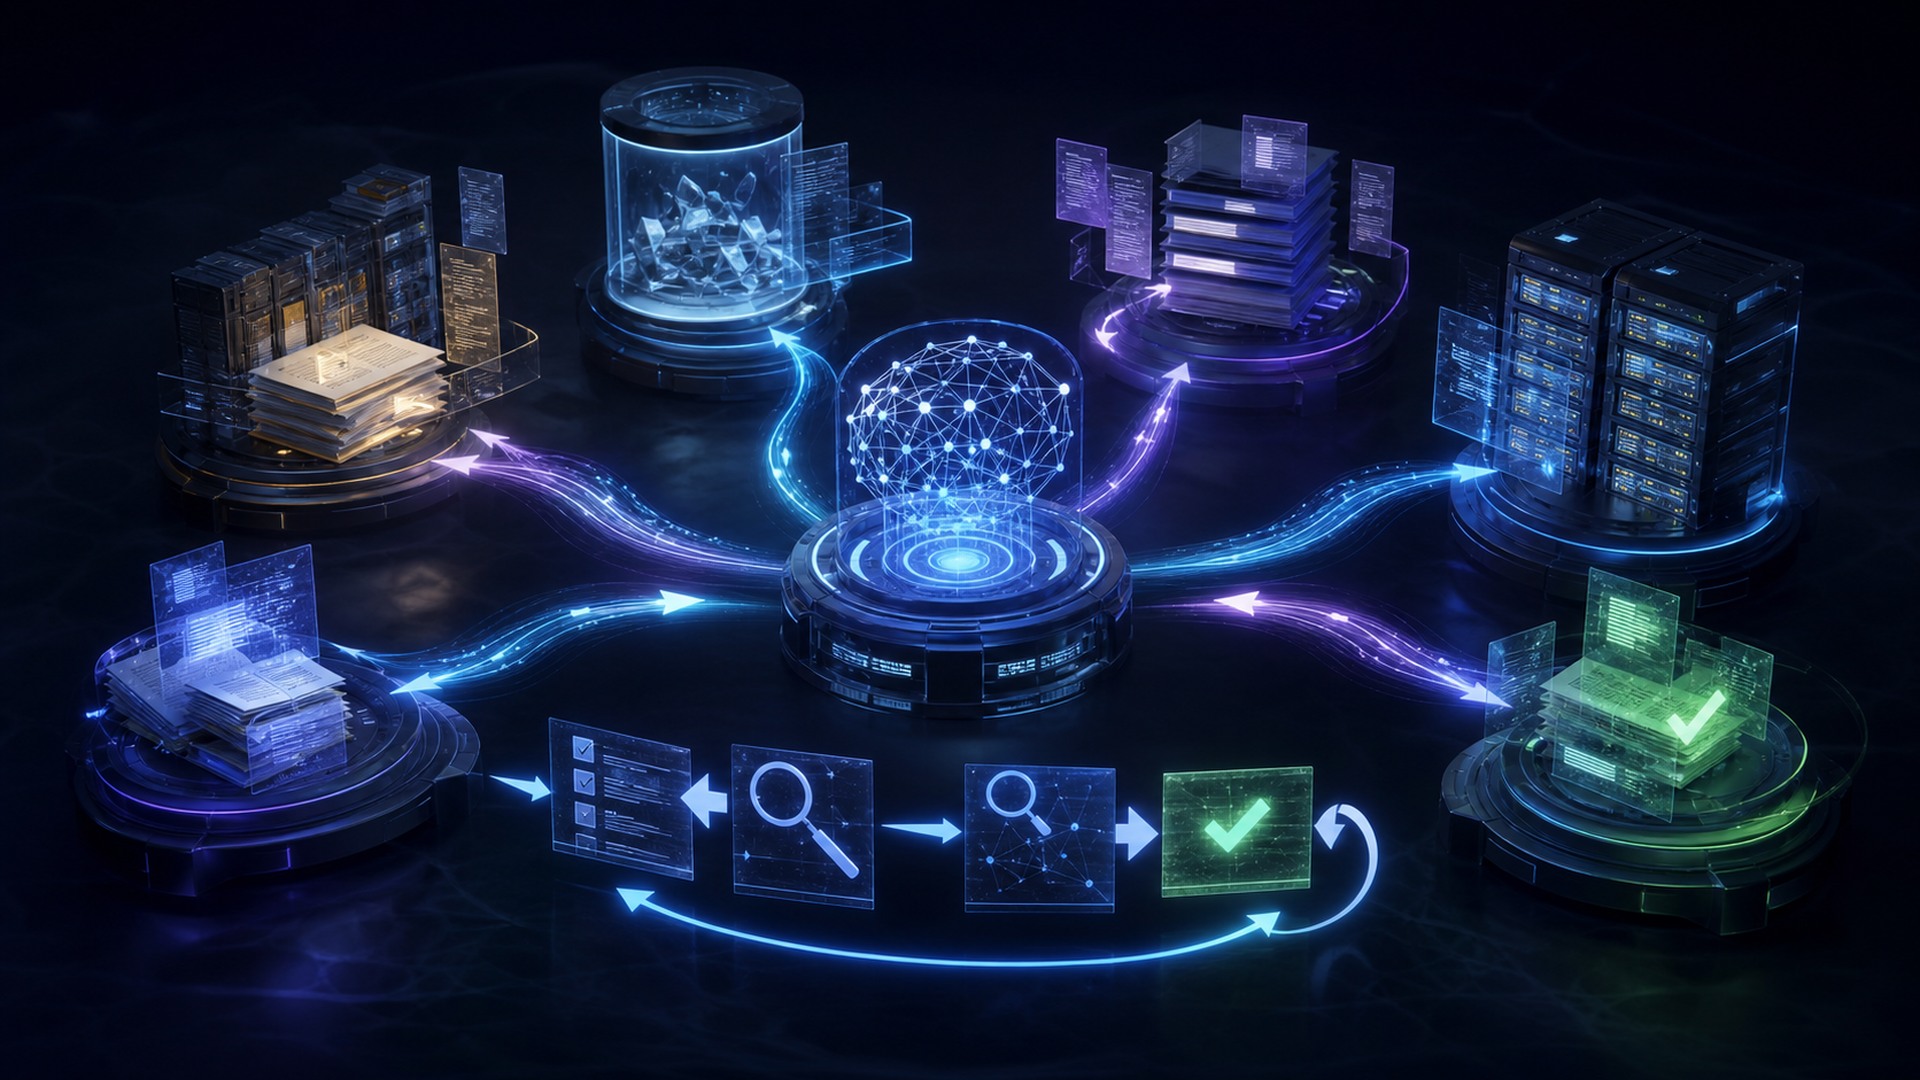
Что такое Agentic RAG: когда ИИ сам планирует и регулирует поиск информации
Подробный разбор концепции Agentic RAG: как нейросети автономно планируют поиск, проверяют факты и корректируют запросы. Разбираем 5 этапов работы, риски и методы оценки.
Читать далее
Асинхронный GRPO с LoRA на Hugging Face Jobs: настройка vLLM, прокси и Storage Buckets
Разбор архитектуры асинхронного обучения с подкреплением (AsyncGRPO) с использованием LoRA-адаптеров в библиотеке TRL v1.14. Показываем, как организовать взаимодействие узлов без межсерверного NCCL через Hugging Face Storage Buckets и умный прокси-маршрутизатор, ускоряющий процесс обучения почти в 4 раза.
Читать далее
Как устроена обвязка (harness) AI-агентов: опыт Yandex по созданию исследовательского движка «Исследовать»
Разбор архитектуры и обвязки (harness) исследовательского агента Алисы AI: от отказа от CodeAgent до оптимизации GPU-расходов в 6,6 раза и победы над зарубежными аналогами.
Читать далее
Recurrent Looped Transformer (RLT): передача состояния декодера через каждый токен
Разбираем концепцию Recurrent Looped Transformer (RLT) от исследователя из Принстона. Узнайте, как сквозная передача состояния декодера и 96 логических блоков на токен меняют архитектуру LLM.
Читать далее