Тэг
LLM

Как ИИ меняет математику: от решения задач тысячелетия до кризиса верификации
Разбираем, как нейросети решают гипотезы Эрдёша и уравнения Навье — Стокса, зачем математикам Lean и как Теренс Тао предлагает переосмыслить научный процесс.
Читать далее
GuardRate: архитектура, метрики и инсайты из аудита моделей защиты ИИ
Подробный разбор архитектуры GuardRate, математических метрик и результатов аудита 37 guardrail-моделей ИИ. Разбор аномалий рейтинга, русскоязычных тестов и скорости работы.
Читать далее
Что такое токенизация в ИИ: полное руководство по превращению текста в токены
Токенизация — это фундаментальный механизм, с помощью которого языковые модели превращают сырой текст в математические идентификаторы. Разбираем пятиэтапную карту токенизации, ключевые риски и методы оценки.
Читать далее
RAG или Long Context: когда действительно нужен сложный пайплайн, а когда хватит большого окна LLM
Разбираем, когда действительно нужен RAG с векторной базой и реранкером, а когда проще загрузить всю документацию в контекстное окно LLM с использованием кэширования.
Читать далее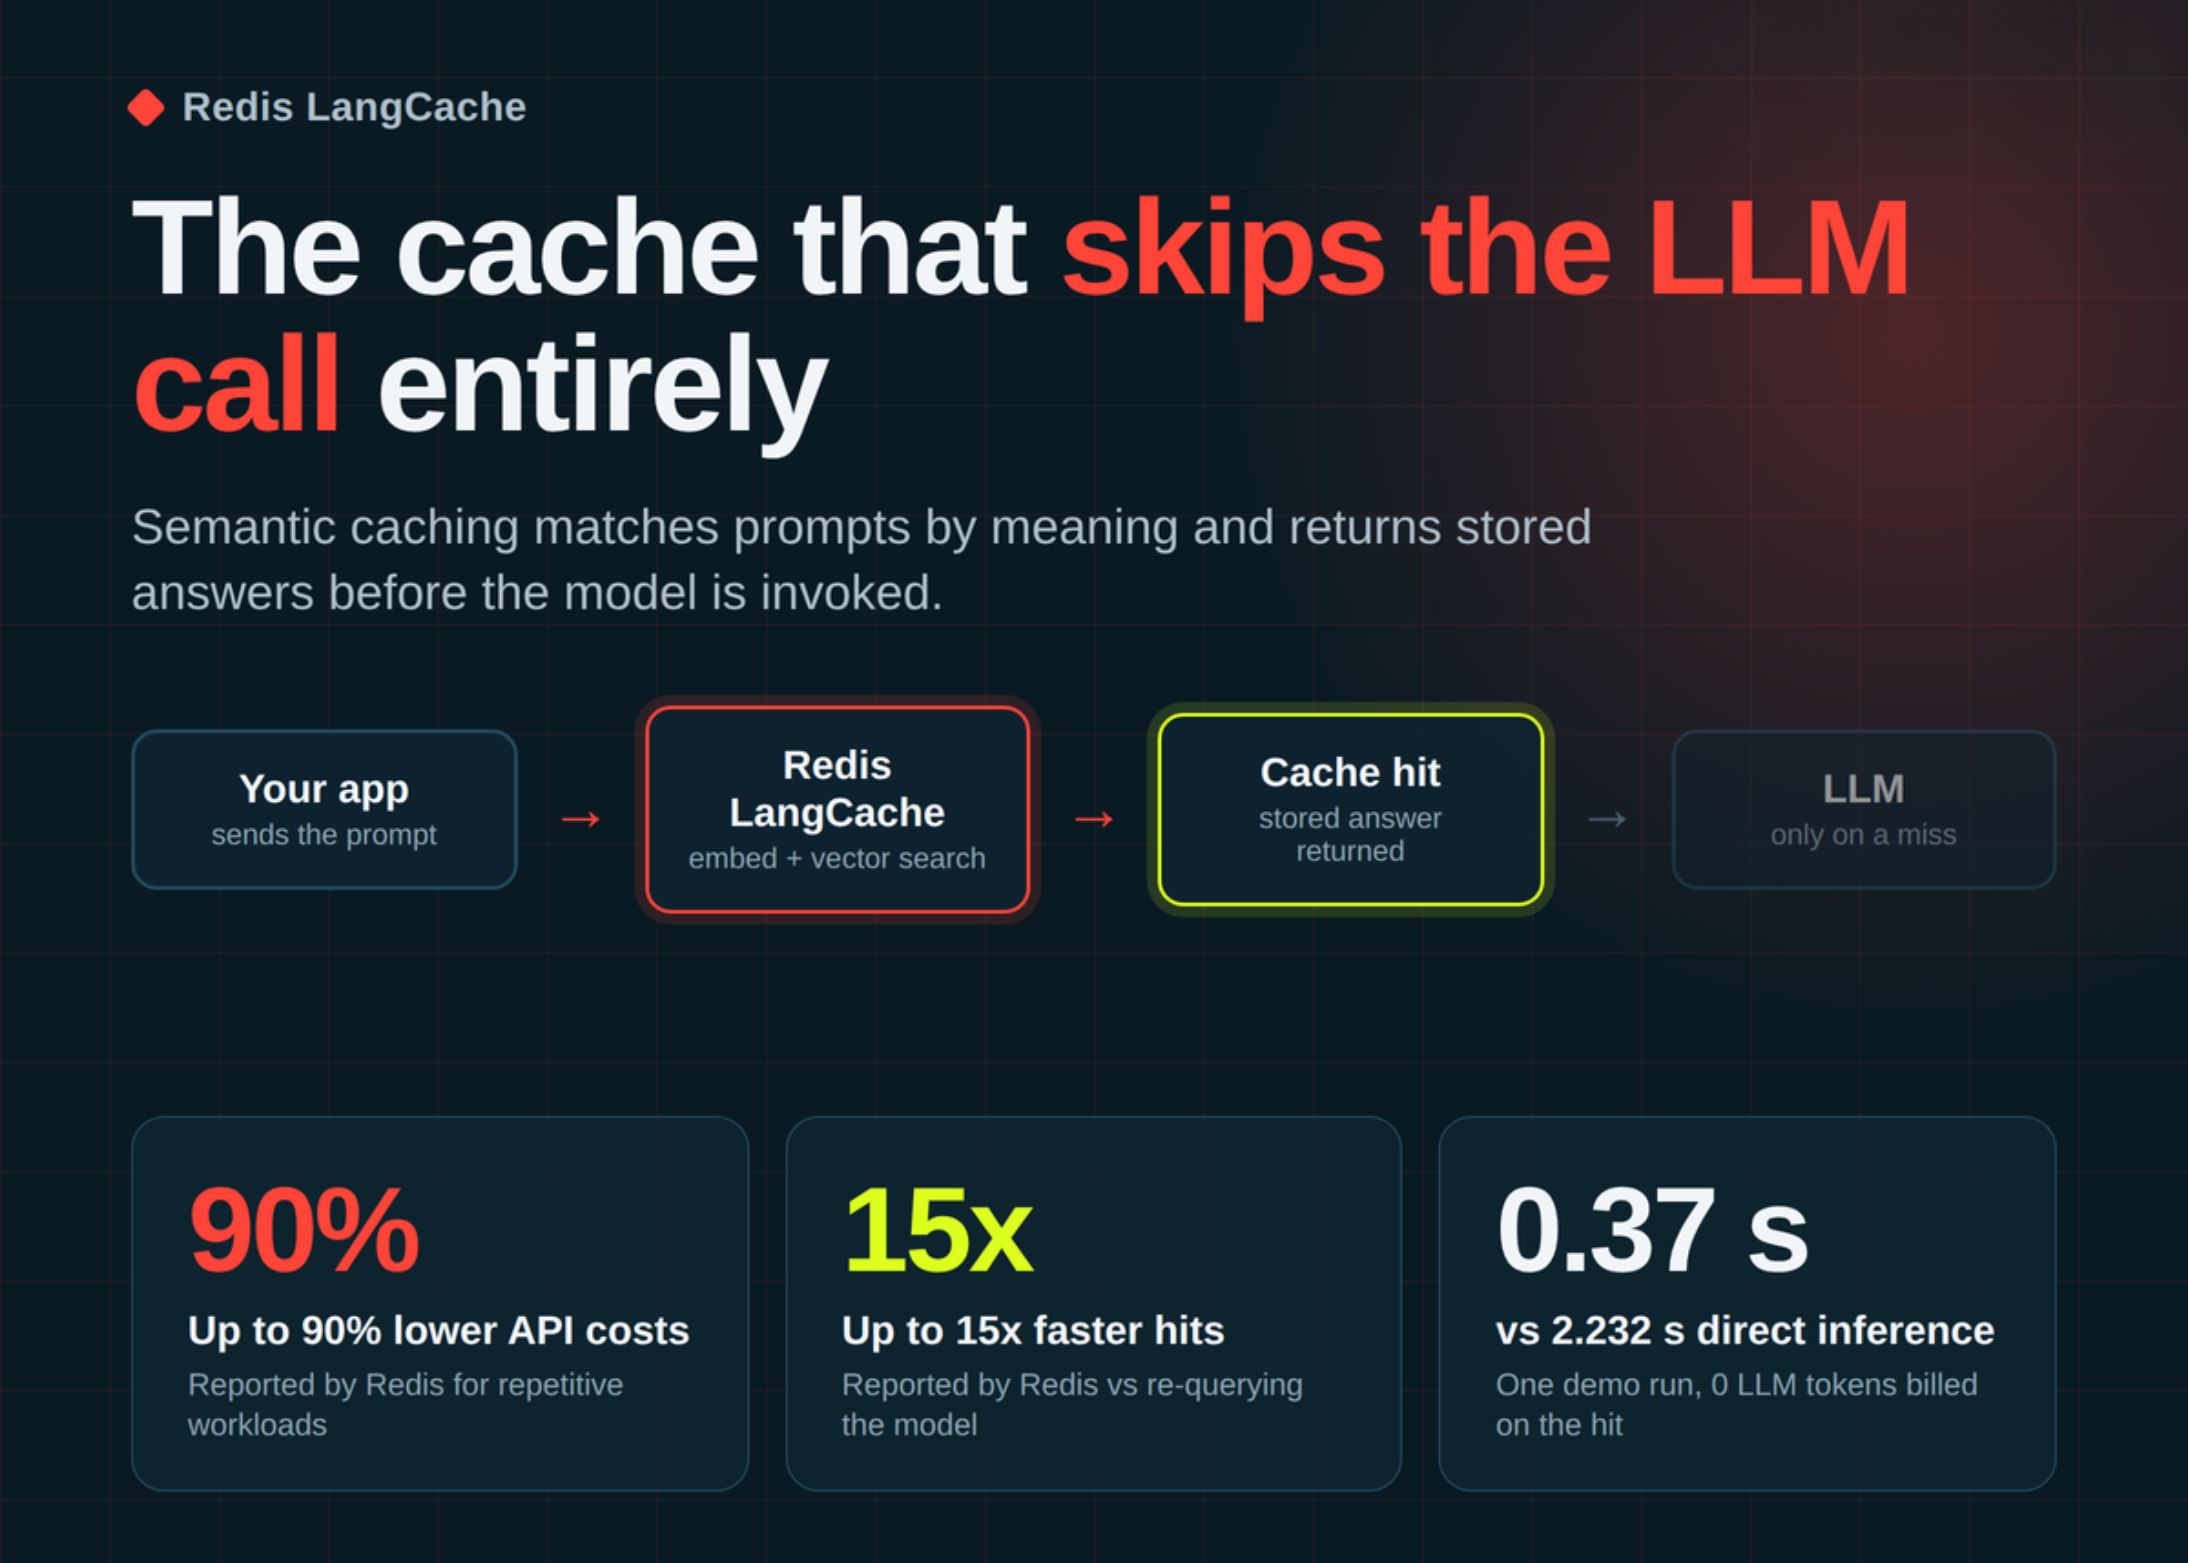
Обзор Redis LangCache: управляемый семантический кэш, сокращающий расходы на LLM до 90%
Разбор Redis LangCache — управляемого сервиса семантического кэширования для LLM, который позволяет сократить расходы на API до 90% и ускорить выдачу ответов до 15 раз.
Читать далее
Мониторинг упоминаний бренда в ChatGPT: сравнение трёх способов сбора данных и разбор ошибок парсинга
Сравнил три способа сбора данных из ChatGPT: через API gpt-4o, gpt-5.5 и веб-интерфейс. Показываю разницу в источниках, ошибках парсинга и даю готовый Python-код для точного мониторинга бренда в нейросетях.
Читать далее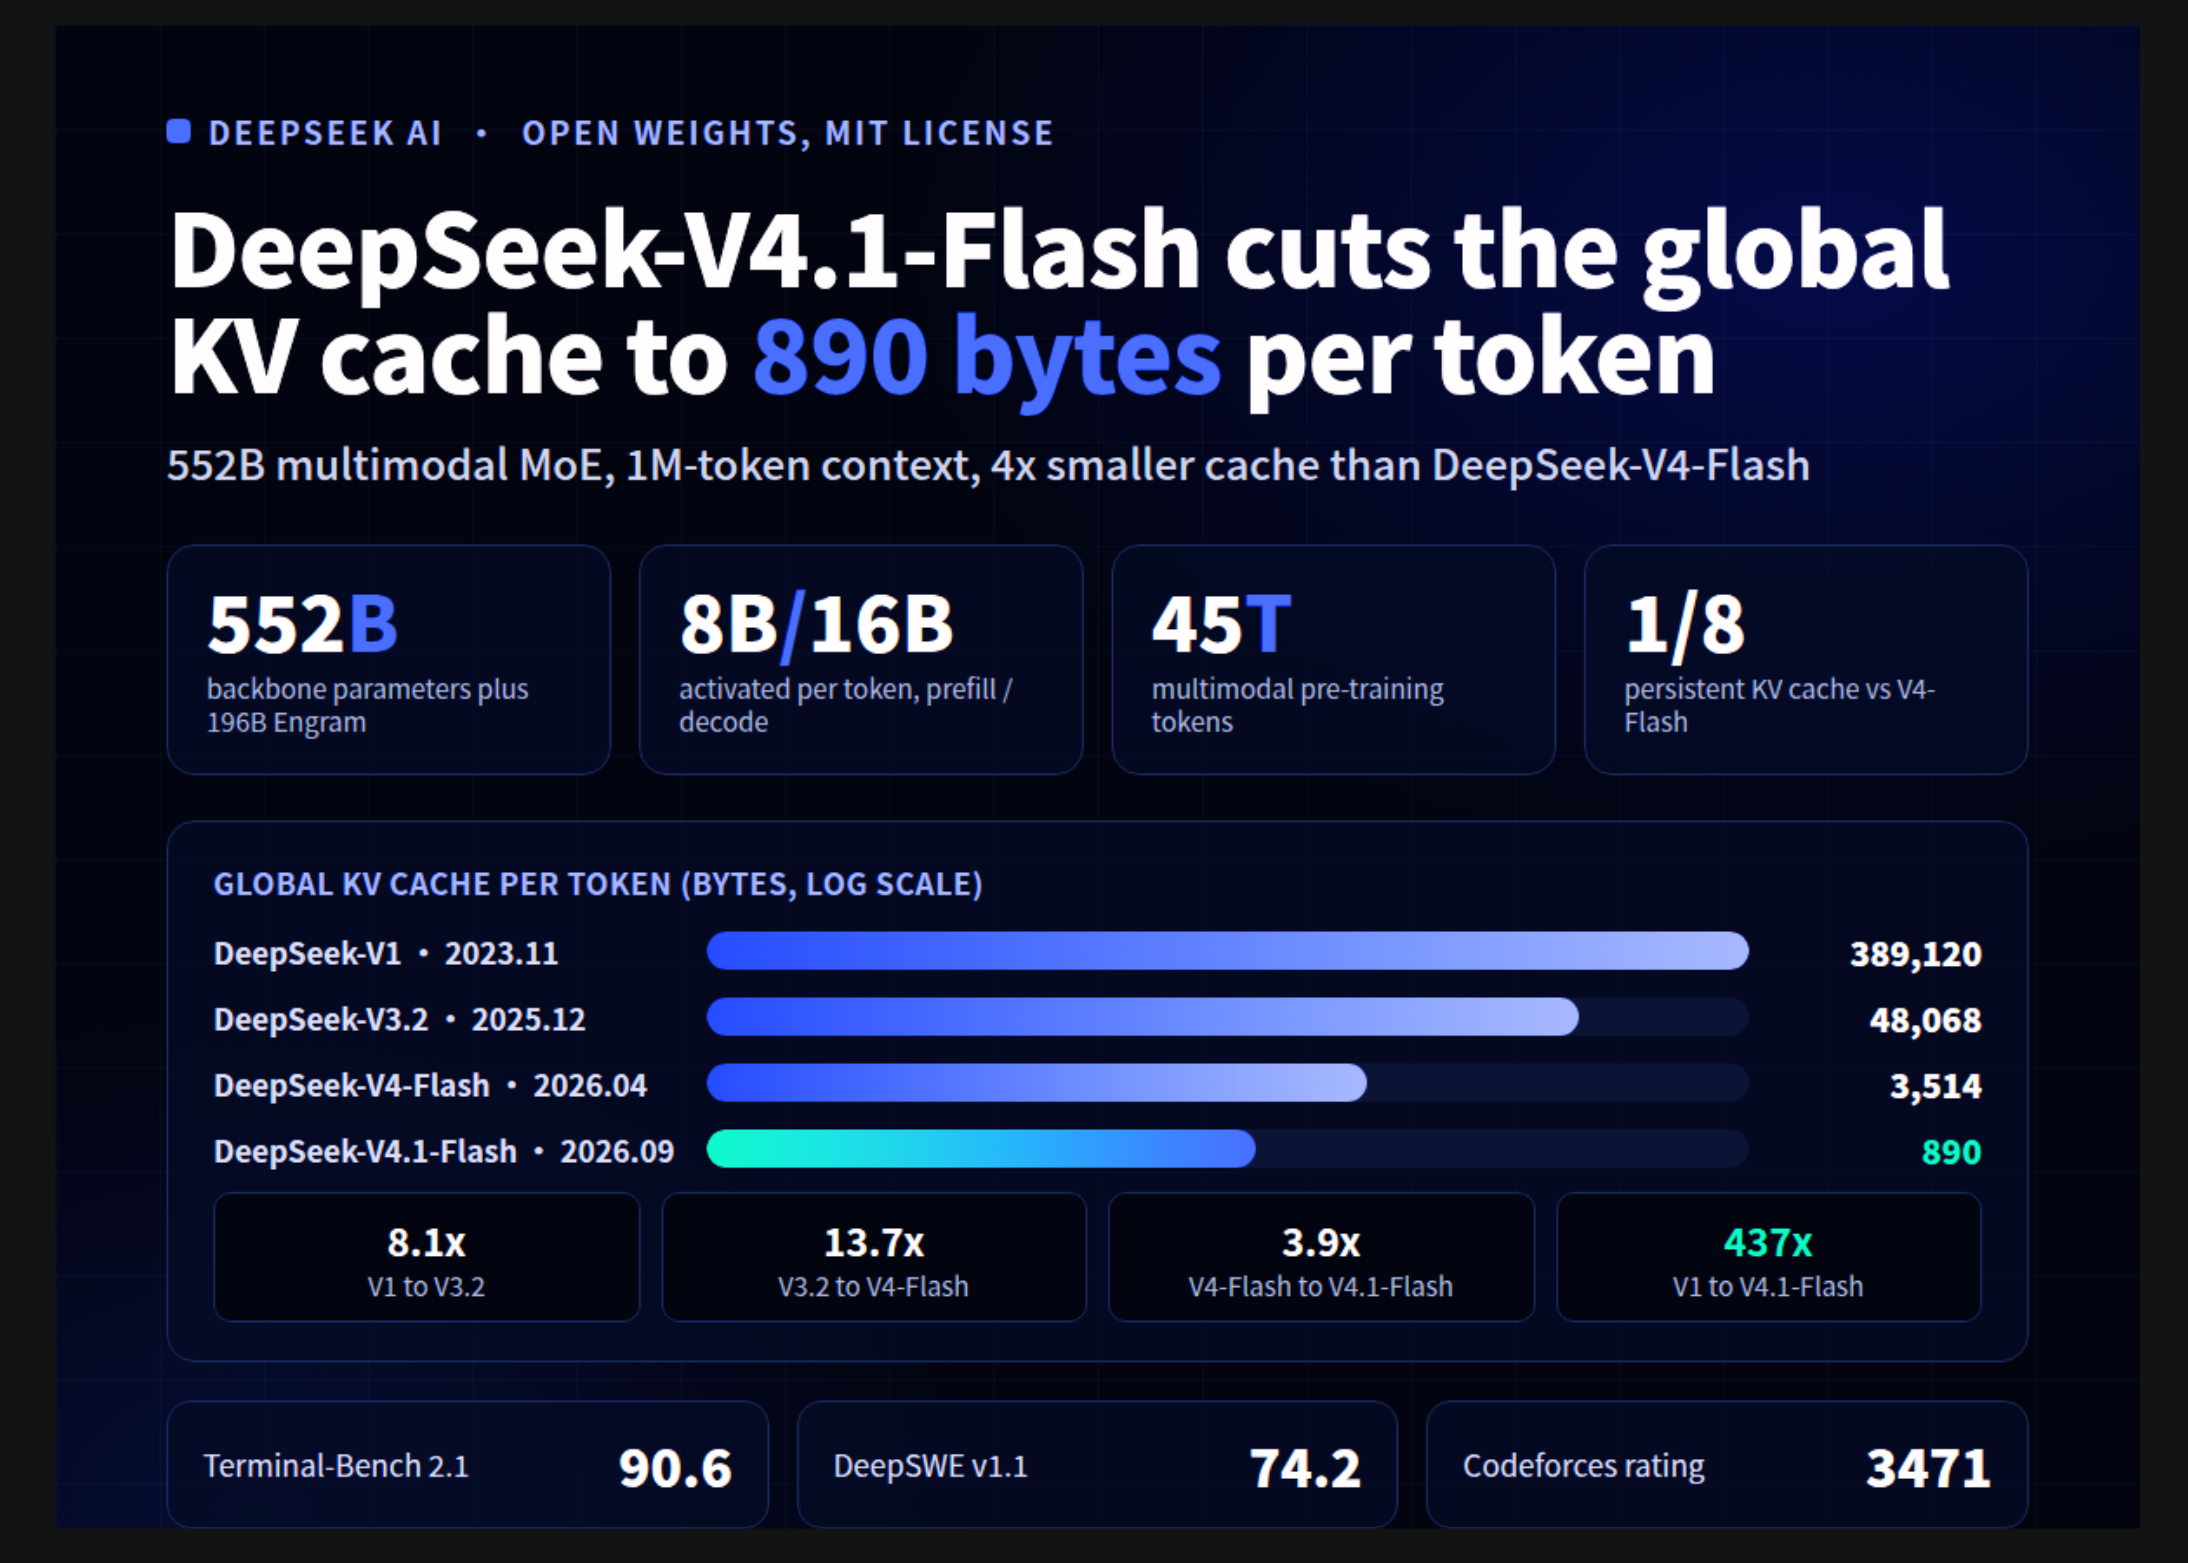
DeepSeek-V4.1-Flash: архитектурный прорыв с контекстом 1M токенов, FP4 KV-кэшем и повторным использованием внимания
Разбор нейросети DeepSeek-V4.1-Flash: окно контекста 1M токенов, сжатие KV-кэша до 890 байт на токен, квантование FP4 и архитектура Causal Encoder-Decoder.
Читать далееКомпьютеры для людей: от вайб-кодинга до запуска Qwen3.8-Flash-Next 125B на 6 ГБ VRAM
Разбираем смену парадигмы в разработке ПО: от истории интерфейсов и вайб-кодинга до рекордного запуска нейросети Qwen3.8-Flash-Next 125B с потреблением всего 5,95 ГБ VRAM.
Читать далее
Обработка естественного языка (NLP): как компьютеры понимают человеческую речь
Подробный разбор технологии NLP: пятиэтапная карта обработки текста, отличие от поиска по ключевым словам, методология тестирования и предотвращения сбоев в языковых моделях.
Читать далее
Тестирование DeepSeek, Qwen и GLM на ПК с RTX 5090: подборы инференса, VRAM и драфтеры
Провел масштабный бенчмарк свежих локальных нейросетей DeepSeek, Qwen, GLM и Ornith на топовом пользовательском ПК с RTX 5090 и 192 ГБ ОЗУ. Разбираем реальную скорость, работу MoE и спекулятивное декодирование.
Читать далее